几天前,我发表了《Go+ c2go:假期 3 天迁移 C 标准库的进展》,介绍了 C 标准库迁移的实现框架以及进展情况。今天,我很高兴地宣布:迁移 C 标准库的第一个小目标:让 printf 可以正常工作,已经达成了。
这一个月,我们基本上以一周一次的频度,来向大家同步 c2go 项目遇到的挑战,以及我们怎么克服这些挑战。阅读这些内容,将有助于大家理解 C 与 Go 这两门语言之间的异同,以便更深去掌握这两门语言。如果你想更多了解 c2go 项目,可以参考以下文章:先来说说我们的迁移成果。虽然我们的目标只是移植一个 printf 函数,但实际上它的牵涉面非常广。它依赖多少东西?我们看一下当前 libc 这个库的现状就知道了:这是 libc 的语言分布图。这就是说,为了迁移 printf 函数,我们差不多迁移了整个 libc 10% 的代码量了。以下是已经编译通过的 C 源代码文件清单:./src/internal/libc.c./src/errno/strerror.c./src/errno/__errno_location.c./src/math/__fpclassify.c./src/math/__fpclassifyl.c./src/math/__signbit.c./src/math/__signbitl.c./src/math/frexp.c./src/math/frexpl.c./src/ctype/isdigit.c./src/string/memchr.c./src/string/memset.c./src/string/memcpy.c./src/string/strchrnul.c./src/string/strnlen.c./src/string/strlen.c./src/string/strncmp.c./src/string/strcmp.c./src/env/__environ.c./src/env/getenv.c./src/mman/mmap.c./src/mman/munmap.c./src/time/__map_file.c./src/locale/__mo_lookup.c./src/locale/__lctrans.c./src/locale/c_locale.c./src/locale/locale_map.c./src/unistd/lseek.c./src/stdio/vsnprintf.c./src/stdio/vsprintf.c./src/stdio/snprintf.c./src/stdio/sprintf.c./src/stdio/__stdio_exit.c./src/stdio/__lockfile.c./src/stdio/__towrite.c./src/stdio/__stdio_read.c./src/stdio/__stdio_write.c./src/stdio/__stdio_seek.c./src/stdio/__stdio_close.c./src/stdio/__stdout_write.c./src/stdio/ofl.c./src/stdio/stdin.c./src/stdio/stdout.c./src/stdio/stderr.c./src/stdio/fwrite.c./src/stdio/vfprintf.c./src/stdio/fprintf.c./src/stdio/printf.c
这还不是全部,有些函数因为一些原因(比如依赖内嵌的汇编代码)而无法直接移植。这部分的完整清单可以从 c2go 的工程文件(c2go.cfg 文件)中的 source.ignore.names 字段中找到:看起来不能迁移的函数数量有点多,但是其实就 4 类:- 原子操作(atomic),包括 a_cas,a_ll,a_sc,a_swap 等;
原子操作(atomic)和内存管理(malloc)比较基础,依赖是比较显而易见的,这里不多提。系统调用(syscall)也好理解,毕竟 printf 涉及到文件系统的操作,自然会有系统调用。pthread 可能是最让人费解的,为什么 printf 的实现还会和线程相关。这其实是因为 C 标准库一个不太优雅的设计引起的,那就是 errno。我们知道,C 标准库中存在为数不少的函数,它们在出错的时候,会把错误码写到全局的 errno 中。在最早的单线程时代,errno 就是一个简单的全局变量。但是到了多线程,它就不能是全局变量了,而必须基于类似 TLS(线程局部存储)这样技术。而要想用到 TLS,就必须得到线程的实例,这就解释了为什么 printf 会依赖 __pthread_self() 函数的原因了。说清楚了我们都迁移了啥,接下来我们照例聊聊我们遇到的挑战。我们顺藤摸瓜,先说说上面 4 类不能自动翻译的函数怎么破。其一,原子操作(atomic)。这块比较简单,调用 Go 的 sync/atomic 标准库进行封装即可。代码如下:其二,系统调用(syscall)。虽然 syscall 函数的个数非常多,但是他们完全类似,只是参数个数不一样。见下图:其中参数 n 是功能代号,相当于某个系统调用的函数名。参数 a..f 是函数参数。syscall 的返回值都代表错误码。当然你可能要问:syscall 调用难道就不会返回一些什么么?这是一个好问题。一个可能的做法是输入参数(a..f)传入一个指针,这样就能够得到系统调用要 “返回” 的一些数据。但是如果只是想传回一些简单数据如整型值那就太浪费了。于是就有了 __syscall_ret 函数,专门用于得到 syscall 返回的整型类数据。我们这里只以 __syscall3 作为例子,其他 __syscallN 函数完全类似。这里我们重点呈现的是它们和 __syscall_ret 函数的关系。好消息是,Go 把 syscall 能力公开了,我认为这是非常英明的决策。C 语言没有把 syscall 纳入标准库的范畴,这就意味着如果操作系统有了新的能力,就需要 C 标准库来跟进这个能力,否则用户就只能去 hack(当然 C 对 hack 是非常友好的,因为它没有 private 函数的概念,只要你知道 C 标准库内部函数的规格,你可以自己去调用,只不过它没有跨不同 C 标准库版本、跨不同 C 编译器的兼容性保证)。而 Go 语言公开 syscall 就意味着:Go 标准库能够做到的,你也能。不好的消息是,这真的只是示意代码。它实际上是有问题的:因为我们用了 g_r1 这个全局变量来传递信息。这意味着如果多个 goroutine 一起调用 syscall 的话,他们会相互干扰。正确的做法像 errno 一样,用 pthread 的 TLS 能力。如下:不过我注意到在 musl 这个 C 标准库实现的代码中,定义一个 syscall 宏:#define syscall(...) __syscall_ret(__syscallN(...))
也就是说,在很多时候 __syscallN 函数的调用会紧接着就调用 __syscall_ret。对于这种情况我们实际上可以优化掉其对 TLS 的依赖。为此我们定义了新的 __syscallN_r1 系列的函数,如下:并且,我们将 syscall(...) 宏改为调用 __syscallN_r1(...),而非之前的 __syscall_ret(__syscallN(...))。这里 __syscallN_r1 函数本身是非常简单的,我们仍然以 __syscall3_r1 为例:怎么做到不改 musl 的代码而实现 syscall 宏的替换?利用 C 编译器的 include 路径搜索功能。替换的逻辑很简单,我们建立一个同名的文件 syscall.h,其内容的核心逻辑如下:它先 include 老的 syscall.h 文件,然后把老的 syscall 宏 undef 掉,换上我们自己的 syscall。这样我们自己的代码就注入进去了。这里有一个 undef _INTERNAL_SYSCALL_H 大家可能觉得很突兀。它其实是我们的一种自我保护机制:既然有老的 syscall.h,又有我们定义的新 syscall.h,那么怎么避免用户误 include 老的 syscall.h 呢?你可能说,这怎么可能?我们 ./c2go/include 在搜索路径第一顺位,老的 syscall.h 没有机会被包含吧?C 编译器搜索头文件的规则是:#include <xxx> 只搜索 include 搜索路径,但是 #include "xxx" 则优先搜索本目录中的头文件,找不到再搜索 include 搜索路径。对于这种情况,还是会有机会 include 到老的 syscall.h 的。我们在一个很基础的、几乎人人都会包含的 features.h 文件中加入:#define _INTERNAL_SYSCALL_H
这样如果用户误 include 老的 syscall.h,那就相当于什么都没 include(这当然是因为 C 的防止重复 include 机制所保护),编译就会出错从而被我们发现了(发现了怎么解决?这个问题留给大家,这里不展开)。而我们自己 include 老的 syscall.h 前先 undef _INTERNAL_SYSCALL_H,这样就做到了只有我们新的 syscall.h 才能包含它,其他人都无法包含老 syscall.h 头文件。好吧,syscall 很重要,我们啰啰嗦嗦讲了很多。其三,内存管理(malloc)。这块我们当前先简化处理:简单说,我们先用 Go 的内存分配来实现 malloc。这样得到的内存可以被自动回收,对应的 free 函数可以是空的。这能够奏效,但可能不会是我们长期的做法。在我们的规划中,malloc/free 还是会基于手工管理的逻辑来实现。其四,pthread。完整的 pthread 支持是非常庞大的工作。好在 printf 只依赖于 __pthread_self 函数。它是 TLS(线程局部存储)的基础。Go 语言的 goroutine 并不支持 TLS。但是只要我们能够得到 goroutine 的 id,我们就能够实现 TLS。怎么得到 goroutine id?这个基础工作已经有人做过了:- github.com/petermattis/goid
基于它我们就可以实现 __pthread_self,如下: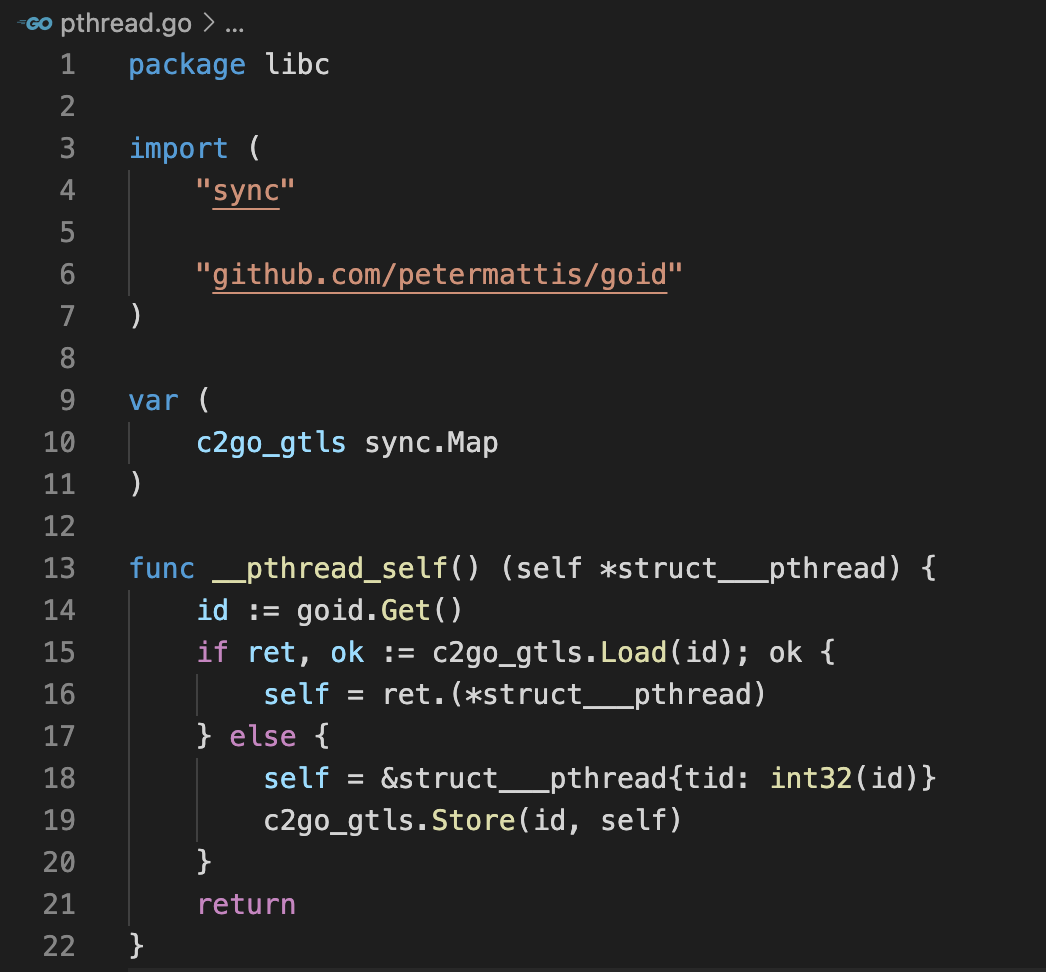
当然比起真正的 TLS,这里的实现性能还是会差一些,多了一次 map 查找的过程。好在 C 标准库对它的依赖基本上都不是一些高频调用的代码(如果有,我们也可以针对该函数进行单独的优化,去掉对 TLS 的依赖),这里的性能损失在可接受范围。接下来我们照例谈谈 C 文法上的支持问题。随着翻译的代码量不断增加,语法问题比我想象得还是要多一些,大部分问题都比较冷门。我们一一展开来看。其一,static 变量或函数。static 关键字有一个很特殊的能力,是允许出现重名。例如 a.c 和 b.c 两个文件都出现 static char buf[100]; 或者都叫 buf 但是类型不同,这都没有问题。函数也一样。a.c 和 b.c 两个文件都出现 static void dummy() { ... } 函数,甚至一个文件中 dummy 是函数,另一个文件中 dummy 是一个变量,这些都是允许的。有 static 声明的符号只在本 C 源代码文件内有意义,其他源文件中并不能看到它。Go 语言并不支持变量或函数重名,所以我们简单引入消重机制解决它:给 static 符号加上唯一编号进行消重。比如 a.c 中的 buf 改名为 buf_1,b.c 中的 buf 改名为 buf_2 等。其二,用 a && b 或 a || b 来实现类似 if 语句的功能。很多脚本语言(比如 Python)也支持你这么写。这是利用 && 和 || 不同于其他算符的一个特殊功能:短路。对于 a && b 来说,如果 a 表达式为 false 那么 b 表达式就不会被执行,这就是短路。同样对于 a || b 来说,如果 a 表达式为 true,那么 b 表达式也不会执行。这就是说,其实 a && b 就等价于 if a { b }。而 a || b 则等价于 if !a { b }。当然在 Go 语言中并不存在这种等价关系,我们需要发现这种模式,并把它们转换为 if 语句。其三,用 volatile 标记未使用的变量。对于大部分的 C 编译器来说,定义一个变量但是没有使用它,都会报变量未使用的告警(warning)。为了抑制这种告警,在 C 语言中最常见的做法是强制转换为 void 类型。如下:int a;...(void)a; // 用于抑制变量 a 未使用的告警
volatile int a; // 变量 a 未使用不会产生告警
这当然很好解决,在 Go 语言中抑制变量未使用的方式是用 _ 变量赋值。如下:var a int..._ = a // 用于抑制变量 a 未使用的告警
其四,n[p] 取值运算。我们平常大家见到的都是 p[n],这里 p 是指针类型(*T),n 是下标(整型)。但是 C 语言灵活得有点变态,它支持 n[p] 这样的取值语法,把指针放到 [] 里面,而下标在外面。当然这问题解决起来比较简单,我们把它翻译成了 *(n+p) 运算。其五,for 循环 initStmt 的变量定义。在 C 语言中一个通用的 for 循环语法可以表示为:for (initStmt; condExpr; postStmt) { ...}
for (int i = 0; i < 10; i++) { ...}
for var i int = 0; i < 10; i++ { ...}
这当然是有问题的,因为 Go 的 for 循环 initStmt 不允许出现 var 关键字。我们把它改为了:for i := int(0); i < 10; i++ { ...}
至此,printf 函数迁移我们遇到的所有挑战就算介绍完了。当然,printf 的依赖并没有完全迁移完。以下是未完成的部分:func __aio_close(int32) int32func __futexwait(addr unsafe.Pointer, val int32, priv int32)func __lock(*int32)func __syscall_cp(int64, int64, int64, int64, int64, int64, int64) int64func __unlock(*int32)func __vm_wait()func __wake(addr unsafe.Pointer, cnt int32, priv int32)func wctomb(*int8, uint32) int32
- 文件类:__aio_close(关闭文件)。由于我们还没有支持打开文件,所以这个函数并不会被执行到。
- syscall 类:__syscall_cp。这个函数没迁移是因为我还没有搞清楚它和 __syscall 的区别(欢迎了解该函数语义的人留言说明),暂时看起来也没有在核心逻辑的分支相关的代码,所以先 panic("notimpl") 了。
- pthread 类:__futexwait, __lock, __unlock, __vm_wait, __wake 等。这些也都不在核心流程中,且 pthread 整个体系比较庞大,暂不移植。
- wchar 类:wctomb。printf 支持打印宽字符,这个我们认为优先级不高,暂不支持。
迁移成功 printf 函数后,我们基本上可以认为 Go+ 支持 C 的大部分风险已经得到验证。迁移的 printf、sprintf、fprintf 我们都实现了基础的单元测试进行了功能验证:- github.com/goplus/libc/blob/musl-go/libc_test.go
剩下来的,pthread 是比较硬的骨头,但是并不存在不可克服的困难。所以下一步我们计划把 libc 的迁移先放一放,把精力先回到 Go+ 本身上来。毕竟,我们原计划在 3 月底 Release 的 Go+ v1.1 正式版已经 delay 了一个月多了。这个 delay 最核心的原因还是因为 c2go 项目。我对 v1.1 版本的几个核心期望(相比 Go+ v1.0 版本)是:这里面最重要的考虑,是 v1.1 需要把 Go+ 的能力完整呈现出来。这个版本后 Go+ 在语法层面的功能会做冻结。后面蛮长一段时间内我们只会加小微功能,大功能短期会非常谨慎,包括对泛型的支持。在泛型这个功能上,我们计划后续版本中会实现对泛型函数(或类)的调用,但是在 Go+ 自身的文法中不能定义新的泛型(但是可以通过 Go+ 和 Go 混合编程来实现)。而在此后的 v1.2 版本,我们会全面完善 Go+ 对 C 语言的支持,以期在可用性上达到工程级别的品质要求。 许式伟约 12 分钟