K近邻、SVM、决策树等机器学习算法的应用场景是什么?
p pythonic生物人约 11 分钟
「
pythonic生物人
」👇系统分享数据科学干货,下划线点击直达👉:
Python可视化
、
R可视化
、
Python精进
、
图解统计学
、
机器学习
等,一起来精进吧!
k近邻、贝叶斯、决策树、svm、逻辑斯蒂回归和最大熵模型、隐马尔科夫、条件随机场、adaboost、em 这些在一般工作中分别用到的频率多大?一般用途是什么?需要注意什么?
作者:King James
https://www.zhihu.com/question/26726794/answer/1048590114
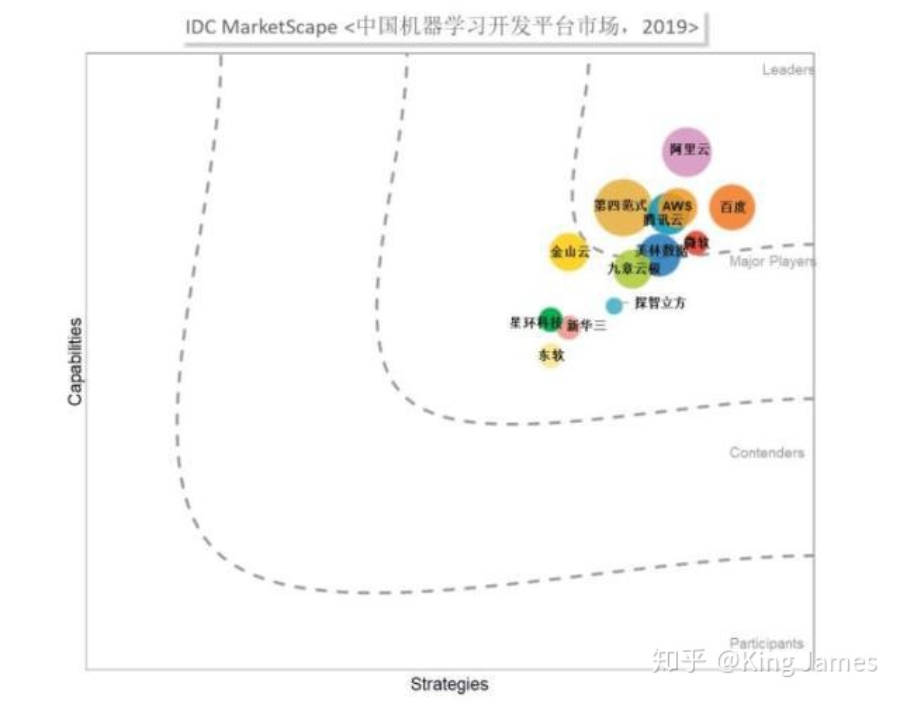
首先简要的回答一下:楼主说的这些算法,在目前国内工业界应用机器学习最多的一些场景中使用频率接近0,没啥实际用途。如果楼主是想为未来工作做积累,你还得对以下算法多做研究,这些才是目前工业界主流应用的算法。 1.国内工业界应用机器学习最多的领域 我们先从工业界对于机器学习的需求开始说起,明白用户需求才知道什么算法用的多。首先大家可以看一下IDC MarketScape发布的2019中国机器学习开发平台市场的报告,里面国内做机器学习头部公司是:第四范式、百度、阿里云,这是头部三家企业。
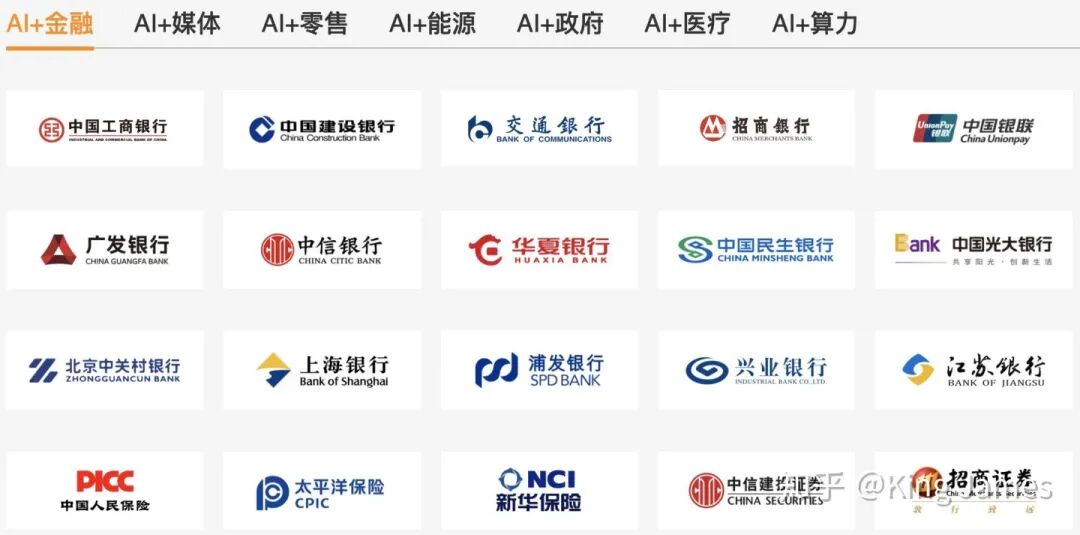
然后我们看一下上图中某头部公司的客户都来自于哪个领域:
(图片来自于官网截图)
我们可以很清晰地看出主要来自于这些领域:金融、媒体、零售;为什么了?原因如下:
第一个是因为数据:
做To C生意的客户积累的用户多,数据也多,满足机器学习建模对数据量的要求。金融、媒体、零售积累了大量C端用户的数据;
第二个是因为场景:
这些领域的客户有些大量可以使用机器学习建模的场景,也是国内工业界最早尝试将机器学习引入到实际的建模场景中的。
具体哪些场景下面会细述。
2. 国内工业界应用最多的机器学习算法
说清楚主要应用领域和场景以后,分析算法就很清楚了。
2.1 金融领域
金融领域使用机器学习建模最多的场景就是风控。当然风控也要进行细分,主要应用机器学习建模的细分场景如下:
https://www.zhihu.com/question/26726794/answer/421409624 对于supervised learning的机器学习算法而言,机器学习算法可以拆解为 representation 、 evaluation 和 optimization 三个部分。
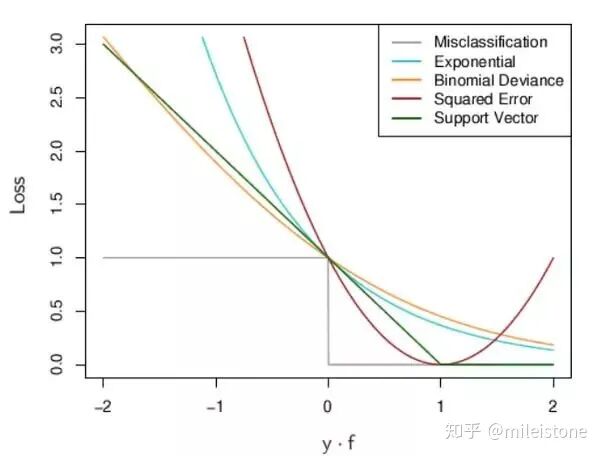
各种各样的loss function
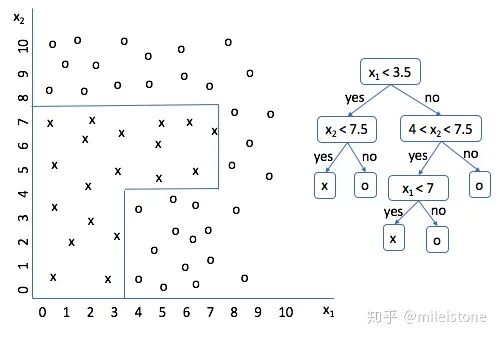
决策树representation图解
adaboost属于ensemble method中boosting方法的一个具体实现,ensemble method包括bagging、boosting和stacking。这些方法在打比赛的时候常用,因为理论上它们一定会带来效果上的提升。
这篇文章
A Few Useful Things to Know about Machine Learning
(链接:
https://homes.cs.washington.edu/~pedrod/papers/cacm12.pdf
)
不错,对宏观地认识机器学习有比较大的帮助。
作者:Spacelounger
https://www.zhihu.com/question/26726794/answer/1526236102 之前学习时候正好整理了笔记,回答一下也算是复习了。先总结各种方法的优缺点,然后简单串连一下如何选择ML算法。 1.线性回归,Linear regression. 优点:简单,上手快,对线性可分的数据有效,正则和cross-validation 可以避免过拟合。 缺点:对outlier敏感,很容易过拟合或者underfitting(不知道中文翻译的什么). 无法处理非线性数据。 2. 逻辑回归, Logistic regression. 优点:简单,上手快,数据做不做预处理都无所谓,输出数据自动落入(0,1)区间,对输入数据的微小波动不敏感,可以通过数值分析方法进行模型优化。 缺点:非线性数据表现不好,对于特征highly correlated的表现不好, 特征必须有明确指向性。 3. SVM 优点:线性非线性数据都可以处理,高维数据表现不错,当类型明确可分的时候是最优选择,outliers影响很小。 缺点:慢, 当类型互相重叠时候表现不太好,kernel选择很重要,参数选择也很关键。 4. Neural Network 优点:整体表现良好, 输入数据的波动影响小 缺点:慢,隐藏层选择很重要 5. Naive Bayers 优点:快,无需训练,irrelevant features 影响非常小,高维数据表现好。 缺点:不适合做预测, 输入数据必须代表整体分布不然会导致结果不好。 6. 决策树 优点:不需要预处理数据,可以处理部分数据丢失的情况,可以可视化,容易理解。 缺点:容易过拟合,对outlier非常敏感,输入数据的微小波动会引起输出的大幅变化, 训练时间长。 7. 随机森林 优点:人多力量大,可以降低综合误差(bias & variance),可以处理高维数据,不会出现过拟合。 缺点:具体过程无法可视化,特征选择比较关键。 8. KNN 优点:简单好上手,对输入数据无要求,参数少,只有一个K 缺点:大量数据处理慢,数据量大+特征多的时候表现不好,imbalanced数据表现不好,无法处理数据丢失。 9. K-mean 优点:可处理大量数据,保证收敛,对新数据适应良好。 缺点:人工选择K, 初始数据完全影响整个模型的结果,高维数据速度慢,对outliers敏感。 10. 如何选择ML模型, 著名no free lunch theroem(可不是我瞎说的)已经表示,不可能有一个全方面称心如意的模型可以解决你的所有问题,就像择偶时候,不可能有兼具帅气多金温柔上进体贴智慧专一。。。于一身的人,主要还是看你更需要什么了。 实际选择模型时候可以从以下方面考虑: 10.1 训练数据 数据量是大还是小,数据是high bias 还是 high variance。。。 数据小,或者数据high bias/ low variance 可以选择linear、 logistics regression, Naïve Bayes, 或者SVM无kernel。 数据量大或low bias / high variance 可选择KNN, SVM 高斯kernel, 决策树。 10.2 数据的结构 考虑数据是线性还是非线性,相关还是不相关,根据上面的模型优缺点进行选择 10.3 训练时间 是想一杯茶喝一天等结果还是想嗖的一下就出结果,可以根据模型本身的速度选择。 10.4 数据特征 特征多还是少,特征是有明确指向性还是没有,特征之间有无重叠,都可以根据具体要求选择合适的模型。
作者:图灵的猫
https://www.zhihu.com/question/26726794/answer/1015964231 我觉得前面的回答意义不大,因为这个问题真的不需要长篇大论,看看题主的描述: k近邻、贝叶斯、决策树、svm、逻辑斯蒂回归和最大熵模型、隐马尔科夫、条件随机场、adaboost、em 这些在一般工作中分别用到的频率多大?一般用途是什么?需要注意什么? 据我了解,现在的真实业务场景下,很少有直接用这些基础算法模型作为线上应用的了。 用途基本就是拿来做前期的base,跑跑看效果如何,或者嵌入到离线的一些应用,比如分词。 要注意的就一点:有些模型数据量大的时候跑起来时间成本太大,比如SVM。你自己在学校可能没觉得有什么,但是公司里是没法这么搞的。还有的模型跑起来速度可以,但是精度不高,比如决策树(这里不包括lightGBM这种集成树),不管是分类还是回归都比不过最新的一些深度模型。 总结一下:小数据量的情况下,你可以研究研究这些模型,毕竟是算法基础。如果你指的是工作中,那么他们的用处不多。 链接:https://www.zhihu.com/question/26726794 编辑:深度学习与计算机视觉 声明:仅做学术分享,侵删 -END- 「 pythonic生物人 」👇系统分享数据科学干货,下划线点击直达👉: Python可视化 、 R可视化 、 Python精进 、 图解统计学 、 机器学习 等,一起来精进吧!
k近邻、贝叶斯、决策树、svm、逻辑斯蒂回归和最大熵模型、隐马尔科夫、条件随机场、adaboost、em 这些在一般工作中分别用到的频率多大?一般用途是什么?需要注意什么?
作者:King James
https://www.zhihu.com/question/26726794/answer/1048590114
首先简要的回答一下:楼主说的这些算法,在目前国内工业界应用机器学习最多的一些场景中使用频率接近0,没啥实际用途。如果楼主是想为未来工作做积累,你还得对以下算法多做研究,这些才是目前工业界主流应用的算法。 1.国内工业界应用机器学习最多的领域 我们先从工业界对于机器学习的需求开始说起,明白用户需求才知道什么算法用的多。首先大家可以看一下IDC MarketScape发布的2019中国机器学习开发平台市场的报告,里面国内做机器学习头部公司是:第四范式、百度、阿里云,这是头部三家企业。
然后我们看一下上图中某头部公司的客户都来自于哪个领域:
- 信用卡交易反欺诈 :分类任务,GBDT算法+LR逻辑回归;
- 信用卡申请反欺诈 :分类任务,GBDT算法+LR逻辑回归;
- 贷款申请反欺诈 :分类任务,GBDT算法+LR逻辑回归;
- 反洗钱 :分类任务,GBDT算法+LR逻辑回归;
- 营销场景: 为用户推荐理财产品、基金产品、保险产品或者邀请用户办理信用卡账单分期等;
- 推荐: 基于内容item的推荐、基于知识图谱的推荐、基于协同过滤算法的推荐。资讯信息物料的推荐,这里面会涉及到Doc2Vec、Lsi等算法,因为涉及到一部分对于物料语义的理解。
- 推荐: 协同过滤CF算法、FM算法+LR排序模型;
- 销量预测: 回归任务,回归模型;
- 供应链优化: 运筹学的知识
https://www.zhihu.com/question/26726794/answer/421409624 对于supervised learning的机器学习算法而言,机器学习算法可以拆解为 representation 、 evaluation 和 optimization 三个部分。
具体的,假设
是训练集中一条sample的data,
为该条sample的label,
为预测值,那么:
1、
的具体形式就是
representation
,比如是一次型的
,或者二次型的
;
2、衡量
和
之间差距的是
evaluation
,其实也就是loss function,例如我们熟知的squared loss,
;
3、根据2中的evaluation求解权重
的过程则是optimization,包括我们熟知的SGD、EM等都可以划到
optimization
。
作者:Spacelounger
https://www.zhihu.com/question/26726794/answer/1526236102 之前学习时候正好整理了笔记,回答一下也算是复习了。先总结各种方法的优缺点,然后简单串连一下如何选择ML算法。 1.线性回归,Linear regression. 优点:简单,上手快,对线性可分的数据有效,正则和cross-validation 可以避免过拟合。 缺点:对outlier敏感,很容易过拟合或者underfitting(不知道中文翻译的什么). 无法处理非线性数据。 2. 逻辑回归, Logistic regression. 优点:简单,上手快,数据做不做预处理都无所谓,输出数据自动落入(0,1)区间,对输入数据的微小波动不敏感,可以通过数值分析方法进行模型优化。 缺点:非线性数据表现不好,对于特征highly correlated的表现不好, 特征必须有明确指向性。 3. SVM 优点:线性非线性数据都可以处理,高维数据表现不错,当类型明确可分的时候是最优选择,outliers影响很小。 缺点:慢, 当类型互相重叠时候表现不太好,kernel选择很重要,参数选择也很关键。 4. Neural Network 优点:整体表现良好, 输入数据的波动影响小 缺点:慢,隐藏层选择很重要 5. Naive Bayers 优点:快,无需训练,irrelevant features 影响非常小,高维数据表现好。 缺点:不适合做预测, 输入数据必须代表整体分布不然会导致结果不好。 6. 决策树 优点:不需要预处理数据,可以处理部分数据丢失的情况,可以可视化,容易理解。 缺点:容易过拟合,对outlier非常敏感,输入数据的微小波动会引起输出的大幅变化, 训练时间长。 7. 随机森林 优点:人多力量大,可以降低综合误差(bias & variance),可以处理高维数据,不会出现过拟合。 缺点:具体过程无法可视化,特征选择比较关键。 8. KNN 优点:简单好上手,对输入数据无要求,参数少,只有一个K 缺点:大量数据处理慢,数据量大+特征多的时候表现不好,imbalanced数据表现不好,无法处理数据丢失。 9. K-mean 优点:可处理大量数据,保证收敛,对新数据适应良好。 缺点:人工选择K, 初始数据完全影响整个模型的结果,高维数据速度慢,对outliers敏感。 10. 如何选择ML模型, 著名no free lunch theroem(可不是我瞎说的)已经表示,不可能有一个全方面称心如意的模型可以解决你的所有问题,就像择偶时候,不可能有兼具帅气多金温柔上进体贴智慧专一。。。于一身的人,主要还是看你更需要什么了。 实际选择模型时候可以从以下方面考虑: 10.1 训练数据 数据量是大还是小,数据是high bias 还是 high variance。。。 数据小,或者数据high bias/ low variance 可以选择linear、 logistics regression, Naïve Bayes, 或者SVM无kernel。 数据量大或low bias / high variance 可选择KNN, SVM 高斯kernel, 决策树。 10.2 数据的结构 考虑数据是线性还是非线性,相关还是不相关,根据上面的模型优缺点进行选择 10.3 训练时间 是想一杯茶喝一天等结果还是想嗖的一下就出结果,可以根据模型本身的速度选择。 10.4 数据特征 特征多还是少,特征是有明确指向性还是没有,特征之间有无重叠,都可以根据具体要求选择合适的模型。
作者:图灵的猫
https://www.zhihu.com/question/26726794/answer/1015964231 我觉得前面的回答意义不大,因为这个问题真的不需要长篇大论,看看题主的描述: k近邻、贝叶斯、决策树、svm、逻辑斯蒂回归和最大熵模型、隐马尔科夫、条件随机场、adaboost、em 这些在一般工作中分别用到的频率多大?一般用途是什么?需要注意什么? 据我了解,现在的真实业务场景下,很少有直接用这些基础算法模型作为线上应用的了。 用途基本就是拿来做前期的base,跑跑看效果如何,或者嵌入到离线的一些应用,比如分词。 要注意的就一点:有些模型数据量大的时候跑起来时间成本太大,比如SVM。你自己在学校可能没觉得有什么,但是公司里是没法这么搞的。还有的模型跑起来速度可以,但是精度不高,比如决策树(这里不包括lightGBM这种集成树),不管是分类还是回归都比不过最新的一些深度模型。 总结一下:小数据量的情况下,你可以研究研究这些模型,毕竟是算法基础。如果你指的是工作中,那么他们的用处不多。 链接:https://www.zhihu.com/question/26726794 编辑:深度学习与计算机视觉 声明:仅做学术分享,侵删 -END- 「 pythonic生物人 」👇系统分享数据科学干货,下划线点击直达👉: Python可视化 、 R可视化 、 Python精进 、 图解统计学 、 机器学习 等,一起来精进吧!