哈佛大学教授详解:深度学习和经典统计学差异?
p pythonic生物人约 15 分钟
「
pythonic生物人
」👇系统分享数据科学干货,下划线点击直达👉:
Python可视化
、
R可视化
、
Python精进
、
图解统计学
、
机器学习
等,一起来精进吧!
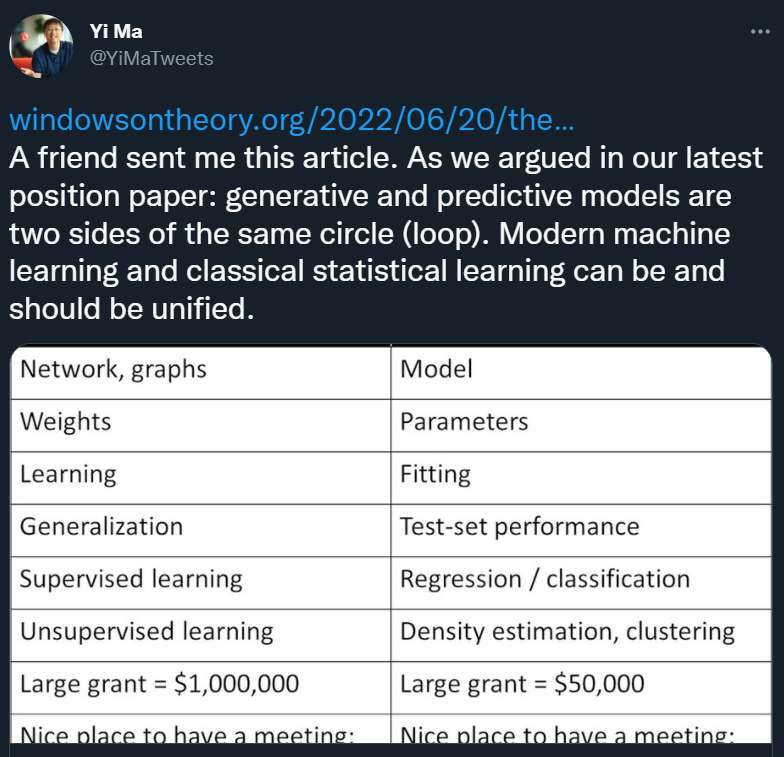
图源:https://twitter.com/YiMaTweets/status/1553913464183091200
深度学习(或一般的机器学习)经常被认为是简单的统计学,即它与统计学家研究的基本是相同的概念,但是使用与统计学不同的术语来描述。Rob Tibshirani 曾总结了下面这个有趣的“词汇表”:
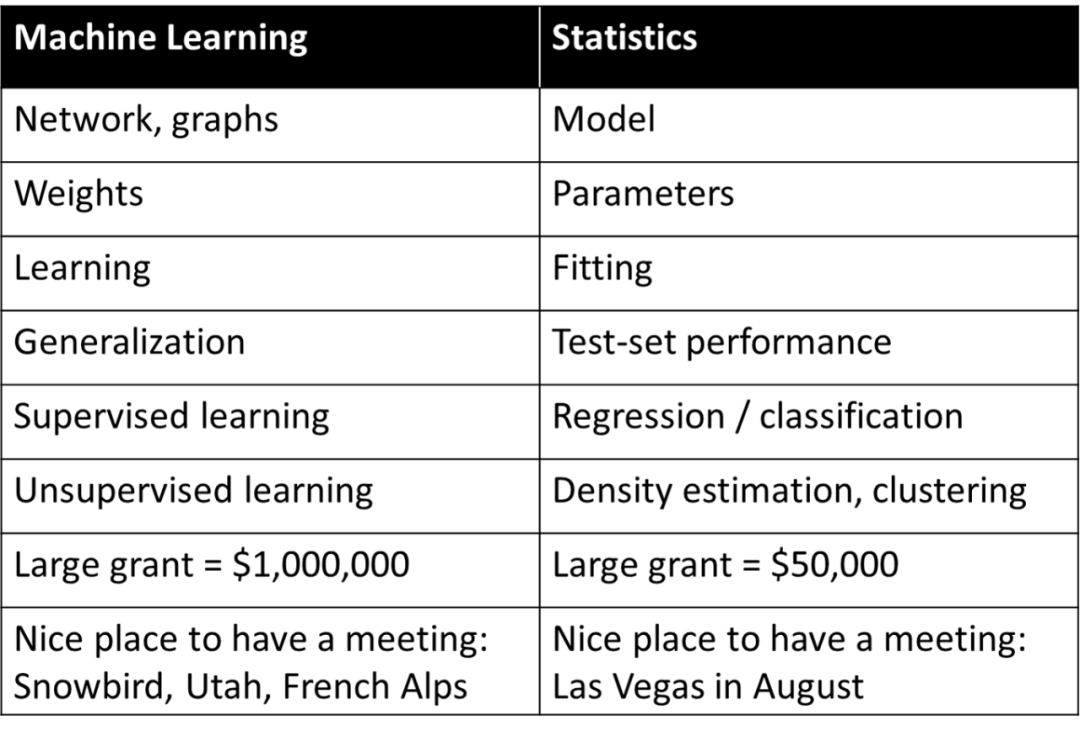
表中的某些内容是不是很能引起共鸣?事实上所有从事机器学习的人都清楚,Tibshiriani 发布的这张表中,右侧的许多术语在机器学习中已被广泛使用。
如果纯粹从统计学角度认识深度学习,就会忽略其成功的关键因素。对深度学习更恰当的评价是:它使用统计学术语来描述完全不同的概念。
本文对比了深度学习和统计学,这里的统计学特指的是“经典统计学”,因为它被研究得最久,并且在教科书中经久不衰。 许多统计学家正在研究深度学习和非经典理论方法,就像 20 世纪物理学家需要扩展经典物理学的框架一样。 事实上,模糊计算机科学家和统计学家之间的界限对双方都是有利的。 1、预测与模型拟合
一直以来,科学家们都是将模型计算结果与实际观测结果进行比较,以验证模型的准确性。 埃及天文学家托勒密提出了关于行星运动的巧妙模型。 托勒密的模型遵循地心说,但有一系列的本轮(见下图),使其具有极好的预测准确性。 相比之下,哥白尼最初的日心说模型比托勒密模型简单,但在预测观察结果方面不太准确。 (哥白尼后来添加了自己的本轮,以便能够与托勒密的模型媲美。 )
1.这里有一些数据
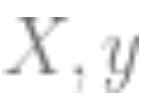 (
 是
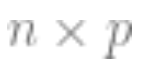 的矩阵;
 是
 维向量,即类别标签。把数据认为是来自某个有结构且包含噪声的模型,就是要去拟合的模型)
2.使用上面的数据拟合一个模型
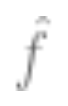 ,并用优化算法来最小化经验风险。就是说通过优化算法找到这样的
,使得
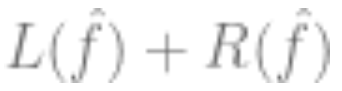 最小,
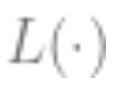 代表损失(表明预测值有多接近真实值),
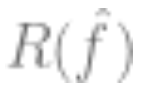 是可选的正则化项。
3. 模型的总体损失越小越好,即泛化误差
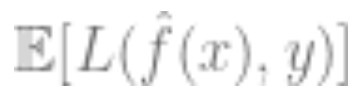 的值相对最小。
权衡:假设
 是经过优化的模型集合(如果函数是非凸的或包含正则化项,精心选择算法和正则化,可得到模型集
。
的偏差是元素
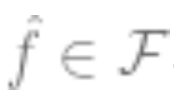 所能达到的最接近真值的近似值。集合
 越大,偏差越小,并且可能为 0(如果
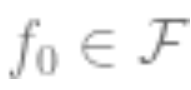 )。
然而,
 越大,需要缩小其成员范围的样本越多,因此算法输出模型的方差越大。总体泛化误差是偏差和方差的总和。因此,统计学习通常是 Bias-Variance 权衡,正确的模型复杂度是将总体误差降至最低。事实上,Geman 等人证明了其对神经网络的悲观态度,他们认为:Bias-Variance 困境造成的基本限制适用于所有非参数推理模型,包括神经网络。
“多多益善”并不总是成立:在统计学习中,更多的特征或数据并不一定会提高性能。例如,从包含许多不相关特征的数据中学习是很难的。类似地,从混合模型中学习,其中数据来自两个分布中的一个(如
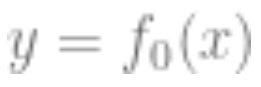 和
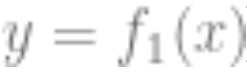 ),比独立学习每个分布更难。
收益递减:在很多情况中,将预测噪声降低到水平
 所需的数据点数量与参数
 和
 是有关的,即数据点数量约等于
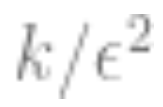 。在这种情况下,需要大约 k 个样本才能启动,但一旦这样做,就面临着回报递减的情况,即如果需要
 个点才能达到 90% 的准确率,则需要大约额外的
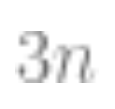 个点来将准确率提高到 95%。一般来说,随着资源增加(无论是数据、模型复杂度还是计算),人们希望获得越来越精细的区分,而不是解锁特定的新功能。
对损失、数据的严重依赖性:当将模型拟合到高维数据时,任何小细节都可能会产生很大的差异。L1 或 L2 正则化器等选择很重要,更不用说使用完全不同的数据集。不同数量的高维优化器相互之间也非常不同。
数据是相对 “单纯” 的:通常会假设数据是独立于某些分布进行采样的。虽然靠近决策边界的点很难分类,但考虑到高维度上测量集中现象,可以认为大多数点的距离都是相近的。因此在经典的数据分布中,数据点间的距离差异是不大的。然而,混合模型可以显示这种差异,因此,与上述其他问题不同,这种差异在统计中很常见。
场景 B:学习数学
在这个场景中,我们假设你想通过一些说明和练习来教学生数学(如计算导数)。
这个场景虽然没有正式定义,但有一些定性特征:
1. 假设数据是一个序列
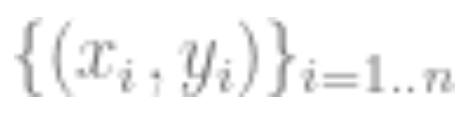 ,其中
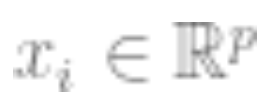 是某个数据点(比如一张图片),
 是标签。
2. 首先得到表示函数
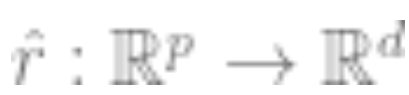 的深度神经网络。通过最小化某种类型的自监督损失函数,仅使用数据点
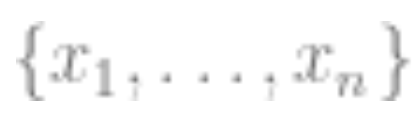 而不使用标签来训练该函数。这种损失函数的例子是重建(用其它输入恢复输入)或对比学习(核心思想是正样本和负样本在特征空间对比,学习样本的特征表示)。
3. 使用完整的标记数据
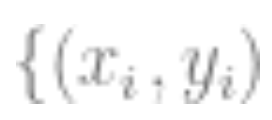 拟合线性分类器
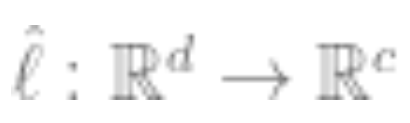 (
 是类数),以最小化交叉熵损失。我们的最终分类器是:
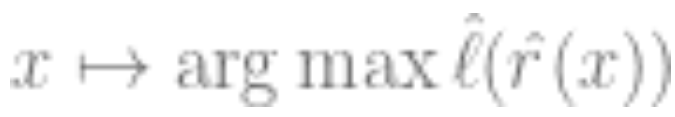
步骤 3 仅适用于线性分类器,因此 “魔术” 发生在步骤 2 中(深度网络的自监督学习)。在自监督学习中有些重要属性:
学习一项技能而不是去近似一个函数:
自监督学习不是逼近函数,而是学习可用于各种下游任务的表示(这是自然语言处理的主导范式)。通过线性探测、微调或激励获得下游任务是次要的。
多多益善:
在自监督学习中,表示质量随着数据量的增加而提高,不会因为混合了几个来源的数据而变糟。事实上,数据越多样化越好。
有些情况比其他情况更困难:
这一点并不特定于自监督学习。数据点似乎有一些固有的 “难度级别”。事实上,不同的学习算法具有不同的“技能水平”,不同的数据 dian 具有不同的” 难度水平“(分类器
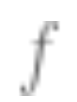 正确分类点
 的概率随
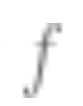 的技能而单调提升,随
 难度单调降低)。
“技能与难度(skill vs. difficulty)”范式是对 Recht 等人和 Miller 等人发现的 “accuracy on the line” 现象的最清晰解释。
Kaplen、Ghosh、Garg 和 Nakkiran 的论文还展示了数据集中的不同输入如何具有固有的“难度剖面”,对于不同的模型族,该剖面通常是稳健的。
其次,有证据表明,尽管使用完全不同的损失函数,但监督学习和自监督学习在”内部“的行为其实是相似的。两者通常都能达到相同的性能。具体地,对于每一个
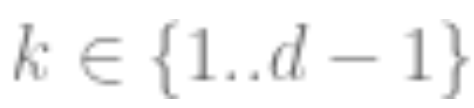 ,人们可以将通过自监督训练的深度为 d 的模型的前 k 层与监督模型的最后 d-k 层合在一起,而性能损失很小。
深度学习和简单的统计学是一回事吗?很多人可能都有这个疑问,毕竟二者连术语都有很多相似的地方。在这篇文章中,理论计算机科学家、哈佛大学知名教授 Boaz Barak 详细比较了深度学习与经典统计学的差异,认为“如果纯粹从统计学角度认识深度学习,就会忽略其成功的关键因素”。
本文对比了深度学习和统计学,这里的统计学特指的是“经典统计学”,因为它被研究得最久,并且在教科书中经久不衰。 许多统计学家正在研究深度学习和非经典理论方法,就像 20 世纪物理学家需要扩展经典物理学的框架一样。 事实上,模糊计算机科学家和统计学家之间的界限对双方都是有利的。 1、预测与模型拟合
一直以来,科学家们都是将模型计算结果与实际观测结果进行比较,以验证模型的准确性。 埃及天文学家托勒密提出了关于行星运动的巧妙模型。 托勒密的模型遵循地心说,但有一系列的本轮(见下图),使其具有极好的预测准确性。 相比之下,哥白尼最初的日心说模型比托勒密模型简单,但在预测观察结果方面不太准确。 (哥白尼后来添加了自己的本轮,以便能够与托勒密的模型媲美。 )
- 导致了不相关的理论和可疑的科学结论。
- 阻止了统计学家研究令人兴奋的新问题。
- 首先,如果监督学习确实等于自监督 + 简单学习,那么这可能解释了它的泛化能力。
-
其次,过度参数化并不是深度学习成功的关键。深度网络之所以特别,并不是因为它们与样本数量相比大,而是因为它们在绝对值上大。事实上,通常在无监督 / 自监督学习中,模型不会过度参数化。即使对于非常大的语言模型,它们的数据集也更大。