程序员必备的数据库知识——数据存储结构
云 司马辽太杰约 8 分钟
一、前言
图片来源《高性能MySQL》
二、逻辑结构
图片来源《MySQL 技术内幕 InnoDB存储引擎》
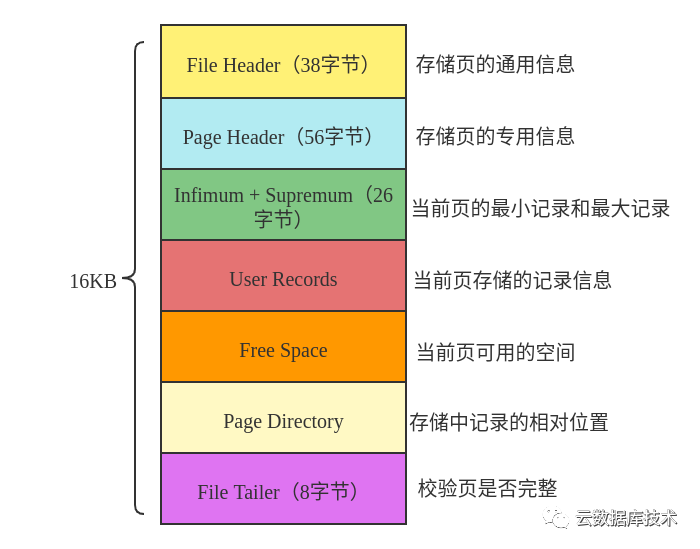
比如先插入一个小行,接着插入一个大行,而且这个大行无法和小行无法存储在同一个块上,接着又插入一个小行。查询这三行数据它的默认排序是:小行、小行、大行。这些行并不按插入的顺序显示的,Oracle会找到能放下此数据的合适空间,而不是按照时间或者事务的某种顺序来存放。 堆表的特点是数据存储在表中,索引存储在索引里,这两者分开的。数据在堆中是无序的,索引让键值有序,但数据还是无序的。堆表中主键索引和普通索引一样的,都是存放指向堆表中数据的指针。 四、B+TREE MySQL InnoDB 引擎将数据划分为若干页(page),以页作为磁盘与内存交互的基本单位,页默认的大小为16KB。这样每次磁盘IO至少读取一页数据到内存中或者将内存中一页数据写入磁盘,通过这种方式减少内存与磁盘的交互次数,从而提升性能。page的格式如下图:
图片来源《MySQL 技术内幕 InnoDB存储引擎》
MySQL InnoDB 引擎是使用B+Tree,B+Tree的特性是主键索引(又称聚集索引)的叶子节点保存的是真正的数据,而辅助索引(又称二级索引、非聚集索引)叶子节点的数据保存的是通过指向主键索引然后获得数据(也就是只根据辅助索引查询,需要进行一次回表)。
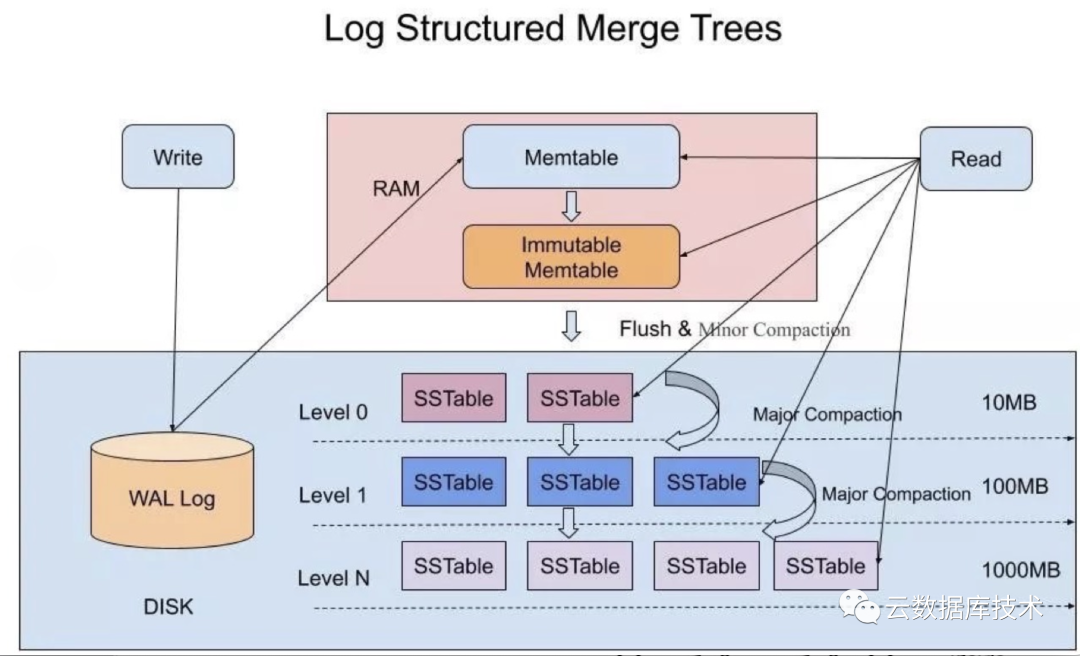
图片来源阿里巴巴数据库团队
随着不断的写入 SSTable 数量会越来越多,数据库持有的文件句柄(FD)会越来越多,读取数据时需要搜索的 SSTable 也会越来越多。另一方面对于某个 Key 而言只有最新版本的数据是有效的,其它记录都是在白白浪费磁盘空间。因此对 SSTable 进行合并和压缩(Compact)就十分重要。在合并和压缩的过程中,会遇到读放大、写放大、空间放大等问题,这些不同的问题需要做取舍,也就诞生了多种合并压缩策略。
七、HASH
Redis HASH 是字符串字段和值之间关系的映射表,适合用于存储对象。
比如:
一个用户有多个属性字段,如:
姓名、年龄、性别等等。
数据库是用于存储数据的,为了不丢失数据每次写需要做持久化,也就是数据每次写都要存储在磁盘上。磁盘相对CPU、内存、缓存等设备,它的IO处理速度慢了几个数量级,即使是SSD,磁盘IO也是远低于内存的读写速率。所以数据库为了提高性能,就需要在磁盘IO上做出最佳选择。
这些不同的数据存储结构,就是
面对不同的数据以及业务场景,
来提高数据库性能
。当然现代数据库还要对数据进行压缩、解压、分布等等运算操作,则需要使用CPU等资源,这些不再本文论述范围内。
本文介绍了五种常见数据存储结构,另外还有图、表格、链式、R-TREE等数据结构并未涉及,当然本文也只是对数据库存储结构的知识抛砖引玉,有兴趣的同学可以对每一种数据存储结构做更详细和深入的学习。
九、参考
《高性能MySQL 》Baron Scbwartz等
《Oracle Database 编程艺术 深入数据库体系结构》Thomas kyte等
《涂抹Oracle 三思笔记之一步一步学Oracle》李丙洋
《MySQL 技术内幕 InnoDB存储引擎》姜承尧
apache-parquet
apache-cassandra-compaction
rocksdb Leveled-Compaction
name-that-compaction-algorithm
阿里云RDS X-Engine
https://en.wikipedia.org/wiki/Column-oriented_DBMS
https://redis.io/docs/data-types
十、作者介绍 司马辽太杰是 NineData 工程师。NineData 向企业和个人提供高效、安全的数据库SQL开发、数据库备份、数据复制/迁移/集成、数据对比等功能,是一个SaaS服务开箱即用,可以快速提升企业SQL开发效率,保障企业数据安全。 NineData 官网地址: https://ninedata.cloud
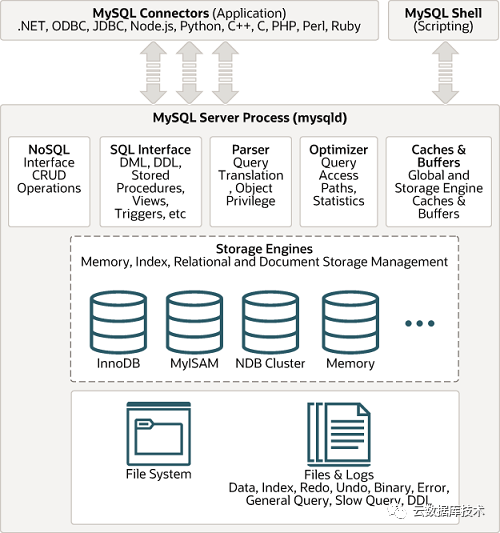
数据在数据库中的存储方式就是数据存储结构。传统数据库由上到下,可以分为 网络接 入层、计算引擎层、存储引擎层、系统文件层,数据存储结构就是在存储引擎层, 数据库通过存储引擎实现CRUD操作。 不同的存储引擎决定了数据库的性能和功能,所以存储引擎层是数据库的核心。 另外,在数据库中数据是以表的形式存储,所以存储引擎也可以称为表类型。
本文将介绍, HEAP、B+TREE、COLUMN-STORE、 LSM-TREE、HASH等存储结构,这些不同的数据存储结构,导致不同数据库的索引、锁、事务等功能特性不同。 下图是MySQL架构图,其中存储引擎有InnoDB、MyISAM、NDB Cluster、Memory等。
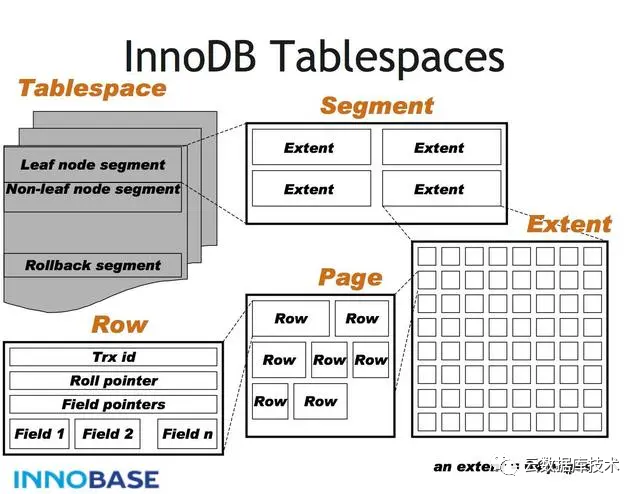
在介绍数据存储结构前,需要先了解数据库逻辑存储架构,常见关系型数据库逻辑架构单元从小到大是: 块(block,MySQL称为page 页) > 区(extent) > 段(segment) > 表空间(tablespace)。
块是数据库存储的最小单元,也是最小逻辑存储结构。不同数据库块的默认大小不一样,MySQL是16k,Oracle是8k。当数据写入块中,如果一条数据过大,就会连续占用几个块。块和块之间并不一定在物理上相连,只是在逻辑上使用双向链表关联,它们之间的物理位置有可能很远,所以数据库一般不以块作为最小的存储分配单位。 区(extent)是由一个或多个连续的块组成,区是Oracle和MySQL数据库的最小分配单位。段(segment)是由一个或多个区组成 。它 可以是连续的,也可以不连续。它是一个独立的逻辑结构,是存储对象、表、索引的数据对象,一个段属于一个数据对象,每创建一个新的的数据对象,就会创建新的独立段。不同类型的数据对象有不同的段:数据段、索引段、回滚段、临时段。 表空间(tablespace)是逻辑结构最高一级,数据库由一个或多个表空间组成,一个表空间则对应着一个或多个物理的数据文件,常见的表空间有数据表空间、索引表空间、系统表空间、日志表空间。下图是MySQL InnoDB逻辑存储架构图。说明:如果表只存储了一条数据,那数据库也是要扫描整个最小存储单元(Oracle是block、MySQL是page)。这样设计是为了提高效率,因为物理I/O成本很大,不可能读、写一行数据就只扫描那行数据的磁盘。三、HEAP Heap表,也就是堆表,是Oracle数据库最常见、也是默认的表类型。 堆表的数据会以堆的方式管理,意味着它的数据存取是随机的。 数据库写数据时,会找到能放下此数据的合适空间。 从表中删除数据时,则允许以后的写入和更新重用这部分空间。
比如先插入一个小行,接着插入一个大行,而且这个大行无法和小行无法存储在同一个块上,接着又插入一个小行。查询这三行数据它的默认排序是:小行、小行、大行。这些行并不按插入的顺序显示的,Oracle会找到能放下此数据的合适空间,而不是按照时间或者事务的某种顺序来存放。 堆表的特点是数据存储在表中,索引存储在索引里,这两者分开的。数据在堆中是无序的,索引让键值有序,但数据还是无序的。堆表中主键索引和普通索引一样的,都是存放指向堆表中数据的指针。 四、B+TREE MySQL InnoDB 引擎将数据划分为若干页(page),以页作为磁盘与内存交互的基本单位,页默认的大小为16KB。这样每次磁盘IO至少读取一页数据到内存中或者将内存中一页数据写入磁盘,通过这种方式减少内存与磁盘的交互次数,从而提升性能。page的格式如下图:
| 类型 | 优点 | 不足 | 应用场景 | 代表数据库 |
| HEAP | 基本数据结构 结构简单 全表查询性能好 | 没有查询优化 | OLTP表数据 | Oracle(堆表) MySQL(MyISAM) PostgreSQL |
| B+TREE | 小数据量查询性能高 响应时间稳定 | 全表查询性能差 维护复杂 | OLTP索引 OLTP索引表 | Oracle(索引组织表) MySQL(InnoDB) |
| COLUMN-STORE | 按字段查询性能好 压缩存储 | 单行查询差 实时更新难 | OLAP | ClickHouse Snowflake Greenplum |
| LSM-TREE | 写入友好 压缩存储 | 查询效率差(二级索引,范围查询) 大吞吐量读 | 日志写入 大数据量管理 | HBase OceanBase RocksDB |
| HASH | 资源使用率高 相比String性能更好 | 集群下无法大规模使用 | NoSQL | Redis Memcache |
十、作者介绍 司马辽太杰是 NineData 工程师。NineData 向企业和个人提供高效、安全的数据库SQL开发、数据库备份、数据复制/迁移/集成、数据对比等功能,是一个SaaS服务开箱即用,可以快速提升企业SQL开发效率,保障企业数据安全。 NineData 官网地址: https://ninedata.cloud