将GPT家族模型极限压缩,1700+亿参数稀疏性达50%性能不减,单GPU即可
机 机器之心约 5 分钟
选自
arXiv
机器之心编译
编辑:袁铭怿
剪枝是一种较为普遍的模型压缩方法,它将网络元素从单个权重(非结构化剪枝)删除到更高粒度的组件,例如权重矩阵的整行 / 列(结构化剪枝)。 该方法已经投入使用一段时间了,能够有效地应用于视觉和较小规模的语言模型和任务。 然而,最优的剪枝方法需要对模型进行大量的再训练,以恢复删除的元素所造成的准确率损失,所以遇到向 GPT 这样规模的模型时,成本也会极为高昂。 虽然也存在一些 one-shot 剪枝方法,无需重新训练即可压缩模型,但弊端在于,它们的计算成本太高,无法应用于具有数十亿个参数的模型。 因此,到目前为止,几乎没有能对 GPT-3 比例模型进行精确剪枝的方法。
本文中,来自奥地利科技学院等机构的研究者提出 SparseGPT,其是目前首个 one-shot 精确剪枝技术,可以在 100 - 1000 亿参数的模型规模上有效地运作。SparseGPT 的工作原理是将剪枝问题简化为大规模的稀疏回归实例。它基于新的近似稀疏回归求解器,用于解决分层压缩问题,其效率足以在几个小时内使用单个 GPU 在最大的 GPT 模型(175B 参数)上执行。同时,SparseGPT 准确率足够高,不需要任何微调,剪枝后所损耗的准确率也可以忽略不计。例如,当在最大的公开可用的生成语言模型(OPT-175B 和 BLOOM-176B)上执行时,SparseGPT 在 one-shot 测试中剪枝到 50-60% 的稀疏性,无论是以困惑度还是 zero-shot 测试准确率来衡量,损失准确率都极小。
值得注意的是,该方法仅针对局部,从某种意义上说,它依赖于权重更新,旨在保留每一层的输入输出关系,计算是在没有任何全局梯度信息的梯度下进行的。 因此,用户可以直接识别密集预训练模型近邻中的稀疏精确模型。 另一处发现如图 1(右)所示: 较大的模型更容易稀疏化。 具体来说,对于一个固定的稀疏水平,随着模型大小的增加,稠密和稀疏模型变体之间的相对准确率差距会随之缩小,如此一来,如果将最大的模型剪枝到 50% 的稀疏性,实际上不会降低准确率。 实验部分会详细说明这一观察结果,对于未来压缩巨型模型的研究而言,这具有极大的鼓舞性。 SparseGPT 算法概览
SparseGPT 重建算法的可视化。给定一个固定的修剪掩码 M,使用 Hessian 逆序列
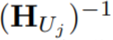 ,增量地修剪权重矩阵 W 的每一列的权重,并更新这些行中的其余权重(位于正在处理的列的右侧)。
具体来说,修剪权重的右边(深蓝色部分)将被更新以补偿修剪错误,而未修剪的权重不生成更新(浅蓝色部分)。
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]
我们可以压缩大型语言模型以获得更好的性能吗? 本文中,研究者提出了剪枝技术 SparseGPT,可以一次性修剪至少 50% 的稀疏性,而无需任何重新训练,并且准确率损失最小。GPT 家族的大型语言模型(LLMs)在诸多任务中取得了出色的表现,但模型庞大的规模和高昂的计算成本也增加了部署难度。 例如,性能最好的 GPT-175B 模型约有 1750 亿参数,以半精度(FP16)格式计算,总计至少占 320GB(计算 1024 的倍数)的存储空间,所以需要至少 5 个 A100 GPU,且在推理时,每个 GPU 都起码需要有 80GB 的内存。 因此,自然就需要通过模型压缩来降低成本。 迄今为止,几乎所有现有的 GPT 压缩方法都侧重于量化,即降低单个权重数值表示的精确度。
剪枝是一种较为普遍的模型压缩方法,它将网络元素从单个权重(非结构化剪枝)删除到更高粒度的组件,例如权重矩阵的整行 / 列(结构化剪枝)。 该方法已经投入使用一段时间了,能够有效地应用于视觉和较小规模的语言模型和任务。 然而,最优的剪枝方法需要对模型进行大量的再训练,以恢复删除的元素所造成的准确率损失,所以遇到向 GPT 这样规模的模型时,成本也会极为高昂。 虽然也存在一些 one-shot 剪枝方法,无需重新训练即可压缩模型,但弊端在于,它们的计算成本太高,无法应用于具有数十亿个参数的模型。 因此,到目前为止,几乎没有能对 GPT-3 比例模型进行精确剪枝的方法。
本文中,来自奥地利科技学院等机构的研究者提出 SparseGPT,其是目前首个 one-shot 精确剪枝技术,可以在 100 - 1000 亿参数的模型规模上有效地运作。SparseGPT 的工作原理是将剪枝问题简化为大规模的稀疏回归实例。它基于新的近似稀疏回归求解器,用于解决分层压缩问题,其效率足以在几个小时内使用单个 GPU 在最大的 GPT 模型(175B 参数)上执行。同时,SparseGPT 准确率足够高,不需要任何微调,剪枝后所损耗的准确率也可以忽略不计。例如,当在最大的公开可用的生成语言模型(OPT-175B 和 BLOOM-176B)上执行时,SparseGPT 在 one-shot 测试中剪枝到 50-60% 的稀疏性,无论是以困惑度还是 zero-shot 测试准确率来衡量,损失准确率都极小。
值得注意的是,该方法仅针对局部,从某种意义上说,它依赖于权重更新,旨在保留每一层的输入输出关系,计算是在没有任何全局梯度信息的梯度下进行的。 因此,用户可以直接识别密集预训练模型近邻中的稀疏精确模型。 另一处发现如图 1(右)所示: 较大的模型更容易稀疏化。 具体来说,对于一个固定的稀疏水平,随着模型大小的增加,稠密和稀疏模型变体之间的相对准确率差距会随之缩小,如此一来,如果将最大的模型剪枝到 50% 的稀疏性,实际上不会降低准确率。 实验部分会详细说明这一观察结果,对于未来压缩巨型模型的研究而言,这具有极大的鼓舞性。 SparseGPT 算法概览
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]