开挖扩散模型小动作,生成图像几乎原版复制训练数据,隐私要暴露了
机 机器之心约 5 分钟
机器之心报道
编辑:袁铭怿
论文地址:https://arxiv.org/pdf/2301.13188v1.pdf
首先,研究提出并实现了图像模型中记忆的新定义。然后,研究设计了分为两阶段的数据提取攻击(data extraction attack),使用标准方法生成图像,并对一些图像进行标记。研究将该方法应用于 Stable Diffusion 和 Imagen,从而提取了 100 多个几乎相同的训练图像副本,这些图像中,既有个人可识别照片也有商标 logo(如图 1)。
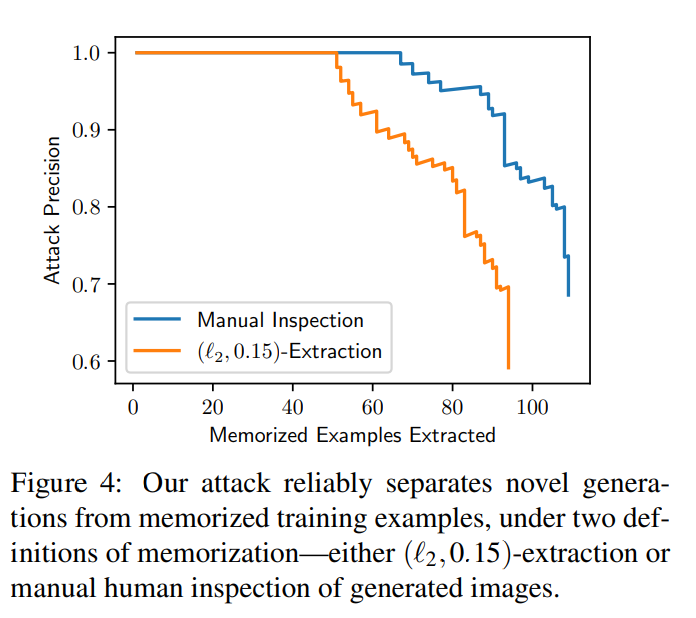
实 验 还 给出了在有给定带注释的有序图像集的情况下,计算曲线,评估提取的图像数量与攻击的假阳性率。 攻击异常精确: 在 1.75 亿张生成的图像中,可以识别出 50 张 0 假阳性的记忆图像,并且所有的记忆图像都可以以 50% 以上的精度提取。 图 4 包含了两种记忆定义的精度 - 召回曲线。
从图像中提取数据
尽管 Stable Diffusion 是目前公开可用的扩散模型中最佳选择,但一些非公开模型使用更大的模型和数据集获得了更强的性能。先前研究发现,较大的模型更容易记住训练数据,因此该研究对 Imagen(一个 20 亿参数的文本 - 图像扩散模型)展开了研究。
令人惊讶的是,研究发现在 Imagen 中攻击非分布图像比在 Stable Diffusion 中更有效。在 Imagen 上,研究尝试提取出 500 张 out-of - distribution(OOD)得分最高的图像。Imagen 记忆并复制了其中 3 个图像(这三个图像在训练数据集中是独有的)。相比之下,当研究将相同的方法应用于 Stable Diffusion 时,即使在尝试提取 10,000 个最离群的样本后,也未能识别任何记忆。因此,在复制和非复制图像上,Imagen 比 Stable Diffusion 的私密性更差。这可能是由于 Imagen 使用的模型比 Stable Diffusion 更大,因此记得的图像也就更多。此外,Imagen 在更小的数据集上进行了更多的迭代训练,这也可以有助于提高记忆水平。
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]
该研究表明,扩散模型能从其训练数据中记忆图像,并在生成图像中复现。去噪扩散模型是一类新兴的生成神经网络,通过迭代去噪过程从训练分布中生成图像。与之前的方法(如 GANs 和 VAEs)相比,这类扩散模型产生的样本质量更高,且更容易扩展和控制。因此,经过快速发展,它们已经可以生成高分辨率图像,而公众也对诸如 DALL-E 2 这样的大型模型产生了极大的兴趣。 生成扩散模型的魅力在于它们合成新图像的能力,从表面上看,这些图像不同于训练集中的任何东西。而事实上,过去大规模的训练工作没有发现过拟合会成为问题,隐私敏感领域的研究人员甚至建议可以用扩散模型来保护隐私,通过生成合成示例来生成真实图像。这一系列的工作是在扩散模型没有记忆和重新生成训练数据的假设下进行的。而这样做将违反所有的隐私保障,并滋生模型泛化和数字伪造方面的许多问题。 本文中,来自谷歌、 DeepMind 等机构的研究者证明了 SOTA 扩散模型确实可以记忆和重新生成单个训练示例。
实 验 还 给出了在有给定带注释的有序图像集的情况下,计算曲线,评估提取的图像数量与攻击的假阳性率。 攻击异常精确: 在 1.75 亿张生成的图像中,可以识别出 50 张 0 假阳性的记忆图像,并且所有的记忆图像都可以以 50% 以上的精度提取。 图 4 包含了两种记忆定义的精度 - 召回曲线。
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]