从 ChatGPT 被挤崩,浅谈如何做入口限流?
高 张斌斌约 9 分钟
作者
:
张斌斌:
Nacos
&Sentinel
Committer
最近
ChatGPT
很火,激起了社会广泛关注和学习热潮,记得上次我通宵学习
AI
知识还是
Goolgle
发布最新算法的时候
。
当时我考虑是不是要转行去搞
AI
,不然就有被淘汰的风险,随着学完斯坦福大学的
AI
公开课,突然就释然了。我发现这个行业极少天才去演进算法,大部分人只是训练和调整参数运用到不同的场景。但是最近
ChatGPT
火了,又引起了我的焦虑和好奇,随即尝试挑战一下
AI
能力,问了几个问题。
作为
Nacos
的
Committer
,想看一下
AI
到底能否理解技术,所以问了一个带有感情色彩的问题,结果让人震惊。我布道
Nacos
也就是从开源定位、优势结构化的去分享,要知道结构化是专家级工程师的核心思维要求,
AI
能达到专家级的思维水平了?
多尝试几次,结果每次都不一样,似乎越问越精简,最后居然能总
结回答,太妙啦~
能够结构化按照定位、优势回答
如果 ChatGPT 的后端已经云原生化,那么猜测是类似 Higress + Sentinel + Dubbo + Nacos + K8s 的技术栈,这样可以快速 构建高并发、高可用、自动弹性的后端体系。 (由于目前未从官方公开文档找到 ChatGPT 的后端架构,所以这里只是假设情况)
作为云计算从业者,就在思考了, ChatGPT 的现象级爆火,让很多公司都羡慕不已,在这个信息大爆炸的时代,每个公司都有着在短时间迅速爆火的可能,在机遇到来时,能不能抗住流量洪峰,保证服务的质量,抓住这次机遇呢?如何快速构建高并发、高可用的微服务架构呢? 我初步构思了一个架构,仅供参考讨论: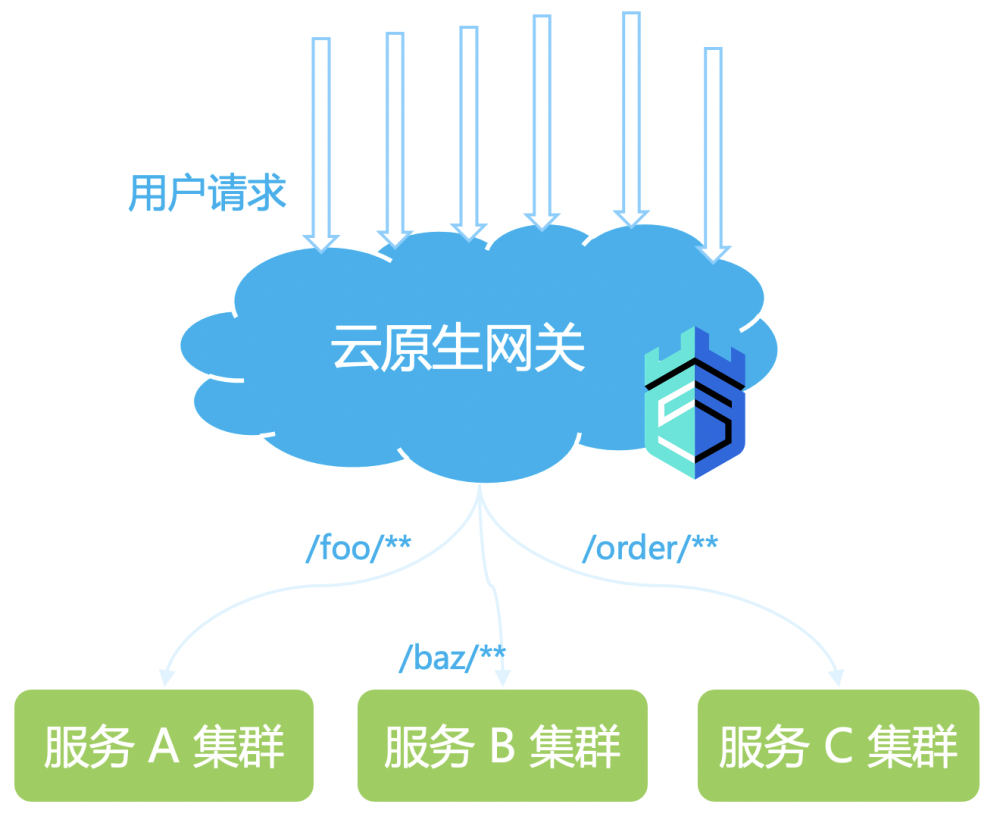 Higress
云原生网关内置了
Sentinel
高可用模块,历经多年双十一大促洪峰流量考验,提供了丰富的高可用防护能力,包括流控、并发控制、熔断,可以从入口层面保障服务稳定性;此外,
Higress
商业版
MSE
还具备流量预热能力,
通过小流量预热方法,可以有效解决大促场景下,资源初始化慢所导致的大量请求响应慢、请求阻塞问题,避免刚扩容的节点无法提供正常服务,影响用户体验。
那么,仅仅依靠入口流量防护来保障整体业务稳定性是否是足够的?随着我们业务规模、量级的不断增长,业务架
构趋于复杂,微服务间的调用拓扑关系呈复杂网状结构。影响稳定性的因素有非常多,除了流量超过承载能力导致不可用的场景之外,服务之间调用的稳定性问题也是不可忽视的一点。比如
ChatGPT
可能依赖几个第三方服务,假设某个搜索服务出现异常,慢调用、超时的请求非常多,而调用端又没有有效地进行预防与处理,则调用端的线程池会被占满,影响服务自身正常运转。在分布式系统中,调用关系是网状的、错综复杂的,某个服务出现故障可能会导致级联反应,导致整个链路不可用,整体
RT
升高,并发升高,此时仅在网关层面做流控是无法保障业务稳
定性的。我们需要在应用层结合流控、慢调用熔断、并发隔离等手段,配合网关层的流控来达到整体业务稳定的目标。
应用视角的稳定性治理手段
面对突发的流量,流控能力可以将超出系统服务能力以外的请求拒绝掉。在应用层,建议结合容量评估,通过压测等手段评估流量阈值,针对核心 API 、接口、方法进行细粒度的流控配置,起到 “ 安全气囊 ” 的作用。注意并不是只有大流量场景才需要流控,任何服务与接口都有其容量上限,对于核心接口,无论流量大小,都需要配置流控来起到保护作用。
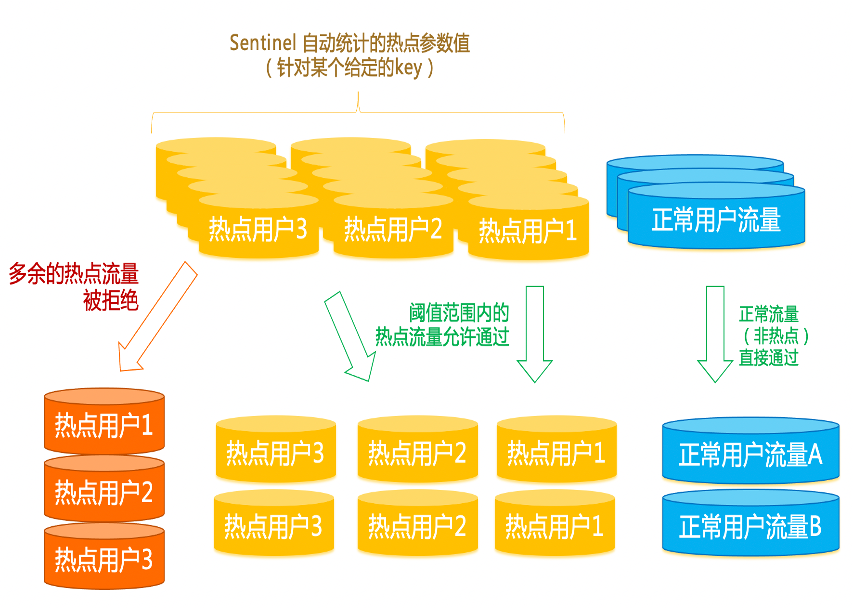 同时,针对热点流量的防护也是保障服务稳定性的重要一环。比如请求中的某些
UID
、某些
IP
具有热点访问性质,业务方事先无法准确预知热点属性;这些突发的热点流量会击穿缓存,将
DB
打挂,影响了正常流量的业务处理,造成整体不可用。这种场景下,通过借助
Sentinel
的
热点参数流控能力
,自动识别参数中的
TopN
访问热度的参数值,并对这些参数分别进行流控,避免单个热点访问过载导致系统不可用。
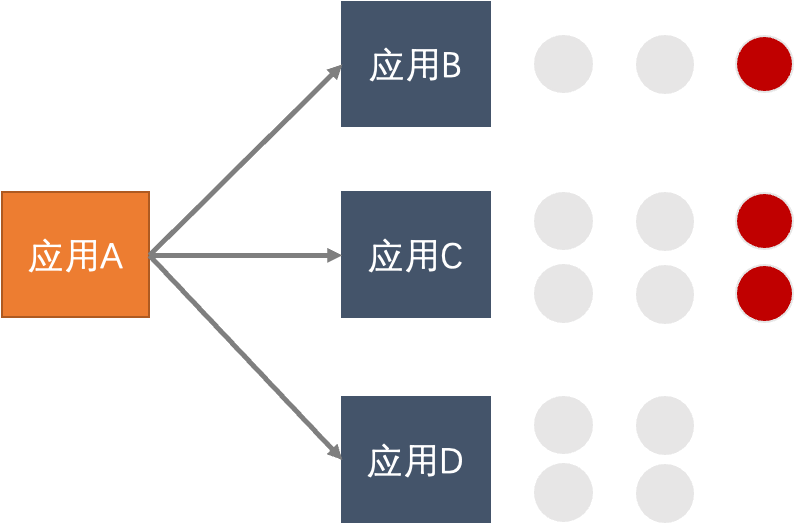 在业务峰值时刻,应用的某几台机器由于磁盘满,或者是宿主机资源争抢导致
load
很高,导致
consumer
出现调用超时,从而影响系统的整体稳定性。我们可以通过配置离群实例摘除规则,自动摘除异常的实例,避免单点故障引起的整体不可用问题。
展望
如今是
AI
技术突破爆发的时代,我们再脑洞大开一些,是否可以把
AI
技术结合到流量防护体系,基于
AI+
大数据的能力与策略来做到智能化保障服务稳定性呢?其实,
Sentinel
一直在进行自适应、智能化流量治理的探索,结合控制论、排队论、强化学习等理论与策略来达到自动
化保障业务稳定性的目标。目前
Sentinel
提供的基于
load + BBR
的自适应过载保护策略已经可以保障一部分场景下稳定性兜底,我们也在持续探索与演进,针对更多的稳定性场景进行落地。
作为技术小伙伴,大家是怎么看待
ChatGPT
,如何将
ChatGPT
运营在自己的业务和技术领域呢?欢迎交流,
留言点赞最高的
TOP10
,我们将送出
Nacos + Sentinel
的社区礼物
。
参考阅读:
能够做提炼精简
能够用总体来说-总结
总的来说,ChatGPT 超出了预期,激发了我的热情。晚上睡觉的时候都在考虑怎么问 ChatGPT,想看看他是怎么回答的,要知道上一次有这么高热情还是谈恋爱的时候,哈哈~
限流了。。我好奇的是,AI 也会限流?AI 能写限流代码吗?看来 Java 程序员这个工作还是能继续干下去的,哈哈。
作为一名从事微服务架构和稳定性的程序员,我立马就想了
ChatGPT
限流用的是什么技术呢?
- 基于 IP 限流 ?
- 那限流是在入口做的,还是在后端应用,或者算法层面做的呢?
- 那为什么要限流呢? 是系统还是单体应用撑不住了呢? 还是不具备弹性水平扩容能力呢?是不是采用微服务 + 容器架构能够大幅提升并发能力,快速弹性伸缩呢?
如果 ChatGPT 的后端已经云原生化,那么猜测是类似 Higress + Sentinel + Dubbo + Nacos + K8s 的技术栈,这样可以快速 构建高并发、高可用、自动弹性的后端体系。 (由于目前未从官方公开文档找到 ChatGPT 的后端架构,所以这里只是假设情况)
作为云计算从业者,就在思考了, ChatGPT 的现象级爆火,让很多公司都羡慕不已,在这个信息大爆炸的时代,每个公司都有着在短时间迅速爆火的可能,在机遇到来时,能不能抗住流量洪峰,保证服务的质量,抓住这次机遇呢?如何快速构建高并发、高可用的微服务架构呢? 我初步构思了一个架构,仅供参考讨论:
那么如何结合云原生网关与服务治理来保障业务的稳定性与连续性呢?下面来为大家进行揭秘。
- 通过细粒度流控与热点防护,避免业务超过承载能力导致不可用
面对突发的流量,流控能力可以将超出系统服务能力以外的请求拒绝掉。在应用层,建议结合容量评估,通过压测等手段评估流量阈值,针对核心 API 、接口、方法进行细粒度的流控配置,起到 “ 安全气囊 ” 的作用。注意并不是只有大流量场景才需要流控,任何服务与接口都有其容量上限,对于核心接口,无论流量大小,都需要配置流控来起到保护作用。
- 通过并发隔离与熔断,保障调用端不被不稳定服务拖垮
- 通过离群实例摘除解决实例单点异常问题
-
十亿人都在用的健康码,运维体系是怎么设计的?
- vivo 低代码平台【后羿】的探索与实践
- 分布式系统关键路径延迟分析实践
- 对话阿里云叔同:如何看待 2022 年云原生的发展,2023 年有哪些值得关注的技术?
- 美团外卖搜索基于Elasticsearch的优化实践