机器学习常用术语汇总,中英对照!
p pythonic生物人约 43 分钟
刚
接触机器学习框架 TensorFlow 的新手们,这篇由 Google 官方出品的常用术语词汇表,一定是你必不可少的入门资料!
本术语表列出了基本的机器学习术语和 TensorFlow 专用术语的定义,希望能帮助您快速熟悉 TensorFlow 入门内容,轻松打开机器学习世界的大门。
A
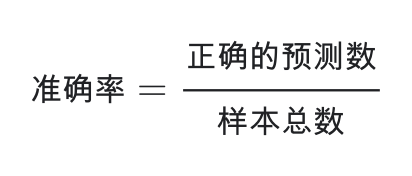
在二元分类中,准确率的定义如下:
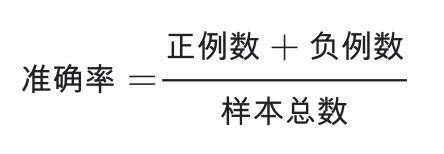
请参阅正例和负例。
距离原点的截距或偏移。偏差(也称为偏差项)在机器学习模型中用 或 表示。例如,在下面的公式中,偏差为 : 请勿与预测偏差混淆。
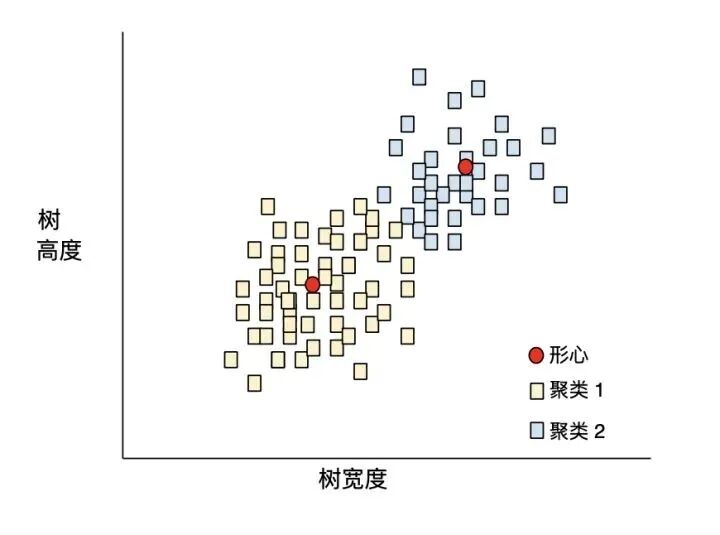
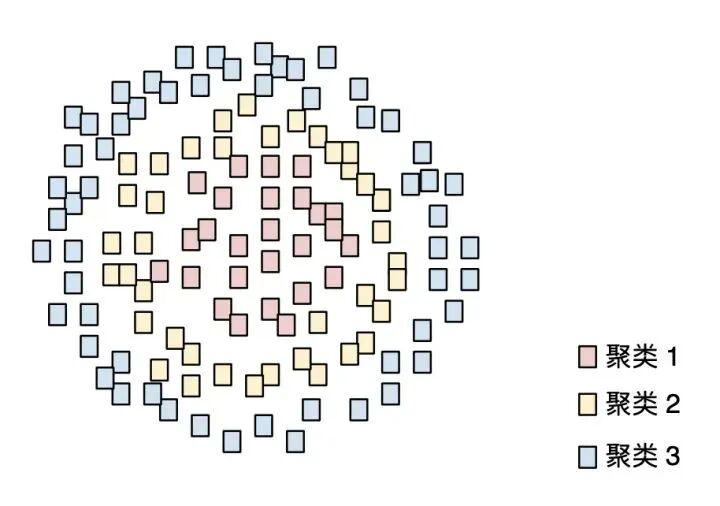
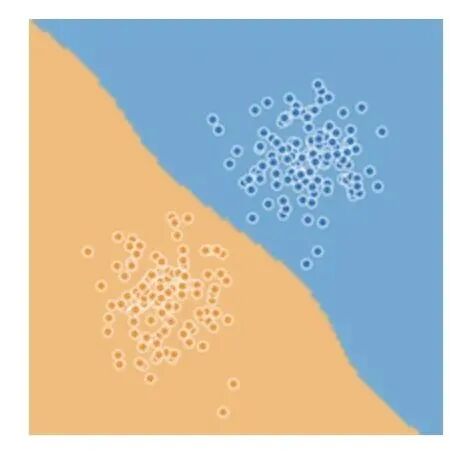
之后,研究人员便可查看这些聚类并进行其他操作,例如,将聚类 1 标记为“矮型树”,将聚类 2 标记为“全尺寸树”。 再举一个例子,例如基于样本与中心点距离的聚类算法,如下所示:
上面的混淆矩阵显示,在 19 个实际有肿瘤的样本中,该模型正确地将 18 个归类为有肿瘤(18 个正例),错误地将 1 个归类为没有肿瘤(1 个假负例)。同样,在 458 个实际没有肿瘤的样本中,模型归类正确的有 452 个(452 个负例),归类错误的有 6 个(6 个假正例)。 多类别分类问题的混淆矩阵有助于确定出错模式。例如,某个混淆矩阵可以揭示,某个经过训练以识别手写数字的模型往往会将 4 错误地预测为 9,将 7 错误地预测为 1。 混淆矩阵包含计算各种效果指标(包括精确率和召回率)所需的充足信息。
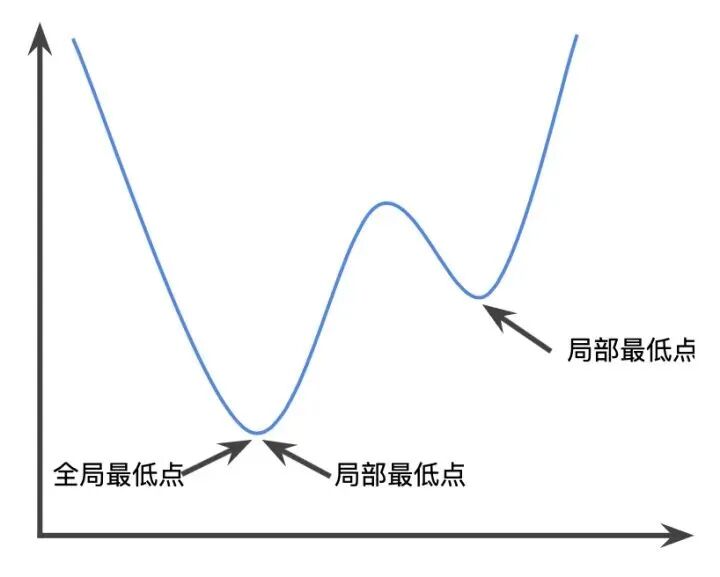
相反,以下函数则不是凸函数。请注意图像上方的区域如何不是凸集:
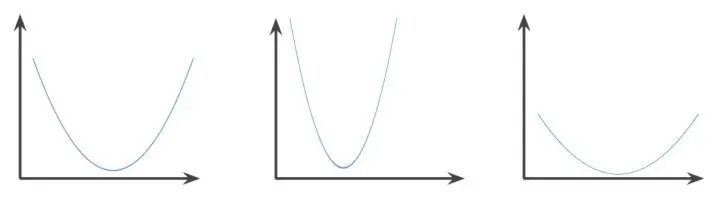
严格凸函数只有一个局部最低点,该点也是全局最低点。经典的 U 形函数都是严格凸函数。不过,有些凸函数(例如直线)则不是这样。 很多常见的损失函数(包括下列函数)都是凸函数:
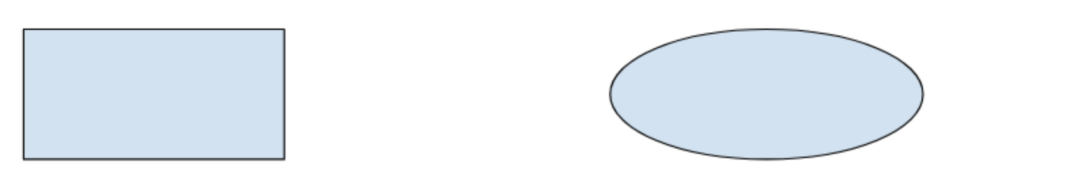
相反,下面的两个图形都不是凸集:
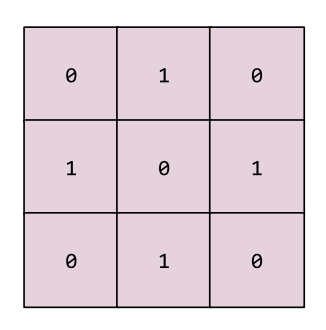
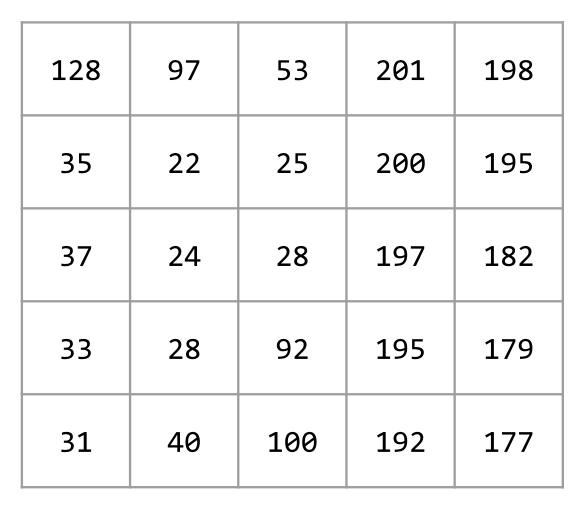
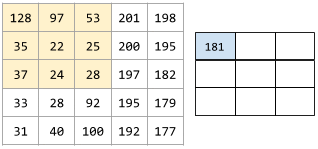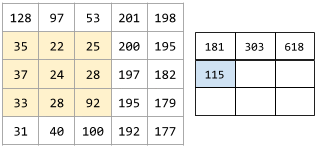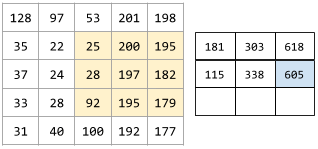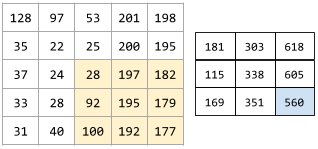
下面的动画显示了一个由 9 个卷积运算(涉及 5x5 输入矩阵)组成的卷积层。请注意,每个卷积运算都涉及一个不同的 3x3 输入矩阵切片。由此产生的 3×3 矩阵(右侧)就包含 9 个卷积运算的结果:
现在,以下面这个 2x2 卷积过滤器为例:
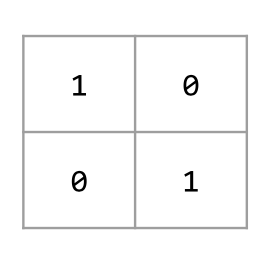
每个卷积运算都涉及一个 2x2 输入矩阵切片。例如,假设我们使用输入矩阵左上角的 2x2 切片。这样一来,对此切片进行卷积运算将如下所示:
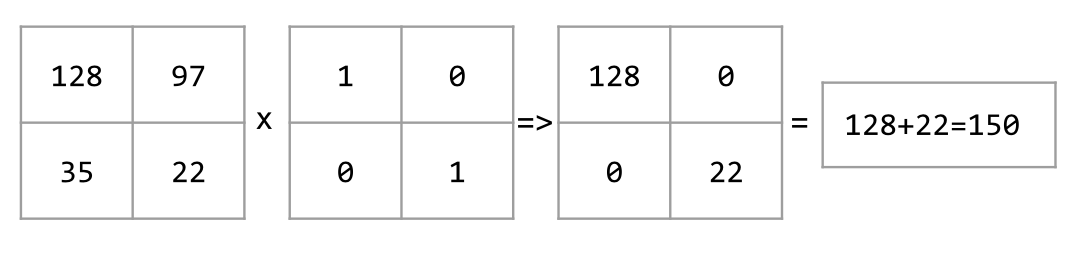
卷积层由一系列卷积运算组成,每个卷积运算都针对不同的输入矩阵切片。
其中“y'”表示分类器模型的原始输出:
“y”表示真标签,值为 -1 或 +1。 因此,合页损失与 (y * y') 的关系图如下所示:
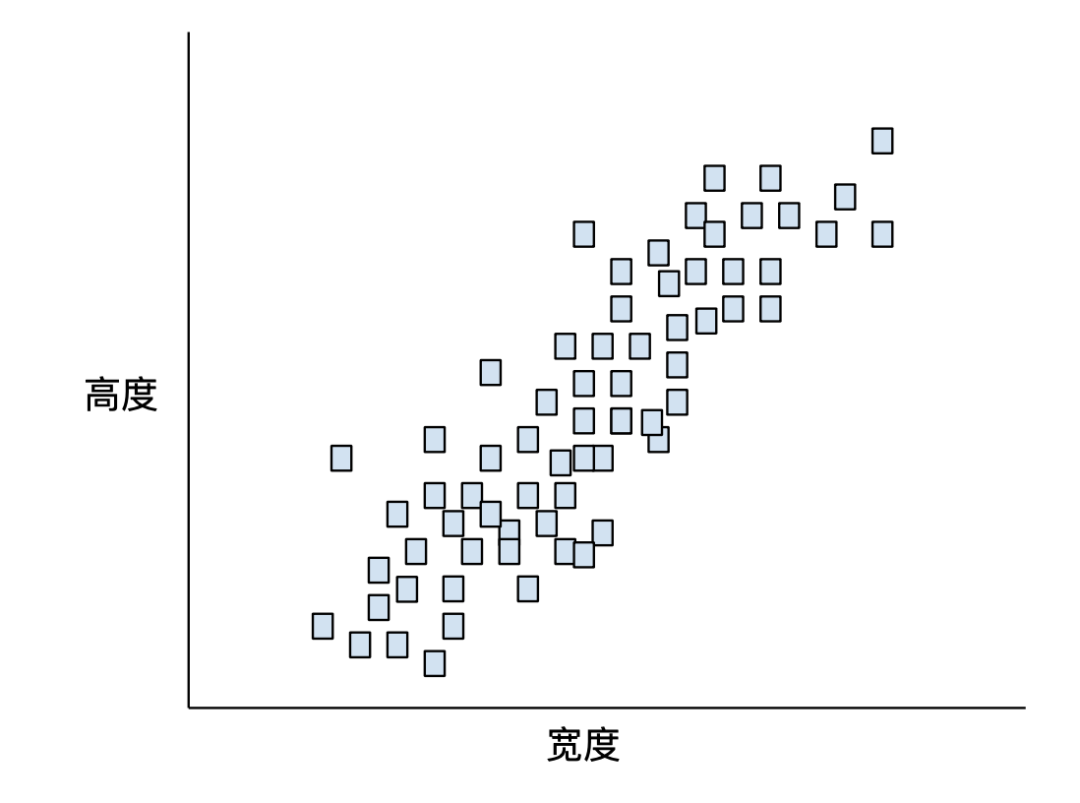
如果 k=3,则 k-means 算法会确定三个形心。每个样本都被分配到与其最接近的形心,最终产生三个组:
假设制造商想要确定小、中和大号狗毛衣的理想尺寸。在该聚类中,三个形心用于标识每只狗的平均高度和平均宽度。因此,制造商可能应该根据这三个形心确定毛衣尺寸。请注意,聚类的形心通常不是聚类中的样本。 上图显示了 k-means 应用于仅具有两个特征(高度和宽度)的样本。请注意,k-means 可以跨多个特征为样本分组。
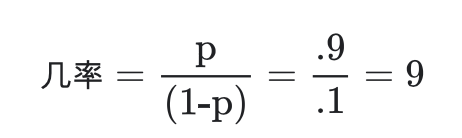
简单来说,对数几率即几率的对数。按照惯例,“对数”指自然对数,但对数的基数其实可以是任何大于 1 的数。若遵循惯例,上述示例的对数几率应为:
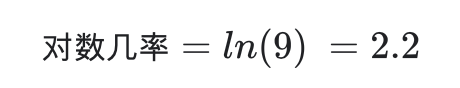
对数几率是S 型函数的反函数。
机器学习算法的基础架构。流水线包括收集数据、将数据放入训练数据文件、训练一个或多个模型,以及将模型导出到生产环境。
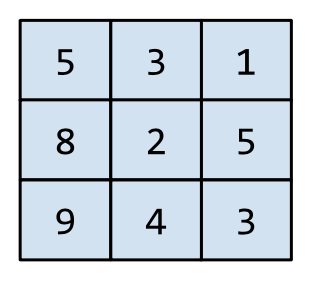
池化运算与卷积运算类似:将矩阵分割为多个切片,然后按步长逐个运行卷积运算。例如,假设池化运算按 1x1 步长将卷积矩阵分割为 2x2 个切片。如下图所示,进行了四个池化运算。假设每个池化运算都选择该切片中四个值的最大值:
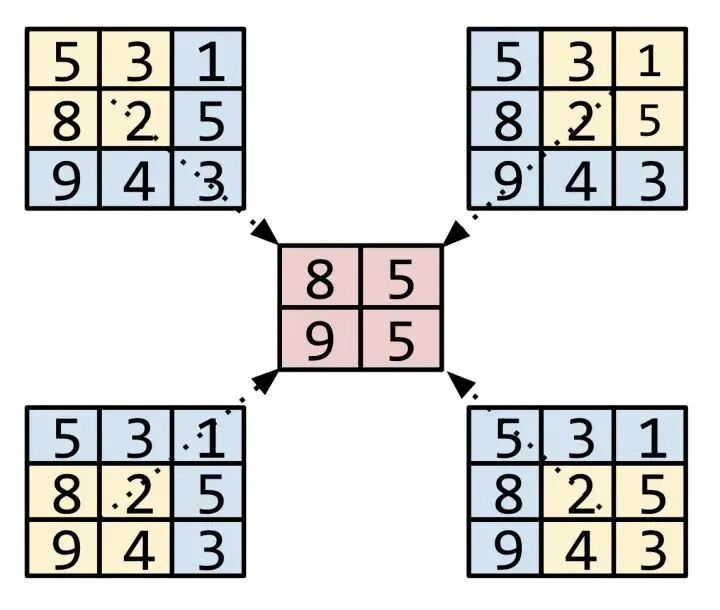
池化有助于在输入矩阵中实现平移不变性。
对于视觉应用来说,池化的更正式名称为空间池化。时间序列应用通常将池化称为时序池化。按照不太正式的说法,池化通常称为下采样或降采样。
换句话说,S 型函数可将 转换为介于 0 到 1 之间的概率。 在某些神经网络中,S 型函数可作为激活函数使用。
特征稀疏性是指特征向量的稀疏性;模型稀疏性是指模型权重的稀疏性。
 前面的示例演示了一个二维步长。如果输入矩阵为三维,那么步长也将是三维。
本术语表列出了基本的机器学习术语和 TensorFlow 专用术语的定义,希望能帮助您快速熟悉 TensorFlow 入门内容,轻松打开机器学习世界的大门。
A
- A/B 测试 (A/B testing)
- 准确率 (accuracy)
在二元分类中,准确率的定义如下:
请参阅正例和负例。
- 激活函数 (activation function)
- AdaGrad
- ROC 曲线下面积 (AUC, Area under the ROC Curve)
B
- 反向传播算法 (backpropagation)
- 基准 (baseline)
- 批次 (batch)
- 批次大小 (batch size)
- 偏差 (bias)
距离原点的截距或偏移。偏差(也称为偏差项)在机器学习模型中用 或 表示。例如,在下面的公式中,偏差为 : 请勿与预测偏差混淆。
- 二元分类 (binary classification)
- 分箱 (binning)
- 分桶 (bucketing)
C
- 校准层 (calibration layer)
- 候选采样 (candidate sampling)
- 分类数据 (categorical data)
house style
的分类特征为例,该特征拥有一组离散的可能值(共三个),即
Tudor, ranch, colonial
。通过将
house style
表示成分类数据,相应模型可以学习
Tudor
、
ranch
和
colonial
分别对房价的影响。
有时,离散集中的值是互斥的,只能将其中一个值应用于指定样本。例如,
car maker
分类特征可能只允许一个样本有一个值 (
Toyota
)。在其他情况下,则可以应用多个值。一辆车可能会被喷涂多种不同的颜色,因此,
car color
分类特征可能会允许单个样本具有多个值(例如
red
和
white
)。
分类特征有时称为离散特征。
与数值数据相对。
- 形心 (centroid)
- 检查点 (checkpoint)
- 类别 (class)
- 分类不平衡的数据集 (class-imbalanced data set)
- 分类模型 (classification model)
- 分类阈值 (classification threshold)
- 聚类 (clustering)
之后,研究人员便可查看这些聚类并进行其他操作,例如,将聚类 1 标记为“矮型树”,将聚类 2 标记为“全尺寸树”。 再举一个例子,例如基于样本与中心点距离的聚类算法,如下所示:
- 协同过滤 (collaborative filtering)
- 混淆矩阵 (confusion matrix)
上面的混淆矩阵显示,在 19 个实际有肿瘤的样本中,该模型正确地将 18 个归类为有肿瘤(18 个正例),错误地将 1 个归类为没有肿瘤(1 个假负例)。同样,在 458 个实际没有肿瘤的样本中,模型归类正确的有 452 个(452 个负例),归类错误的有 6 个(6 个假正例)。 多类别分类问题的混淆矩阵有助于确定出错模式。例如,某个混淆矩阵可以揭示,某个经过训练以识别手写数字的模型往往会将 4 错误地预测为 9,将 7 错误地预测为 1。 混淆矩阵包含计算各种效果指标(包括精确率和召回率)所需的充足信息。
- 连续特征 (continuous feature)
- 收敛 (convergence)
- 凸函数 (convex function)
相反,以下函数则不是凸函数。请注意图像上方的区域如何不是凸集:
严格凸函数只有一个局部最低点,该点也是全局最低点。经典的 U 形函数都是严格凸函数。不过,有些凸函数(例如直线)则不是这样。 很多常见的损失函数(包括下列函数)都是凸函数:
-
L2 损失函数 -
对数损失函数 -
L1 正则化 -
L2 正则化
- 凸优化 (convex optimization)
- 凸集 (convex set)
相反,下面的两个图形都不是凸集:
- 卷积 (convolution)
- 卷积过滤器 (convolutional filter)
- 卷积层 (convolutional layer)
下面的动画显示了一个由 9 个卷积运算(涉及 5x5 输入矩阵)组成的卷积层。请注意,每个卷积运算都涉及一个不同的 3x3 输入矩阵切片。由此产生的 3×3 矩阵(右侧)就包含 9 个卷积运算的结果:
- 卷积神经网络 (convolutional neural network)
-
卷积层 -
池化层 -
密集层
- 卷积运算 (convolutional operation)
-
对卷积过滤器和输入矩阵切片执行元素级乘法。(输入矩阵切片与卷积过滤器具有相同的等级和大小。) -
对生成的积矩阵中的所有值求和。
现在,以下面这个 2x2 卷积过滤器为例:
每个卷积运算都涉及一个 2x2 输入矩阵切片。例如,假设我们使用输入矩阵左上角的 2x2 切片。这样一来,对此切片进行卷积运算将如下所示:
卷积层由一系列卷积运算组成,每个卷积运算都针对不同的输入矩阵切片。
- 成本 (cost)
- 交叉熵 (cross-entropy)
- 自定义 Estimator (custom Estimator)
D
- 数据分析 (data analysis)
- DataFrame
- 数据集 (data set)
- Dataset API (tf.data)
tf.data.Dataset
对象表示一系列元素,其中每个元素都包含一个或多个张量。
tf.data.Iterator
对象可获取
Dataset
中的元素。
如需详细了解 Dataset API,请参阅《TensorFlow 编程人员指南》中的导入数据。
- 决策边界 (decision boundary)
- 密集层 (dense layer)
- 深度模型 (deep model)
- 密集特征 (dense feature)
- 设备 (device)
- 离散特征 (discrete feature)
- 丢弃正则化 (dropout regularization)
- 动态模型 (dynamic model)
E
- 早停法 (early stopping)
- 嵌套 (embeddings)
-
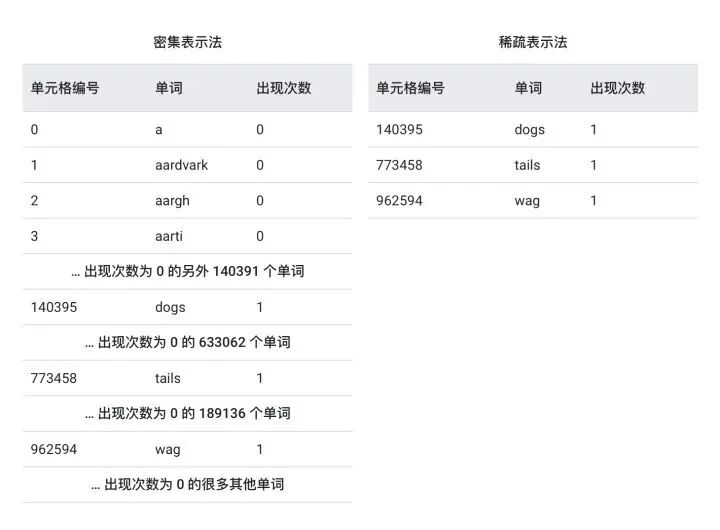
表示成包含百万个元素(高维度)的稀疏向量,其中所有元素都是整数。向量中的每个单元格都表示一个单独的英文单词,单元格中的值表示相应单词在句子中出现的次数。由于单个英文句子包含的单词不太可能超过 50 个,因此向量中几乎每个单元格都包含 0。少数非 0 的单元格中将包含一个非常小的整数(通常为 1),该整数表示相应单词在句子中出现的次数。 -
表示成包含数百个元素(低维度)的密集向量,其中每个元素都存储一个介于 0 到 1 之间的浮点值。这就是一种嵌套。
- 经验风险最小化 (ERM, empirical risk minimization)
- 集成学习 (ensemble)
-
不同的初始化 -
不同的超参数 -
不同的整体结构
- 周期 (epoch)
N
/批次大小)次训练迭代,其中
N
是样本总数。
- Estimator
tf.Estimator
类的一个实例,用于封装负责构建 TensorFlow 图并运行 TensorFlow 会话的逻辑。您可以创建自定义 Estimator(如需相关介绍,请点击此处),也可以实例化其他人预创建的 Estimator。
- 样本 (example)
F
- 假负例 (FN, false negative)
- 假正例 (FP, false positive)
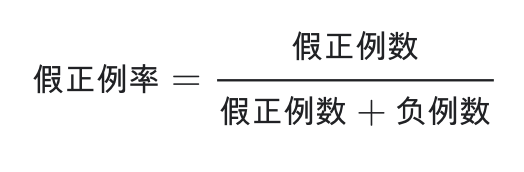
- 假正例率(false positive rate, 简称 FP 率)
- 特征 (feature)
- 特征列 (tf.feature_column)
tf.feature_column
函数,模型可对输入特征的不同表示法轻松进行实验。有关详情,请参阅《TensorFlow 编程人员指南》中的特征列一章。
“特征列”是 Google 专用的术语。特征列在 Yahoo/Microsoft 使用的 VW 系统中称为“命名空间”,也称为场。
- 特征组合 (feature cross)
- 特征工程 (feature engineering)
- 特征集 (feature set)
- 特征规范 (feature spec)
-
要提取的数据(即特征的键) -
数据类型(例如 float 或 int) -
长度(固定或可变)
- 少量样本学习 (few-shot learning)
- 完整 softmax (full softmax)
- 全连接层 (fully connected layer)
G
- 泛化 (generalization)
- 广义线性模型 (generalized linear model)
-
逻辑回归 -
多类别回归 -
最小二乘回归
-
最优的最小二乘回归模型的平均预测结果等于训练数据的平均标签。 -
最优的逻辑回归模型预测的平均概率等于训练数据的平均标签。
- 梯度 (gradient)
- 梯度裁剪 (gradient clipping)
- 梯度下降法 (gradient descent)
- 图 (graph)
H
- 启发法 (heuristic)
- 隐藏层 (hidden layer)
- 合页损失函数 (hinge loss)
其中“y'”表示分类器模型的原始输出:
“y”表示真标签,值为 -1 或 +1。 因此,合页损失与 (y * y') 的关系图如下所示:
- 维持数据 (holdout data)
- 超参数 (hyperparameter)
- 超平面 (hyperplane)
I
- 独立同等分布 (i.i.d, independently and identically distributed)
- 推断 (inference)
- 输入函数 (input function)
- 输入层 (input layer)
- 实例 (instance)
- 可解释性 (interpretability)
- 评分者间一致性信度 (inter-rater agreement)
- 迭代 (iteration)
K
- k-means
-
以迭代方式确定最佳的 k 中心点(称为形心)。 -
将每个样本分配到最近的形心。与同一个形心距离最近的样本属于同一个组。
如果 k=3,则 k-means 算法会确定三个形心。每个样本都被分配到与其最接近的形心,最终产生三个组:
假设制造商想要确定小、中和大号狗毛衣的理想尺寸。在该聚类中,三个形心用于标识每只狗的平均高度和平均宽度。因此,制造商可能应该根据这三个形心确定毛衣尺寸。请注意,聚类的形心通常不是聚类中的样本。 上图显示了 k-means 应用于仅具有两个特征(高度和宽度)的样本。请注意,k-means 可以跨多个特征为样本分组。
- k-median
-
对于 k-means,确定形心的方法是,最大限度地减小候选形心与它的每个样本之间的距离平方和。 -
对于 k-median,确定形心的方法是,最大限度地减小候选形心与它的每个样本之间的距离总和。
-
k-means 采用从形心到样本的欧几里得距离。(在二维空间中,欧几里得距离即使用勾股定理来计算斜边。)例如,(2,2) 与 (5,-2) 之间的 k-means 距离为:
-
k-median 采用从形心到样本的曼哈顿距离。这个距离是每个维度中绝对差异值的总和。例如,(2,2) 与 (5,-2) 之间的 k-median 距离为:
- Keras
- 核支持向量机 (KSVM, Kernel Support Vector Machines)
L
- L1 损失函数 (L₁ loss)
- L1 正则化 (L₁ regularization)
- L2 损失函数 (L₂ loss)
- L2 正则化 (L₂ regularization)
- 标签 (label)
- 有标签样本 (labeled example)
- lambda
- 层 (layer)
- Layers API (tf.layers)
-
通过
tf.layers.Dense构建全连接层。 -
通过
tf.layers.Conv2D构建卷积层。
- 学习速率 (learning rate)
- 最小二乘回归 (least squares regression )
- 线性回归 (linear regression)
- 逻辑回归 (logistic regression)
- 对数 (logits)
- 对数损失函数 (Log Loss)
- 对数几率 (log-odds)
简单来说,对数几率即几率的对数。按照惯例,“对数”指自然对数,但对数的基数其实可以是任何大于 1 的数。若遵循惯例,上述示例的对数几率应为:
对数几率是S 型函数的反函数。
- 损失 (Loss)
M
- 机器学习 (machine learning)
- 均方误差 (MSE, Mean Squared Error)
- 指标 (metric)
- Metrics API (tf.metrics)
tf.metrics.accuracy
用于确定模型的预测与标签匹配的频率。在编写自定义 Estimator 时,您可以调用 Metrics API 函数来指定应如何评估您的模型。
- 小批次 (mini-batch)
- 小批次随机梯度下降法 (SGD, mini-batch stochastic gradient descent)
- ML
- 模型 (model)
-
一种 TensorFlow 图,用于表示预测的计算结构。
-
该 TensorFlow 图的特定权重和偏差,通过训练决定。
- 模型函数 (model function)
- 模型训练 (model training)
- 动量 (Momentum)
- 多类别分类 (multi-class classification)
- 多项分类 (multinomial classification)
N
- NaN 陷阱 (NaN trap)
- 负类别 (negative class)
- 神经网络 (neural network)
- 神经元 (neuron)
- 节点 (node)
-
隐藏层中的神经元。 -
TensorFlow 图中的操作。
- 标准化 (normalization)
- 数值数据 (numerical data)
20000
在效力上并不是邮政编码 10000 的两倍(或一半)。此外,虽然不同的邮政编码确实与不同的房地产价值有关,但我们也不能假设邮政编码为 20000 的房地产在价值上是邮政编码为 10000 的房地产的两倍。邮政编码应表示成分类数据。
数值特征有时称为连续特征。
- Numpy
O
- 目标 (objective)
- 离线推断 (offline inference)
- 独热编码 (one-hot encoding)
-
一个元素设为 1。 -
所有其他元素均设为 0。
- 单样本学习(one-shot learning,通常用于对象分类)
- 一对多 (one-vs.-all)
-
动物和非动物 -
蔬菜和非蔬菜 -
矿物和非矿物
- 在线推断 (online inference)
- 操作 (op, Operation)
- 优化器 (optimizer)
-
动量 (Momentum) -
更新频率(AdaGrad = ADAptive GRADient descent;Adam = ADAptive with Momentum;RMSProp) -
稀疏性/正则化 (Ftrl) -
更复杂的数学方法(Proximal,等等)
- 离群值 (outlier)
-
绝对值很高的权重。 -
与实际值相差很大的预测值。 -
值比平均值高大约 3 个标准偏差的输入数据。
- 输出层 (output layer)
- 过拟合 (overfitting)
P
- Pandas
- 参数 (parameter)
- 参数服务器 (PS, Parameter Server)
- 参数更新 (parameter update)
- 偏导数 (partial derivative)
- 划分策略 (partitioning strategy)
- 性能 (performance)
-
在软件工程中的传统含义。即:相应软件的运行速度有多快(或有多高效)? -
在机器学习中的含义。在机器学习领域,性能旨在回答以下问题:相应模型的准确度有多高?即模型在预测方面的表现有多好?
- 困惑度 (perplexity)
- 流水线 (pipeline)
机器学习算法的基础架构。流水线包括收集数据、将数据放入训练数据文件、训练一个或多个模型,以及将模型导出到生产环境。
池化 (pooling)
将一个或多个由前趋的**卷积层**创建的矩阵压缩为较小的矩阵。池化通常是取整个池化区域的最大值或平均值。以下面的 3x3 矩阵为例:- 正类别 (positive class)
- 精确率 (precision)
- 预测 (prediction)
- 预测偏差 (prediction bias)
- 预创建的 Estimator (pre-made Estimator)
DNNClassifier
、
DNNRegressor
和
LinearClassifier
。您可以按照这些说明构建自己预创建的 Estimator。
- 预训练模型 (pre-trained model)
- 先验信念 (prior belief)
Q
- 队列 (queue)
R
- 等级 (rank)
-
张量中的维数。例如,标量等级为 0,向量等级为 1,矩阵等级为 2。 -
在将类别从最高到最低进行排序的机器学习问题中,类别的顺序位置。例如,行为排序系统可以将狗狗的奖励从最高(牛排)到最低(枯萎的羽衣甘蓝)进行排序。
- 评分者 (rater)
- 召回率 (recall)
- 修正线性单元 (ReLU, Rectified Linear Unit)
-
如果输入为负数或 0,则输出 0。 -
如果输入为正数,则输出等于输入。
- 回归模型 (regression model)
- 正则化 (regularization)
-
L1 正则化 -
L2 正则化 -
丢弃正则化 -
早停法(这不是正式的正则化方法,但可以有效限制过拟合)
- 正则化率 (regularization rate)
- 表示法 (representation)
- 受试者工作特征曲线(receiver operating characteristic,简称 ROC 曲线)
- 根目录 (root directory)
- 均方根误差 (RMSE, Root Mean Squared Error)
- 旋转不变性 (rotational invariance)
S
- SavedModel
- Saver
- 缩放 (scaling)
- scikit-learn
- 半监督式学习 (semi-supervised learning)
- 序列模型 (sequence model)
- 会话 (tf.session)
tf.session
对象。在使用 Estimator API 时,Estimator 会为您创建会话对象。
- S 型函数 (sigmoid function)
换句话说,S 型函数可将 转换为介于 0 到 1 之间的概率。 在某些神经网络中,S 型函数可作为激活函数使用。
- 大小不变性 (size invariance)
- softmax
- 稀疏特征 (sparse feature)
- 稀疏表示法 (sparse representation)
-
要采用密集表示法来表示此句子,则必须为所有一百万个单元格设置一个整数,然后在大部分单元格中放入 0,在少数单元格中放入一个非常小的整数。 -
要采用稀疏表示法来表示此句子,则仅存储象征句子中实际存在的单词的单元格。因此,如果句子只包含 20 个独一无二的单词,那么该句子的稀疏表示法将仅在 20 个单元格中存储一个整数。
- 稀疏性 (sparsity)
特征稀疏性是指特征向量的稀疏性;模型稀疏性是指模型权重的稀疏性。
- 空间池化 (spatial pooling)
- 平方合页损失函数 (squared hinge loss)
- 平方损失函数 (squared loss)
- 静态模型 (static model)
- 平稳性 (stationarity)
- 步 (step)
- 步长 (step size)
- 随机梯度下降法 (SGD, stochastic gradient descent)
- 结构风险最小化 (SRM, structural risk minimization)
-
期望构建最具预测性的模型(例如损失最低)。 -
期望使模型尽可能简单(例如强大的正则化)。
- 步长 (stride)
- 下采样 (subsampling)
- 总结 (summary)
- 监督式机器学习 (supervised machine learning)
- 合成特征 (synthetic feature)
-
对连续特征进行分桶,以分为多个区间分箱。 -
将一个特征值与其他特征值或其本身相乘(或相除)。 -
创建一个特征组合。
T
- 目标 (target)
- 时态数据 (temporal data)
- 张量 (Tensor)
- 张量处理单元 (TPU, Tensor Processing Unit)
- 张量等级 (Tensor rank)
- 张量形状 (Tensor shape)
- 张量大小 (Tensor size)
- TensorBoard
- TensorFlow
- TensorFlow Playground
- TensorFlow Serving
- 测试集 (test set)
- tf.Example
- 时间序列分析 (time series analysis)
- 训练 (training)
- 训练集 (training set)
- 迁移学习 (transfer learning)
- 平移不变性 (translational invariance)
- 负例 (TN, true negative)
- 正例 (TP, true positive)
- 正例率(true positive rate, 简称 TP 率)
U
- 无标签样本 (unlabeled example)
- 非监督式机器学习 (unsupervised machine learning)
V
- 验证集 (validation set)
W
- 权重 (weight)
- 宽度模型 (wide model)
仅学术分享,原文出处:https://developers.google.cn/machine-learning/glossary?hl=zh-CN- END-