百度内容理解推理服务FaaS实战——Punica系统
高 高可用架构约 10 分钟
GEEK TALK
01
背景
内容理解服务是对百家号、好看、全民、直播等多个发文方的文本、图片、视频等内容进行理解,并标记内容标签,为百度Feed信息流、搜索等C端用户提供内容,例如,自媒体用户在百家号提交了一篇关于美食的文章,经过内容理解的推荐策略服务,会进行理解并标记美食标签,然后Feed信息流会基于内容标签和浏览用户的爱好进行匹配推荐。
内容理解服务是架构统一 微服务 推理框架,不同业务自建服务App,在架构平台上注册和管理,基于 PaaS 进行调度,共有近千的 CPU 和 GPU 类型的服务App。在业务接入、迭代、运维过程中存在如下问题:
在开发阶段,推理框架参数多、配置成本高,且推理服务封装后性能降低;在测试阶段,测试数据构造成本高, 测试资源 不足,且每次补充测试资源均需要创建一个单实例的App, 补充成本高 ;在上线阶段,业务同学需要学习厂内多个 PaaS平台 的应用创建流程,监控&报警添加繁琐,新服务接入需要操作多个平台,协调等待线上资源,正常情况下完成上线需要两周, 而策略迭代频繁,平均每个月要新增数十策略服务,服务接入存在较高的人力消耗 ;在部署&运维阶段,由于服务部署依赖较多较大lib包下载,新实例部署耗时20+分钟,服务存在低弹性、扩容 止损 慢等问题,另外存量服务有近千App,架构升级成本高,架构框架、 云原生 改造等均需要操作大量App;另外服务的资源利用率低,存在较大的资源浪费,业务成本高且新服务上线资源准备成本高。
GEEK TALK 02 整体思路 为了解决上述问题,我们考虑如何提升业务接入、迭代、维护的效率,同时提升资源利用效率,降低业务成本,主要从两个方面展开:一站式+无人值守。 2.1 一站式平台 平台加一减N :将多个平台统一至Punica平台,减少用户学习和使用成本,无需创建PaaS服务,提供一站式推理服务接入、迭代、测试、上线、运维等功能。 提升服务迭代速度 :将服务参数配置平台化,提供推荐参数配置,测试期间支持快速修改验证;测试资源快速补充,无需创建PaaS服务;提供自动化测试任务,用户仅需提交测试任务,由Punica系统自动调配闲时资源,自动调节压测参数,用户只需关注最终测试结果;支持业务快速小流量验证,使用系统内的冗余资源先行小流量验证效果;对于新服务上线,可以自动增加监控、报警,减少用户操作成本。 降低业务资源成本 :在支持通用性&易用性的Python微服务推理框架的同时,还支持高性能C++微服务推理框架;支持多种GPU卡,例如T4、P4、A10、A30以及高性价比的昆仑卡, 通过联合厂内GPU同学,基于CGPU、MPS、MIG等机制,支持小规格(半卡、1/4卡等)的GPU卡配额;在调度层面,可以自动调度多模型在GPU卡上混部;同时,Punica还集成了PaddlePaddle的模型性能优化流程,从模型层面降低业务资源成本。 通过一站式平台,用户将训练好的模型以及前后置处理代码提交到模型仓库和代码仓库,在Punica平台注册服务、测试、上线,减少了跨平台操作、测试环境准备、等待资源投产等耗时,整体上线周期从两周降低到一周,减少用户学习成本。
在 容量管理 方面,服务的频繁迭代会带来众多问题,例如:新旧服务切换,旧服务没有及时下线,导致资源浪费;服务 容量评估 不准确,线上服务存在容量风险或者资源浪费;业务流量变化频繁,服务拓扑结构复杂,人工调整成本高。针对这类问题,从几个方面进行了 容量治理 :低利用率服务资源回收,解决服务下线、容量评估不准确导致的资源浪费问题;基于服务资源负载的容量自动扩缩,解决服务容量风险问题,减少人工操作成本;基于服务流量预测的分时伸缩,形成一定的闲时 资源池 ,供给给闲时任务使用。另外,也通过多模型混部、GPU混部等技术解决小卡服务以及极限利用率较低的模型的资源利用率问题。
GEEK TALK 03 技术方案
首先给大家介绍一下Punica系统中用到的云原生概念:IaaS,基础设施即服务,容器服务如docker;PaaS,平台即服务,容器调度系统如EKS、Kubernetes;FaaS,函数即服务,Punica系统中推理模型即服务。
我们从FaaS角度,重新定义推理服务,建设一站式平台和无人值守机制,隔离业务与PaaS部署,让业务更轻量、更简洁。通过隔离业务与PaaS基础环境,解耦了业务与基础环境,架构可以对基础环境进行统一管理和收敛,提升服务部署速度,使业务服务具备高弹性。
整体架构如下图所示,主要包括四部分: FaaS系统,包括容器框架、调度系统、P roxy 网关 模块,提供推理服务高弹性部署与调度; 平台前端,提供统一的推理服务接入、测试、上线 、管理页面,资源报表展现,伸缩&自愈事件展现等 ; 平台后端,提供对应页面的后端功能,同时支持 OpenAPI 调用,提供FaaS 服务管理 、服务测试迭代、资源管理等; 服务治理,提供FaaS服务自愈巡检、容量伸缩等。
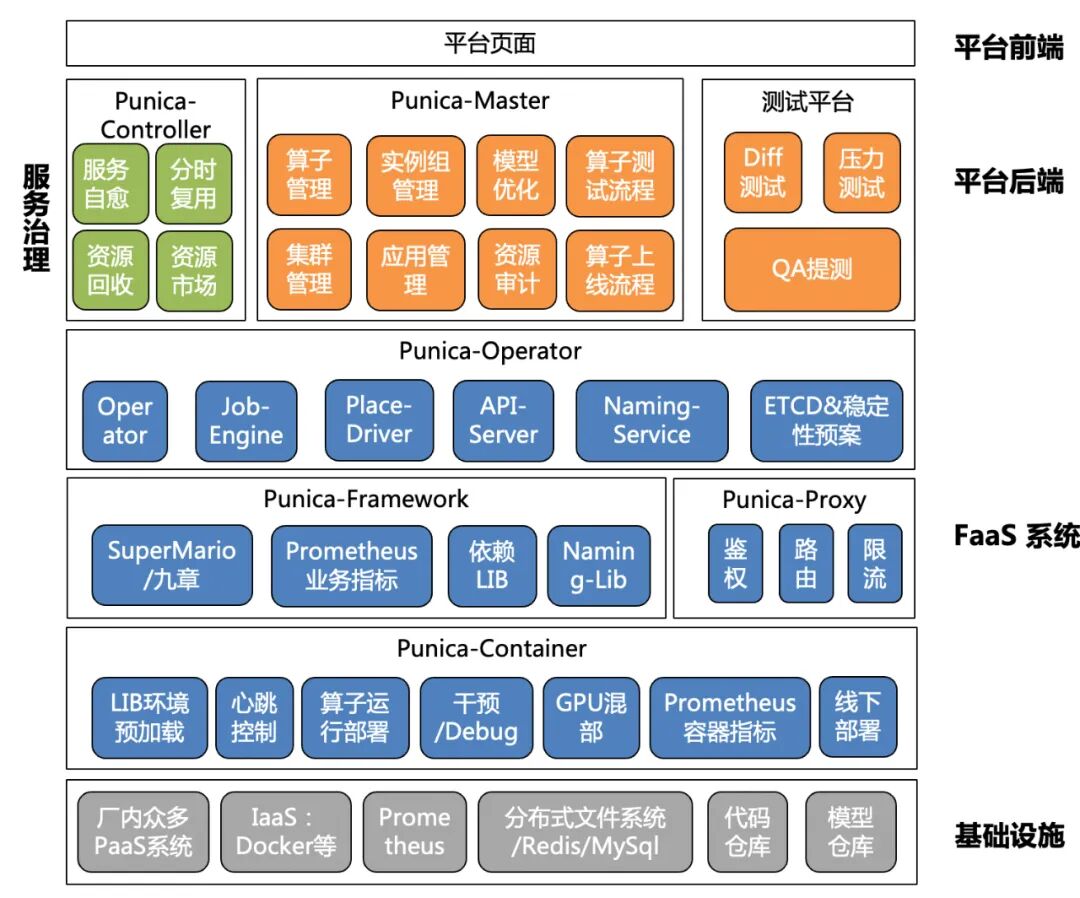
其中平台前/后端作为Punica系统的服务接入、系统管理平台。下面主要介绍FaaS系统和服务治理机制。
3.1 服务部署 建设Punica容器框架,对接并改造推理微服务框架,将业务环境与基础环境分离,对基础环境进行托管,同时收敛基础环境的版本;从框架层对接Prometheus监控,将容器、机器、业务指标上报,由百度云Prometheus团队提供统一的监控视图和报警。
下面简单介绍下容器框架的功能点:心跳机制,提供探活能力,上报调度系统该节点是否正常运行以及该节点上部署的推理服务信息&状态,同时接收调度系统下发的服务更新、创建、删除等命令;部署能力,支持服务的创建、更新、重启、删除、停止等功能,同时可以配置lib预下载,提前下载相关lib包,服务部署仅需下载模型包即可;干预机制,支持停止心跳、屏蔽流量、屏蔽心跳命令的干预接口;Debug机制,支持节点信息查询,包括节点部署路径、部署服务信息等;线下部署能力,支持线下单独部署,用于本地测试。
调度系统完成了推理服务的Resource到PaaS App、Replica到Node的映射,通过映射关系,实现了推理服务的容量伸缩、实例迁移、版本更新等机制。
首先来介绍一下Punica中推理服务部署的拓扑信息如何获取,上面讲到了调度系统完成了推理服务到PaaS App的映射,因此调度系统可以提供推理服务每一个Replica部署所在容器的IP、Port。对于一个推理服务,我们就可以通过查询调度系统来获取该推理服务部署在Punica中的节点访问地址列表。
通过调度系统,我们可以获取到指定服务的地址列表,为了降低用户的使用成本,同时支持限流和鉴权功能,我们建设了推理服务统一网关模块。网关模块定义了用户名、token、特征id,由这三个字段定义一组路由配置,具体包括服务地址、鉴权配置、限流配置。通过自定义baidu-rpc的naming插件,查询 Punica服务地址,实现路由能力;通过请求中的用户名、token、特征id进行鉴权;根据用户名、token、特征id增加限流配置。
GEEK TALK 04
参考阅读:
本文由高可用架构转载。技术原创及架构实践文章,欢迎通过公众号菜单「联系我们」进行投稿
内容理解服务是架构统一 微服务 推理框架,不同业务自建服务App,在架构平台上注册和管理,基于 PaaS 进行调度,共有近千的 CPU 和 GPU 类型的服务App。在业务接入、迭代、运维过程中存在如下问题:
在开发阶段,推理框架参数多、配置成本高,且推理服务封装后性能降低;在测试阶段,测试数据构造成本高, 测试资源 不足,且每次补充测试资源均需要创建一个单实例的App, 补充成本高 ;在上线阶段,业务同学需要学习厂内多个 PaaS平台 的应用创建流程,监控&报警添加繁琐,新服务接入需要操作多个平台,协调等待线上资源,正常情况下完成上线需要两周, 而策略迭代频繁,平均每个月要新增数十策略服务,服务接入存在较高的人力消耗 ;在部署&运维阶段,由于服务部署依赖较多较大lib包下载,新实例部署耗时20+分钟,服务存在低弹性、扩容 止损 慢等问题,另外存量服务有近千App,架构升级成本高,架构框架、 云原生 改造等均需要操作大量App;另外服务的资源利用率低,存在较大的资源浪费,业务成本高且新服务上线资源准备成本高。
GEEK TALK 02 整体思路 为了解决上述问题,我们考虑如何提升业务接入、迭代、维护的效率,同时提升资源利用效率,降低业务成本,主要从两个方面展开:一站式+无人值守。 2.1 一站式平台 平台加一减N :将多个平台统一至Punica平台,减少用户学习和使用成本,无需创建PaaS服务,提供一站式推理服务接入、迭代、测试、上线、运维等功能。 提升服务迭代速度 :将服务参数配置平台化,提供推荐参数配置,测试期间支持快速修改验证;测试资源快速补充,无需创建PaaS服务;提供自动化测试任务,用户仅需提交测试任务,由Punica系统自动调配闲时资源,自动调节压测参数,用户只需关注最终测试结果;支持业务快速小流量验证,使用系统内的冗余资源先行小流量验证效果;对于新服务上线,可以自动增加监控、报警,减少用户操作成本。 降低业务资源成本 :在支持通用性&易用性的Python微服务推理框架的同时,还支持高性能C++微服务推理框架;支持多种GPU卡,例如T4、P4、A10、A30以及高性价比的昆仑卡, 通过联合厂内GPU同学,基于CGPU、MPS、MIG等机制,支持小规格(半卡、1/4卡等)的GPU卡配额;在调度层面,可以自动调度多模型在GPU卡上混部;同时,Punica还集成了PaddlePaddle的模型性能优化流程,从模型层面降低业务资源成本。 通过一站式平台,用户将训练好的模型以及前后置处理代码提交到模型仓库和代码仓库,在Punica平台注册服务、测试、上线,减少了跨平台操作、测试环境准备、等待资源投产等耗时,整体上线周期从两周降低到一周,减少用户学习成本。
在 容量管理 方面,服务的频繁迭代会带来众多问题,例如:新旧服务切换,旧服务没有及时下线,导致资源浪费;服务 容量评估 不准确,线上服务存在容量风险或者资源浪费;业务流量变化频繁,服务拓扑结构复杂,人工调整成本高。针对这类问题,从几个方面进行了 容量治理 :低利用率服务资源回收,解决服务下线、容量评估不准确导致的资源浪费问题;基于服务资源负载的容量自动扩缩,解决服务容量风险问题,减少人工操作成本;基于服务流量预测的分时伸缩,形成一定的闲时 资源池 ,供给给闲时任务使用。另外,也通过多模型混部、GPU混部等技术解决小卡服务以及极限利用率较低的模型的资源利用率问题。
GEEK TALK 03 技术方案
首先给大家介绍一下Punica系统中用到的云原生概念:IaaS,基础设施即服务,容器服务如docker;PaaS,平台即服务,容器调度系统如EKS、Kubernetes;FaaS,函数即服务,Punica系统中推理模型即服务。
我们从FaaS角度,重新定义推理服务,建设一站式平台和无人值守机制,隔离业务与PaaS部署,让业务更轻量、更简洁。通过隔离业务与PaaS基础环境,解耦了业务与基础环境,架构可以对基础环境进行统一管理和收敛,提升服务部署速度,使业务服务具备高弹性。
整体架构如下图所示,主要包括四部分: FaaS系统,包括容器框架、调度系统、P roxy 网关 模块,提供推理服务高弹性部署与调度; 平台前端,提供统一的推理服务接入、测试、上线 、管理页面,资源报表展现,伸缩&自愈事件展现等 ; 平台后端,提供对应页面的后端功能,同时支持 OpenAPI 调用,提供FaaS 服务管理 、服务测试迭代、资源管理等; 服务治理,提供FaaS服务自愈巡检、容量伸缩等。
3.1 服务部署 建设Punica容器框架,对接并改造推理微服务框架,将业务环境与基础环境分离,对基础环境进行托管,同时收敛基础环境的版本;从框架层对接Prometheus监控,将容器、机器、业务指标上报,由百度云Prometheus团队提供统一的监控视图和报警。
下面简单介绍下容器框架的功能点:心跳机制,提供探活能力,上报调度系统该节点是否正常运行以及该节点上部署的推理服务信息&状态,同时接收调度系统下发的服务更新、创建、删除等命令;部署能力,支持服务的创建、更新、重启、删除、停止等功能,同时可以配置lib预下载,提前下载相关lib包,服务部署仅需下载模型包即可;干预机制,支持停止心跳、屏蔽流量、屏蔽心跳命令的干预接口;Debug机制,支持节点信息查询,包括节点部署路径、部署服务信息等;线下部署能力,支持线下单独部署,用于本地测试。
调度系统完成了推理服务的Resource到PaaS App、Replica到Node的映射,通过映射关系,实现了推理服务的容量伸缩、实例迁移、版本更新等机制。
首先来介绍一下Punica中推理服务部署的拓扑信息如何获取,上面讲到了调度系统完成了推理服务到PaaS App的映射,因此调度系统可以提供推理服务每一个Replica部署所在容器的IP、Port。对于一个推理服务,我们就可以通过查询调度系统来获取该推理服务部署在Punica中的节点访问地址列表。
通过调度系统,我们可以获取到指定服务的地址列表,为了降低用户的使用成本,同时支持限流和鉴权功能,我们建设了推理服务统一网关模块。网关模块定义了用户名、token、特征id,由这三个字段定义一组路由配置,具体包括服务地址、鉴权配置、限流配置。通过自定义baidu-rpc的naming插件,查询 Punica服务地址,实现路由能力;通过请求中的用户名、token、特征id进行鉴权;根据用户名、token、特征id增加限流配置。
GEEK TALK 04
总结
我们从业务迭代、资源提效出发,结合当前推理服务开发、部署、运维现状,尝试了从FaaS角度来建设Punica系统,提升业务迭代效率,平台加一减N,新服务上线效率提升100%,保障线上服务的稳定性,服务扩容速度提升5倍,降低业务的资源成本,目前已累计回收400+张GPU卡,已经投产到新业务的迭代发展。参考阅读:
本文由高可用架构转载。技术原创及架构实践文章,欢迎通过公众号菜单「联系我们」进行投稿