如何选择合适的云数据库架构与规格
云 orczhou约 22 分钟
3月25日,NineData 联合创始人周振兴(苏普)受邀参加
2023年
ACMUG 第一站西安站,发表了《云数据库架构与选型》主题演讲。
ACMUG,全称为中国MySQL用户组 (All China MySQL User Group) ,是 MySQL 和 MariaDB 在中国最大的技术社区,是得到了 Oracle User Group Community、MairaDB Foundation、中国计算机行业协会开源数据库专业委员会等官方认可的社区组织,
ACMUG
会邀请国内外顶尖互联网公司和大型企业技术专家,分享其在数据库、大数据、云原生、AIOps 等技术方向上的经验以及最新进展。
01 AWS:选择合适的 RDS 架构与规格
1.1 架构与规格大图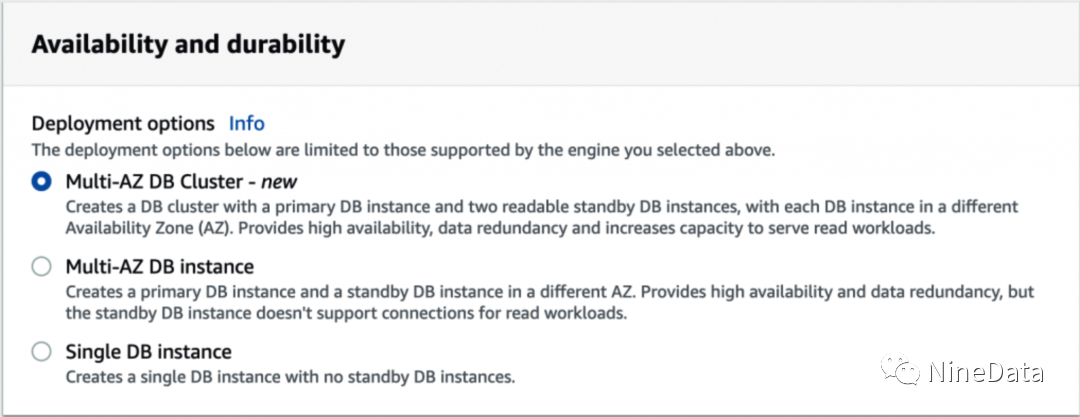 当前,多可
用区集群版是标准模板中的第一个、也是默认选项。
关于该版本的架构、优缺点等相关信息可以参考该文章获得更多详细内容:
AWS RDS 发布三节点形态,哪些业务场景应该选择?
1.3 CPU 架构
主流的云厂商都逐步开始提供 X86 和 ARM 架构的 CPU,AWS 在这方面是在这方面动作最早的。在2018年 re:Invent 上推出了第一代的 Graviton,2019年推出了 Graviton 2,2021年推出了 Graviton 3
。可以认为,当前产品已经有一定的成熟度,根据 Percona 做的 MySQL 测试,我们也看到,Graviton 在不同的并发类型,都表现出了与 Intel X86 差不多的性能,并且在高并发(并发数超过 CPU 核心数量)时,Graviton 表现还要更好一些。
性能比较接近,成本又更低,所以,目前已经有不少客户在尝试通过 Graviton 实例降低成本。目前,AWS RDS 也有非常多的 Graviton 的规格供选择。
当前的建议是:可以考虑在部分业务中尝试使用 Graviton 降低成本,根据企业内部的负载情况,再逐步考虑扩大范围使用。
另外,值得一提的是,AWS RDS 提供的最大规格是 db.x2iedn.32xlarge,具备 128vCPU 4096GB,一般来说,企业内部绝绝大多数业务都是满足需要的。
1.4 存储层
接着来看看 AWS RDS 提供了哪些存储类型。
AWS RDS 当前主流的存储类型包括了 gp2、gp3、io1(预留 IOPS 的 SSD),以及一个已经过时的 HDD 存储。其中:
2.1 架构与规格大图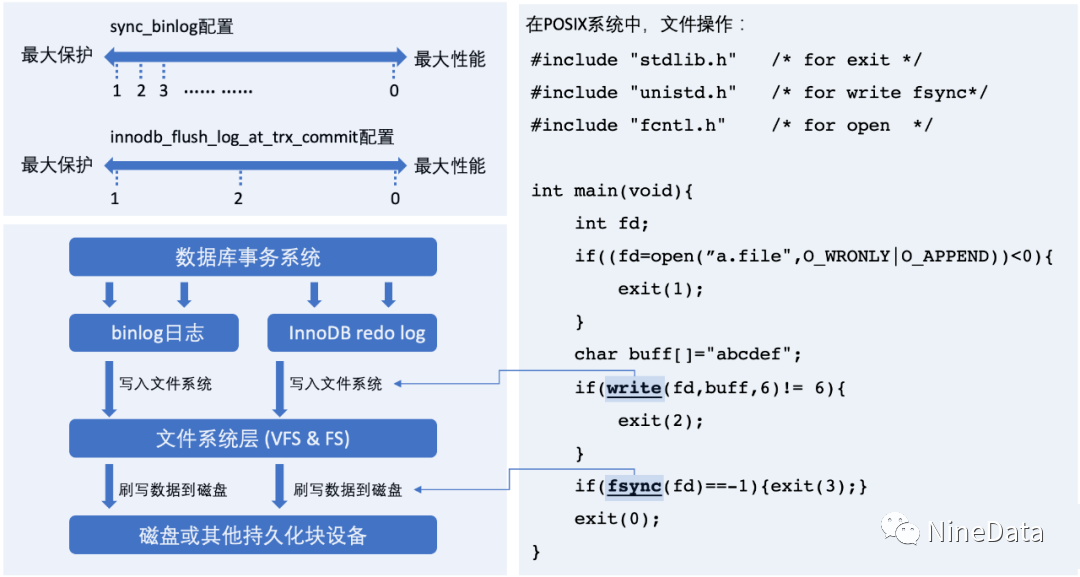 这时,再回头看看阿里云 RDS 的参数模板。在高性能模板中,”sync_binlog=1000, innodb_flush_log_at_trx_commit=2, async”,代表了在写入1000个 binlog 日志后再进行刷写数据到磁盘的操作,InnoDB 的日志则都会先写入文件系统,然后每隔一秒进行一次刷写数据到磁盘。在“默认模式下,“默认:sync_binlog=1, innodb_flush_log_at_trx_commit=1, semi-sync”,则是最严格的日志模式,也就是会保障每个事务日志安全的刷写到磁盘。
日志的刷写模式对性能有非常大的影响。如果不去关注这些参数,就直接去测试不同云厂商的性能,则会发现,云厂商之间的 RDS 有着非常大的性能差异。通常,这些差异并不是厂商之前的技术能力导致的,更多的是由于他们在对于安全性和性能的平衡时,选择的不同的平衡点。
2.3 资源复用与规格
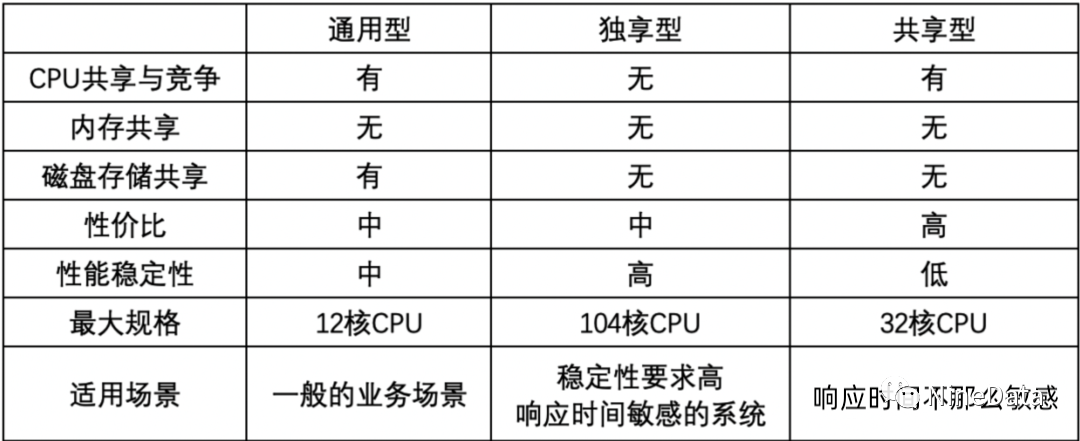
从资源共享与隔离上,RDS 又分为:通用型、独享型和共享型。具体的:
2.4 数据库专属集群 MyBase
专属集群 MyBase 是阿里云推出的一种特殊的形态。可以理解为,是一种全托管 RDS 与自建数据库的中间形态。在全托管的 RDS 基础上,提供了两个重大的能力:
阿里云RDS
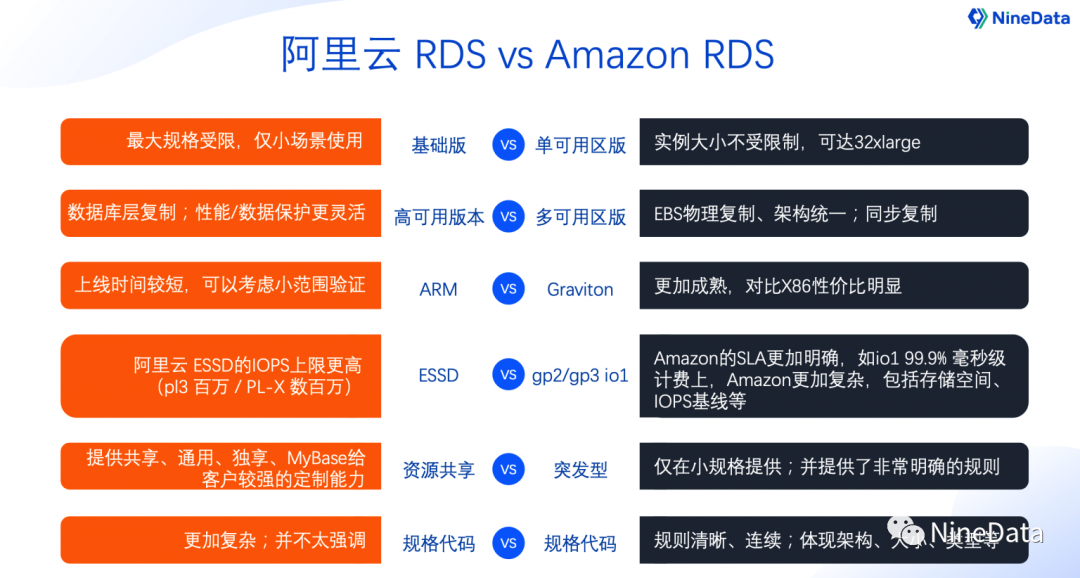
AWS 和阿里的数据库产品各自都发展了很长时间,所处的市场环境、客户场景都有很大的不同,所以,其产品形态也有很多不同的地方,即便是看似相同的名称其含义也可能不同。这里整理,阿里云和 AWS RDS 产品的一些差异,以便帮助大家更好的选择产品:
3.1 基础版 vs 单可用区版本
无论是在阿里云还是 AWS,这两个版本都是代表了单节点的架构。但是:
01 AWS:选择合适的 RDS 架构与规格
1.1 架构与规格大图
▋ 1.2.1 单/多可用区
该选项清晰的描述了实例的在可用区级别的容灾能力:- 单可用区版本的数据库仅一个实例,没有高可用节点,如果节点失败,则会重启主机或者使用新的节点,整个过程会比较长。
- 多可用区版本,则默认会使用两个节点,且一定分布在两个不同的可用区,实例可以实现跨可用区的容灾。当一个可用区出现故障的时候,实例会发生切换,容灾到另一个可用区。AWS 的多可用区版本,主备之间使用的是存储层(EBS)的物理复制 ,所以因此其性能也会受到一定的限制。
▋ 1.2.2 多可用区集群版
这是 Amazon RDS 在去年发布新的架构形态,详细参考: AWS RDS 发布三节点形态,哪些业务场景应该选择? 。该形态主要解决原来的“多可用区版本”备节点完全不可用(相对成本较高)的问题。 “多可用区集群版”使用了数据库的类似的半同步复制机制(参考系统参数判断出来的),数据库的事务写入需要至少两个(多数派)写入成功才成功,但因为有两个备节点,所以相比“多可用区版本”性能会更好,另外,因为是数据库层的复制,而不是块级别,写入和同步路径会更短,也会让延迟更低一些。 该版本,似乎是当前 Amaozn RDS 主推的版本(从 RDS 创建流程中的默认选项和选项顺序来看)。- gp2 存储定位是适用于开发测试环境,存储大小最大为64TB,最大 IOPS 为64000。在购买时,只能选定存储空间,其 IOPS 会根据存储空间进行换算,一般的会是存储空间的三倍,但是有一个下限、也有64000的上限。
- gp3 定位是生产环境的 OLTP 应用,gp3 的最大存储空间和gp2相同,但是,gp3 存储可以单独购买 IOPS,即存储空间和 IOPS 是可以分开购买的,这就给用户提供了更大的灵活度。但是,需要注意的是 IOPS 购买的上限/下限也与存储有一定的关系。避免了,购买非常小的存储空间,但是购买非常大的 IOPS 的情况。具体的限制可以参考其文档介绍。所以,gp3 类型的实例,其计费也是按照存储空间和 IOPS 分开计费的。
- gp2、gp3 存储所提供的 SLA 都是99%的请求在毫秒级别。
- io1(预留 IOPS 的 SSD)则提供了更高性能的存储,最大存储空间依旧是64TB,但是其 IOPS 则可以高达25.6万。另外,io1 存储提供的 SLA 也更高,为99.9%的请求在毫秒级别。计费也是按照存储空间和 IOPS 分开计费。
- HDD 存储是过时的存储类型,主要为了保持兼容性而存在,其最大存储空间为3TB、最大 IOPS 为1000。
- 规格代码中的“db”代表了这是一个用于数据库的实例(ec2) ;
- {t|m|r|x}分别代表了突发型实例 t(小规格)、标准实例 m(内存 cpu 比为4)、内存优化型 r(内存 cpu 比为8)、内存优化型 x(内存 cpu 比为16) ;
- 跟在其后的,则是 CPU 的迭代 ;
- 数字之后的可能出现的字母包括:g、d、n、i等。g代表这是一个 Graviton 类型的实例、d 代表该实例本地有额外的、增强的存储资源、n则代表了额外的网络能力、i 代表这是一个 Intel X86 架构的实例。
▋ 1.6.1 关于“可用区”
可用区可以理解为一片机房区域。例如,在东京东部的某个机房区域,通常会有数栋机房。一个大区域(Region,例如东京)会有多个可用区。▋ 1.6.2 补充说明
- 本文内容主要聚焦于使用最多的各个云厂商的 RDS 数据库的架构与选型,并不包括完整的产品系列 ;
- 该架构图旨在帮助大家从整体框架上了解云数据库整体概括,并不是精确的架构图,并不求精确、面面俱到,例如 RDS MySQL、RDS SQL Server在很多细节上是不同的,这里并没有体现,这些详情可以参考各个云厂商的相关文档 ;
- 这里不包括价格、性能相关的内容。
2.1 架构与规格大图
- 单节点通过简单的架构,以最低的成本提供了基本可用的云数据库服务 ;
- 双节点高可用版则是适合绝大多数业务场景的模式,两个节点分布于一个地区的两个可用区,故障时,切换速度较快,数据双副本,可靠性也比较高 ;
- 三节点企业版,则通过 X-Paxos 实现底层数据一致,并以三副本(两份数据+一份日志)保障数据可靠性。
▋ 2.2.1 基础版(即单节点版本)
阿里云基础版使用阿里云云盘作为数据库存储,挂载在数据库的计算节点上,实现了存储与计算的分离。这使得,计算节点出现故障的时候,重新使用一个新的计算节点,再重新挂载原来的数据库存储,即可启动数据库,恢复出现故障的数据库。所以,在计算节点发生故障的时候,RPO 通常小于1分钟,RTO 则为5分钟~一小时。当整个可用区发生故障的时候,RPO 和 RTO 的值则依赖数据库备份的频率情况。▋ 2.2.2 高可用版
两节点高可用是用户使用最多的版本,也是数据库最为常见的架构。数据库由主备两个节点组成,通过数据库层的逻辑日志进行复制。相比单节点,无论是在数据可靠性、服务的可用性都有非常大的提升。由于主备节点都在同一个大 region,日志延迟通常都非常小,所以发生单节点故障时,高可用版的数据可靠性通常是比较高的。注意到,AWS 对应的双节点版本的 RPO 是零,那么阿里云数据库怎样呢? 具体的,对阿里云 RDS MySQL,阿里云的两节点高可用,根据所选择的参数模板分为如下三类:- 高性能:sync_binlog=1000, innodb_flush_log_at_trx_commit=2, async ;
- 异步模式:sync_binlog=1, innodb_flush_log_at_trx_commit=1, async ;
- 默认:sync_binlog=1, innodb_flush_log_at_trx_commit=1, semi-sync。
▋ 2.2.3 三节点企业版
当前仅 RDS MySQL 有该版本。三节点企业版使用了基于 X-Paxos[^4] 的一致性协议实现了数据的同步复制,适用于数据安全可靠性要求非常高的场景,例如金融交易数据等。三节点中,有一个节点仅存储日志,以此实现接近于两个节点的成本与价格,实现更高的数据安全与可靠性。 三节点企业版在创建的时候,可以选择分布在1~3个可用区。如果需要跨可用区的容灾,则可以让三个副本分布于三个可用区,如果需要更高的性能,则可以让三个副本都在同一个可用区。▋ 2.2.4 关于MySQL的参数sync_binlog, innodb_flush_log_at_trx_commit
在阿里云 RDS 的高可用参数模板选择中,不同的参数模板,最主要的区别就是这两个参数的不同配置。这是 MySQL 和 InnoDB 在数据安全性上最重要的两个参数。双1设置(sync_binlog=1, innodb_flush_log_at_trx_commit=1)是数据安全性最高的配置。 数据库是日志先行(WAL)的系统,通过事务日志的持久化存储来保障数据的持久化。在一般的 Linux 系统中,数据写入磁盘的持久化需要通过系统调用 fsync 来完成,相对于内存操作,fsync 需要将数据写入磁盘,这是一个非常“耗时”的操作。而上面这两个参数就是控制 MySQL 的二进制日志和 InnoDB 的日志何时调用 fsync 完成数据的持久化。所以,这两个参数的配置很大程度上反映了 MySQL 在性能与安全性方面的平衡。 其中,sync_binlog 代表了,MySQL 层的日志(即二进制日志)的刷写磁盘的频率,如果设置成 1,则代表每个二进制日志写入文件后,都会进行强制刷盘。如果设置成 0,则代表 MySQL 自己不会强制要求操作系统将缓存刷入磁盘,而由操作系统自己来控制这个行为。如果设置成其他的数字 N,则代表完成N个二进制日志写入后,则进行一次刷写数据的系统调用。 innodb_flush_log_at_trx_commit 则控制了 InnoDB 的日志刷写磁盘的频率。取值可以是 0,1,2。-
其中 1 最严格,代表每个事务完成后都会刷写到磁盘中。 -
如果该参数设置成 0,那么在事务完成后,InnoDB并不会立刻调用文件系统写入操作也不会调用磁盘刷写操作,而是每隔1秒才调用一次文件系统写入操作和磁盘刷写操作。那么,在操作系统崩溃的情况下,可能会丢失1秒的事务。 -
如果该参数设置成 2,那么,每次 InnoDB 事务完成的时候,都会通过系统调用 write 将数据写入文件(这时候可能只是写入到了文件系统的缓存,而不是磁盘),但是每隔1秒才会进行一次刷写到磁盘的操作。那么,在操作系统崩溃的情况下,可能会丢失1秒的事务。相比设置成 0,该设置会让 InnoDB 更加频繁地调用文件系统写入操作,数据的安全性要比设置成 0 高一些。
- “通用型”适合一般的业务使用场景,但有一定的 CPU 共享率,也就说是,有一定的概率实例的资源可能会被其他实例争抢而导致性能的波动 。
- “独享型”则使用完全独享的 CPU 的资源和内存资源,不会共享其他人的资源,自己的资源也不会被其他人共享,所以,有更稳定的性能。
- “共享型”则与通用型类似 CPU 资源会被共享,并且共享率更高,所以性价比更高,同时受到资源争抢的影响的可能性也更大,当前仅 SQL Server 支持。
- 允许用户登录数据库所在的主机 ;
- 允许用户配置数据库实例 CPU 的“超配比”。
- 统一使用云盘版,让云厂商的供应链管理变得简单。如果使用本地盘版本,意味着数据库机型定制性会增强,供应链的困难会增加产品的成本,最终影响价格。另外,简单的供应链也会让产品的部署更加标准化,更加敏捷地实现多环境多区域的部署。
- 使用云盘版,也可以理解为是“存储计算分离”的架构,那么如果计算节点故障,则可以快速通过使用一台新的计算节点并挂载云盘,而实现高可用。这种方式有着非常好的通用性,无论是哪种数据库都可以使用,而无需考虑数据库种类之间的差异。无论是 MySQL 还是 PostgreSQL、Oracle 都可以使用这种方式实现高可用。
- 云盘版本身提供了一定的高可用与高可靠能力。云盘本身数据可以通过 RAID 或者 EC 算法实现数据的冗余与高可用,并且可以将数据分片到不同的磁盘与机器上,整体的吞吐会更高。
- 云盘版本身是分布式的,可以提供更高的吞吐,通常还可以提供更大的存储空间。例如,各个云厂商的云盘存储都可以提供 12 TB 或 32 TB 的存储空间,基本上可以满足各类业务需要。
- 本架构图主要反映阿里云数据库 RDS 的主要架构;
- ARM CPU 仅部分数据库部分规格支持,当前仅 MySQL、PostgreSQL 支持;
- “集群版”仅 MySQL 和 SQL Server 支持;
- 不同数据库的不同的版本,支持的架构和规格都有不同,这里并没有体现出来 ;
- 不同的区域支持的数据库、版本均可能不同 ;
- 该图的完成得到了阿里云 RDS 团队的帮助,在此一并表示感谢 ;
- v1 版本发布于2022年5月;v2 版本发布于2023年2月。
阿里云RDS
vs
AWS RDSAWS 和阿里的数据库产品各自都发展了很长时间,所处的市场环境、客户场景都有很大的不同,所以,其产品形态也有很多不同的地方,即便是看似相同的名称其含义也可能不同。这里整理,阿里云和 AWS RDS 产品的一些差异,以便帮助大家更好的选择产品:
- 阿里云的“基础版”,强调“基础”,所以均为小规格,最大只有 12v CPU,也没有高可用节点,所以也就只能在一些小场景,如测试环境,中使用。
- AWS 则强调是“单可用区”版本,并不一定是小规格,其最大规格也可以到 128v CPU,所以其使用场景要更广泛。例如,部分分析业务节点使用,该类型可能需要非常强的计算能力,但是可以接受一定程度的可用性问题。