左右互搏还是互补:Google云数据库AlloyDB与Spanner的差异与定位
云 云数据库技术约 8 分钟
摘要:随着对传统数据库扩展性、成本等方面的不满以及自主可控的需要,数据库替代成为热点。原本大家希望有一种终极架构能满足所有需求,并对分布式数据库给予厚望,但真的有绝对先进的架构可以做到这点吗?我们借Google正式推出AlloyDB从而在架构上脚踩两船的事来分析下这一问题。
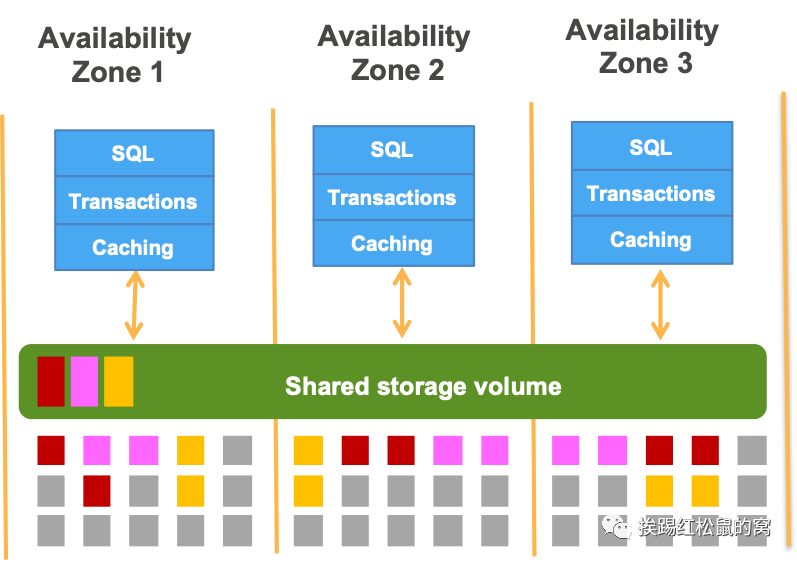 Aurora:共享存储回来了
如果要区分Google AlloyDB和Spanner的差异的话,AlloyDB是采用传统意义上的存储的共享存储(Share Storage)架构,同时是这类架构中典型的日志即数据库(Log is Database)架构,而Spanner是典型的Spanner架构(谁叫人家是始祖呢)的分布式数据库。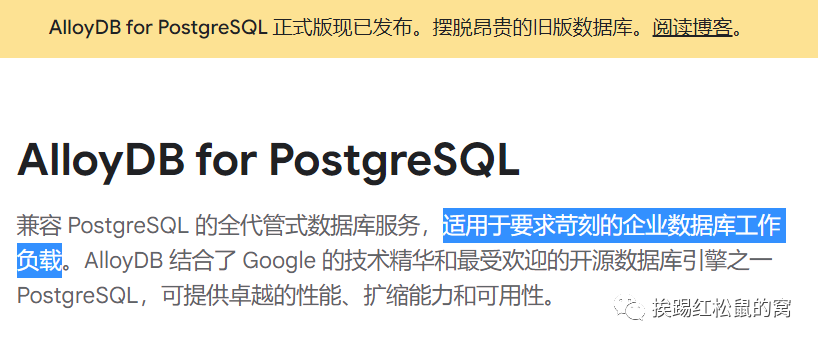 关键信息:苛刻的
企业数据库工作负载
、
卓越性能、扩缩能力、可用性
。
再看Spanner,非常简洁的一句话:
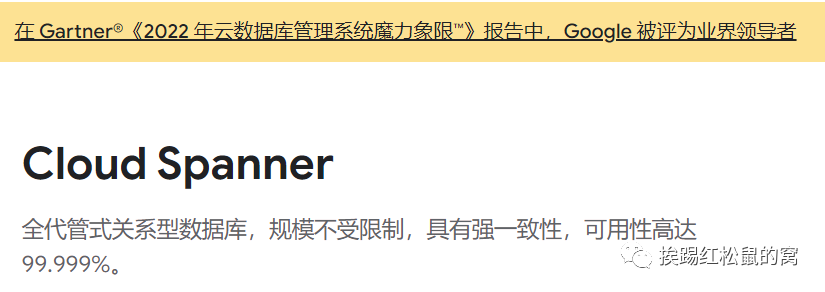 来自Goocle Cloud
关键词:
规模不受限,强一致性,可用性99.999%
 来自Google Cloud
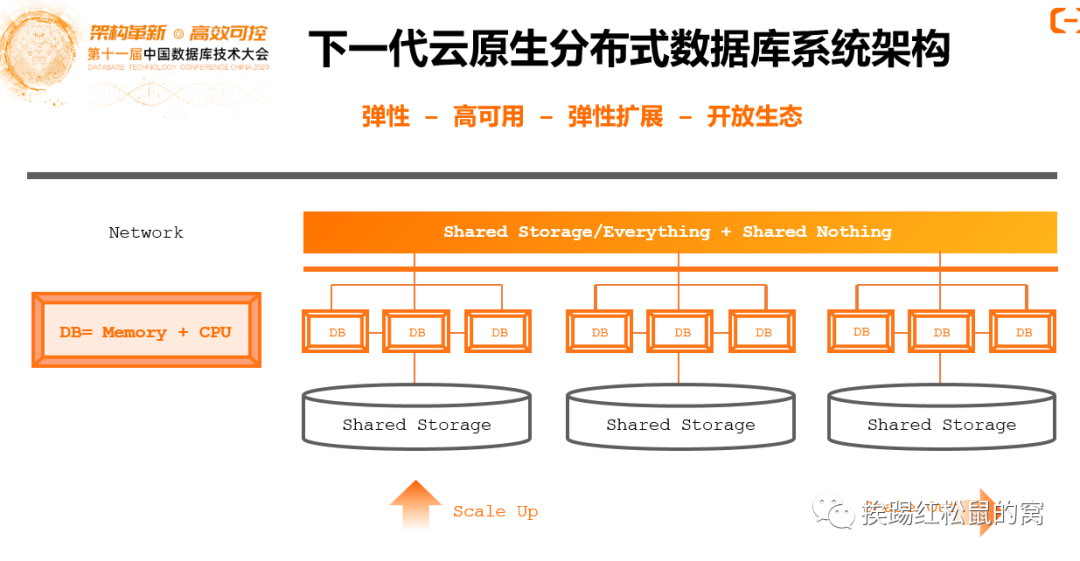 共享存储数据库和分片路由被PolarDB揉到一起
在AWS Aurora出现后,大家都在模仿Aurora,虽然是Google最后上船的,但一来它有后发优势,二来反而有了双架构优势,其它厂商是否会反向跟风?我觉得有这种可能,但构建分布式数据库的方式可能是多样化的,因为这十几年来大家在分布式数据库的几条技术路径上都做了长期探索,有一定积累,没有必要完全重构。
架构分类简述
先说结论:- 去年推出的AlloyDB和Spanner肯定有一些重叠的业务场景,但两者有明确的分工,AlloyDB主要是Google为了增加企业业务的竞争力;
- AlloyDB也是分布式数据库,只是它和ORACLE RAC更像,让人觉得Google又搞了个集中式架构的数据库。
如果要区分Google AlloyDB和Spanner的差异的话,AlloyDB是采用传统意义上的存储的共享存储(Share Storage)架构,同时是这类架构中典型的日志即数据库(Log is Database)架构,而Spanner是典型的Spanner架构(谁叫人家是始祖呢)的分布式数据库。
Google的定位:“企业”应用和“全球”应用
官网简介对比:AlloyDB是“企业负载”
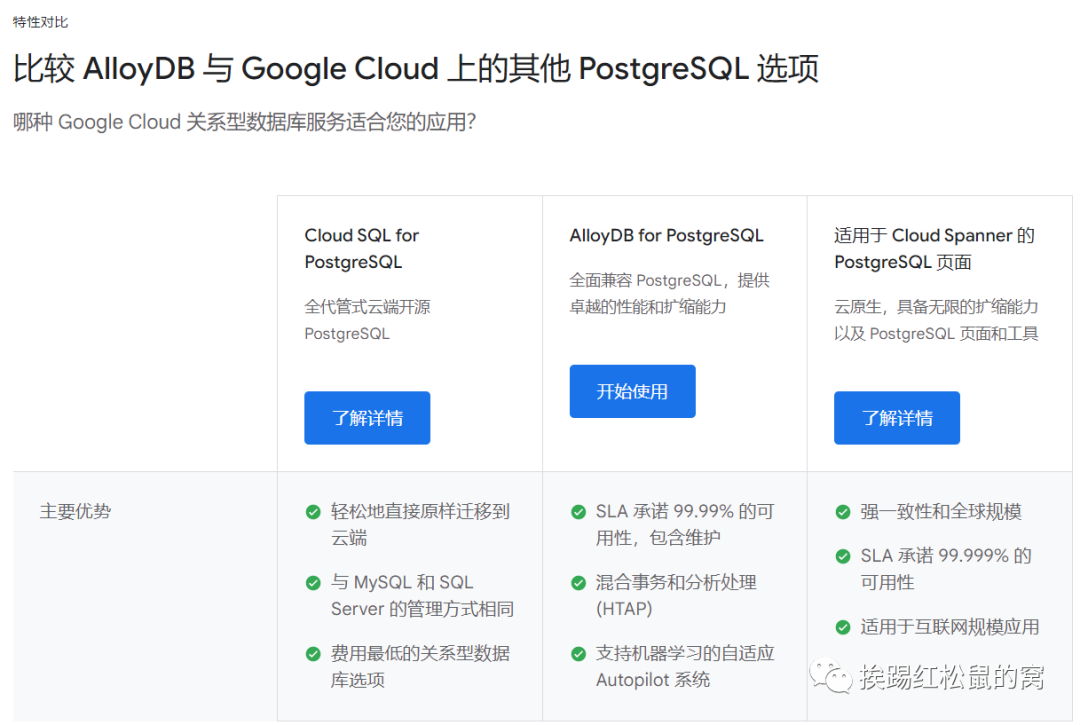
先看看Google Cloud官方对两种数据库的定位,首先是AlloyDB:官方的横向对比
因为AlloyDB与Spanner都是兼容PostgreSQL的数据库,因此Google做了二者与PostgreSQL云服务的横向对比:为什么AlloyDB可用性更低反而是企业数据库?
可以看到,应用在“苛刻的企业数据库工作负载”的Alloy在可用性上反而比Spanner的可用性SLA少一个9。为了搞清楚其中原因,我收集了两种数据库的其它信息做下对比:| 特性 | AlloyDB | Spanner |
|---|---|---|
| 可用性SLA | 99.99%SLA | 99.999% |
| 可用性其它特性 | 大多数故障 60 秒内自动恢复, 支持无中断的实例大小调整和数据库维护 | 未说明 |
| 跨Region容灾 | 未说明,有跨ZONE容灾 | 跨区(Region)容灾 |
| 事务处理能力 | 比标准 PostgreSQL 快 4 倍,比AWS Aurora高2倍 | 未说明 |
| 数据分析能力 | 最多 可以比标准 PostgreSQL 快 100 倍 | 未说明 |
| 扩展性 | 可扩展读实例和存储 | “规模不受限”,根据请求负载和数据大小自动分片 |
99.99%可用性已很高
其实AlloyDB的可用性只是比Spanner低而已。在同类型数据库中已经很强,意味着一年业务中断时间小于 52.6分钟 ,对比大多数产品也不低,如AWS Aurora和阿里PolarDB的可用性都是99.99%,只是比ORACLE Exadata一体机的99.999%差。因为没有查到AlloyDB是否支持跨Region容灾,如果加上这个能力,估计可用性还会有提升。不过代价可能是性能的大幅下降。可靠性不只是数几个9
对于企业业务,性能、可靠性、运维性、成本是并重的,而这几方面的能力又相互影响:可靠性的提升有可能要牺牲性能,反之亦然,而可靠性、性能的提升往往造成成本的大幅度提升。AlloyDB对高可用性的描述是这样的: AlloyDB 提供 99.99% 的正常运行时间服务等级协议 (SLA),包含维护。它能在大多数数据库故障发生后的 60 秒内自动检测并恢复,与数据库大小和负载无关。该架构支持无中断的实例大小调整和数据库维护。 60秒自动恢复应该并不是AlloyDB对Spanner的优势,而是和除Spanner外的其它架构数据库来对比的。像Mysql,PostgreSQL等采用Shared Nothing架构部署方式是基于日志同步和回放实现高可用的,故障发生时备节点能会有部分日志还没有回放完,尤其是数据库负载很高而产生了大量日志时,备节点就需要更长的时间才能接管业务。AlloyDB采用的是Shared Storage架构,故障恢复时不需要等待备节点进行日志回放,自然恢复速度也“ 与数据库大小和负载无关 ”。由于Spanner也采用了特殊的共享存储架构,所以Alloy并无优势,但Alloy的存储架构又使它在实例大小调整和维护方面更加灵活。性能与可靠性既要又要
能做到既要又要是AlloyDB被定位于支撑“ 苛刻的 企业数据库工作负载 ”的原因。一方面从公布的性能数据来看,它支撑很多企业业务甚至替代大量ORACLE都是没有问题的,这与其采用的日志即数据库架构以及Google在存储缓存方面的优化有很大关系。另一方面从架构来说Spanner要达成这样的性能,需要在硬件如网络、存储等方面做大量投入造成成本上升而且效果未必好。 除了事务性能,AlloyDB的数据分析性能也很亮眼。很多用户在使用Oracle、DB2这类数据库时,很多是同时跑OLTP和OLAP业务的,甚至直接用来做数据仓库使用。AlloyDB的HTAP能力对它支撑甚至替换ORACLE等数据库都非常有价值。为什么不用分布式Scale解决性能问题
像Spanner通过Scale扩展分片可以把性能扩展到很高的水平,Google Cloud的描述中也提到了这点,那为什么性能还是AlloyDB的优势而不是Spanner呢? 当AlloyDB作为PostgreSQL甚至ORACLE的替代者时如果性能能实现对原有数据库的一对一替换就可以避免迁移前的分布式改造、去存储过程之类的改造和替换后因分布式事务等对性能的影响。这一点AWS曾在自己去O的总结中提到过,因此对企业业务来说,数据库的单体性能是非常重要的能力。解决不了的还有Spanner
AlloyDB在一定程度上实现了既要又要,但很难有一个完美的架构能实现既要又要还要,对Google来说,解决不了的就由Spanner来解决。 AlloyDB的架构决定了它虽然扩展灵活,但规模不能太大,如果业务的规模很大,就可以考虑 “规模不受限” 的Spanner。而跨区域甚至全球部署的Spanner也更适合互联网。多架构并存趋势,如何选择?
AWS曾经总结过自己的去O经验,认为从单一的ORACLE数据库走向多类型数据库不可避免。AWS的数据库替换使用了Aurora、Redshift、DynamoDB数据库以及数据湖等多种产品。而Google又采取双架构支持交易型数据库业务的策略又把这一趋势更进一步。这既有业务需求导致单一架构难以满足需求的原因,也有当前数据库产品与ORACLE仍有较大差距的无奈。其中前者的存在决定了多架构可能会在相当长的时间里持续。那么应该如何选择合适的架构来支撑业务或替换上云?架构决定特性
数存协同的“合金”
AlloyDB是典型的共享存储多活数据库里的 的日志即数据库架构。 架构图 共享存储多活从最经典的ORACLE RAC多写到一写多读的AWS Aurora、阿里PolarDB,共同的特点包括:- 故障接管速度快:因为共享存储不需要进行日志回放同步
- “集中式数据库的使用体验”,分布式数据库的横向扩展性
- 存算分离,扩展灵活。AWS和阿里甚至把ServerLess和云原生的概念套用到自家产品中了。 而AlloyDB不但采用了日志即数据库架构,更是通过缓存设计把数据库与存储的深度协同推到一个新高度。性能和可靠性是ORACLE的替代者们的普遍短板,打造数据库与存储的合金(Alloy)则是Google追赶Oracle的努力。