IBM加入战局!任意大模型低成本变ChatGPT方法开源,个别任务超GPT-4
 关注前沿科技约 6 分钟
衡宇 发自 凹非寺
量子位 | 公众号 QbitAI
科幻中有机器人三原则,IBM说不够,要十六原则
。
单峰“瘦”骆驼比草泥马大
这匹出自IBM和CMU的单峰骆驼,威力如何?
先来看几个例子。
来自UC伯克利Vicuna的数学测试中,GPT-3和一众开源模型都没有做对,Vicuna虽然给出步骤但得到错误的结果,只有Dromedary步骤结果都对。
研究团队在benchmark上对Dromedary进行定量分析,还给出了在一些数据集上的定性分析结果。
多说一嘴,所有语言模型生成的文本的temperature都默认设置在0.7。
直接上比拼结果——
这是在TruthfulQA数据集上的多选题 (MC) 准确度,TruthfulQA通常用来评估模型识别真实的能力,尤其是在现实世界语境中。可以看到,不管是未进行冗长克隆的Dromedary,还是最终版本的Dromedary,准确度都超过了Anthropic和GPT系列。
这是在TruthfulQA进行生成任务得到的数据,给出的数据是答案中“可信答案”与“可信且信息丰富的答案”。
(评估通过OpenAI API进行)
这是由GPT-4评估的在Vicuna基准问题上得到的答案比较数据。
以及这是在Vicuna基准问题上得到的答案的相对质量,同样由GPT-4进行评估。
全新方法SELF-ALIGN
Dromedary基于transformer架构, 以语言模型LLaMA-65b为基础 ,最新知识停留在2021年9月。 根据抱抱脸上的公开资料,Dromedary训练时间只有一个月 (2023年4月到5月) 。
30天左右的时间,Dromedary是怎么实现用极少的人类监督就让AI助理自对齐的呢?
不卖关子,研究团队提出了一种结合原则驱动式推理和LLM生成能力的全新方法: SELF-ALIGN (自对齐) 。 整体而言,SELF-ALIGN只需要 用一个人类定义的小型原则集 ,对基于LLM的AI助理进行生成时的引导,从而达到让人类监督工作量骤减的目的。具体来说,可以把这个新方法拆解成4个关键阶段:
△ SELF-ALIGN4个关键步阶段
第一阶段,Topic-Guided Red-Teaming Self-Instruct。Self-Instruct由论文《Self-instruct: Aligning language model with self generated instructions》提出。
它是一种框架,可以使用最少的人工标注,生成大量用于instruct-tuning的数据。
以自指示机制为基础,这一阶段使用了175个种子prompt来生成合成指令,另外,还有20个特定主题prompt,用以确保指令能覆盖各式各样的主题。
这样一来,就能确保指令全面覆盖AI助理接触的场景、上下文,进而减少潜在偏见产生的概率。
第二阶段,Principle-Driven Self-Alignment。这一步中,为了引导AI助理的回答有用、靠谱且符合道德伦理,研究团队用英语定义了一个包含16条原则的集,作为“指导方针”。
16原则既囊括了AI助理生成回答的理想质量,还有AI助理得到答案的行为背后的规则组成。
实际上下文学习 (ICL、in-context learning) 工作流程中,AI助理到底是怎么生成遵守原则的回答呢?
研究团队选择的办法是每次生成回答时,让AI助理查询相同的示例集,代替以前工作流程中所需的不同人类标注示例集。
接着提示LLM生成新主题,并在删除重复主题后,让LLM生成新的指令及与指定指令类型和主题相对应的新指令。
基于16原则、ICL范例和第一阶段的Self-Instruct,触发AI助理背后LLM的匹配规则。
一旦检测到生成内容有害或不合规,就拒绝吐出生成的内容。
第三阶段,Principle Engraving。这个阶段的主要任务是在自对齐回答上,微调原始LLM。这里所需的自对齐回答,是LLM通过自我提示生成的。
与此同时,还对微调后的LLM进行了原则和演示的剪枝。
微调的目的是让AI助理可以直接生成和人类意图对齐得很不错的回答,哪怕是在不规定使用16原则和ICL范例的情况下。
值得一提的是,由于模型参数的共享性,所以AI助理生成的回复在各式各样不同的问题上都能实现对齐。
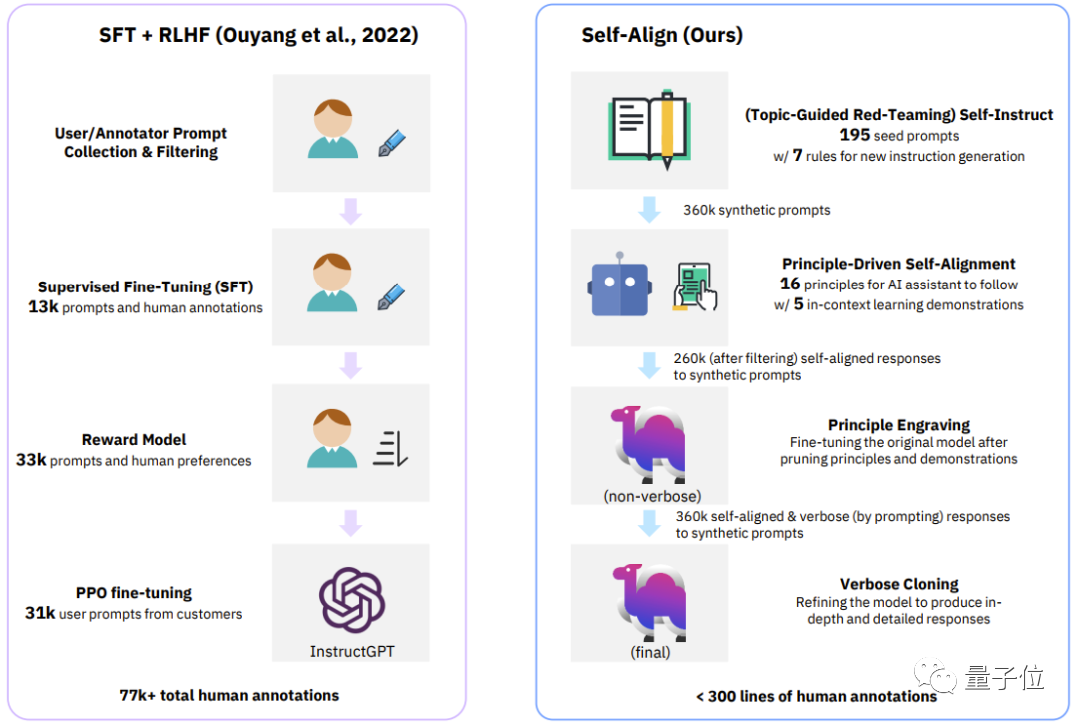 △
经典流程(InstructGPT)与SELF-ALIGN的四个阶段对比
来看一个最直观的表格,它包含了
近期闭源/开源的AI助理所使用的监督方法
。
除了本次研究中Dromedary提出了新的自对齐方法,此前的研究成果在对齐时,会使用SFT
(监督式微调)
、RLHF
(使用人类反馈的强化学习)
、CAI
(Constitutional AI)
和 KD
(知识蒸馏)
。
可以看到,之前的AI助理,如InstructGPT或Alpaca等至少需要5万条人类标注。
但是,整个SELF-ALIGN过程必需的注释量,是 少于300行 (包括195个种子prompt,16个原则和5个范例) 的。背后团队
Dromedary背后的团队,来自IBM研究院MIT-IBM Watson AI Lab、CMU LTI (语言技术研究所) 、马萨诸塞大学阿默斯特分校。
主要与全球组织合作,围绕AI展开研究,致力于推动AI前沿进展,并将突破转化为现实影响。
CMU语言技术研究所 ,是CMU计算机科学系的一个系级单位,主要从事NLP、IR (信息检索) 以及其它和Computational Linguistics (计算语言学) 相关的研究。 马萨诸塞大学阿默斯特分校 则是麻省大学系统的旗舰校区,属于研究型大学。 Dromedary背后论文的一作, Zhiqing Sun ,目前CMU博士在读,本科毕业于北京大学。
对此,他也无可奈何,只得写进论文中的失败案例:
真是笑不活了哈哈哈哈哈哈哈哈哈!!!
看来AI一本正经胡说八道这个问题,还需要新的方法来解决。
参考链接:[1] https://arxiv.org/pdf/2305.03047.pdf
[2] https://arxiv.org/pdf/2212.10560.pdf
[3] https://www.cs.cmu.edu/~zhiqings/
[4] https://huggingface.co/zhiqings/dromedary-65b-lora-delta-v0 — 联系 作者 —
欢迎关注人工智能、智能汽车的小伙伴们加入交流群,与AI从业者交流、切磋,不错过最新行业发展&技术进展。
PS. 加好友请务必备注您的姓名-公司-职位噢 ~
点这里 👇 关注我,记得标星哦~ 一键三连「分享」、「点赞」和「在看」 科技前沿进展日日相见 ~