如何并发安全且高效的使用map
 叶子彬约 7 分钟
背景
在使用go语言开发的过程中,我碰到过这样一种情况,就是代码自测没问题,代码检查没问题,上线跑了一段时间时间了也没问题,就是突然偶尔会抽风panic,导致程序所在的pod(k8s的运行docker镜像的最小单位)重启了,而程序里抛出来的异常如下
意思是多个协程正在同时对同一个map变量进行读写,这个就涉及到go程序的竞态问题,而竞态问题也是我们日常开发中遇到比较多的情况
为什么要关注map并发安全问题
主要原因是有多个协程在对同一个map变量进行修改,这样就可能会出现map被一个协程修改到一半的时候,然后另外一个协程就来读取了,导致读到一个“半成品”的map变量。而这个就说明一个问题,就是map类型并不是并发安全的
并发安全是指在多线程或多协程环境下,对共享资源进行访问和操作时,保证程序正确性和一致性的性质。在并发安全的情况下,多个并发执行的操作可以正确地完成,不会导致数据损坏、结果错误或系统崩溃。
那么go语言有些类型是不具备并发安全,如:map,slice,struct....
需要注意的是,map类型会检测是否发生并发,如果检测到并发会调用runtime.throw(),这个是无法被recover的,一定会中断程序,而这也导致程序运行的pod会被检测出异常从而重启
如何解决map并发安全问题
1、使用go的一些并发原语
如果需要修改的变量是程序启动之后就不需要修改的配置,那么可以使用sync.Once包来处理,这个包的作用就是限制一件事情只做一次,示例代码如下
type User struct {Name stringOther map[string]interface{}ConfigOnce sync.Once}func (u *User)InitConfigOnce(name string, other map[string]interface{}) *User {u.ConfigOnce.Do(func() {// print okfmt.Println("ok")u.Name = nameu.Other = other})return u}func (u *User) GetUserConfig() {fmt.Println(u)}
调用代码
func main() {var u Uservar wg sync.WaitGroupnum := 30wg.Add(num)for i := 0; i < num; i++ {go func() {u.InitConfigOnce("yzb", map[string]interface{}{"age": 18,})u.GetUserConfig()wg.Done()}()}wg.Wait()}
结果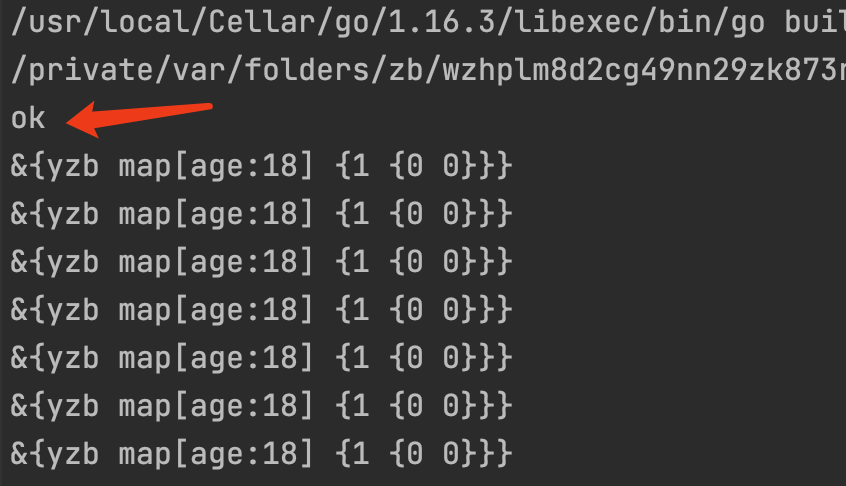
2、加读写锁(RWMutex map)
出现竞态的本质是因为多个协程对同一个变量同时进行读与写,通过用锁来防止这个情况,因为我举的案例是读多写少的情况,用上读写锁性能会更好,示例代码如下
type Mmap struct {Data map[string]interface{}Mu sync.RWMutex}func InitMmap() *Mmap {return &Mmap{Data: make(map[string]interface{}),}}func (m *Mmap) Get(name string) interface{} {m.Mu.RLock()defer m.Mu.RUnlock()return m.Data[name]}func (m *Mmap) Set(data map[string]interface{}) {m.Mu.Lock()defer m.Mu.Unlock()for k, v := range data {m.Data[k] = v}}func (m *Mmap) SetOne(key, val string) {m.Mu.Lock()defer m.Mu.Unlock()m.Data[key] = val}
建议
1、如果属于读多写少的情况,尽量选择读写锁来减少锁住的范围,从而提高读写性能
2、这里推荐将需要用来读写的map变量和锁共同组建一个struct,这样能保证读和写上的是同一把读写锁,同时也方便整合对map变量的操作
调用代码试试
//调用方法func main() {var c = InitMmap()for i := 0; i < 30; i++ {go func() {c.SetOne("name", "yzb")}()go func() {fmt.Println(c.Get("name"))}()}}
然后进行数据竞态监测,并无报错
3、分片加锁
方案2中虽然加了读写锁,比加一把普通的锁要性能高些,不过锁的粒度还是大了些,当高并发来袭时,写的操作必然会阻塞读的动作,那么有没有办法将锁住的范围缩小一些呢
思路:如果给map里的每个元素加锁,每次修改只是单个元素的锁生效,其他没改到的元素就正常读,这样锁的粒度会更细,这就是分片加锁的原理
这种就是将一把“大”锁拆成一把把小锁,是一种空间换时间的方法
实现上,已经有人实现了好用的具有分片锁的map,库地址:https://github.com/orcaman/concurrent-map
示例代码
import (cmap "github.com/orcaman/concurrent-map""sync")func InitCmap() *cmapConfig {return &cmapConfig{cmap.New(),}}func (c *cmapConfig) Set(config map[string]interface{}) {for k, v := range config{c.Cmap.Set(k, v)}}func (c *cmapConfig) Get(k string) interface{} {v, ok := c.Cmap.Get(k)if ok {return v} else {return nil}}
4、go的原生可并发map
最后还会跟大家介绍一个go原生库里就有一个可并发读写的map,这个放在sync库
官方的文档中指出,在以下两个场景中使用 sync.Map,会比使用 map+RWMutex 的方式,性能要好得多:
1、只会增长的缓存系统中,一个 key 只写入一次而被读很多次;
2、多个 goroutine 为不相交的键集读、写和重写键值对。
大致原理:sync.Map结构里有两个字段,一个read,一个dirty。dirty包含read的所有字段,新增字段是写在dirty上,当访问到read没有这个变量,miss变量数值就会+1,同时加锁去dirty访问该值,当miss数值等于dirty长度,就会把dirty提升为read
空间换时间。通过冗余的两个数据结构(只读的 read 字段、可写的 dirty),来减少加锁对性能的影响。
动态调整。miss 次数多了之后,将 dirty 数据提升为 read,避免总是从 dirty 中加锁读取。double-checking。加锁之后先还要再检查 read 字段,确定真的不存在才操作 dirty 字段。
延迟删除。删除一个键值只是打标记,只有在提升 dirty 字段为 read 字段的时候才清理删除的数据。
示例代码
type syncMapConfig struct {Smap sync.Map}func InitSmap() *syncMapConfig {return &syncMapConfig{sync.Map{},}}func (s *syncMapConfig) Set(config map[string]interface{}) {for k, v := range config {s.Smap.Store(k, v)}}func (s *syncMapConfig) Get(k string) interface{} {c, ok := s.Smap.Load(k)if ok {return c} else {return nil}}
性能对比
上面说了4种方法,处理用once这个包比较特殊(map只写一次,以后只读),其他都是可读写多次的,有可比性,那么2,3,4这三种方案的性能对比如何呢,哪种情况下该用哪种呢
标注:下面数据对比,带有相关字符的有如下含义
字符 | 含义 | 字符 | 含义 |
|---|---|---|---|
| Cmap | 使用了concurrent-map包 | WnR | 写和读一样多次 |
| Smap | 使用了sync.Map包 | WnRMore | 读多写少 |
| Mmap | 使用RWMutex | WMorenR | 写多读少 |
当并发=1000,对map是部分更新,且不是更新读取的字段
当读写一样多的时候性能: sync.Map > concurrent-map > RWMutex map
当读多写少的时候性能:concurrent-map > sync.Map > RWMutex map
当写多读少的时候性能:sync.Map > concurrent-map > RWMutex map
结论:当高并发对map进行读写时,如果写的字段和读的字段错开的时候
concurrent-map 在读多写少的情况下有优势,因为锁的粒度小
sync.Map 在写多读少的情况下有优势,因为有结构设计有优势
而读写锁因为加锁粒度大,导致高并发下性能都不是很好
当并发=1000,对map是更新和读取都是同一个字段
当读写一样多的时候性能: sync.Map > RWMutex map > concurrent-map
当读多写少的时候性能:sync.Map > RWMutex map > concurrent-map
当写多读少的时候性能:sync.Map > concurrent-map > RWMutex map
在读写都是同一个map字段的时候,sync.Map的结构优势就凸显了,因为对读和写是针对sync.Map 结构里的read字段,且不加锁;而其他两个包都是会上锁的
当并发=10,对map是部分更新,且不是更新读取的字段
当读写一样多的时候性能: RWMutex map > sync.Map > concurrent-map
当读多写少的时候性能:RWMutex map > sync.Map > concurrent-map
当写多读少的时候性能:RWMutex map > concurrent-map > sync.Map
当并发变低的情况下,RWMutex map的性能就好于其他两种,主要原因是并发低,锁的竞争和阻塞情况变少,反而是结构简单不需要占用大空间的RWMutex map形式要更好
当并发=10,对map是更新和读取都是同一个字段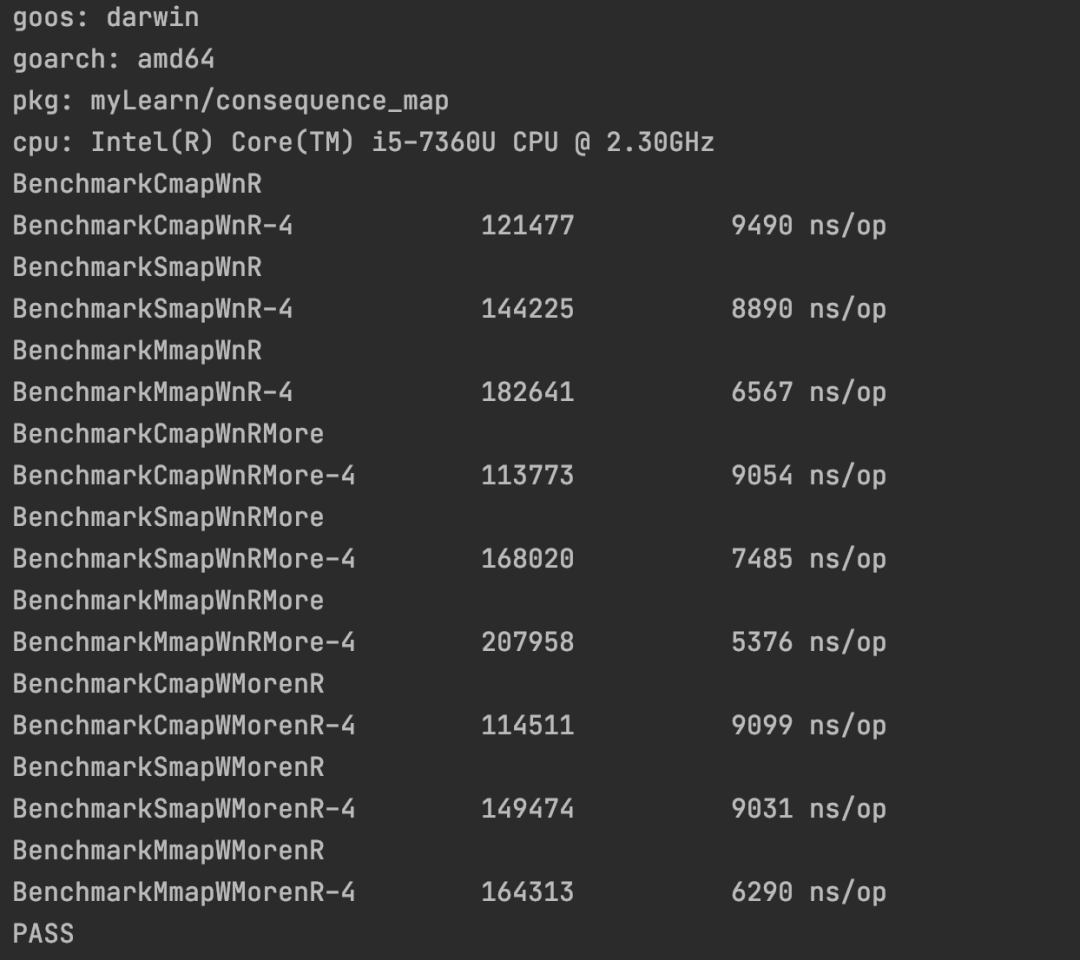
当读写一样多的时候性能: RWMutex map > sync.Map > concurrent-map
当读多写少的时候性能:RWMutex map > sync.Map > concurrent-map
当写多读少的时候性能:RWMutex map > sync.Map > concurrent-map
当并发变低的情况下,RWMutex map的性能就好于其他两种,主要原因是并发低,锁的竞争和阻塞情况变少,反而是结构简单不需要占用大空间的RWMutex map形式要更好
最终结论
选用哪个方式,其实主要先看并发数,其次看读写模式,再来选择使用哪种模式,以下表格是选用最优解
读多写少 | 写多读少 | |
|---|---|---|
| 并发高 | concurrent-map | sync.Map |
| 并发低 | RWMutex map | RWMutex map |