「羊驼」们走到哪一步了?研究表明:最好的能达到GPT-4性能的68%
机 机器之心约 6 分钟
机器之心报道
编辑:马梓文
最近,大型语言模型获得了前所未有的关注度。在更迭迅速的情况下,开源模型与闭源模型的发展并驾齐驱,同时呈现百花齐放的态势。 但仍然令大家好奇的是,开源大模型和闭源大模型,哪一边实力更强?又该如何对比? 近日,在推特上,华盛顿大学计算机科学博士生 Wang Yizhong 同样对众多指令调优数据集及开源模型的发展提出了这个疑问。
 挑战开放模型的极限
当确定「使用广泛的数据混合是最好的」以及「使用 LLAMA 作为基础模型比其他开放替代方案更可取」后,研究比较所有 LLAMA 尺寸的人类 + GPT 数据混合 (TÜLU 模型) 上训练的模型的性能(如表 5 所示)。
基于模型的开放式生成评估结果 表 6 中报告了模型 AlpacaFarm 胜率。
总体而言,有这些结果可以看出,虽然模型偏好评估很重要,但它并没有提供对这些模型的整体评估。因此,在更大、更全面的评估设置里,模型偏好评估应该只作为其中的一部分。 开放式生成的人工评价结果 图 4 中展示了人工评估结果。人工评估结果与 AlpacaFarm 和基于基准的评估具有强烈相关性:所有评估表明,65B TÜLU 优于 7B TÜLU。这表明使用更大的基础模型是重要的,并且在 65B TÜLU 和 ChatGPT 之间仍有不小的性能差距。
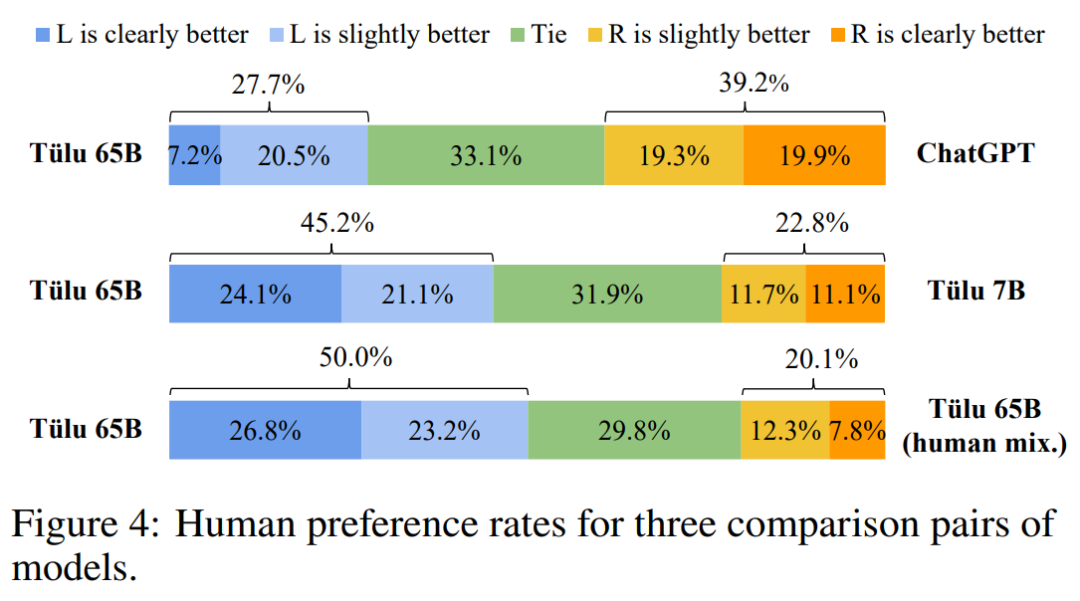
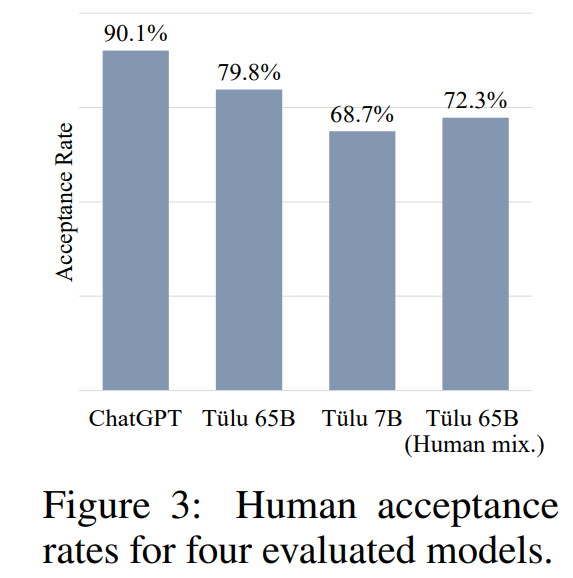
除此之外,研究还发现利用蒸馏数据集可以让性能有很大的提升,这表明相比之下人类编写的数据集是匮乏的。这些观察结果也与图 3 中的可接受性分数相一致。7B TÜLU 在模型偏好评估中优于 human-mix 65B TÜLU,但如果比较图 3 中的可接受性分数,则情况似乎相反。这进一步证明,模型两两评估可能并不始终揭示模型缺陷。在这种情况下,65B 人类混合模型比 7B 模型更有可能产生可接受的 (如果不是高质量的) 响应。
更多详细内容,请参见原文。
开源 VS 闭源,哪边的大语言模型更能打?
最近,大型语言模型获得了前所未有的关注度。在更迭迅速的情况下,开源模型与闭源模型的发展并驾齐驱,同时呈现百花齐放的态势。 但仍然令大家好奇的是,开源大模型和闭源大模型,哪一边实力更强?又该如何对比? 近日,在推特上,华盛顿大学计算机科学博士生 Wang Yizhong 同样对众多指令调优数据集及开源模型的发展提出了这个疑问。
- 一个跨所有任务的最佳指令调优数据集是不存在的;
- 合并数据集可以在基准任务上获得最佳的整体性能;
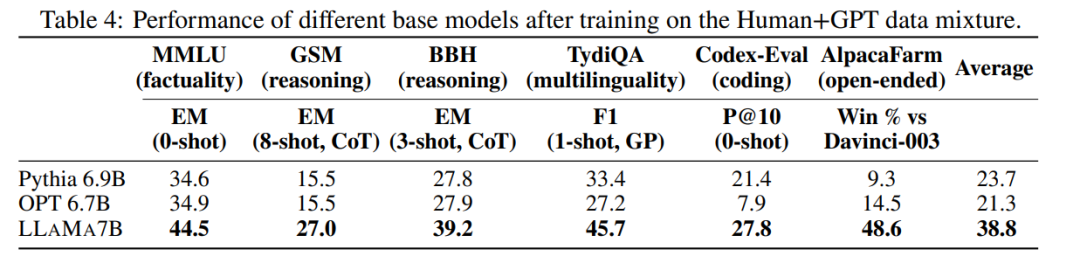
- 基础模型的质量对于下游性能非常重要。(见表 4)
- 指令调优给所有尺寸的 LLAMA 模型都带来了很大的好处;
- 较小的模型从指令调优中获益最大;
- TÜLU 仍然落后于最先进的专有模型。
基于模型的开放式生成评估结果 表 6 中报告了模型 AlpacaFarm 胜率。
- 基于传统 NLP 数据集的混合模型表现不佳;
- 鼓励长时间、多样化代的数据集表现最好 (见图 2);
- ShareGPT 的性能最好。
总体而言,有这些结果可以看出,虽然模型偏好评估很重要,但它并没有提供对这些模型的整体评估。因此,在更大、更全面的评估设置里,模型偏好评估应该只作为其中的一部分。 开放式生成的人工评价结果 图 4 中展示了人工评估结果。人工评估结果与 AlpacaFarm 和基于基准的评估具有强烈相关性:所有评估表明,65B TÜLU 优于 7B TÜLU。这表明使用更大的基础模型是重要的,并且在 65B TÜLU 和 ChatGPT 之间仍有不小的性能差距。