ChatGPT最强竞品Claude2来了:代码、GRE成绩超越GPT-4,免费可用
机 机器之心约 6 分钟
机器之心报道
编辑:小舟、杜伟
今日,那个被很多网友称为「ChatGPT 最强竞品」的人工智能系统 Claude 迎来了版本大更新。
Claude 2 正式发布!
据介绍, Claude 2 在编写代码、分析文本、数学推理等方面的能力得到加强,并且可以产生更长的响应 。
更重要的是, 用户可以在新的 beta 网站上免费试用 ,并且 Claude 2 商用 API 的价格与 1.3 版本相同。
之后持续升级,五月份通过 100K Context Windows 将 Claude 的上下文窗口从 9k token 扩展到了 100k。
现在终于迎来了大版本更新。Anthropic 表示,Claude 2 基于此前从用户那里获得的反馈建议进行改进。
接下来看各方面能力细节。
Claude 2 在哪些方面得到了加强?
总的来说,Claude 2 注重提高以下能力:
该研究进行了一系列评估实验来测试 Claude 2 的性能水平,包括对齐评估和能力评估两部分。
在模型对齐方面,该研究针对大模型的三个关键要求做了具体评估,包括:遵循指令、生成内容有用(helpfulness);生成内容无害(harmlessness);生成内容准确、真实(honesty)。
人类反馈评估
大模型在生成过程中应该遵循人类提供的指令,这将让生成结果符合要求、实际有用。针对这一点,该研究对 Claude 2、Claude 1.3 和 Claude Instant 1.1 进行了实验评估,并使用经典的对弈水平评估指标 ——Elo 分数,几个模型的评估结果如下图 1 所示:
Bias Benchmark for QA(BBQ)是用于评估模型对人群偏见的常用基准。该研究在 BBQ 基准上进行实验评估,几种模型的实验结果如下图 2 所示:
大模型有时会生成虚假混乱的信息,因此测试模型生成内容的事实性非常重要。TruthfulQA 是一个用于评估语言模型在对抗性环境中输出的准确性和真实性的基准,几种模型的测试结果如下图 4 所示:
多语言翻译
该研究选择涵盖 200 多种语言的翻译基准 Flores 200 来评估 Claude 2 的多语言翻译能力,其中包括低资源语言。Claude 2、Claude 1.3 和 Claude Instant 1.1 的评估结果如下图 7 所示:
今年早些时候,研究团队将 Claude 的上下文窗口从 9K token 扩展到了 100K token,现在 Claude 2 进一步扩展了上下文窗口, 达到 200K token,相当于约 150000 个单词。
为了证明 Claude 2 会实际使用完整的上下文,该研究测量了每个 token 位置的损失,平均超过 1000 个长文档,如下图 8 所示:
标准基准评估
该研究在几个标准基准上评估测试了 Claude 2、Claude Instant 1.1 和 Claude 1.3,包括用于 python 函数合成的 Codex HumanEval、用于解决小学数学问题的 GSM8k、用于多学科问答的 MMLU、针对长故事问答的 QuALITY、用于科学问题的 ARC-Challenge、用于阅读理解的 TriviaQA 和用于中学水平阅读理解与推理的 RACE-H,具体的评估结果如下表所示:
资格水平考试
该研究还用几个常见资格水平考试的题目测试了 Claude 2 的实际能力。
首先,Claude 2 在美国律师资格考试(Bar Exam)的多项选择题测试中得分率为 76.5%,高于 Claude 1.3 的 73.0%。
官方示例及试用体验
我们先看 Anthropic 提供的一些官方示例。
1、 编码能力:为静态地图添加交互式数据 。
2、文
本处理能力:总结文档、输出表格
。这里 Claude 2 用上了 100K token 文本处理功能,可以在 prompt 窗口上传几百页的文档。
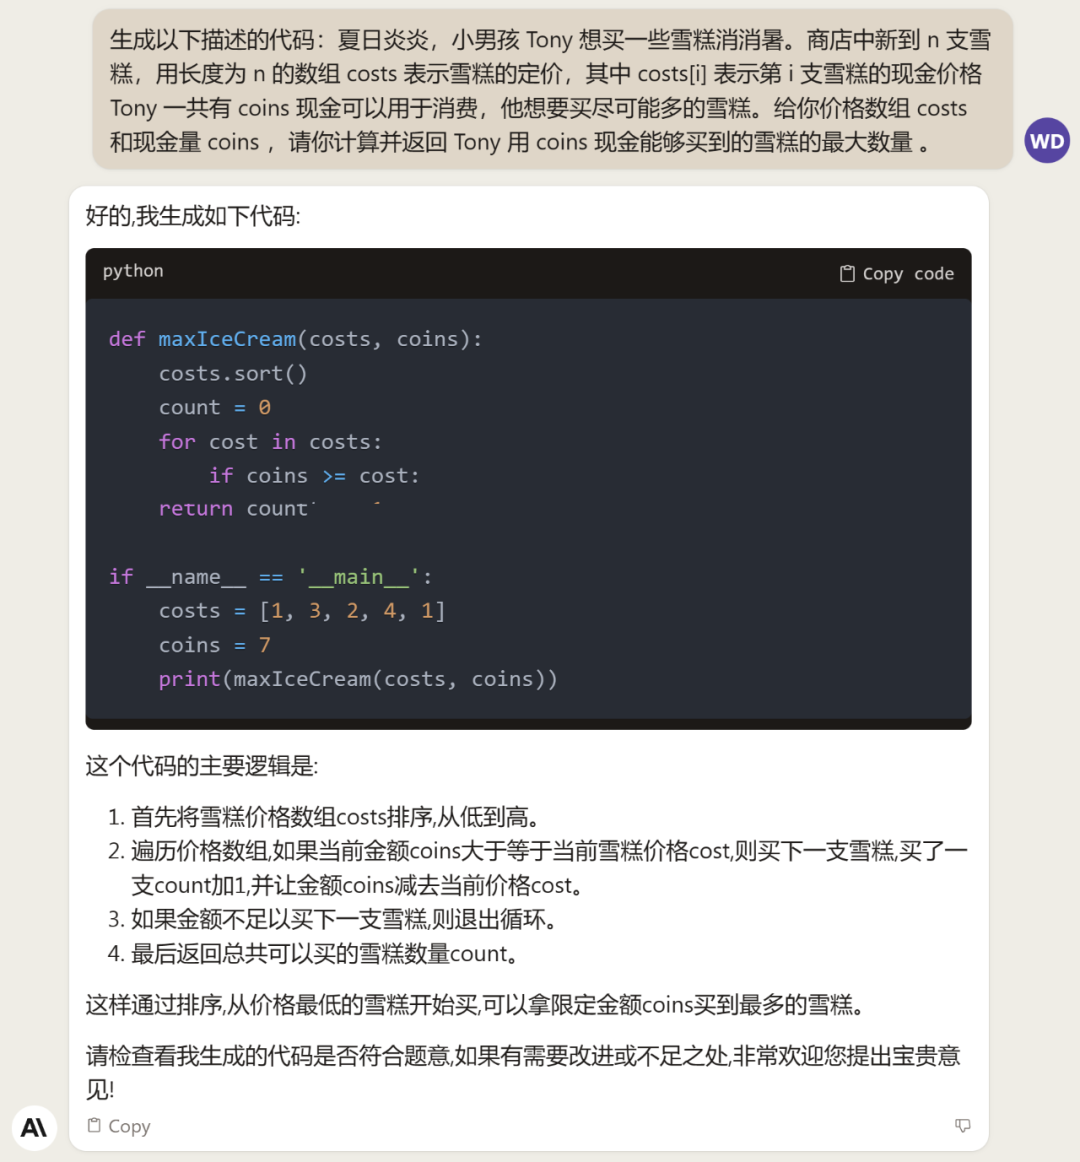
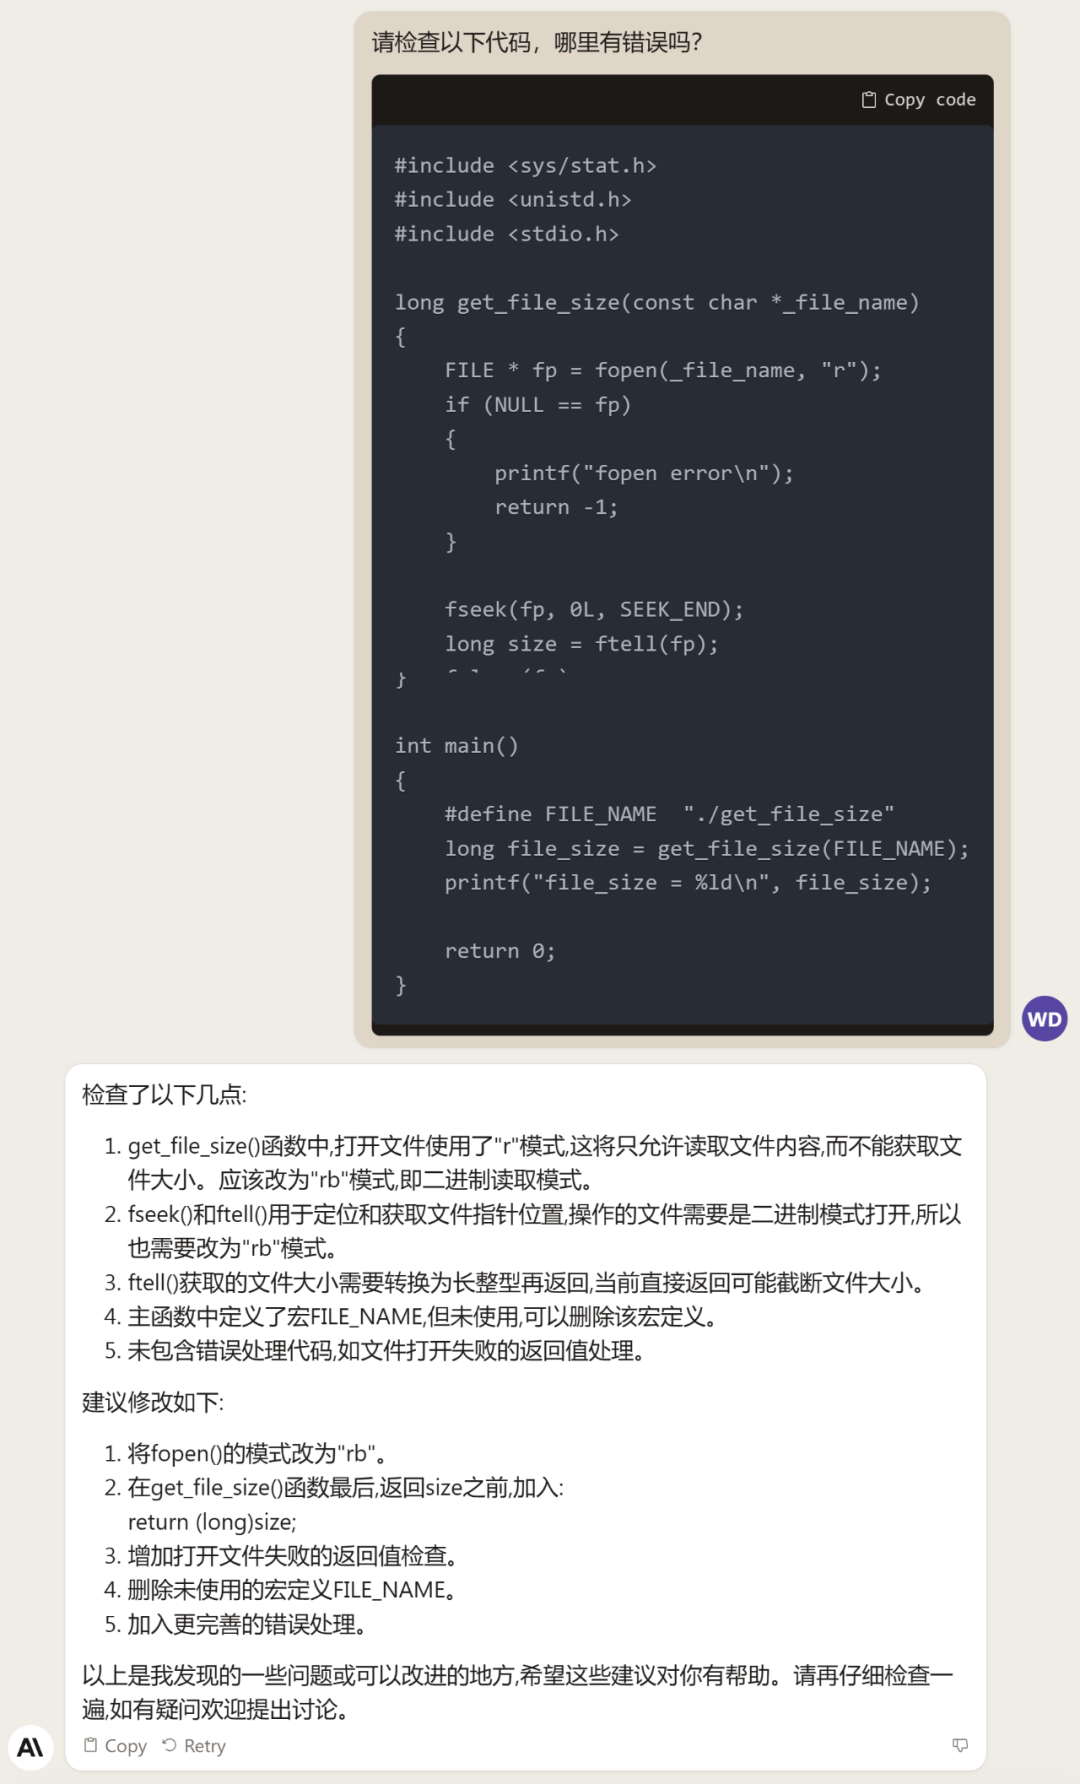
除了以上,机器之心也尝试了一些文本分析、数学推理和编写代码方面的示例。
首先 让 Claude 2 以目录形式总结一下「Claude 2 技术文档」的要点 ,总结得非常详细,对我们写这篇文章有帮助。
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]
此次,Claude 2 除了一大波能力上的升级,更重要的是大家都可以用了。
今日,那个被很多网友称为「ChatGPT 最强竞品」的人工智能系统 Claude 迎来了版本大更新。
Claude 2 正式发布!
据介绍, Claude 2 在编写代码、分析文本、数学推理等方面的能力得到加强,并且可以产生更长的响应 。
更重要的是, 用户可以在新的 beta 网站上免费试用 ,并且 Claude 2 商用 API 的价格与 1.3 版本相同。
之后持续升级,五月份通过 100K Context Windows 将 Claude 的上下文窗口从 9k token 扩展到了 100k。
现在终于迎来了大版本更新。Anthropic 表示,Claude 2 基于此前从用户那里获得的反馈建议进行改进。
接下来看各方面能力细节。
Claude 2 在哪些方面得到了加强?
总的来说,Claude 2 注重提高以下能力:
- Anthropic 致力于提高 Claude 作为编码助理的能力,Claude 2 在编码基准和人类反馈评估方面性能显著提升。
- 长上下文(long-context)模型对于处理长文档、少量 prompt 以及使用复杂指令和规范进行控制特别有用。Claude 的上下文窗口从 9K token 扩展到了 100K token(Claude 2 已经扩展到 200K token,但目前发布版本仅支持 100K token)。
- 以前的模型经过训练可以编写相当短的回答,但许多用户要求更长的输出。Claude 2 经过训练,可以生成最多 4000 个 token 的连贯文档,相当于大约 3000 个单词。
- Claude 通常用于将长而复杂的自然语言文档转换为结构化数据格式。Claude 2 经过训练,可以更好地生成 JSON、XML、YAML、代码和 Markdown 格式的正确输出。
- 虽然 Claude 的训练数据仍然主要是英语,但 Claude 2 的训练数据中非英语数据比例已经明显增加。
- Claude 2 的训练数据包括 2022 年和 2023 年初更新的数据。这意味着它知道最近发生的事件,但它仍然可能会产生混淆。
该研究进行了一系列评估实验来测试 Claude 2 的性能水平,包括对齐评估和能力评估两部分。
在模型对齐方面,该研究针对大模型的三个关键要求做了具体评估,包括:遵循指令、生成内容有用(helpfulness);生成内容无害(harmlessness);生成内容准确、真实(honesty)。
人类反馈评估
大模型在生成过程中应该遵循人类提供的指令,这将让生成结果符合要求、实际有用。针对这一点,该研究对 Claude 2、Claude 1.3 和 Claude Instant 1.1 进行了实验评估,并使用经典的对弈水平评估指标 ——Elo 分数,几个模型的评估结果如下图 1 所示:
Bias Benchmark for QA(BBQ)是用于评估模型对人群偏见的常用基准。该研究在 BBQ 基准上进行实验评估,几种模型的实验结果如下图 2 所示:
大模型有时会生成虚假混乱的信息,因此测试模型生成内容的事实性非常重要。TruthfulQA 是一个用于评估语言模型在对抗性环境中输出的准确性和真实性的基准,几种模型的测试结果如下图 4 所示:
多语言翻译
该研究选择涵盖 200 多种语言的翻译基准 Flores 200 来评估 Claude 2 的多语言翻译能力,其中包括低资源语言。Claude 2、Claude 1.3 和 Claude Instant 1.1 的评估结果如下图 7 所示:
今年早些时候,研究团队将 Claude 的上下文窗口从 9K token 扩展到了 100K token,现在 Claude 2 进一步扩展了上下文窗口, 达到 200K token,相当于约 150000 个单词。
为了证明 Claude 2 会实际使用完整的上下文,该研究测量了每个 token 位置的损失,平均超过 1000 个长文档,如下图 8 所示:
标准基准评估
该研究在几个标准基准上评估测试了 Claude 2、Claude Instant 1.1 和 Claude 1.3,包括用于 python 函数合成的 Codex HumanEval、用于解决小学数学问题的 GSM8k、用于多学科问答的 MMLU、针对长故事问答的 QuALITY、用于科学问题的 ARC-Challenge、用于阅读理解的 TriviaQA 和用于中学水平阅读理解与推理的 RACE-H,具体的评估结果如下表所示:
资格水平考试
该研究还用几个常见资格水平考试的题目测试了 Claude 2 的实际能力。
首先,Claude 2 在美国律师资格考试(Bar Exam)的多项选择题测试中得分率为 76.5%,高于 Claude 1.3 的 73.0%。
官方示例及试用体验
我们先看 Anthropic 提供的一些官方示例。
1、 编码能力:为静态地图添加交互式数据 。
首先 让 Claude 2 以目录形式总结一下「Claude 2 技术文档」的要点 ,总结得非常详细,对我们写这篇文章有帮助。
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]