对于监督学习与无监督学习比较好奇,查阅资料后有了个基本的认知,机器学习算法可以分为3种:有监督学习(Supervised Learning)、无监督学习(Unsupervised Learning)和强化学习(Reinforcement Learning)。监督学习是模型利用有标签数据进行训练,主要解决回归与分类问题。无监督学习是模型利用无标签数据进行训练,主要完成聚类与关联问题。强化学习是用于描述和解决智能体(agent)在与环境的交互过程中通过学习策略以达成回报最大化或实现特定目标的问题。除此之外,结合监督学习与无监督学习形成了半监督学习,而半监督学习是属于弱监督学习中的一种形式。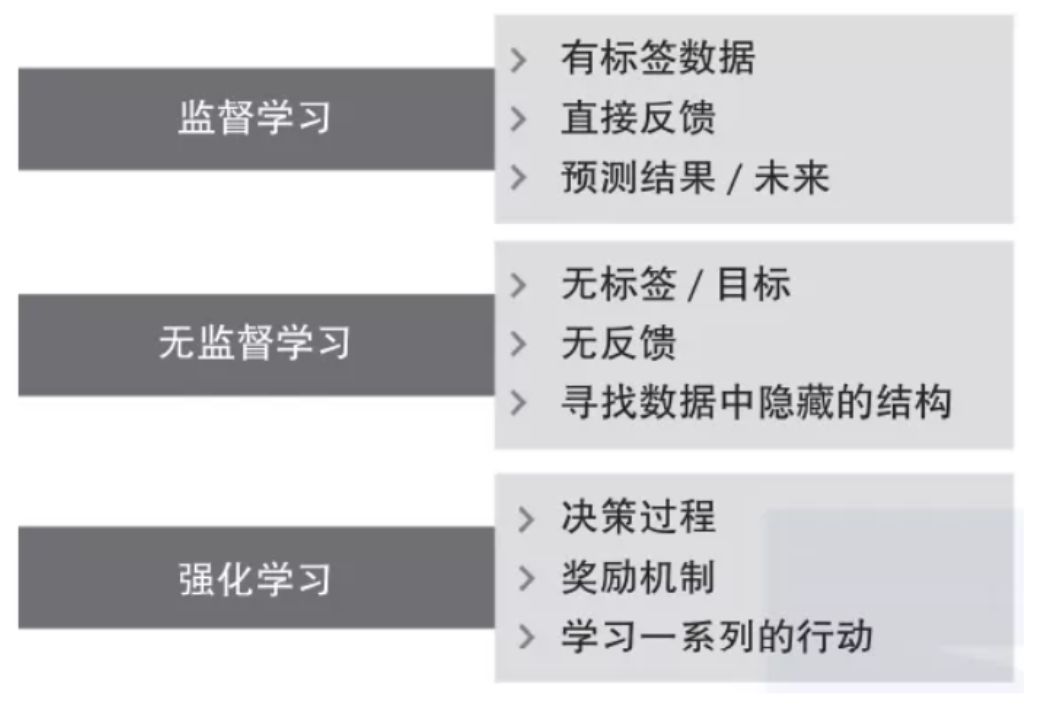
监督学习是机器学习的一种类型,本质是机器使用“标记好”的训练数据进行训练,并基于该数据,机器预测输出。标记的数据意味着一些输入数据已经用正确的输出标记。在监督学习中,提供给机器的训练数据充当监督者,教导机器正确预测输出。它应用了与学生在老师的监督下学习相同的概念。监督学习是向机器学习模型提供输入数据和正确输出数据的过程。监督学习算法的目的是找到一个映射函数来映射输入变量(x)和输出变量(y)。在现实世界中,监督学习可用于风险评估、图像分类、欺诈检测、垃圾邮件过滤等。在监督学习中,模型使用标记数据集进行训练,其中模型学习每种类型的数据。训练过程完成后,模型会根据测试数据(训练集的子集)进行测试,然后预测输出。以下示例和图表可以很容易地理解监督学习的工作原理: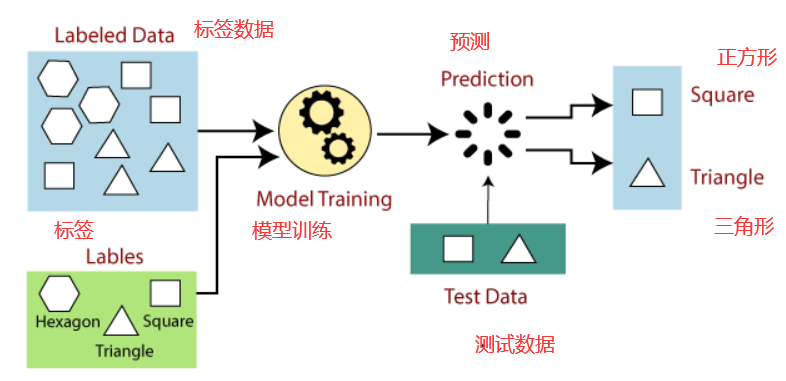 (2)收集/收集标记的训练数据(一般可能需要手动标记);(3)将训练数据集拆分为训练数据集、测试数据集和验证数据集;(4)确定训练数据集的输入特征,这些特征应该有足够的知识使模型能够准确地预测输出;(5)确定适合模型的算法,如支持向量机、决策树等;(6)在训练数据集上执行算法。有时我们需要验证集作为控制参数,它们是训练数据集的子集;(7)通过提供测试集来评估模型的准确性。如果模型预测出正确的输出,这意味着我们的模型是准确的。
4. 解决问题
监督学习主要解决两类问题:回归和分类。
4.1. 回归
如果输入变量和输出变量之间存在关系,则使用回归算法。它用于预测连续变量,例如天气预报、市场趋势等。以下是一些流行的回归算法,它们属于监督学习:
当输出变量是分类时使用分类算法,这意味着有两个类别,例如是 - 否,男性 - 女性,真假等。垃圾邮件过滤,是否为垃圾等。可能用到的算法:
5. 优缺点
优点:在监督学习的帮助下,模型可以根据先前的经验预测输出;在监督学习中,我们可以对对象的类别有一个准确的认识;监督学习模型帮助我们解决各种现实问题,例如欺诈检测、垃圾邮件过滤等。缺点:监督学习模型不适合处理复杂的任务;如果测试数据与训练数据集不同,监督学习无法预测正确的输出;训练需要大量的计算时间;在监督学习中,我们需要足够的关于对象类别的知识。无监督学习是一种机器学习技术,其中模型不使用训练数据集进行监督。相反,模型本身会从给定数据中找到隐藏的模式和见解。它可以比作在学习新事物时发生在人脑中的学习。它可以定义为:使用未标记的数据集进行训练,并允许在没有任何监督的情况下对该数据进行操作。无监督学习不能直接应用于回归或分类问题,因为与监督学习不同,我们有输入数据但没有相应的输出数据。无监督学习的目标是找到数据集的底层结构,根据相似性对数据进行分组,并以压缩格式表示该数据集。示例,假设给定无监督学习算法的输入数据集,其中包含不同类型的猫和狗的图像。该算法从未在给定的数据集上进行过训练,这意味着它对数据集的特征一无所知。无监督学习算法的任务是自行识别图像特征。无监督学习算法将通过根据图像之间的相似性将图像数据集聚类到组中来执行此任务。采用未标记的输入数据,这意味着它没有分类,也没有给出相应的输出。现在,这些未标记的输入数据被输入机器学习模型以对其进行训练。首先,它将解释原始数据以从数据中找到隐藏的模式,然后应用合适的算法,如 k-means 聚类、决策树等。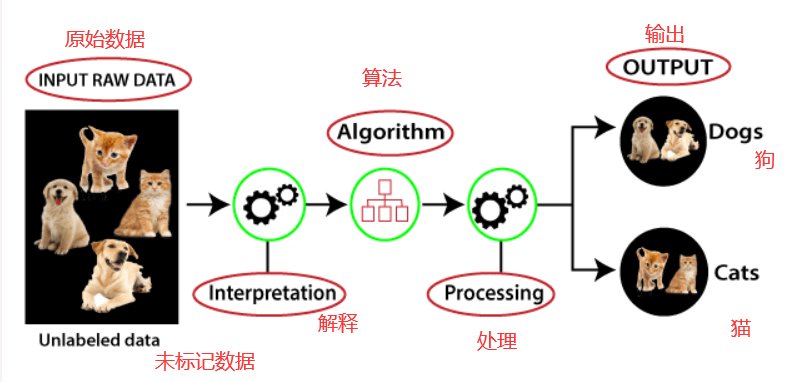
(2)无监督学习与人类通过自己的经验学习思考非常相似,这使得它更接近真正的人工智能;(3)无监督学习适用于未标记和未分类的数据,这使得无监督学习更加重要;(4)在现实世界中,我们并不总是有输入数据和相应的输出,因此为了解决这种情况,我们需要无监督学习;4. 解决问题
4.1. 聚类
聚类是一种将对象分组为聚类的方法,使得具有最多相似性的对象保留在一个组中,并且与另一组的对象具有较少或没有相似性。聚类分析发现数据对象之间的共性,并根据这些共性的存在和不存在对它们进行分类。
关联规则是一种无监督学习方法,用于查找大型数据库中变量之间的关系。它确定在数据集中一起出现的项目集。关联规则使营销策略更加有效。例如购买 X 商品(假设是面包)的人也倾向于购买 Y(黄油/果酱)商品。关联规则的一个典型例子是市场篮子分析。KNN(k-最近邻)
层次聚类
异常检测
神经网络
主成分分析
独立成分分析
先验算法
奇异值分解
5. 优缺点
优点:与监督学习相比,无监督学习用于更复杂的任务,因为在无监督学习中,我们没有标记的输入数据;无监督学习更可取,因为与标记数据相比,它更容易获得未标记数据。缺点:无监督学习本质上比监督学习更难,因为它没有相应的输出;无监督学习算法的结果可能不太准确,因为输入数据没有标记,并且算法事先不知道确切的输出。又称再励学习、评价学习或增强学习,是机器学习的范式和方法论之一,用于描述和解决智能体(agent)在与环境的交互过程中通过学习策略以达成回报最大化或实现特定目标的问题。换句话说,强化学习是一种学习如何从状态映射到行为以使得获取的奖励最大的学习机制。这样的一个agent需要不断地在环境中进行实验,通过环境给予的反馈(奖励)来不断优化状态-行为的对应关系。因此,反复实验(trial and error)和延迟奖励(delayed reward)是强化学习最重要的两个特征。三种学习方式的区别是:监督学习是机器学习领域研究最多的方法,已经十分成熟,在监督学习的训练集中,每一个样本都含有一个标签,在理想情况下,这个标签通常指代正确的结果。监督学习的任务即是让系统在训练集上按照每个样本所对应的标签推断出应有的反馈机制,进而在未知标签的样本上能够计算出一个尽可能正确的结果,例如我们熟悉的分类与回归问题。在强化学习中的交互问题中却并不存在这样一个普适正确的“标签”,智能体只能从自身的经验中去学习。但是强化学习与同样没有标签的无监督学习也不太一样,无监督学习是从无标签的数据集中发现隐藏的结构,典型的例子就是聚类问题。但是强化学习的目标是最大化奖励而非寻找隐藏的数据集结构,尽管用无监督学习的方法寻找数据内在结构可以对强化学习任务起到帮助,但并未从根本上解决最大化奖励的问题。
3. 强化学习特点
没有监督者,只有一个奖励信号
反馈是延迟的而非即时
具有时间序列性质
智能体的行为会影响后续的数据
强化学习系统一般包括四个基本要素:策略(policy),奖励(reward),价值(value)以及环境或者说是模型(model)。接下来我们对这四个要素分别进行介绍。策略定义了智能体对于给定状态所做出的行为,换句话说,就是一个从状态到行为的映射,事实上状态包括了环境状态和智能体状态,这里我们是从智能体出发的,也就是指智能体所感知到的状态。因此我们可以知道策略是强化学习系统的核心,因为我们完全可以通过策略来确定每个状态下的行为。我们将策略的特点总结为以下三点:策略定义智能体的行为
它是从状态到行为的映射
策略本身可以是具体的映射也可以是随机的分布
奖励信号定义了强化学习问题的目标,在每个时间步骤内,环境向强化学习发出的标量值即为奖励,它能定义智能体表现好坏,类似人类感受到快乐或是痛苦。因此我们可以体会到奖励信号是影响策略的主要因素。我们将奖励的特点总结为以下三点:奖励是一个标量的反馈信号
它能表征在某一步智能体的表现如何
智能体的任务就是使得一个时段内积累的总奖励值最大
接下来说说价值,或者说价值函数,这是强化学习中非常重要的概念,与奖励的即时性不同,价值函数是对长期收益的衡量。我们常常会说“既要脚踏实地,也要仰望星空”,对价值函数的评估就是“仰望星空”,从一个长期的角度来评判当前行为的收益,而不仅仅盯着眼前的奖励。结合强化学习的目的,我们能很明确地体会到价值函数的重要性,事实上在很长的一段时间内,强化学习的研究就是集中在对价值的估计。我们将价值函数的特点总结为以下三点:价值函数是对未来奖励的预测
它可以评估状态的好坏
价值函数的计算需要对状态之间的转移进行分析
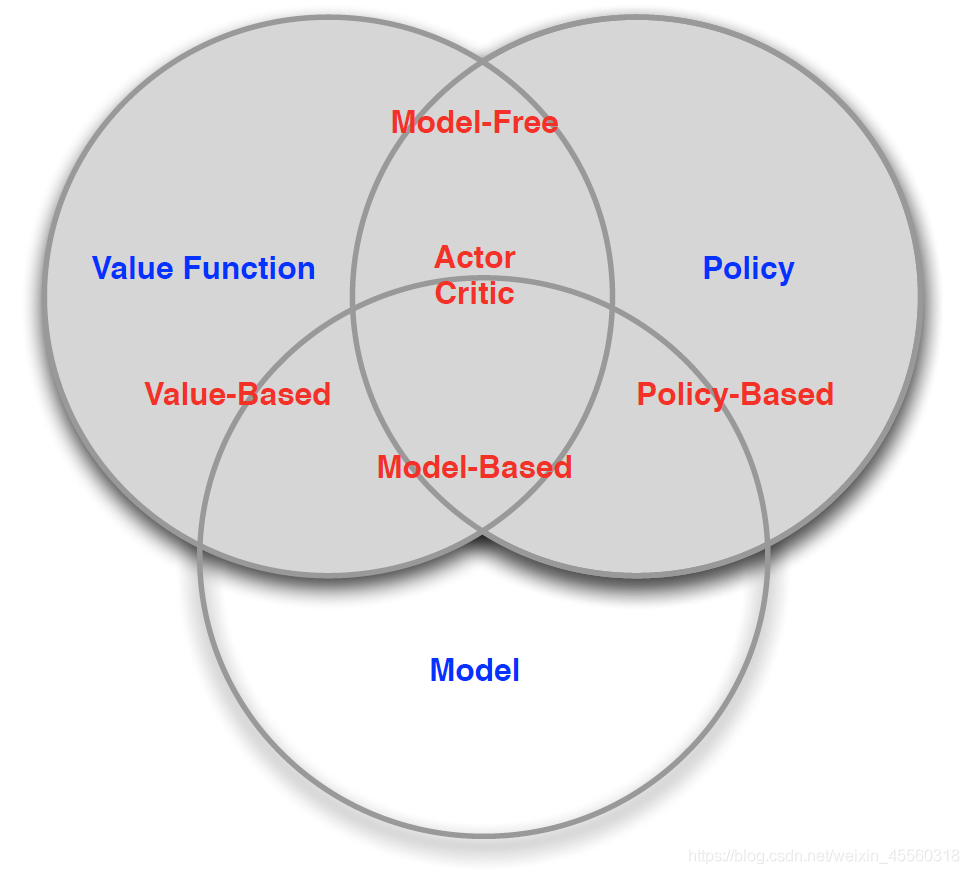
最后说说外界环境,也就是模型(Model),它是对环境的模拟,举个例子来理解,当给出了状态与行为后,有了模型我们就可以预测接下来的状态和对应的奖励。但我们要注意的一点是并非所有的强化学习系统都需要有一个模型,因此会有基于模型(Model-based)、不基于模型(Model-free)两种不同的方法,不基于模型的方法主要是通过对策略和价值函数分析进行学习。我们将模型的特点总结为以下两点:模型可以预测环境下一步的表现
表现具体可由预测的状态和奖励来反映
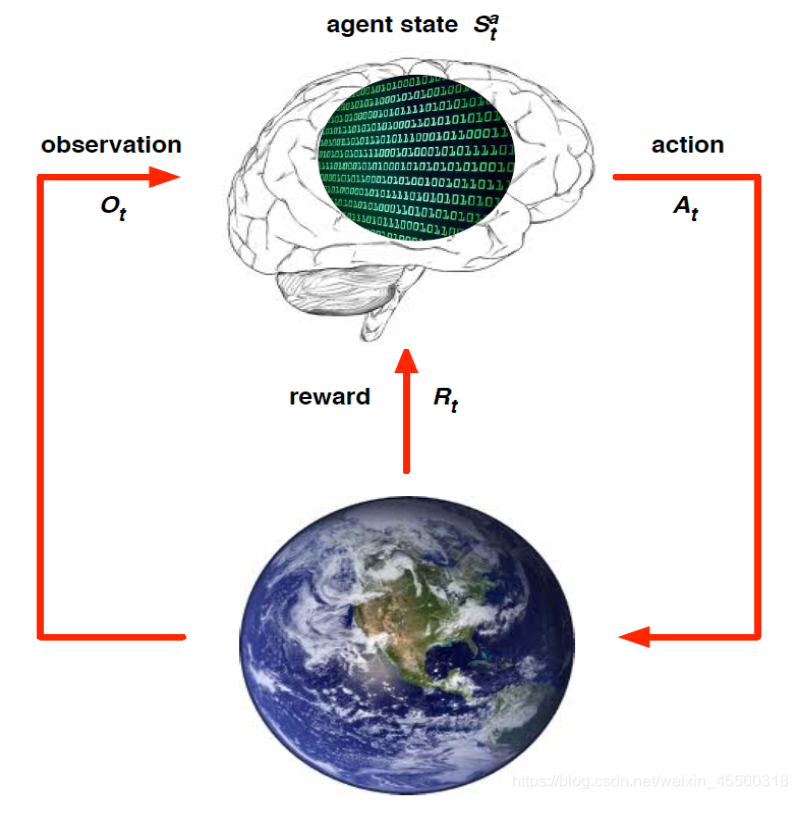
学习架构:我们用这样一幅图来理解一下强化学习的整体架构,大脑指代智能体agent,地球指代环境environment,从当前的状态 出发,在做出一个行为
 之后,对环境产生了一些影响,它首先给agent反馈了一个奖励信号
 ,接下来我们的agent可以从中发现一些信息,此处用
 表示,进而进入一个新的状态,再做出新的行为,形成一个循环。强化学习的基本流程就是遵循这样一个架构。
5. 强化学习的问题
基于价值的方法(Value Based):没有策略但是有价值函数;
基于策略的方法(Policy Based):有策略但是没有价值函数;
参与评价方法(Actor Critic):既有策略也有价值函数。
6. 探索与利用
最后在强化学习的问题这里谈一下探索和利用的问题。强化学习理论受到行为主义心理学启发,侧重在线学习并试图在探索-利用(exploration-exploitation)间保持平衡,不要求预先给定任何数据,而是通过接收环境对动作的奖励(反馈)获得学习信息并更新模型参数。一方面,为了从环境中获取尽可能多的知识,我们要让agent进行探索,另一方面,为了获得较大的奖励,我们要让agent对已知的信息加以利用。鱼与熊掌不可兼得,我们不可能同时把探索和利用都做到最优,因此,强化学习问题中存在的一个重要挑战即是如何权衡探索-利用之间的关系。强化学习是一种理解和自动化目标导向学习和决策的计算方法,它强调个体通过与环境的直接交互来学习,而不需要监督或是完整的环境模型。可以认为,强化学习是第一个有效解决从与环境交互中学习以实现长期目标的方法,而这种模式是所有形式的机器学习中最接近人类和其他动物学习的方法,也是目前最符合人工智能发展终极目标的方法。半监督学习是监督学习与无监督学习相结合的一种学习方法。半监督学习使用大量的未标记数据,以及同时使用标记数据,来进行模式识别工作。当使用半监督学习时,将会要求尽量少的人员来从事工作,同时,又能够带来比较高的准确性。存在的原因主要是:(1)现实的数据往往缺乏标签;(2)数据标注过程的高成本;(3)很多任务很难获得如全部真实标签这样的强监督信息。半监督学习属于弱监督学习中的一个分支领域。通常来说,弱监督可以分为三类。1、不完全监督(incomplete supervision),即,只有训练集的一个(通常很小的)子集是有标签的,其他数据则没有标签。这种情况发生在各类任务中。例如,在图像分类任务中,真实标签由人类标注者给出的。从互联网上获取巨量图片很容易,然而考虑到标记的人工成本,只有一个小子集的图像能够被标注或者是A卡的用户有很多会先被风控引擎等切掉一部分,导致这部分样本无法拥有好坏用户的标签。2、不确切监督(inexact supervision),即只有粗粒度的标签,例如,某些图像问题只有人工打标的粗粒度的标签,这在扁平数据中也较为常见,例如社交网络用户,给这个用户打标签,用户可能是多标签的,但是在标注的过程中仅标注了一个大范围的标签,一个典型直观的例子就是给 猫打标为“猫”而没有细致到打标猫的品种,粗粒度的标签对于细粒度的任务来说帮助很有限。3、不准确的监督(inaccurate supervision),模型给出的标签不总是真实的。出现这种情况的常见原因有,图片标注者的失误,或者某些图片就是难以分类,评分卡的定义都是比较明确的,而在反欺诈、异常检测的应用中,样本的标注往往是模糊的。弱监督学习是一个总括性的术语,涵盖了尝试通过较弱的监督来学习并构建预测模型的各种研究。三种弱监督的联系可见下图:不完全监督考虑那些我们只拥有少量有标注数据的情况,这些有标注数据并不足以训练出好的模型,但是我们拥有大量未标注数据可供使用。不完全监督主要包含了两个方向:(1)active learning 主动学习,大体的思路是未标记数据通过人工专家等方法来进行查询与标注,得到了新的标签信息之后模型继续迭代,这样的过程一直重复下去,最终使得人类的经验知识越来越丰富,模型的泛化性能也越来越好,人机交互,各自获得较好的收益,当然主动学习也是一块比较大的领域,涉及到的技术细节还是非常多的,这里暂时不做深入介绍了;(2)semi-supervised learning 半监督学习,按照学习方式又可以分为纯(pure)半监督学习与直推学习(transductive learning),关于二者的区别需要注意,直推学习(transductive learning)实际上属于另一个更大的概念,它和归纳学习(Inductive Learning)属于两种相对的学派。归纳学习强调的是从大量的样本中学习到潜在的规律,然后去预测未知的样本,基于“开放世界”的假设,即模型进行学习的时候不知道未来要预测的示例是什么,我们常见的逻辑回归、gbdt、nn等等都是基于这样的“开放世界”假设;直推学习则是基于“封闭世界”的假设,模型在学习的过程中已经知道未来要预测的示例是什么样的。直推学习理论的鼻祖——Vapnik认为,经典的归纳学习假设期望学得一个在整个样本分布上具有低错误率的决策函数,这实际上把问题复杂化了,因为在很多情况下,人们并不关心决策函数在整个样本分布上的性能怎么样,而只是期望在给定的要预测的样本上达到最好的性能。后者比前者简单,因此,在学习过程中可以显式地考虑测试样本从而更容易地达到目的。从基于两种学习方式的算法的使用方法层面上来说:直推式半监督中只包含有标签样本集和测试样本集,且测试样本也是无标签样本。直推式半监督算法先将测试样本视为无标签样本,然后利用有标签样本和无标签样本训练模型,并在训练过程中预测无标签样本。因此,直推式半监督算法只能处理当前的无标签样本(测试样本)(wordvec实际上就是一个典型的例子),不能直接进行样本外的扩展。对于新的测试样本,直推式半监督算法需要重新训练模型才能预测其标签。归纳式半监督算法除了使用有标签样本集和无标签样本集外,还使用独立的测试样本集。归纳式半监督算法能够处理整个样本空间中的样本。归纳式半监督算法在有标签样本和无标签样本上训练学习模型。该模型不仅可以预测训练无标签样本的标签,还能直接预测新测试样本的标签。4. 半监督学习
self-training,即自我训练,也称之为伪标签技术,初代半监督思想的经典代表,其基本思路就是,在已标记的数据上训练,然后对未标注数据进行预测,取预测置信度最高的样本直接对其进行标签定义,然后将这类样本纳入当前训练样本中继续训练,直到模型的预测结果不再发生变化;如果是分类问题:选择预测概率最有把握的样本的标签作为真实的标签(例如概率为0.99或者概率未0.01的预测标签),将预测然后将得到的有标注的数据加入原始数据继续进行训练,再预测,一直到达停止条件(例如大部分甚至全部unlabeled的样本都被打上了标签),此时,我们就把未标注的样本通过这种方式标注出来了;如果是回归问题,则进行第一轮预测,将预测结果作为新的标签,然后将unlabeled和labeled的数据合并进行训练,再进行第二次预测,计算两次预测的结果中,unlabeled数据的误差情况,取误差最小的部分样本直接进行标签的定义,最后按照上述的思路反复迭代一直到误差收敛为止,此时,我们就把未标注的样本通过这种方式标注出来了;自我训练实际上是一种数据增广的方式,基学习器可以使用的配置不同,但是只有当初始和后续的类别正确的标记了绝大多数样本时,才能通过迭代改进分类的精度,否则,你使用性能很差的分类模型或者回归模型只会预测出大量错误的标签,从而使得模型在迭代的过程中“错上加错”,然而,即使是高精度的模型,也会不可避免的添加错误的标记噪音,在实际应用中,使用更准确地信任度量(例如99%或者0.01%的阈值)和预定义地置信度阈值来限制错误标记地样本的数量,对于回归问题,我们可以使用多次交叉验证之后取回归预测值的标准差作为衡量,标准差越小则置信度越高。伪标签技术大体可以分为硬标签和软标签,硬标签是直接人工确定某个阈值,然后进行无标签数据的标签判定,而软标签技术从另一个角度提出了一种self traning的思路,主要针对于分类问题,其思路也不复杂,就是根据概率对样本的权重进行定义,例如在二分类问题中,我们对样本A预测的概率为0.4与0.6,则我们将A当作两个样本,标签为0的样本其权重为0.4,标签为1的样本其权重为0.6,而后加入原始的数据进行训练和迭代直到收敛或达到预先定义的停止条件为止。关于半监督学习的算法请看该文章:https://zhuanlan.zhihu.com/p/349107869。此外还存在深度半监督学习。5. 应用中存在的问题
无标签样本的有效利用问题。上述使用的各类半监督学习算法在训练阶段都没有太多考虑无标签样本的质量问题,如果无标签样本的质量比较差甚至是完全不同分布的数据,那么很容易反而降低模型的泛化性能。大量无标签样本的高效使用问题。半监督算法的计算复杂度、提升性能的效果以及可扩展性、易用性等都是在实际的工程中要考虑的问题,例如上面所说的TSVM,SVM本身的计算效率就不高,基于半监督不断进行迭代与收敛会使得整个算法的运行时间特别长,而且,就目前风控以lr和gbdt为主的情况下,TSVM难以扩展到这两个算法上面来。特征选择中的有效性问题。可以看到,很多半监督的算法都有无监督的影子,即在没有标签的情况下使用各种奇怪的套路,比如标签传播算法,所以和无监督一样,这类半监督算法对于特征的选择非常的敏感,如果你的特征有很多的辣鸡特征,那么可能效果就会大打折扣了。参考:
https://blog.csdn.net/weixin_46211269/article/details/125093635
https://blog.csdn.net/weixin_45560318/article/details/112981006
https://zhuanlan.zhihu.com/p/349107869
 pythonic生物人约 17 分钟