大猩猩也会玩《我的世界》了,看一遍视频就能get新技能
机 机器之心约 4 分钟
机器之心报道
编辑:张倩
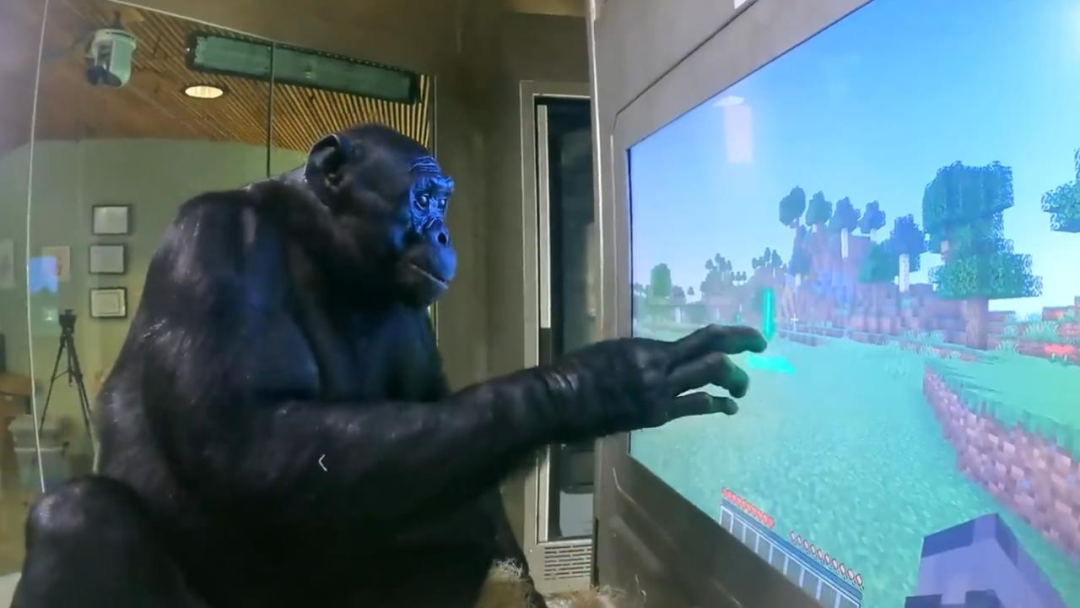
图中的这个大猩猩名叫 Kanzi,是一个 42 岁的倭黑猩猩(bonobo)。它会通过点击触摸屏来玩游戏:点击屏幕中央向前移动;触摸侧面环顾四周。如果表现出色,研究人员会给予奖励,比如花生或其他零食。
或许是因为之前玩过一些游戏,Kanzi 刚坐到屏幕前就进入了状态,几秒钟就学会了如何操作角色前进。只要它能到达指定区域,屏幕上就会出现零食的图案,同时工作人员也会给它对应零食。在这样的奖励机制下,Kanzi 很快学会了如何在游戏里行走。
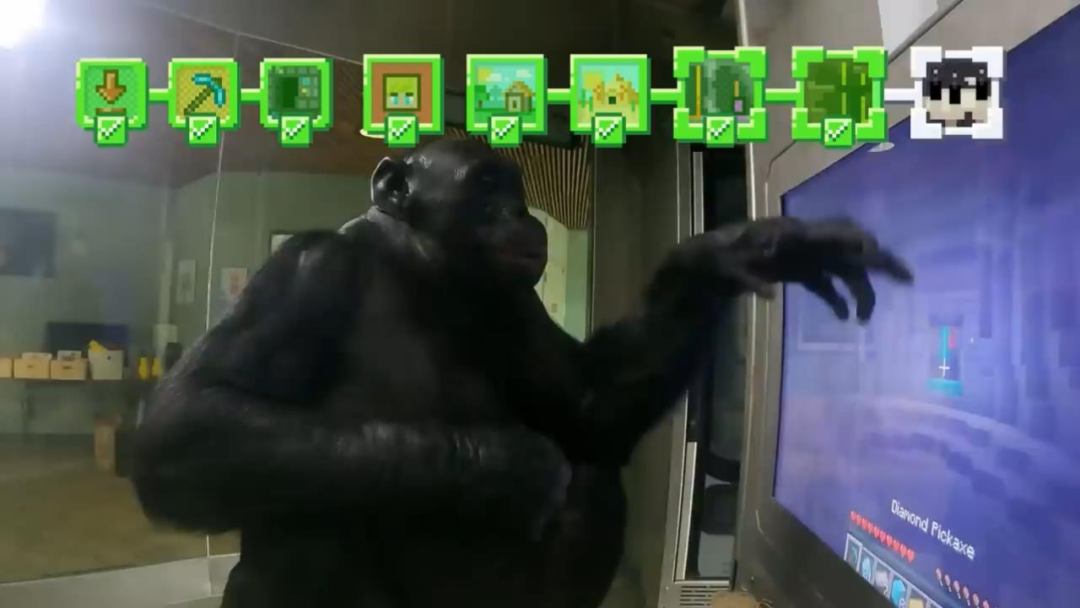
这个视频在国外视频网站引起了很多人关注。视频制作者、YouTube 博主 ChrisDaCow 的本意是呼吁人类关注野生动物,看到这些动物有趣的一面。
「大猩猩的视觉系统如此强大也让我感到惊讶。Kanzi 一生都没见过《我的世界》,他的祖先肯定也没见过。但他很快就适应了《我的世界》里与自然世界截然不同的纹理和物理。这种泛化水平远远超出了我们今天最强大的视觉模型所能做的。我们又一次陷入了莫拉维克悖论:我们最好的人工智能在理解语言方面接近人类的水平,但在解析像素方面远远落后于动物。」Jim Fan 评价说。 莫拉维克悖论是由人工智能 和机器人学者所发现的一个和常识相左的现象。和传统假设不同,人类所独有的高阶智慧能力只需要非常少的计算能力,例如推理。但是无意识的技能和直觉却需要极大的运算能力。这个理念是由汉斯・莫拉维克、布鲁克斯、马文・闵斯基等人于 1980 年代所阐释。如莫拉维克所写:「要让电脑如成人般地下棋是相对容易的,但是要让电脑有如一岁小孩般的感知和行动能力却是相当困难甚至是不可能的。」 但有人对此提出了质疑,认为 Kanzi 其实只是为了得到奖励才一直继续,「它根本不知道发生了什么,」也并没有真正学会玩《我的世界》。
这个实验有趣的地方还在于,它让人脑洞大开:现在 ChatGPT 和大猩猩都会玩《我的世界》了,如果未来脑机接口发展顺利还会发生什么?
训练大猩猩和训练AI有不少通用的技巧。在教会 GPT-4 玩《我的世界》(Minecraft)之后,人类也教会了大猩猩玩这款游戏。
- In-context 强化学习:当 Kanzi 在游戏中达到标记的里程碑时,他会得到水果或花生作为奖励,激励他遵循游戏内的指导。
- 人类反馈强化学习(RLHF):Kanzi 并不完全理解语言,但他能看到训练师为他加油,他偶尔也会回应加油!这为他提供了一个强烈的信号,表明他走在正确的道路上。
- 模仿学习:训练师向 Kanzi 展示了一个任务的示范做法,而且只展示了一次,它就理解了其中的概念。这比仅仅使用奖励更加高效。
- 课程学习:他们从非常简单的环境开始,逐渐教会 Kanzi 控制技能。最终,Kanzi 能够在复杂的洞穴、迷宫和下界之间前行。
「大猩猩的视觉系统如此强大也让我感到惊讶。Kanzi 一生都没见过《我的世界》,他的祖先肯定也没见过。但他很快就适应了《我的世界》里与自然世界截然不同的纹理和物理。这种泛化水平远远超出了我们今天最强大的视觉模型所能做的。我们又一次陷入了莫拉维克悖论:我们最好的人工智能在理解语言方面接近人类的水平,但在解析像素方面远远落后于动物。」Jim Fan 评价说。 莫拉维克悖论是由人工智能 和机器人学者所发现的一个和常识相左的现象。和传统假设不同,人类所独有的高阶智慧能力只需要非常少的计算能力,例如推理。但是无意识的技能和直觉却需要极大的运算能力。这个理念是由汉斯・莫拉维克、布鲁克斯、马文・闵斯基等人于 1980 年代所阐释。如莫拉维克所写:「要让电脑如成人般地下棋是相对容易的,但是要让电脑有如一岁小孩般的感知和行动能力却是相当困难甚至是不可能的。」 但有人对此提出了质疑,认为 Kanzi 其实只是为了得到奖励才一直继续,「它根本不知道发生了什么,」也并没有真正学会玩《我的世界》。