 ▎药明康德内容团队编辑你爱刷社交媒体吗?只要利用合理,社交媒体也可以成为“学习网站”。最近,权威医学期刊《自然-医学》上的一项新研究就展示了一个生动的例子。斯坦福大学医学院的研究人员利用社交媒体上公开共享的医学信息,开发了一个多模态人工智能(AI),可以用于提升诊断、知识共享和教育水平。
研究人员在论文中指出,由于标注病理图像需要的专业知识“门槛”很高,医学领域缺乏公开可用的标注医学图像,是计算研究和教育创新的一大障碍。另一方面,近年来随着社交媒体的兴起,大量医疗专业人员在推特(Twitter)等公共平台上分享了许多去标识化的图像和丰富的知识。如何利用这一宝贵的资源?这项研究中,斯坦福的James Zou团队利用这些众包平台,整理并构建了迄今为止最大的公开病理图像数据集,名为OpenPath,包含超过20万张病理图像,每张图像都有相应的自然语言描述。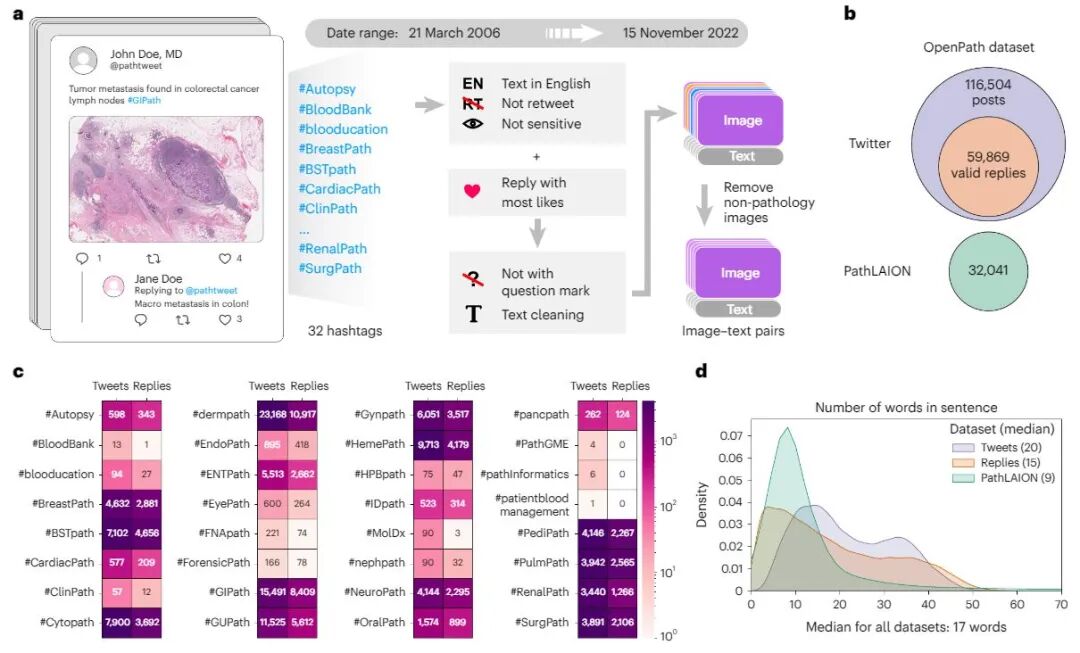
▲根据相关推文抓取、清洗数据并建立数据库(图片来源:参考资料[1])基于OpenPath数据集和OpenAI的CLIP模型,研究人员开发了一种病理语言-图像预训练(PLIP)模型,将自然语言注释整合到学习过程中,让该模型获得理解图像和文本的能力。根据研究者对该模型的全面评估,PLIP在对四个外部数据集进行新病理图像分类时表现出色:在零样本分类方面,与之前对比性语言-图像预训练模型的F1得分(0.030-0.481)相比,PLIP实现了0.565-0.832的F1得分。在PLIP嵌入的基础上训练简单的监督分类器,与使用其他监督模型嵌入相比,F1得分还提高了2.5%。此外,PLIP使用户能够通过图像或自然语言搜索检索相似的病例,表明它能够极大地促进知识共享。在文章提供的网站上(https://tinyurl.com/webplip),用户可以自行通过文字或者病理图片来检索相似的病理图片。这一搜索引擎将会帮助医生通过图片或者文字来搜索相似语义的病例,帮助学习,咨询,以及诊断。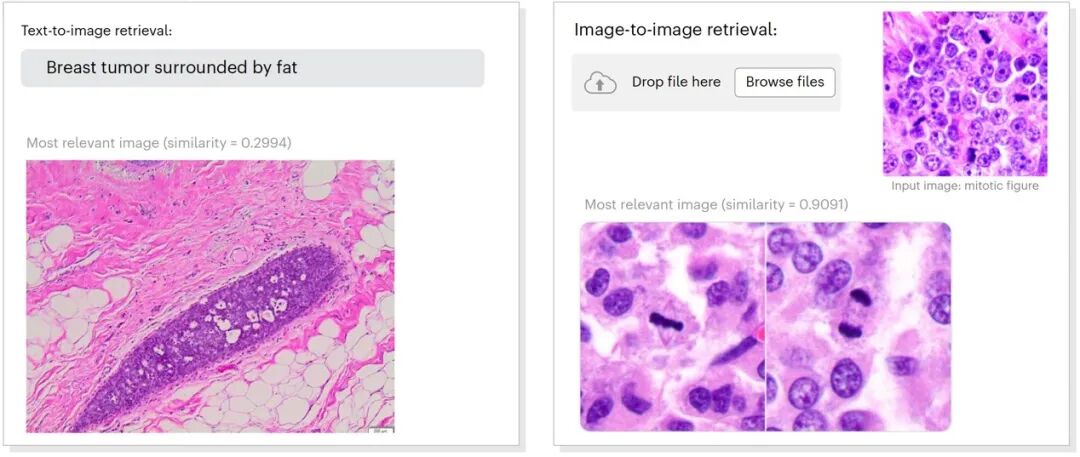
▲文章提供的模型可以让用户通过文字和图片检索相似的病理图片(图片来源:参考资料[1])据第一作者黄治博士及共同一作Federico Bianchi博士介绍,这项成果是病理医学视觉语言领域取得的重要进展,自今年4月预印版发布以来,仅模型下载量就已超过25,000次。该论文也启发了很多后续的研究工作。同时,作者也表示,自2023年以来在该领域有很多其他优秀的工作值得大家探讨学习,比如包括影像学在内的BiomedCLIP,PubMedBert,以及生成式人工智能Med PaLM M,Med-Flamingo工作等,都极大地推动了医学人工智能的发展与进步。黄治博士向学术经纬介绍,自从ChatGPT的风靡和视觉语言模型的发展,未来的医学人工智能将会彻底改变目前的医学培训和辅助诊断的范式。当然,目前的研究还是以探索为主。我们还有很多问题需要解决,包括:(1)目前依然缺乏一个非常可靠的视觉基础模型来解决所有医学图像问题,尤其是可解释性方面;(2)生成式人工智能产生的“幻觉”(hallucinations)问题会极大地降低医生使用的兴趣(Algorithm aversion);(3)医学图像与一般的视觉图像有本质的不同:一个成年人可能仅需17小时就能学会驾驶,而一个医学生则需要至少8年的学习和训练才能有资格成为一名主治医师。因此,在医学领域,人工智能所面临的挑战更为复杂。这些问题都亟需科研工作者慢慢探索。“这篇研究的突出贡献在于阐明了互联网上公开的、以自然语言标注的高质量医学数据是一个巨大的潜在教育资源,能够帮助学者和医生学习,分享,以及开发算法。”黄治博士补充说。研究人员希望通过开源PLIP和OpenPath进一步推动病理学AI的发展,促进医学知识共享,从而造福于医学人工智能领域。参考资料:
[1] Zhi Huang et al., (2023) A visual–language foundation model for pathology image analysis using medical Twitter. Nature Medicine Doi:https://doi.org/10.1038/s41591-023-02504-3
本文来自药明康德内容微信团队,欢迎转发到朋友圈,谢绝转载到其他平台。如有开设白名单需求,请在“学术经纬”公众号主页回复“转载”获取转载须知。其他合作需求,请联系[email protected]。
免责声明:药明康德内容团队专注介绍全球生物医药健康研究进展。本文仅作信息交流之目的,文中观点不代表药明康德立场,亦不代表药明康德支持或反对文中观点。本文也不是治疗方案推荐。如需获得治疗方案指导,请前往正规医院就诊。
 学术经纬约 4 分钟