「 19. 有趣的注意力测试」
L:上回我们说到让机器能理解语言的第一步是向量化。今天我们继续将讲述第二步——信息压缩与特征提取。在此之前,我先出一道题考考小朋友们。
探险队带着藏宝图,他们历经千辛万苦,终于在一个洞穴深处挖出了大量____? A. 地下水;B. 尸骨;C.金银珠宝。请问选哪个?
A:选C,带着藏宝图肯定是找金银珠宝,而不是地下水和尸骨啊。
L:回答的很好!大家注意到没,如果没有最前面的探险队和藏宝图,则这三个答案都有其合理性,甚至在洞穴深处这样的背景下,地下水和尸骨似乎还更合适一些。接下来,我改编一下题目再考考小朋友们。
探险队在沙漠迷路了,他们历经千辛万苦,终于在一个洞穴深处挖出了大量____? A. 地下水;B. 尸骨;C.金银珠宝。请问选哪个?
B:选A,沙漠迷路了,水才是最重要的。
L:很棒!我们来看看,同样的问题来问ChatGPT4,它能答对吗?
GPT-4的回答是正确的,厉害吧,思路也和两位小朋友差不多。A爸:厉害!看起来GPT-4似乎和我们人类一样有推理能力了。
L:准确的说法应该是它通过句子中的上下文,注意到了哪些词对回答起到更关键的作用,这种注意力,实现了更为厉害的信息压缩与特征提取。
A爸:哦,怎么说?
L:这个随后我再解释。
「 20. 注意力不足的R时代」
L:请问大家是否知道ChatGPT的GPT是什么意思?L:G表示Generative,即生成式;P表示Pre-trained,即预训练的;而这个T就是Transformer,合起来表示为生成式与训练的Transformer。L:这可是一个厉害的语言模型架构,正是这种架构助力GPT-4迅速而有准确的回答了前面的问题。在Transformer架构被提出之前,语言模型的主流架构主要是循环神经网络Recurrent Neural Network,简称RNN。RNN按顺序逐字处理,每一步的输出取决于先前的隐藏状态和当前的输入,要等上一个步骤完成后才能进行当前计算,这种模式似乎比较符合人类阅读的习惯,不过却存在明显的不足。L:首先是这种串行模式显然无法并行计算,因为一并行,顺序就无法保障了。这样无法发挥硬件资源多优势,导致训练效率极低。L:由于RNN的架构特点,词之间的距离越远,前面对后面的影响就越弱,难以有效捕获到长距离的语义关系,导致RNN及不擅长处理长序列,即长文本。在人类自然语言中,依赖信息较远时很常见的情况。比如之前提到的那句话“探险队带着藏宝图,他们历经千辛万苦,终于在一个洞穴深处挖出了大量____”,正确预测下一个词的关键词是距离很远的藏宝图。使用RNN就可能把前面给忘没了,只剩下“终于在一个洞穴深处挖出了大量____”,如此一来,距离很近的“洞穴”当成了预测的关键词,自然无法得到正确的答案。L:有的,为了捕获长距离的依赖性,后来也出现了RNN的改良版本LSTM,即长短期记忆网络,但是处理非常长的序列时依然受限。此外无论是RNN还是改良版LSTM,都依然无法实现并行计算,效率提不上。看来RNN架构的这个R时代走向穷途末路了。A爸:那您的意思就是Transformer架构能解决这些问题?
L:是的,Transformer携带自注意力机制这个大杀器,踏着七彩祥云出现了,带我们走进了T时代。「 21. 注意力即一切的T时代」
L:Transformer架构有能力学习输入序列里所有词的相关性和上下文,不会受到短时记忆的影响。做到这点的关键在于Transformer的自注意力机制。也就是之前A爸问我具体该如何进行信息压缩与特征提取时,我提到一篇论文,A爸还记得论文名吗?
A爸:叫《Attention Is All You Need》?
A:是的,记忆力不错!Attention Is All You Need翻译成中文,叫“注意力就是你所需要的一切”。简单来说,Transformer在处理每个词时,会注意这个词本身,以及它附近的词。论文中展示了这么一句简单的例子“The animal didn't cross the street because it was too tired”。这个词本身和附近的词的关系就如下图所示实际上,Transformer在处理每个词时,不仅仅是关注这个词本身和相邻的词,还做到让句子处理每个词时,还会去注意句中所有其他的词。A爸:L老师,我没听错吧,所有其他词,那分析语句时开销会很大吧。L:是的,A爸对性能很敏感。比如还是针对这句简单语句,这样会形成非常错综复杂的连接,如下图所示。A爸:哇,看的头都大了,如果是给GPT-4很长的文字,那分析量岂不是非常大。L:是的,好在现在硬件的性能不断提升,算法也在优化之中。这里需要注意一点,在进行文本分析时,GPT-4对每个词会分配不一样的注意力权重。L:权重是模型在训练过程中通过大量文本逐渐学会的。因此Transformer有能力知道当前这个词和其他词之前的相关性有多强,然后去专注于输入里真正重要的部分,即使两个词的位置隔的很远,Transformer依然可以捕获到它们之间的依赖关系。还是这句The animal didn't cross the street because it was too tired 。这里it 可以指的是离更近的“street”,也可以是离得更远的“animal”,但是自注意力机制捕获到了it 和animal之间更强的关系,因此更集中在animal上。A爸:好比GPT-4捕获到了到藏宝图一词与金银珠宝之间更强的关系;捕获到了沙漠、迷路等词与地下水之前更强的关系一样。
L:是的A爸。现在我可以跟你解释一下,这种注意力机制为啥可以实现更为厉害的信息压缩与特征提取。传统算法在提取特征的时候,想的都是自己,都是一些很局部的信息,比如图像处理的卷积都是一个个窗口,RNN递归网络我们是一个个词,这些其实都是小的单独的个体,很难有一些全局特征。比如说窗口和窗口之间的关系,词跟词之间的关系。而Transformer架构因为其注意力机制,从局部与局部,局部与整体的关联关系中,提取到了全局向量和全局信息。「 22. T时代位置编码的巧妙创新」
L:大家应该都注意到,语言中每个词的顺序极为重要,即使句子里包含的字都是一样的,顺序不一样,也能导致意思完全不一样。比如“小处不可随便“和”不可随处小便“。差异大不大?L:正因为语言必须严格保障每个词的顺序,所以之前的语言处理模型都是RNN模型,一种有序的递归网络架构。不过,前面也提到了,这种方式因为只能串行,无法同时学习所有信息,造成了训练速度的瓶颈。到底有没有什么更好的解决方案,来摆脱这种困境呢?L:大家想想看,一个句子形成时,每个词在句子中的位置已经固定了,把每个词的位置都编码记录下来后,是不是妈妈再也不用担心我的词语顺序呢?A:哦,对啊!这样这些词就可以同时交给多台机器并行处理了。
L:是的,这就是Transformer的另一项关键创新,叫位置编码。即记录每个词在句子中的位置,用来确保词在句子中的顺序的正确性。借助位置编码,词可以不按顺序输入给Transformer,模型可以同时处理输入序列里的所有位置。而不需要像RNN那样以此处理。L:别忘了,每个词本身的含义是有局部性的,可以在一定程度上脱离顺序哦。L:说起来也简单,大家知道词在输入给神经网络前首先会先进行向量化处理,转换成一串数字。而位置编码则是把每个词在句子中的位置也一串数字表示,添加到输入序列的表示中,然后把这个结果给神经网络。以I am a student为例。为简化仅设3个维度,假定词向量为 I [0.28,0.55,-0.3],am [0.18,0.36,0.22],a [0.44,0.33,0.11],student [0.19,0.24,-0.9]。接下来是位置向量化,假定依此为[0.11,0.21,0.35]、[0.31,0.51,0.12]、[0.36,0.22,0.52]、[0.10,-0.1,1.00]。接下来,就是要得出包含位置信息的(I) (am) (a ) (student)了。这里简化为向量相加给大家示范,如0.28+0.11=0.39,0.55+0.21=0.76,-0.3+0.35=0.05。于是(I)的向量化值就出来了,即[0.39,0.76,0.05]。同理得出(am) [0.49,0.87,0.34],(a)[0.80,0.55,0.63],(student) [0.29,0.14,0.1]。换句话说,就是 Transformer通过将I am a student 转成(I) (am) (a ) (student ),实现了词向量与位置向量的融合,使句子具备了并行处理能力。A爸:这个(I) (am) (a ) (student )好巧妙啊!L:是的,现在Transformer既可以理解每个词的意义,又能够捕获词在句子中的位置来理解不同词之间的顺序关系。在计算时每个输出还可以独立地计算。不需要等待其他位置的计算结果。这大大提高了训练速度。正是这种提速让训练大模型成为了可能。「 23. 从注意力到推理能力」
L:Transformer问世后即一统天下,将大语言模型技术推向了令人瞠目结舌的高度。大家回顾一下先前的两道测试题,其实对GPT-4就是小菜一碟。
A:哦,那来一道更难的吧。
L:好,这题爸爸妈妈们可以一起做,10秒思考时间,大家愿意挑战吗?
众人都很自信,跃跃欲试。
L:话说有一位猎人,他向南走了100米,向东走了100米,再向北走了100米,回到了原地,这时他看到了一头熊,然后开枪打死了这头熊,请问这头熊是什么颜色的?
10秒很快过去了,大家一时想不出答案。
L:答案是白色。
为啥....让我们来考考GPT-4,看看它是如何回答的。
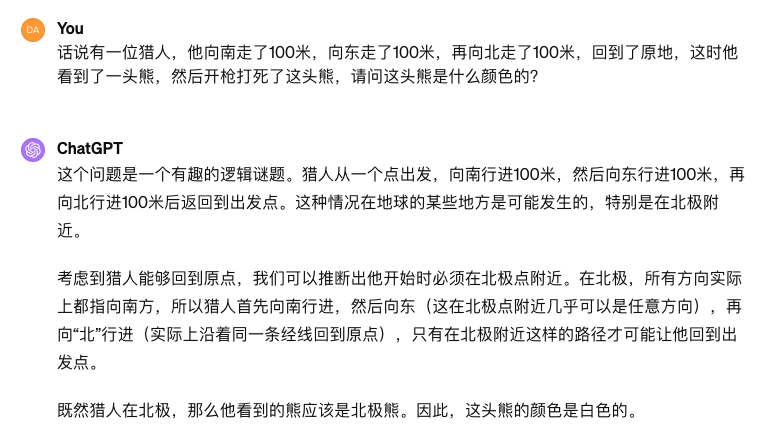
GPT-4是这么想的,从走回原点推断出是北极,再从北极推断出北极熊,最后从北极熊推断毛发是白色的。怎么样,GPT-4的推理能力如何?面对GPT-4如此清晰的推理,众人简直惊掉了下巴,一时说不出话来。L:熊颜色的测试来自一篇名为《Sparks of Artificial General Intelligence: Early experiments with GPT-4》的论文,该论文还有其他测试,涵盖了多模态和跨学科组合、根据变态要求写代码、使用工具与世界互动、理解人类心智等方面。该论文的最终结论是,GPT-4可以被看作是通用人工智能的早期版本。L:GPT-4的复杂度和网络规模比AlphaGo要大很多,两者间差了四到五个数量级。当一句话传过中间的Transformer层时,在多种不同视角下,每个无数的神经元被一层层的激活,一边注入大量的信息,一边对这些信息进行筛选权衡,然后一层又一层的反复这个过程,最终实现了对这段话的透彻理解了。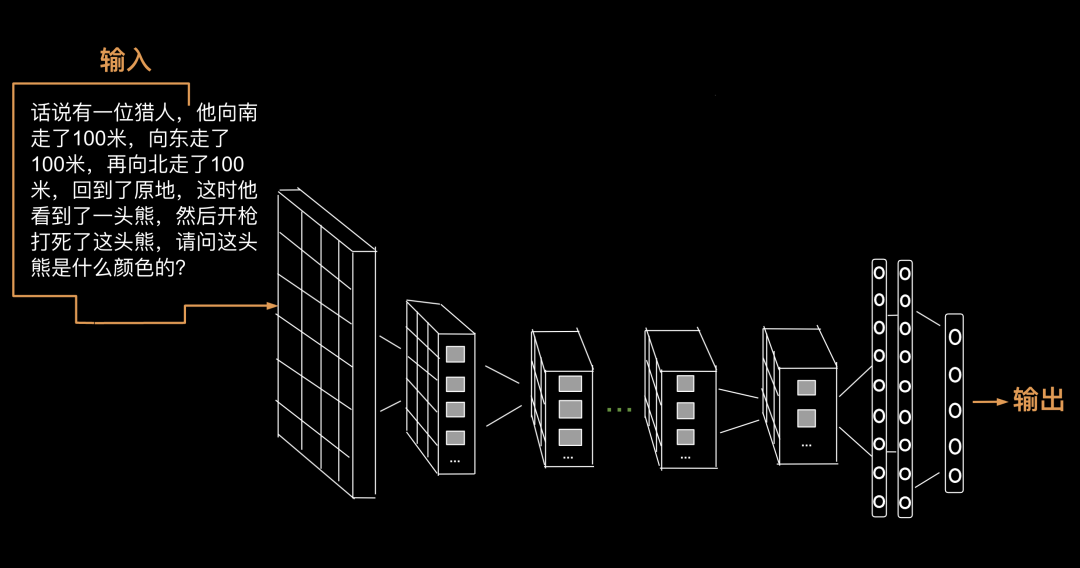
A爸:听起来好厉害啊。
L:接下来我会说说GPT-4完整工作流程与原理,也会给大家展示其更加不可思议的能力。时间不早了,我们下回分解。
 梁敬彬约 9 分钟