最近,有一个激动人心的消息从中关村传来!生数科技联合清华大学,在未来人工智能先锋论坛上正式发布了中国首个高性能的视频大模型——Vidu。
什么是Vidu?
Vidu是第一个在中国研发的长时长、高一致性、高动态性视频大模型。这意味着它可以生成长达16秒、1080P高清分辨率的视频,这些视频不仅清晰,而且内容连贯、生动。Vidu的出现,让我们对AI视频生成的未来充满了期待。Vidu的技术背景
Vidu采用了创新的U-ViT架构,这是一种将Diffusion与Transformer技术结合的模型。通过这种结合,Vidu能够在视频生成过程中,保持时间与空间的高度一致性,生成的视频不仅画面质量高,而且内容丰富、生动。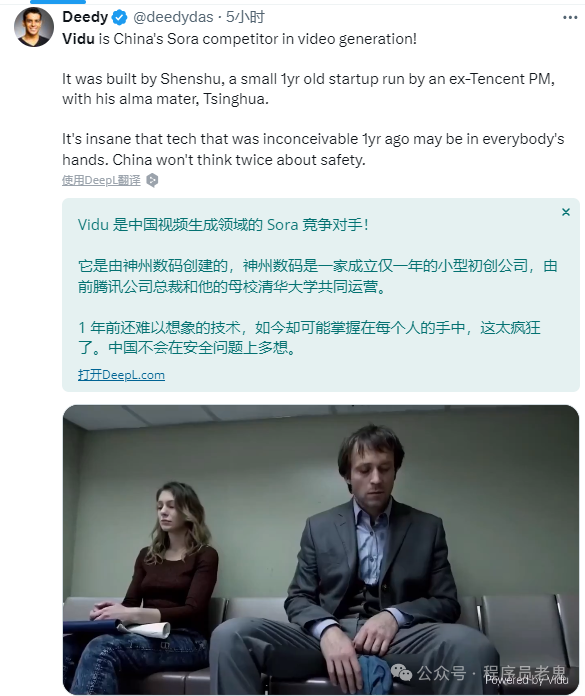
1. Diffusion技术
Diffusion模型通过逐步加入噪声,并学习如何逆转这个过程,生成高质量的图像或视频。在Vidu中,这项技术被用来确保视频内容的连贯性和逼真度。2. Transformer架构
Transformer架构最初设计用于处理语言任务,其后广泛应用于计算机视觉等多个领域。Vidu利用这一架构处理复杂的视频数据,提高了处理速度和效率。3. U-ViT架构
U-ViT是一种全新的架构,特别设计用于结合Diffusion与Transformer的优势,处理长视频数据。这是全球首创的技术,大大提高了视频生成的质量和效果。实际应用案例
Vidu的应用案例同样令人兴奋。从木头玩具船在地毯上航行的逼真场景,到阳光照射的海边小屋,再到山路上行驶的SUV,Vidu生成的视频内容丰富多彩,展示了其在多种场景下的强大适应性和创造力。Vidu的发布不仅代表了中国在视频大模型领域的技术突破,更开启了一系列可能的新应用,从电影制作到虚拟现实,从视频游戏到在线教育,其影响深远。
随着技术的进一步发展和优化,我们可以预见到,Vidu将在未来的多媒体内容创作中扮演越来越重要的角色。
它不仅提升了视频生成的技术水平,也为创作者提供了更多的可能性,让想象力和创新无限扩展。让我们拭目以待
课程包含超多ChatGPT前沿玩法,帮助大家熟练掌握ChatGPT!
 鬼哥约 2 分钟