Karpathy最新四小时视频教程:从零复现GPT-2,通宵运行即搞定
机 机器之心约 3 分钟
机器之心报道
编辑:杜伟
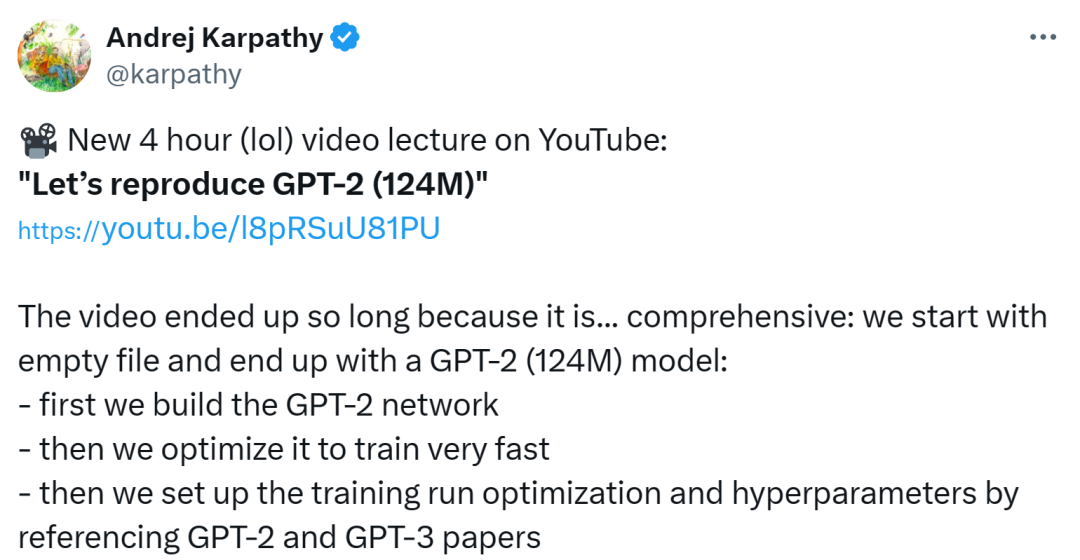
Karpathy 表示,此次视频之所以这么长,是因为它很全面:
从空文件开始,最后得到一个 GPT-2(124M)模型。
具体实现步骤包括如下:
 GitHub 地址:https://github.com/karpathy/build-nanogpt
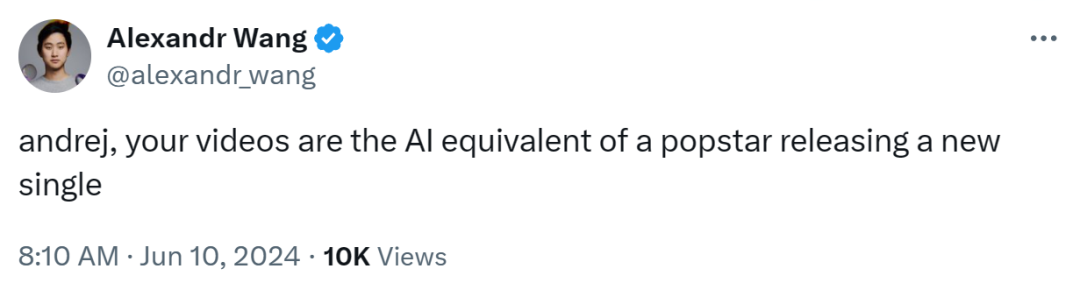
AI 独角兽 Scale AI CEO Alexandr Wang 表示,Karpathy 发布视频就像是流行歌手发布新单曲一样。
 甚至还有人将 Karpathy 的推特内容通过文生音乐模型 Suno 转换为了一首 Rap,简直了。
图源:https://x.com/peterxing/status/1799960277288677478
视频概览
该视频分为了四大部分: 建立网络(很多是以往教程回顾)、加快训练速度、设置运行和结果。 视频第一部分内容(带时间戳)具体如下:
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]
这是Karpathy「Neural Networks:zero to hero」系列视频的最新内容。AI 大牛 Andrej Karpathy 又「上新」了,这次一口气放出了长达四个小时的视频。 视频主题为「让我们来复现 GPT-2(1.24 亿参数)」。
- 首先构建 GPT-2 网络。
- 然后对其进行优化,以便快速训练。
- 然后通过参考 GPT-2 和 GPT-3 论文来设置训练运行优化和超参数。
- 然后进行模型评估。
- 然后祈祷好运,并去睡觉。
- 第二天早上,查看结果并享受有趣的模型生成。 通宵运行的结果甚至非常接近 GPT-3(124M)模 型。
该视频分为了四大部分: 建立网络(很多是以往教程回顾)、加快训练速度、设置运行和结果。 视频第一部分内容(带时间戳)具体如下:
- 00:13:47 第 1 部分: 实现 GPT-2 nn.Module
- 00:28:08 加载 huggingface/GPT-2 参数
- 00:31:00 实现前向传递以获取 logits
- 00:33:31 采样初始化、前缀 token、tokenization
- 00:37:02 采样循环
- 00:41:47 采样、自动检测设备
- 00:45:50 让我们训练:数据批次 (B,T) → logits (B,T,C)
- 00:52:53 交叉熵损失
- 00:56:42 优化循环: 过度拟合单个批次
- 01:22:18 第 2 部分: 让我们加快速度。 GPU、混合精度、1000 毫秒
- 01:28:14 Tensor Cores、代码计时、TF32 精度、333 毫秒
- 01:39:38 float16、梯度缩放器、bfloat16、300 毫秒
- 01:48:15 torch.compile、Python 开销、内核融合、130 毫秒
- 02:00:18 flash attention 技术、96 毫秒
- 02:06:54 nice/ugly 数。词汇量 50257 → 50304,93 毫秒
- 02:14:55 第 3 部分: 超参数、AdamW、梯度裁剪
- 02:21:06 学习率调度器:预热 + 余弦衰减
- 02:26:21 批大小调度、权重衰减、FusedAdamW、90 毫秒
- 02:34:09 梯度累积
- 02:46:52 分布式数据并行 (DDP)
- 03:10:21 GPT-2、GPT-3、FineWeb (EDU) 中使用的数据集
- 03:23:10 验证数据拆分、验证损失、采样恢复
- 03:28:23 评估:HellaSwag,开始运行
- 03:43:05 第 4 部分: 早上出结果! GPT-2、GPT-3 复现成功
- 0 3:56:21 向 llm.c 致敬,原始 C/CUDA 中等效但速度更快的代码
© THE END 转载请联系本公众号获得授权 投稿或寻求报道:[email protected]