微信输入法上线“问AI”AI问答功能
OpenAI 联合创始人 Ilya Sutskever 宣布成立新公司SSI
上海人工智能实验室发布首个AI高考全卷评测结果
阿里Qwen2-72B登顶HELM榜单:性能超越Llama3-70B
AI 搜索初创公司Genspark获6000万美元融资
月之暗面启动 Context Caching 内测
斯坦福大学发布机器人 HumanPlus,可模仿人类行为学习
百度文库新产品橙篇宣布支持10万字长文生成
AI生图可“量身定制”!华为清华联手推个性化生成技术PMG
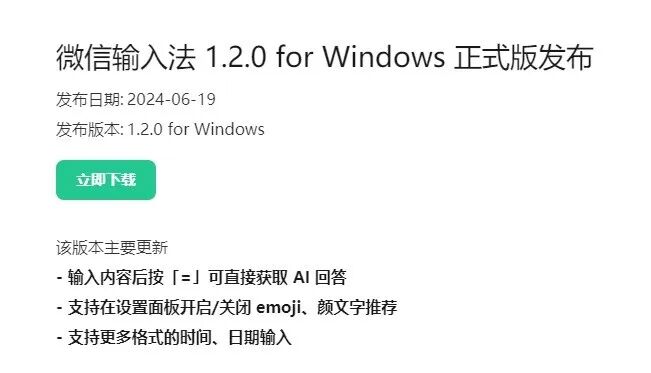
AI大模型工场 6月20日消息,近日,微信输入法发布了Windows和macOS双平台的1.2.0正式版更新,此次更新带来了全新的AI问答功能,为用户带来了更为智能和便捷的输入体验。
现在,用户只需在输入内容后轻按“-”键,即可直接获取AI的智能回答。
OpenAI 联合创始人 Ilya Sutskever 宣布成立新公司SSI据 TechCrunch 报道,前 OpenAI 首席科学家 Ilya Sutskever 今天宣布成立新公司Safe SuperIntelligence。Safe SuperIntelligence 简称SSI,由 Ilya Sutskever 与前 Y Combinator 合伙人 Daniel Gross 和前 OpenAI 工程师 Daniel Levy 共同创办。Ilya Sutskever 表示,新公司的团队、投资者和商业模式都是为了实现 SSI。他们将把安全和能力作为一个技术问题,通过革命性的工程和科学突破加以解决。SSI 在帕洛阿尔托和特拉维夫设有办事处,目前正在招聘技术人才。上海人工智能实验室近日宣布,收个 AI 高考全卷评测结果现已发布。据悉,高考刚结束,司南评测体系OpenCompass选取6个开源模型及GPT-4o进行高考“语数外”全卷能力测试。因无法确定闭源模型的更新时间,为公平起见,此次评测没有纳入商用闭源模型,仅引入GPT-4o作为评测参考。首个大模型高考全卷评测结果显示,Qwen2-72B、GPT-4o及书生·浦语2.0文曲星(InternLM2-20B-WQX)成为本次大模型高考的前三甲,得分率均超过70%。大部分模型“考生”语文、英语科目表现良好,但在数学方面还有很大的提升空间。其中,InternLM2-20B-WQX取得了数学单科的最高分,超越包括GPT-4o在内的所有模型。阿里Qwen2-72B登顶HELM榜单:性能超越Llama3-70B斯坦福大学的大模型测评榜单HELM MMLU近日发布了最新结果。阿里巴巴的通义千问Qwen2-72B模型在排名上超过了Llama3-70B,成为表现最优的开源大模型。斯坦福大学基础模型研究中心,致力于创建一种透明、可复现的评估方法。HELM框架对不同模型在MMLU上的评估结果进行标准化和透明化处理,解决了现有MMLU评估中存在的问题。例如,对所有参评模型使用相同的提示词,并在每项测试主题上为模型提供同样的5个示例进行情境学习。AI 搜索初创公司Genspark获6000万美元融资据 TechCrunch 报道,由前小度CEO景鲲和前小度CTO朱凯华联合创建的 AI 搜索初创公司Genspark近日宣布完成6000万美元的种子轮融资。此次融资由新加坡基金 Lanchi Ventures 领投,估值达2.6亿美元。Genspark公司表示,其搜索引擎拥有一种名为Sparkpage的功能,可以为用户提供综合、可信的信息。它的与众不同之处在于,每次查询都会使用多个专门的AI Agent生成新的、定制化的页面,目的是在一个页面上提供有用的结果。Genspark 专注于服务美国市场,免费使用,未来可能会探索付费订阅。它使用各种大型语言模型来处理任务,包括 Meta 的 Llama 等开源模型和 OpenAI 的 GPT 模型。月之暗面启动 Context Caching 内测据月之暗面官方消息,Kimi 开放平台 Context Caching 功能即将启动内测,届时将支持长文本大模型,可实现上下文缓存功能。Context Caching 是由 Kimi 开放平台提供的一项高级功能,可通过缓存重复的 Tokens 内容,降低用户在请求相同内容时的成本.官方表示,Context Caching可提升 API 的接口响应速度。在规模化、重复度高的 prompt 场景,Context Caching 功能带来的收益越大。斯坦福大学发布机器人 HumanPlus,可模仿人类行为学习据 interestingengineering 报道,斯坦福大学的研究人员制作了一个名为 "HumanPlus "的机器人。研究小组称,它可以通过模仿人类的动作来学习如何弹钢琴、回击乒乓球等。斯坦福大学研究团队的傅子鹏说,这个仿人机器人使用了单个 RGB 摄像头和全身策略来克隆人类动作。研究人员指出,HumanPlus 需要 40 个小时的人类运动数据来学习一项任务,然后一步一步地执行。此外,它还能利用摄像头跟踪人类,然后实时再现其动作。据36氪报道,百度文库宣布,全新产品橙篇首创10万字长文生成及多模态编辑能力。据介绍,在超长图文理解上,橙篇可实现超长文本无损理解,支持用户一次性上传100个多种格式、单个最大200MB的文件,并支持基于上传内容进行快速总结、问答和创作。橙篇在2024百度移动生态万象大会正式公布,百度表示,橙篇可利用AI技术,帮助用户对超大量、超多格式、超长内容的文件进行深入理解、精准总结与即时问答。AI生图可“量身定制”!华为清华联手推个性化生成技术PMG据 GitHub 页面显示,华为与清华大学合作推出了名为PMG的个性化生成技术,帮助生成不同的图片。该技术利用用户历史行为和偏好,生成符合用户需求的多模态内容,如表情包、T恤设计图、电影海报等。通过实验验证,PMG技术展现出巨大潜力和商业价值,为用户带来更加丰富、个性化的体验。《How Do Large Language Models Acquire Factual Knowledge During Pretraining?》本文试图研究大型语言模型(LLMs)在预训练过程中如何获取事实知识,并探讨知识获取的机制。通过研究LLMs在预训练过程中获取事实知识的动态过程,发现预训练数据量的增加并不能显著提高模型获取和保持事实知识的能力;训练步骤与事实知识的记忆和泛化之间存在幂律关系,重复训练数据会导致更快的遗忘;使用更大的批次大小可以增强模型对遗忘的鲁棒性。总体来说,LLMs在预训练过程中获取事实知识的概率会逐步增加,但随后会被遗忘所稀释。https://arxiv.org/abs/2406.11813v1《Transcendence: Generative Models Can Outperform The Experts That Train Them》论文探讨生成模型在特定条件下是否能够超越人类专家,通过使用低温采样训练自回归变换器来玩国际象棋,并证明低温采样是实现超越的关键。实验结果表明,训练出的模型有时能够超越数据集中的所有玩家;论文还讨论了其他可能导致超越的因素,为未来的研究奠定基础https://arxiv.org/abs/2406.11741v1《Be like a Goldfish, Don't Memorize! Mitigating Memorization in Generative LLMs》通过引入一种名为Goldfish Loss的微调方法,随机从损失计算中排除一部分标记,从而防止模型完全重复训练集中的标记序列,从而减少记忆化现象。论文在亿级别的Llama-2模型上进行了广泛实验,证明了Goldfish Loss方法可以显著降低可提取的记忆化现象,同时对下游基准测试几乎没有影响。论文还提供了数据集和代码。https://arxiv.org/abs/2406.10209v1《StreamSpeech: Simultaneous Speech-to-Speech Translation with Multi-task Learning论文试图解决实时语音翻译中的翻译和策略控制的双重挑战问题。论文提出了StreamSpeech模型,它采用多任务学习的方法,统一学习翻译和实时策略控制,实现了离线和实时语音识别、翻译和合成。StreamSpeech在CVSS基准测试中表现出色,同时提供高质量的中间结果,为实时通信提供更全面的体验。论文还提供了数据集和代码。https://arxiv.org/abs/2406.03049v1 大模型机动组约 6 分钟