划重点:
-
OpenAI 向部分付费用户开放 GPT-4o 高级语音模式
-
苹果客服回应国行 iPhone 暂无法使用 Apple 智能
-
Midjourney 发布6.1版本更新,图像质量大幅上升
-
Canva 收购人工智能生成公司 Leonardo.Ai
-
微软希望对 AI 深度伪造行为进行监管
-
周鸿祎宣布 360 安全大模型免费
-
国内首个亿级参数地震波大模型"谛听"在成都发布
-
PaddleMIX 2.0正式发布:图文音视频场景全覆盖
-
AI搜索公司Perplexity与多家媒体合作 推出广告收益分享计划
资讯详情:
OpenAI 向部分付费用户开放 GPT-4o 高级语音模式
据 The Verge 报道,OpenAI 为 ChatGPT 新推出的高级语音模式已开始向一小部分订阅 ChatGPT Plus 的用户推广。
OpenAI 在今年 5 月的 GPT-4o 发布会上展示了这一功能,但被批评听起来与斯嘉丽-约翰逊相似,后来出于安全原因被推迟。该模式原定于 6 月底发布阿尔法版,但 OpenAI 推迟了一个月推出,以保证其达到发布标准。据悉,该公司表示正在提高模型检测和拒绝某些内容的能力。
OpenAI 计划在秋季向所有 ChatGPT Plus 用户推出新语音模式。
 苹果客服回应国行 iPhone 暂无法使用 Apple 智能
苹果昨日凌晨向部分机型推送了 iOS 18.1、iPadOS 18.1、macOS 15.1 的开发者预览版,其中包含 Apple 智能的首个预览版本。
根据更新内容标注,国行设备无法使用 Apple 智能。经测试,更换 Apple 账户或者设备的地区和语言都无法开启相关功能。
对于国行 iPhone 无法使用 Apple 智能一事,苹果客服回应称,该系统版本还没有正式上线,具体以后面正式版上线为准。
Midjourney 发布6.1版本更新,图像质量大幅上升
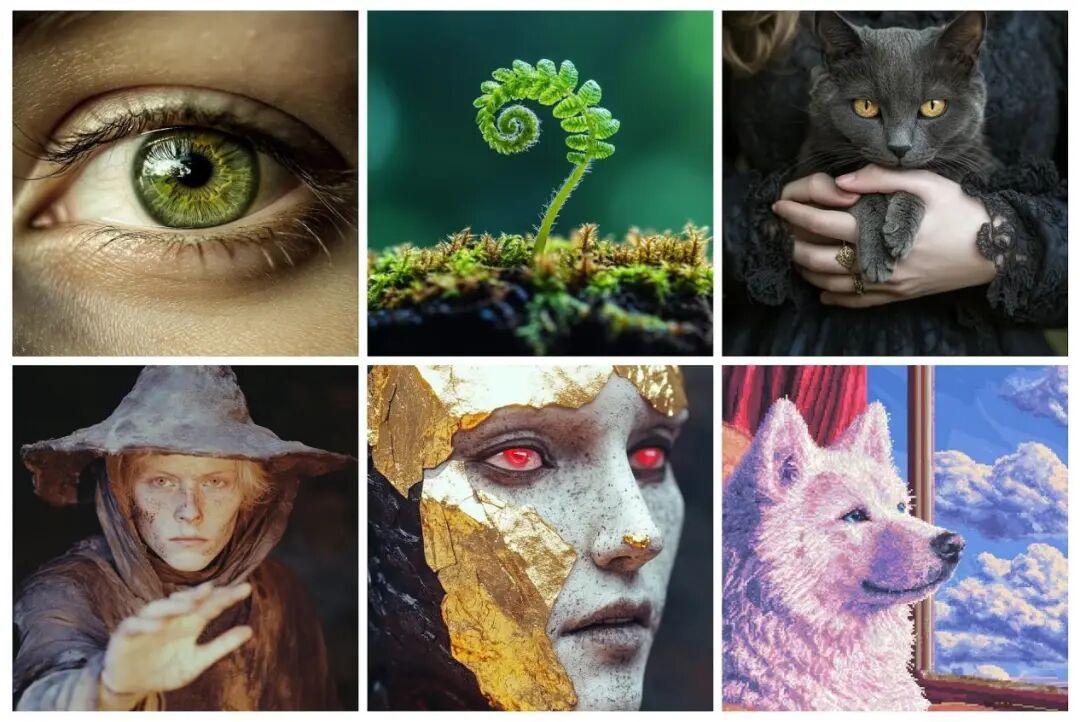
据 Midjourney 官方消息,Midjourney V6.1版本正式更新,该版本对于图像质量大幅提高。
据 Midjourney 官方表示,新版本可以生成质量更好的图像,不仅对皮肤、图片纹理进行增强,还减少了像素伪影。此外,图片生成的手臂、腿部、手掌等细节更加自然流畅,大大减少了之前版本中常见的畸形或不协调问题。另外,图片生成速度提高了约25%。
总体而言,新版本可以用更短的时间生成细节更加丰富的图片。
Canva 收购人工智能生成公司 Leonardo.Ai
据 Canva 官方消息,Canva 收购了生成式人工智能内容和研究初创公司 Leonardo.ai,以扩大其人工智能技术栈的范围。
这笔交易的具体金额并未透露,交易以现金和股票相结合的方式进行。Leonardo.ai的120名员工都将加入Canva,包括高管团队。
总部位于悉尼的Leonardo.ai公司成立于2022年,最初的目标是专注于视频游戏资产创建--这家初创公司的创始人是在一家视频游戏公司工作时相识的。但后来,Leonardo.ai 的团队决定建立平台,以满足更多的应用场景,比如为时尚、广告和建筑等行业的图像创作创建和训练人工智能模型。
微软希望对 AI 深度伪造行为进行监管
据 The Verge 报道,微软呼吁美国议员对使用人工智能生成
的深度伪造进行监管,以防止欺诈、滥用和操纵。
微软副董事长兼总裁Brad Smith呼吁政策制定者采取紧急行动,保护选举,保护老年人免受欺诈,保护儿童免受虐待。
微软希望通过一项 "深度伪造欺诈法规",为执法人员提供一个起诉人工智能生成的骗局和欺诈行为的法律框架。史密斯还呼吁立法者 "确保我们关于儿童性剥削和性虐待以及未经同意的亲密图像的联邦和州法律得到更新,以纳入人工智能生成的内容"。
周鸿祎宣布 360 安全大模型免费
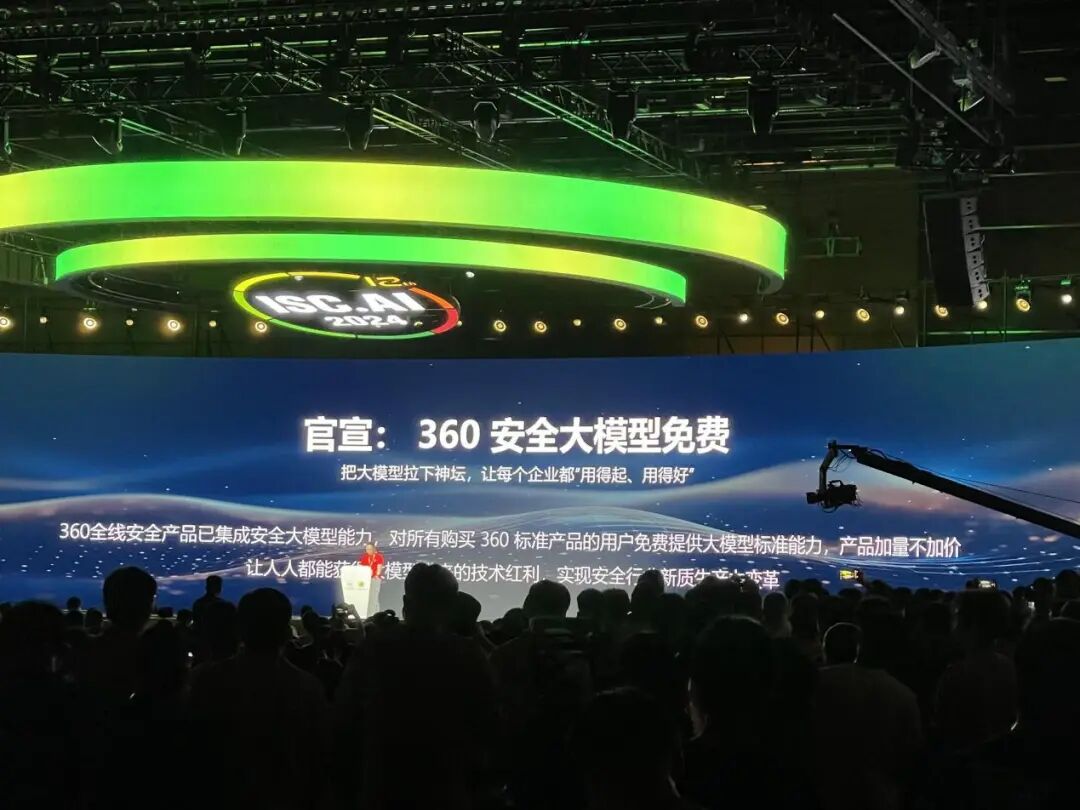
在今天举办的第 12 届互联网安全大会上,360 集团创始人、董事长兼 CEO 周鸿祎宣布 360 安全大模型免费。
周鸿祎在ISC大会上分享了360公司在安全大模型方面的思考和成果。他指出AI与安全行业紧密交织,AI技术能解决安全行业的痛点,但同时带来新挑战。360公司通过自研的AI技术,如360智脑等,实现了安全技术的突破,并在安全大模型方面取得了显著成果。
周鸿祎还强调了安全大模型的重要性,提出了AI应对AI升级的安全问题,以及大模型在安全领域的应用前景。
国内首个亿级参数地震波大模型"谛听"在成都发布
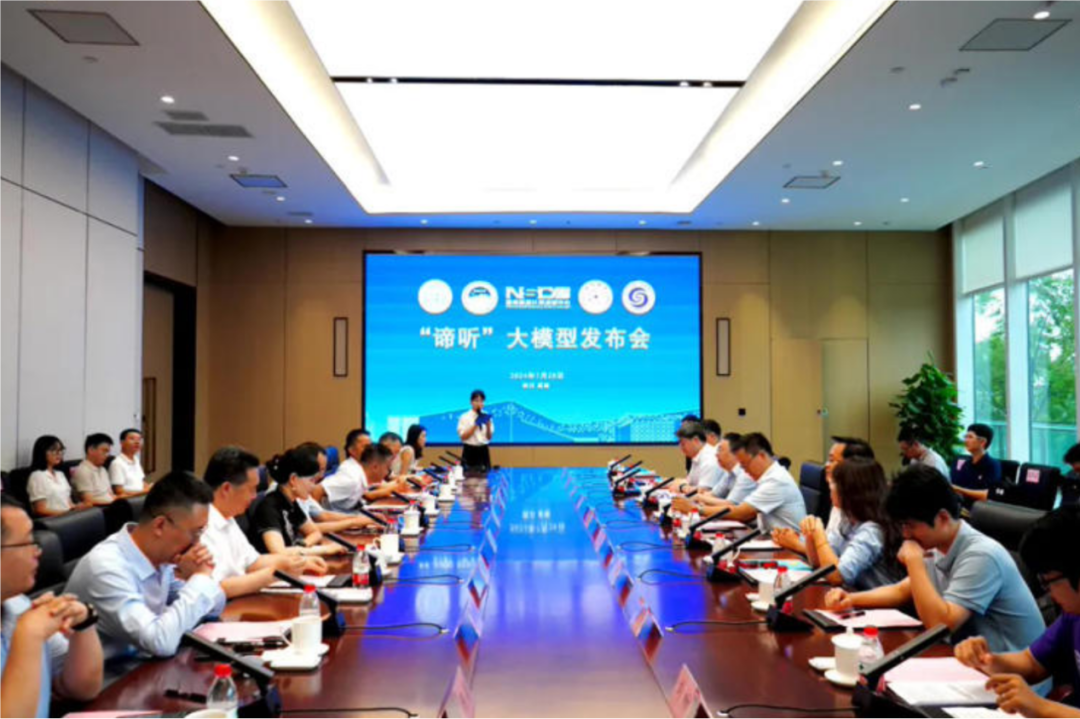
据新华网报道,近日,由国家超级计算成都中心、中国地震局地球物理研究所和清华大学联合开发的"谛听"地震波大模型在四川成都正式发布。
该模型是国内首个达到亿级参数量的地震波大模型,标志着我国地震学研究和人工智能技术融合的重要突破。成都超算中心运营管理有限公司董事长郭黎介绍,"谛听"项目始于2023年9月,经过半年多的努力,研究团队利用国内首个也是目前国内外最大规模的地震学专业AI训练数据集,成功训练出这一大模型。
据悉,"谛听"地震波大模型目前已可投入使用,十亿参数量级的版本预计将于2024年8月完成预训练。未来,该模型有望在矿震监测、城市地下空间结构探测和海底地震监测等多个领域发挥重要作用,为我国地震预警和防灾减灾工作提供有力支持。
 PaddleMIX 2.0正式发布:图文音视频场景全覆盖
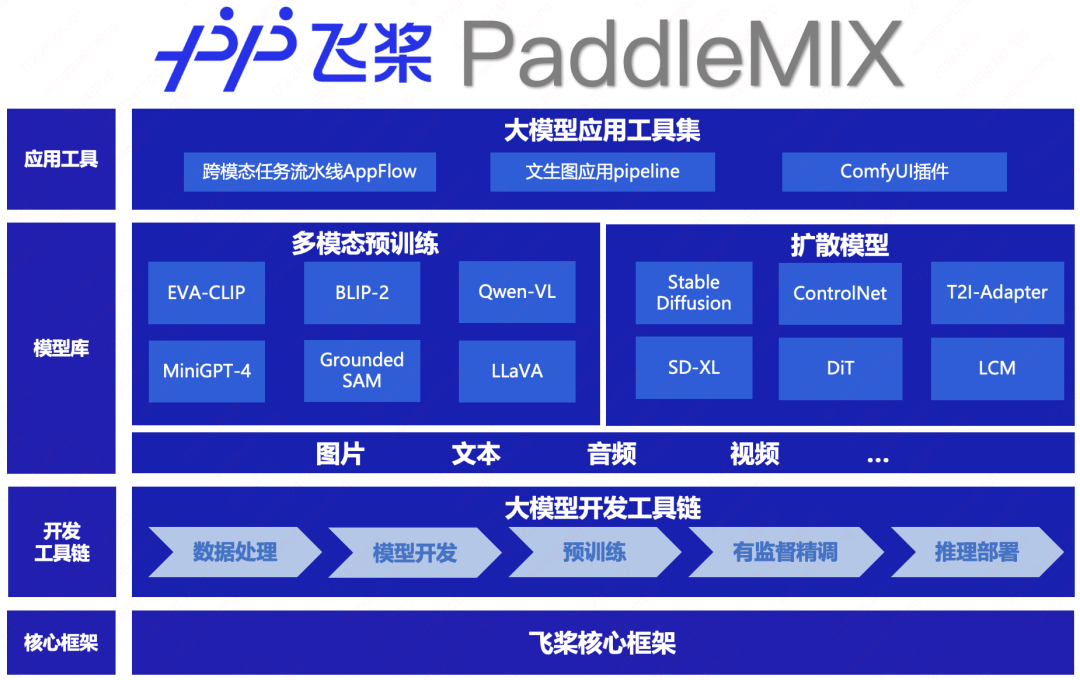
百度近日宣布,推出飞桨多模态大模型开发套件PaddleMIX 2.0版本。全面兼顾高性能算法、便捷开发、高效训练和完备部署,极大降低业界多模态领域开发者的开发门槛。
PaddleMIX 2.0覆盖图像、文本、视频、音频模态模型,多模态理解方向新增LLaVA系列等模型,多模态生成方向新增视频生成能力,支持SoRA相关技术,新增高速推理文图生成模型LCM。此外2.0新增多模态数据处理工具箱DataCopilot。新增Auto模块,统一多模态大模型SFT训练流程,兼容全参数、LoRA训练。发布PPDiffusers 0.24.1版本,新增Paddle版peft,accelerate后端;提供基于PPDiffusers开发的ComfyUI插件。
新版本DiT模型支持3B规模预训练,性能领先同类产品 8%。精调阶段新增MixToken训练策略,吞吐量提升68%。支持LLaVA等模型推理部署,推理性能优于同类技术34%。
AI搜索公司Perplexity与多家媒体合作 推出广告收益分享计划
据 TechCrunch 报道,搜索公司Perplexity 宣布,将与多家媒体合作,分享其广告收入,以平息评者对这家初创公司的指责。
Perplexity的首批出版合作伙伴包括Automattic等多家出版机构。作为多年协议的一部分,这些出版商将获得 Perplexity 的应用程序接口(API)和开发人员支持,这样他们就可以在自己的网站上创建自己的自定义答案引擎。他们的所有员工还将获得Perplexity的企业专业版服务,该服务具有更强的数据隐私和安全功能。
Perplexity 还没有开始在其平台上显示广告,这将在未来几个月内实现。
 今日重点论文:
Sony AI:
《Stretching Each Dollar: Diffusion Training from Scratch on a Micro-Budget》
本论文试图通过降低计算成本,解决大规模文本到图像生成模型的开发集中在具备大量计算资源的人群的问题。论文提出了一种低成本的大规模文本到图像扩散变换器模型训练方法,其中通过在训练期间随机屏蔽高达75%的图像块,来降低变换器的计算成本。论文使用预处理的图像块混合器和专家混合层来提高性能,同时证明了使用合成图像进行微预算训练的关键优势。
论文地址:
https://arxiv.org/abs/2407.15811v1
伊利诺伊大学厄巴纳-香槟分校:
《Knowledge Overshadowing Causes Amalgamated Hallucination in Large Language Models》
论文旨在解决语言模型中存在的知识遮蔽现象,即在查询多个条件的知识时,一些条件会被其他条件所掩盖,导致模型产生幻觉。这是否是一个新问题?论文提出了利用遮蔽条件作为信号来预测幻觉,并提出了一种无需训练的自对比解码方法来减轻幻觉。这种方法在多个模型和数据集上获得了显著的效果。
论文地址:
https://arxiv.org/abs/2407.08039v1
Meta:
《Scaling A Simple Approach to Zero-Shot Speech Recognition》
本文旨在通过使用罗马化和基于1,078种不同语言的数据进行训练的声学模型,解决语音识别中对未知语言的零样本问题,以及提高零样本语音识别的准确性。本文提出了一种基于罗马化和大规模多语言数据训练的声学模型的零样本语音识别方法(MMS Zero-shot),并将其与现有方法进行比较。结果表明,该方法相对于现有方法,可以将平均字符错误率降低46%,而且没有使用任何标注数据。
论文地址:
https://arxiv.org/abs/2407.17852v1
埃里温州立大学:
《Small Molecule Optimization with Large Language Models》
本篇论文旨在探讨利用大型语言模型进行分子药物设计的可能性,并提出了一种基于语言模型的优化算法。利用大型语言模型和基于遗传算法、拒绝抽样和提示优化的算法进行分子优化设计,取得了优秀的性能表现。
论文地址:
https://arxiv.org/abs/2407.18897v1
 大模型机动组约 7 分钟