最近真的被AI视频生成卷疲了,国内外的产品同质化严重。如果现在又出了一个新的AI生成视频的产品,估计大家放反应也都和我一样吧👉“哦,还不都差不多呗,不是文生视频,就是图生视频。”大家似乎也对AI视频渐渐的失去了兴趣,目前AI领域的各大研发团队也是挠破了脑袋想要搞些新突破。最近阿里、智谱和面壁一起发力:阿里推出轨迹可控的Tora,智谱连夜开源CogVideoX;面壁推出小钢炮2.6,直接对标GPT-4V。短短一周之内各家也是相继开启AI视内卷新方向!前几天阿里刚刚推出了可以精准控制视频内容的Tora,并且基于轨迹导向的扩散变换器(DiT)技术,Tora可以将文本、视觉和轨迹条件融合,且允许精确控制具有不同持续时间、宽高比和分辨率的视频内容,从而生成高质量且符合物理世界动态的视频内容。支持长达204帧、720p分辨率的视频制作,能够精确控制视频的动态表现。大量实验证明,Tora 在实现高运动保真度方面表现出色,同时还能细致模拟物理世界的运动。简单来说,就是Tora能够实现对视频内容的精确控制,从而生成高质量、高分辨率且符合物理世界动态的视频。GitHub:https://ali-videoai.github.io/tora_video/HuggingFace:https://arxiv.org/pdf/2407.21705Tora的实际效果如何?话不多说,直接给大家看一下官方实例👇。prompt:晴朗的天空下,两名男子沿着高速公路平稳骑行。视频捕捉了他们踏着有节奏的踏板,以及前方漫长而似乎无尽的高速公路。背景是广阔的农田,增强了运动感和自由感。
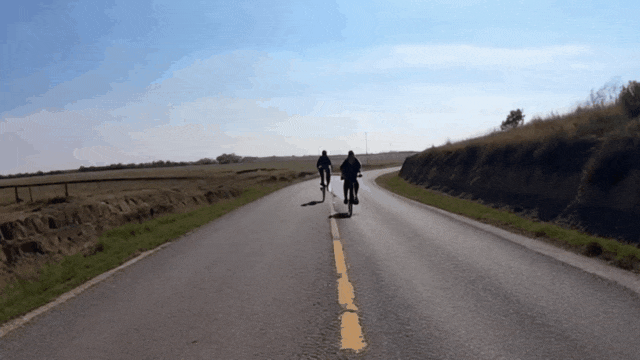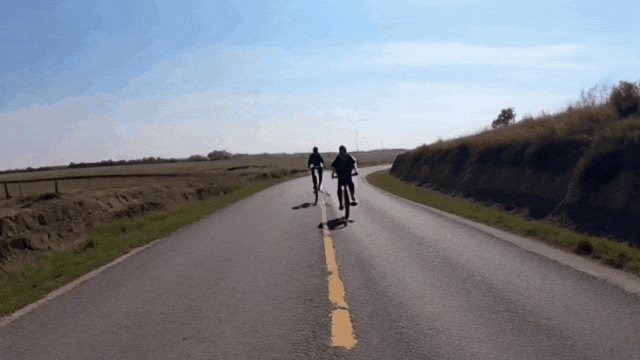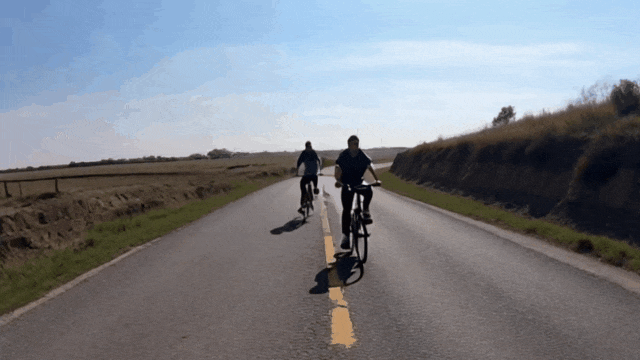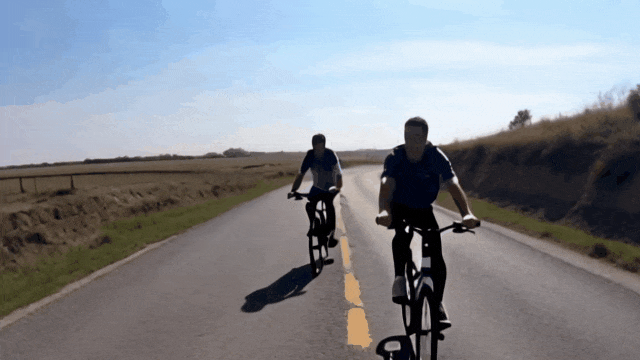
Tora可以通过描绘轨迹方向,精准的控制视频中两名骑车男子的骑行方向,并在骑行过程中人物基本保持一致,且无明显的变形,蹬自行车的动作也很自然且合理;另外视频中其他画面始终保持静态一致。prompt:特写镜头中,两朵玫瑰,一朵是鲜艳的紫色,另一朵是阳光明媚的黄色,在白雪皑皑的山脉背景下,一起轻轻摇曳。视频精心突出了玫瑰的鲜艳色彩与山脉的纯净白色之间的鲜明对比。
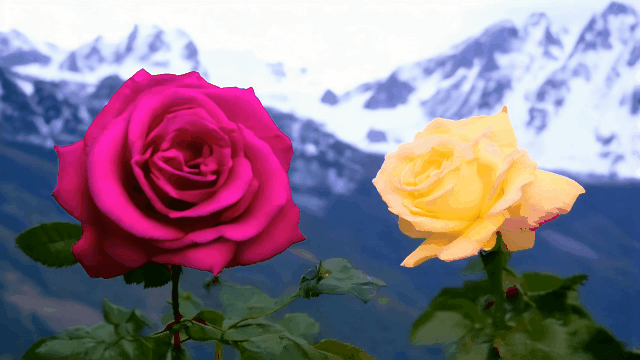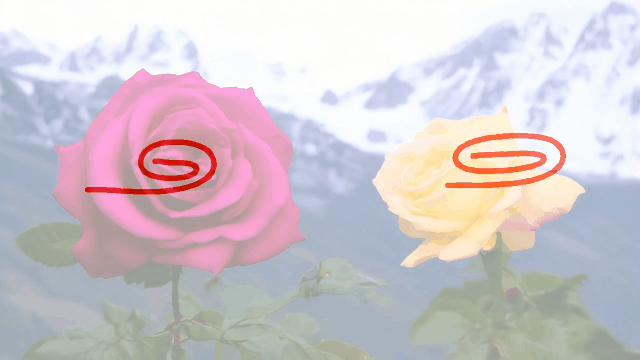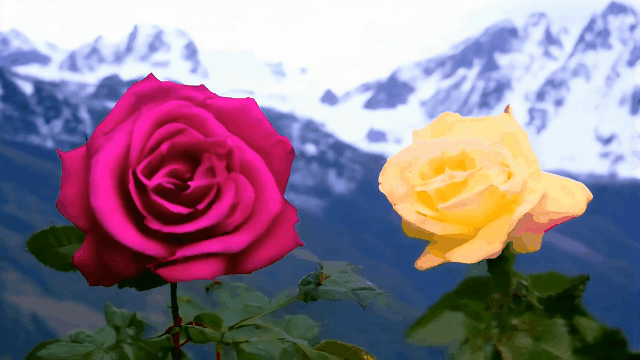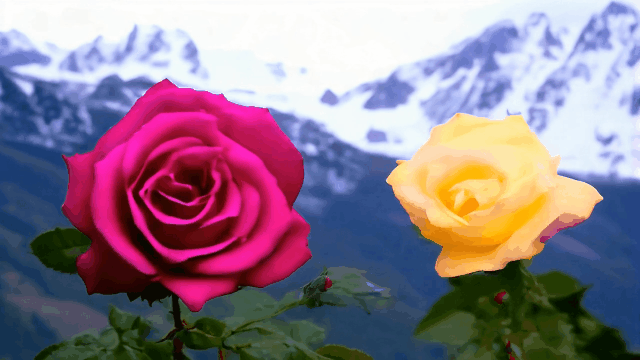
Tora可以支持多个方向、多种形式的轨迹运动,能够同时控制两朵玫瑰按照轨迹自然的摇摆,并且玫瑰整体的动态也均符合物理规律和运动轨迹。prompt:在宁静的黄昏中,一只泰迪熊开心地坐在滑板上,在星空的映衬下,滑板散发出柔和的光芒。泰迪熊轻轻地左右摇摆的可爱动作,背景中森林树木的黑色轮廓增添了古朴的魅力,唤起了一种宁静的孤独感。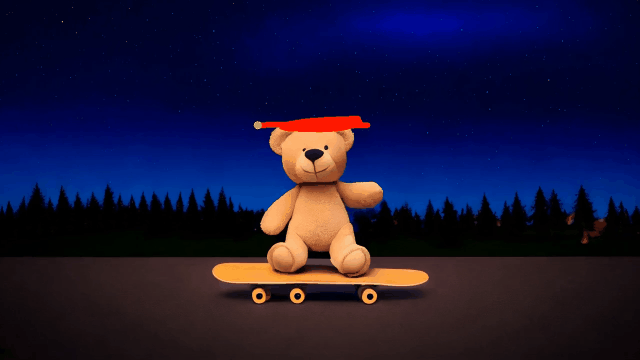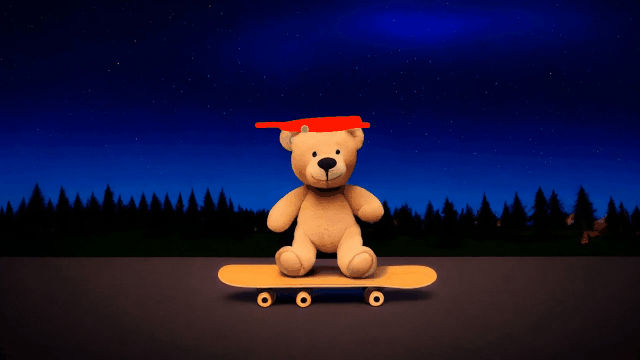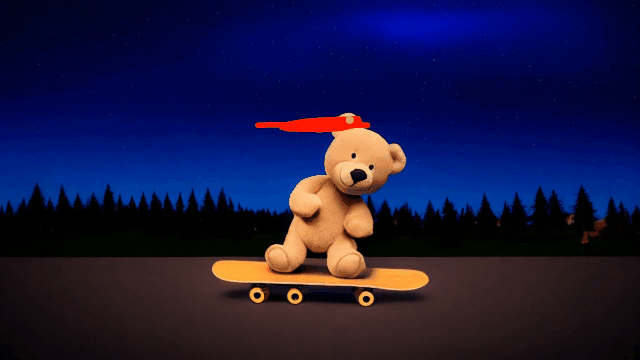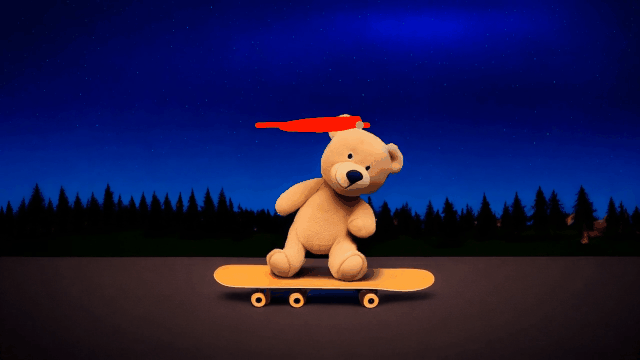
Tora对于重合轨迹也能精准识别。
prompt:动态的空中镜头展示了清晨阳光下倾泻而下的山间瀑布。视频捕捉到了瀑布的强大水流,周围的雾气和穿透的阳光营造出戏剧化而迷人的效果。山峦起伏的地貌,加上瀑布和飘渺的雾气,描绘出一幅自然之美和原始力量的画面。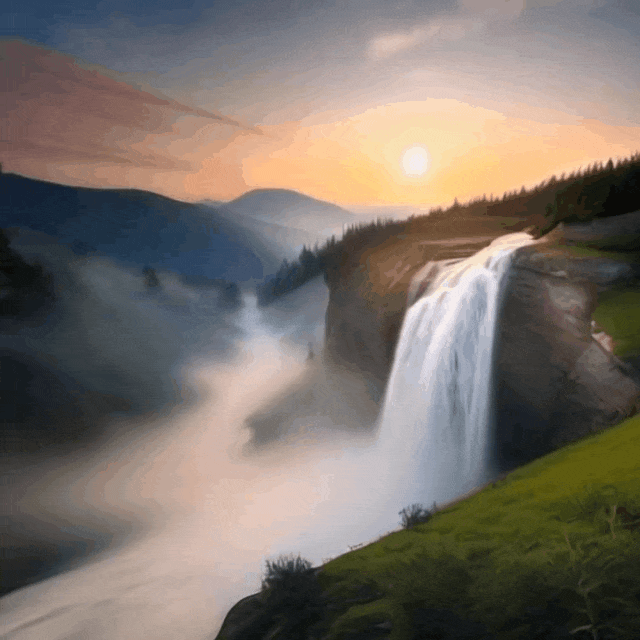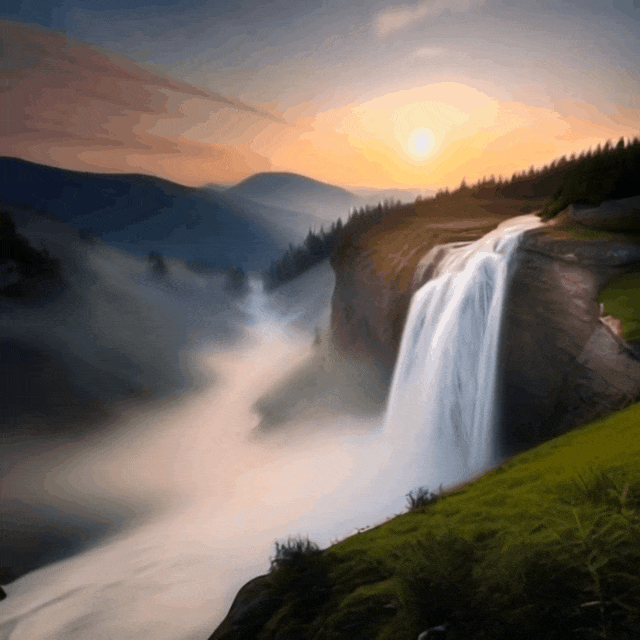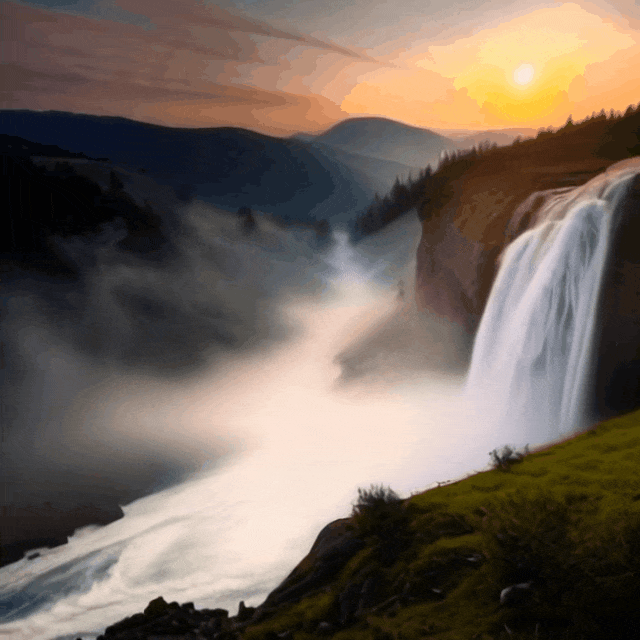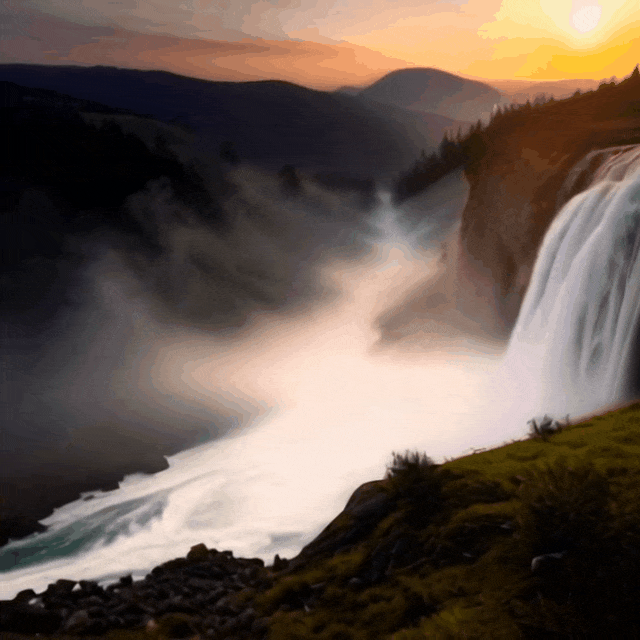
智谱的CogVideoX系列模型能够根据文本提示生成视频内容,同时也是“清影”的基模型,在今天半夜2点多突然开源了!开源行动:智谱AI的CogVideoX-2b模型已在GitHub和Hugging Face平台开源,为全球开发者和研究者提供了探索和创新的平台。
模型特点:支持英语提示,生成分辨率为720*480,视频长度6秒,帧率为8帧/秒。
资源需求:在FP-16精度下,推理需要18GB显存,微调稳定在46.2GB显存内。
CogVideoX模型开源地址:
- GitHub:https://github.com/THUDM/CogVideo
- HuggingFace:https://huggingface.co/THUDM/CogVideoX-2b
智谱同样也是放出了一些官方案例👇,效果其实和“清影”基本没多大差别。prompt:镜头跟拍一辆白色复古 SUV,车顶架上装着黑色的行李架,它沿着陡峭的山坡,行驶在满是松树的土路上,扬起阵阵尘土,阳光洒在行驶的 SUV 上,为眼前的景象披上了一层温暖的光晕。土路在远处缓缓转弯,视野中没有其他车辆。路两旁都是红杉树,零星散落着几片绿地。从后方可以看到汽车轻松地跟随着弯道,行驶在崎岖的道路上。土路四周都是陡峭的山丘和山脉,天空中飘着几朵白云,一片湛蓝。prompt:在一个饱受战争蹂躏的城市,废墟和残垣断壁诉说着满目疮痍,在这个令人心碎的背景下,一个凄美的特写镜头定格了一个年轻的女孩。她的脸上沾满了灰烬,无声地证明着周围的混乱。她的眼睛里闪烁着悲伤和坚韧,捕捉到了这个因冲突而失去天真世界的原始情感。prompt:极端的特写镜头,鸡肉和青椒烤串在火焰烤架上烤制。焦距较浅,烟雾较轻。色彩鲜艳。prompt:一艘精致的木制玩具船,桅杆和船帆都经过精心雕刻,它正平稳地滑过一块仿海浪的蓝色豪华地毯。船身被涂成浓郁的棕色,并带有小窗户。这块柔软而有质感的地毯提供了一个完美的背景,就像一片广阔的海洋。船的周围是各种各样的其他玩具和儿童用品,暗示着一个充满乐趣的环境。这个场景捕捉到了童年的纯真和想象力,玩具船的旅程象征着在一个异想天开的室内环境中无休止的冒险。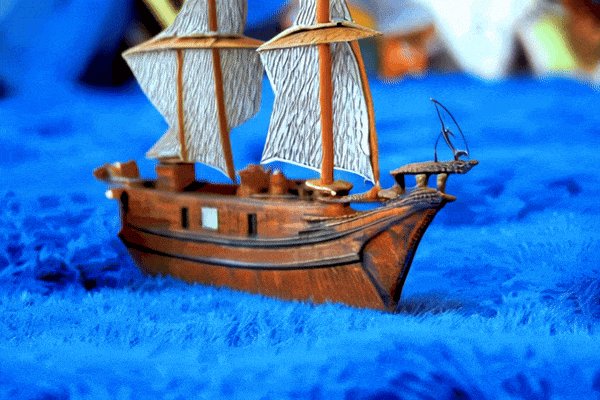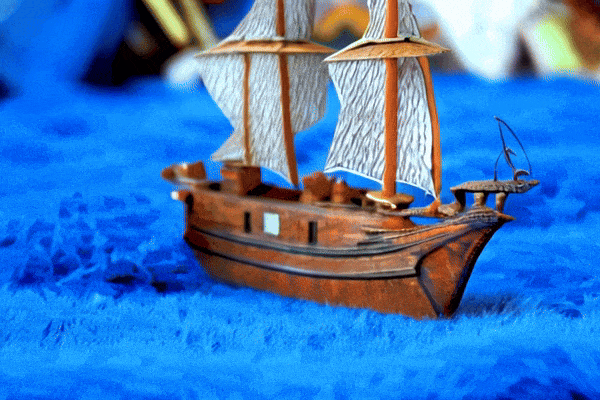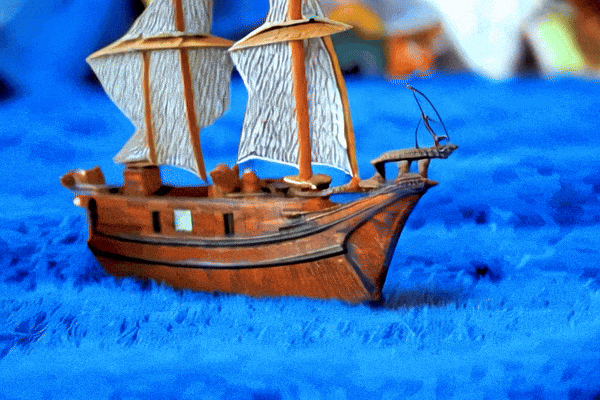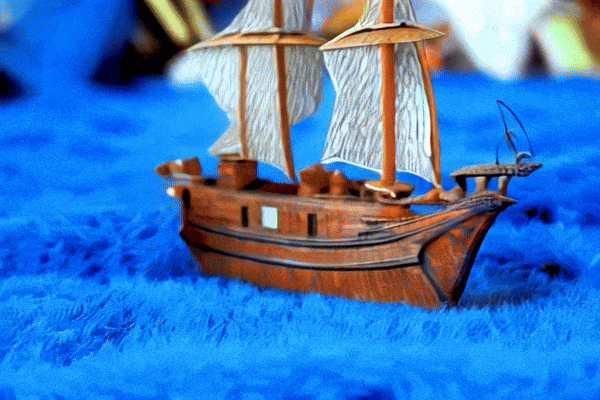
prompt:一片白雪皑皑的森林景观,一条土路穿过其中。路两旁的树木覆盖着白雪,地面也覆盖着白雪。阳光明媚,营造出明亮而宁静的氛围。这条路似乎空无一人,视频中看不到任何人和动物。这段视频的风格是拍摄自然景观,重点是白雪覆盖的森林的美丽和道路的宁静。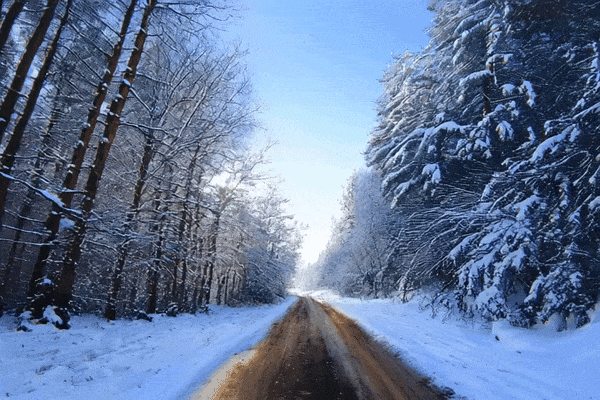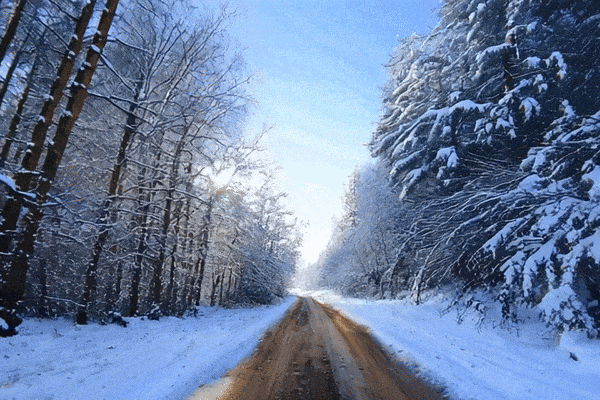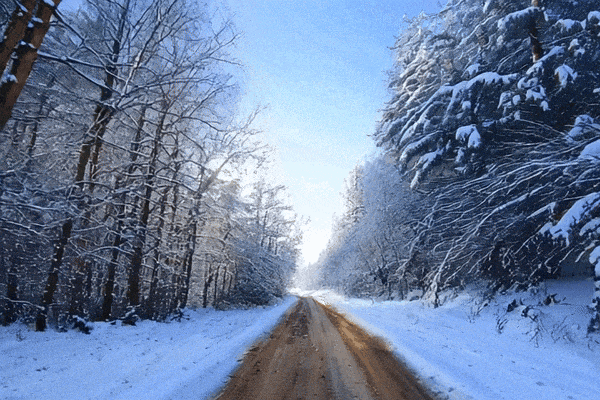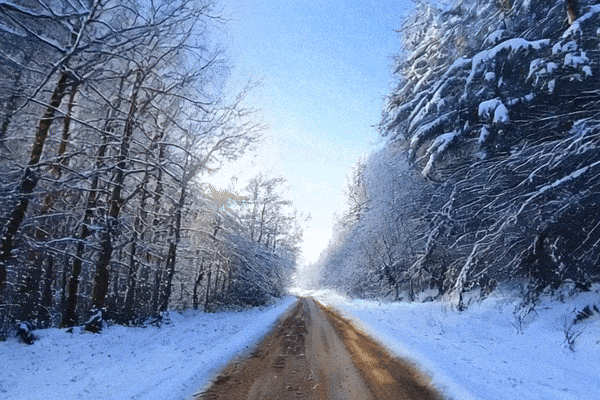
面壁上线“小钢炮” MiniCPM-V 2.6新版本!仅8B参数,取得 20B 以下单图、多图、视频理解 3 SOTA 成绩,一举将端侧AI多模态能力拉升至全面对标超越 GPT-4V 水平。小钢炮首次上「端」多项功能:将实时视频理解、多图联合理解能力首次搬上端侧多模态模型,更接近充斥着复杂、模糊、连续实时视觉信息的多模态真实世界,更能充分发挥端侧 AI 传感器富集、贴近用户的优势。MiniCPM-V 2.6开源地址:
- GitHub:https://github.com/OpenBMB/MiniCPM-V
- HuggingFace:https://huggingface.co/openbmb/MiniCPM-V-2_6
在下面对面壁智能公司实时拍摄中,室内场景的各种办公设备、墙上、会议室上的文字都能轻松被模型精准识别。下面这段 1 分钟左右的天气预报视频,MiniCPM-V 2.6 可以在完全无音频的情况下,发挥强大的视频OCR功能,识别出视频画面里密集的文字,给出不同视频段落中不同城市的详细天气描述。阿里、智谱和面壁在别人还在研究文本图像生成视频时,结果这三家直接next level了。而且阿里、智谱还是面壁,他们始终保持开源的态度,不仅仅是为了加速AI技术的创新和发展,更是为了AI技术能够更加均衡、安全地在全社会推广。我们也期待越来越多的公司、机构能够走进开源,拥抱开源。因为我们更加期待AI鼎盛且安全的时代到来。
 丸丸柚贝约 6 分钟