神经网络在当今人工智能研究和应用中发挥着不可替代的作用。它是人类在理解自我(大脑) 的过程中产生的副产品,以此副产品,人类希望建造一个机器智能来实现机器文明。这个目标在当下如火如荼的人工智能研究中被无限倍凸显,甚至被认为是一场新的工业革命到来的标志。
在人类社会前几次工业革命浪潮中,物理学扮演了十分重要的角色,或者说,这些革命的理论基石在于物理学原理的突破,如热学、量子力学和相对论。但当今的人工智能革命似乎是经验科学(启发式的诀窍,如Transformer)所驱动的,在过去20 年间,尤其是谷歌等互联网巨头加入这场浪潮之后,人工神经网络的架构出现了快速迭代。物理学对神经网络的研究历史悠久,最早①可追溯到20 世纪80 年代初霍菲尔德(与辛顿一起获得2024 年诺贝尔物理学奖) 联想记忆网络的提出;物理学思想在这之后对人工神经网络和神经动力学的研究都产生了深远的影响。著名物理学家戴森有一个说法:“严谨理论赋予一个课题以智力的深度和精确。在你能证明一个严格理论之前,你不可能全面了解你所关注的概念的意义。”②获得玻尔兹曼奖的物理学家霍菲尔德也曾在一次访谈中提到,“如果你不能用数学的语言去描述大脑,那你将永远不知道大脑是怎么工作的。”而鉴于他自身的习惯,“如果一个问题和我熟知的物理毫无联系,那我将无法取得任何的进展”。所以,在人工智能正在重塑人类社会方方面面的同时,我们有必要去了解物理学的思想如何影响人们对神经网络乃至自我的认知。
伊辛模型是统计物理的标准模型[1]。它虽然被用来描述格点上(比如二维表面) 磁矩的集体行为,但是却包含了非常丰富的物理图像(比如相变、自发对称性破缺、普适性等),更让人震惊的是,这个模型的物理图像可以向外扩展到多个似乎毫不相关的学科,如经济学、神经科学、机器学习等。我们先从物理学专业本科生所熟知的态方程讲起:这显然是个迭代方程,因为变量m出现在方程式等号的两边,其中J 描述了自旋之间的相互作用,m表示磁化强度矢量,h则表示外加磁场。注意到,该态方程在没有外加磁场并且相互作用较弱情况下,有且只有一个平庸解,即所有磁化为零,用物理学语言讲叫顺磁态。然而,当增大相互作用到一定程度时,顺磁态将失去稳定,该方程出现两个非平庸解(物理上叫铁磁解,即m=±M)。这个过程叫自发对称性破缺或连续相变。这个迭代蕴含了神经网络的形式。神经网络的基本属性可以总结为DNA,即数据(data)、网络 (network) 和算法 (algorithm),如图1 所示。你把初始化m0看成输入数据,每迭代一次将生成一个新的m,这个就是神经网络的中间隐层表示。然而,奇妙的是,神经网络把J 也变成可以变化的量,这就意味着这个模型是可以变聪明的 (即能处理每一个输入)。这在传统物理学里很不可思议,因为模型通常需要大物理学家猜出来。而外场可以等价于神经网络的偏置(见图1)。那么如何更新J 呢?你只需要写下一个目标函数,即这个神经网络,或者学习中的模型要达到什么样的目标。比如,实现数据的二分类,你可以轻松地写下这里的a 表示数据输入-输出对(x, y)(y 在机器学习叫标签),而fJ 就是这个被J 参数化的神经网络(其本质显然是一个非常复杂的嵌套函数,类似于上面态方程的多次迭代,只不过每次迭代的J都不一样)。接下来你需要一个算法来驱动这个网络自我更新。这个算法其实就是梯度下降:dJ/dt= -∇JE 。聪明的读者一眼就认出这是个过阻尼的朗之万动力学,因为人们在训练神经网络时通常在上面的方程右边加入微弱的白噪声。所以,神经网络的学习过程是在你为它定义的势能函数下的随机游走 (或者布朗运动,见图2),如果你稍微学过一点随机动力学的话,你立马知道这个神经网络的学习过程存在平衡态,其分布正好是玻尔兹曼分布P(J) = (1/Z))e-E/T,其中Z 就是统计物理的地标——配分函数,而温度T 则控制学习过程随机涨落的程度,类似一个粒子在相同温度的溶液里运动。此刻,相信你已经获得足够深刻的理解:神经网络的本质是一个从简单函数(如上述的tanh(),这个函数的形式源自物理上经典自旋有两个取值并且服从玻尔兹曼正则分布) 反复迭代出来的超级复杂并且表达能力超强的函数。这个函数需要不断更新它的参数,即J 和h,这些参数则构成一个聪明的物理学模型(能自我更新,无需靠大物理学家来定义);而这个模型的更新又是一个布朗运动的过程,服从朗之万动力学。所以神经网络的DNA本质在于物理学。接下来首先介绍感知机模型。这个模型当之无愧可称为人工智能的伊辛模型。它研究的是一群神经元如何实现对输入数据的分类,这从数学上可以表达为一个不等式 wTx ≥κ ,这里向量w 是神经连接,x 为神经输入(例如,机器学习常用的MNIST 数据集中每张手写体数字为784 维实向量),而κ通常称为学习的稳定性指标(越大越稳定)。当κ=0,wi=±1 时,我们可以定义这样的玻尔兹曼统计系综:其中,P代表分类图片总数,N代表神经连接数目,而Z 则为统计物理学中的配分函数。如果上面的不等式针对每个输入模式都能满足的话,则该Z显然具有构型数(解的数目) 的特征,从而可定义自由熵:S=lnZ。这个统计系综的设计归功于20 世纪80年代一位杰出的年轻物理学家伊丽莎白·加德纳[2],她考虑权重的分布而不是构型从而超越了霍费尔德模型的框架。因为数据的随机性,求解该熵并非易事,我们这里省去细节(感兴趣者可参阅教科书[3])。1989 年,法国物理学家马克·梅扎尔和他的博士生沃纳·克劳斯利用复本方法进行了计算,得出当α = P/N~0.833 时,自由熵消失 (意味着该学习问题无解)。这是凝聚态物理理论(自旋玻璃)在计算机和统计学交叉学科的早期典型应用。非常奇妙的是,该结果于今年初被数学家完全严格证明[4],而当今高维随机统计预测在数学里是相当有生命力的一个分支。该模型自从被提出以来伴随着不可协调的矛盾,因为长期以来在α<0.833区间,解是存在的,但很多算法找不到它们,或者随维度升高,算法所能求解的最大α变小。这显示这个统计推断问题虽然定义上简单但从算法复杂度看高度非平庸!这个问题的解释要等到2013~2014 年间两篇论文的问世[5]。论文作者的出发点是解空间的几何结构,类似物理上构型空间的形态或者熵景观。解决一个难问题通常需要新思路!为了描绘熵景观,论文作者先从构型空间选取一个典型构型(物理上服从上述玻尔兹曼分布),然后在该构型周围计数与选定参考构型存在一定汉明距离的构型(或者学习问题的解)。这在物理上等价于自旋玻璃理论的弗兰之-帕里西势能。通过复杂推导,作者惊奇地发现,在汉明距离很小的区间,自由熵为负数,哪怕是α非常靠近零。这从物理上意味着,该熵景观存在大量孤岛形态(犹如高尔夫球洞),这也解释了以往局域算法(如蒙特卡洛) 求解的困难性。在松弛不等式的单向性的情况下,数学家近期已经给出了严格证明[6,7]。他们在摘要中把这个物理结论称为Huang-Wong-Kabashima猜想。一个重要问题的解决通常伴随新的重要问题的出现,这是科学研究最为迷人的地方。论文[5]在展望中指出了有些特别设计的算法依然可在孤岛间找到解,这是跟孤岛熵景观格格不入的。这个新的重要问题看似非常难,但很快就被意大利物理学家理查德·泽奇纳及其合作者解决了[8]。这个解决思路也十分巧妙,当然需要很深厚的数学和物理功力。既然自由熵为负,那么可以认为这可能是传统玻尔兹曼测度的结果,因此把自由熵当成随机变量,考虑其统计分布并且服从大偏差原理(即P(S)~e-Nr(S) ,其中r(S)称为率函数)。这么定义之后,理查德·泽奇纳等人发现,这个感知器的学习空间居然存在稀有的稠密解团簇!而且,那些高效的经验算法就是被这些解所吸引的,而完全避开了高尔夫球洞(实际上它们是无法被找到的,掩藏于自由能深谷中)。而这一绝美的物理图像,同样于近期被数学家严格证明[9]。至此,我们可以总结,虽然感知学习从数学形式上看非常简洁,但是从物理上可以获得直观且非常深刻的见解,并大部分结论能从数学上严格证明。从科学上去完全理解一个非平庸的命题应该也必须成为科学文化的一部分,而非一味盲从避开了模型只依赖于数据的现代机器学习方法。这些研究始于一群喜欢跨学科的物理学家的好奇心,最后却激起数学家严格证明的欲望,让人们看到高维空间统计推断的优美。虽然大多物理学家考虑的问题带有随机性的成分(比如上述高斯随机输入数据),但是,在统计物理学的世界里,存在普适性这个重要的概念,或者说,在某些情况下可以被放心舍弃的细节依然不影响事物的本质。这或许是物理学思想的魅力,也是其他学科的科学家或多或少难以理解之处。这些研究目前已经发展成一个更大的猜想,是否在深度学习乃至大语言模型的解空间里存在大偏差的稀有团簇?这些团簇或许能够实现举一反三的逻辑推理能力。上一个例子讲述的是统计物理在理解监督学习的重要作用。接下来我们研究一下无监督学习,即无师自通。无监督学习是让机器从原始数据中自发地发现隐藏规律,类似人类在婴儿时期的观察和学习过程,所以是一种更为重要的认知方式。这个自然界最不可思议的是它的可理解性(爱因斯坦语录),所以人类可通过模型(几条合理性的假设) 依靠逻辑演绎导出简洁的物理方程(如牛顿力学、广义相对论等),从而达到对成千上万种经验观察的高度压缩。这个与当前大语言模型所做的压缩即智能有很大的不同③。那么,对于无监督学习,我们如何建模以直击其本质?如图3所示,σ代表输入原始数据(没有标签),ξ1,2代表两层神经网络对数据规律的表示,x,y 分别为输出神经元。无监督学习从数学上可以表达为已知数据推断连接ξ1,2的过程。为了建立理论模型,我们首先假定存在一个老师网络,它的连接是完全可知的,因此我们可以通过该老师网络来生成训练数据,这个规则叫受限玻尔兹曼机④,图3 中的i,j,k,l 标示显层神经元,x, y 是隐层神经元,因此如图的连接是个伊辛模型,显层与隐层神经元互为条件独立,因此便于蒙特卡洛模拟来生成数据。这样一来,那么具有相同结构的学生网络能否单从数据悟得老师的连接矩阵呢?这就是一个统计物理可研究的课题。接下来,我们容易通过贝叶斯定理写出如下的学生网络的概率分布:其中,Z 为网络结构的配合函数,N为每个隐层神经元的神经连接数,β为温度倒数,P0 为先验分布,Ω则为无监督学习的配分函数。在这里,我们做了两个重要假设:每个数据是独立生成的,并且先验分布对神经元标号是独立的。我们稍微观察以上的系综分布就可以发现,ξ1,2 → -ξ1,2 和1↔2,该分布是不变的,显示了 和
 对称性,因为我们的连接权重取为Ising 自旋值。那么,一个有趣的物理问题就产生了:学习的过程是对称性破缺的过程吗?经过复杂的计算(细节参看文献[3]),我们发现:随着数据量的增长达到第一个阈值,与对称性相关的第一个连续性相变发生,学生开始推断老师连接权重相同的那部分 (即ξ 1i = ξ 2i),这种类型的转变被称为自发对称破缺,就像在标准伊辛模型中遇到的铁磁相变那样。随着数据量进一步增加,学生开始推断老师连接权重不同的那部分 (即ξ1i= -ξ 2i),这被称为第一种置换()对称破缺,即学生开始意识到它的两个感受野( ξ1,ξ 2 )也是不同的。不妨总结为“先求同,后存异”。随着数据量进一步增加,学生开始能够区分老师 (或基本规律) 体系结构中两个隐藏节点的内在顺序。我们将这个转变称为对称性破缺的第二个亚型。仅在此转变之后,自由能才有两个同等重要的谷底。但学生只推断其中一种可能性,并取决于初始条件。这两个谷底对应于基本规律的两种可能顺序(x, y)或(y,x),这也是原始无监督学习概率分布的内在置换对称性。因此,通过统计物理分析,我们得出:数据可以自发驱动层级式的连续相变直至数据中的客观规律被机器所捕获,并且也揭示了先验的作用:极大减少自发对称破缺的最小数据量,并且融合了两个亚型,即在先验的帮助下,学生认识自我和客观是同时发生的;然而在没有先验情况下,认识自我则先于客观。从一个简单模型出发,我们可以揭示无监督学习丰富的物理图像,即对称性破缺是支配学习过程的重要力量。这种概念在今年又在非平衡的生成扩散过程中被完整诠释[11],让人不得不感叹物理思维的巧妙与精确,再次印证了著名物理学家戴森那句名言。前面两个例子并未涉及动力学,然而动力学是理解大脑认知的关键过程。我们注意到,在神经网络训练过程中,前面提到其本质为梯度力作用下的朗之万方程。事实上,在认知动力学层面上,几乎所有的动力学并不存在梯度力,即下面方程其中f 为不显含时间,但并不能写为某个标量势的梯度,即不存在李雅普诺夫函数。ζ表示神经回路的背景噪声 (在这里暂且将其忽略)。在高维空间里,如上的动力学方程可以涌现出混沌行为,成为众多理论神经科学家(实际上多数为理论物理出身) 展示数学物理功力的首选研究对象。在过去三十多年来,经典工作不断涌现,每次都加深了人们对于高维混沌动力学的理解。图4 给出了一个3 维的例子:只有三个神经元的系统,在它们连接矩阵属性改变时,系统的相空间由一个全局稳定点破缺为对称的两个焦点。虽然原系统无法通过梯度力来研究(不存在李雅普诺夫函数),但是如果变换研究的兴趣为非平衡稳态(即零速率极限,即f=0),那么我们就可以非常直观地写下一个动能函数E(x) = (1/2)f 2 (单位质量) 来作为非平衡稳态的伪势[12],这个伪势将让我们能够定义正则系综来研究非平衡神经动力学稳态问题;这在此前的所有研究中是无法想象的。原则上,人们应该通过复杂的动力学平均场或路径积分来推导稳态方程,这对于更复杂的神经动力学(比如f 的形式较复杂)来说甚至是十分艰巨的一个计算任务。
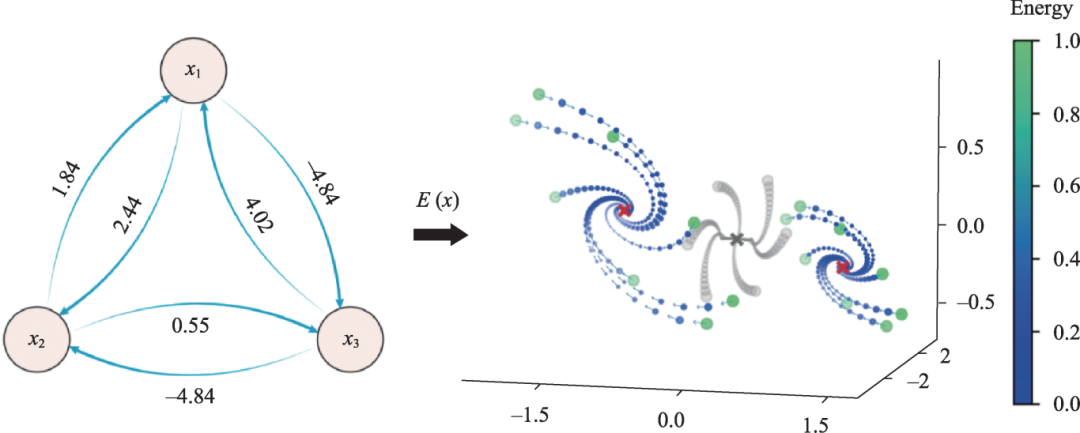 图4 非线性动力学的伪势法有了这个新思路,当三个神经元系统被推广至无穷(N→∞)神经元系统 (比如大脑具有大概860 亿级的神经细胞),并且假设相互作用矩阵是非厄米的随机矩阵[矩阵元Jij ~N(0,g2 /N) ],我们可以发现当g 增加到1 时将触发一个连续的动力学相变(从有序走向混沌),其序参量为网络神经活动水平的涨落。注意这些序参量并不是人为设定的,而是来源于上面正则系综计算的逻辑演绎。让人惊讶的是,该计算还会导出另一个序参量,恰是统计力学中的响应函数,它刻画了动力系统在面对微弱扰动时的响应能力。我们发现在相变点附近,该响应函数出现峰值,从物理上证实了混沌边缘的优越性。无独有偶,2022 年的一项实验研究表明人类大脑的脑电动力学在清醒时在混沌边缘具有最大的信息丰度[13],从而暗示了统计力学推导的响应函数峰值可能从数学上讲是意识的必要条件。这个例子告诉我们,即便是十分复杂的非梯度动力学,我们依然可以另辟蹊径从统计力学角度提出模型,并且通过严谨计算获得深刻认识。因此,年轻学生应该掌握必要的数学工具,并且勇于挑战既有思想框架,通过提供新的见解来发展古老的学科。大语言模型是2023 年初火遍全球的Chat GPT的原动力,它凭借海量数据文本和计算力通过预测下一个单词赢得了世人的赞叹和兴趣[14]。经过预训练的聊天工具尤其展示了一种示例泛化的能力,这在以往所有机器模型中均未出现过。简单来说,就是给少数几个例子(不管是数学的,还是语言的),然后基础模型也不用再训练,它就能够对新问题给出准确答案了。这困惑了大家好一阵子,直到下面的事情发生。我们说过,任何一种复杂现象都需要模型驱动的研究,才能找到潜藏的简单规律(如果存在)。为了找到答案,我们先考虑一个线性回归函数类,如 y = wTx 。我们首先固定一个随机的任务向量w,然后生成多个随机的x 计算其标签y,就有了针对示例泛化的预训练数据:注意最后一列为让基础模型推断的数据,故遮掉了真实的标签。这个矩阵相当于给了有答案的n道数学题,然后问一道(最后一列),看机器能否准确推断。这显然是一个难的问题!但是,神奇的是,聪明的机器做到了,不禁让人看到通用人工智能微弱的曙光。其实通过简单变换,比如假设单层线性自注意力机制(细节见文献[15]),我们喜出望外地发现预训练的机器参数服从如下的哈密顿量:最后一项为机器参数的高斯先验。这显然是一个两体相互作用的实自旋模型,它的基态就是基础模型示例泛化能力的根源。我们可以通过高斯分布假设来求解这个模型的基态,最后发现哪怕在有限尺寸的网络,依然可以得到如下最优解:其中
 为神经网络给出的答案,上述物理模型的基态意味着
 和W21=0,D 是数据的维度。分块矩阵W与自旋耦合J 一一对应。因此我们就明白了,只要找到该基态,示例泛化即可达成,并无需再微调参数!这个模型还揭示了任务向量的多样性对预训练效果起到至关重要的作用。因此,也就不难理解大语言模型需要海量多模态的文本库了。我们可以大胆地想象,只要穷尽承载人类文明的所有知识,也许有一天我们真能制造出无所不能的智慧机器,至少在人类已掌握技能的疆域内是没有问题的。本文从物理学的概念出发介绍了神经网络的DNA,数据相当于一种初始化,可以驱动网络连接权重的连续更新以获得一个聪明的自适应的物理模型,而这个更新过程是端对端地优化一个目标函数,优化的过程即执行在高维空间的朗之万动力学。神经网络的奥秘正是在于高维的权重空间,它本质上服从正则系综分布。半严格的物理分析给出了权重空间的分布和数据驱动的权重的对称性破缺。从物理直观出发,人们可以获取非平衡神经动力学的稳态全貌以及隐藏的动力学相变;甚至,人们可以将大语言模型的示例泛化归结为两体自旋模型,依此可以洞察智能的本质。数学的具象化为物理,而物理的尽头则为数学,数学与物理相辅相成,成为理解神经网络乃至智能本质不可或缺的手段。本文借助少数几个例子,希望启发青年学生欣赏数学的魅力,习得物理的洞察力,为揭开大脑智能神秘的面纱贡献自己的智慧。
 黄海平约 19 分钟