大白话秒懂五论文—AI大模型思维链的进化揭秘
 梁敬彬 梁敬弘约 10 分钟
为什么AI会算错简单数学题?秘密就藏在"思维链"里!本文用轻松对话形式解读五篇论文,让你秒懂让AI变身"超级大脑"的黑科技:
1️⃣ 手把手教:让AI 在答题前先看范例,正确率即可从18% 飙至57%!
2️⃣ 咒语觉醒:仅凭一句 Let's think step by step ,AI立刻聪明3倍!
3️⃣ 双剑合璧:两招一起用,AI性能暴涨,复杂测试反超人类平均水平!
4️⃣群体智慧:让AI生成多个思维链,用多数投票机制,性能再提18%!
5️⃣ 自我进化:生成“题-思维链-答案”合成数据,自我训练,永无上限!
DeepSeek-R1的核心思想源于这些论文的贡献。更为难得的是,这五篇论文皆符合三个特性:1. 较为浅显;2.极为重要;3.易于落地。这实属罕见,不容错过!
1
手把手教(Few-shot-CoT)
 。
 。
Jason Wei 的方法简单有效。就是在问模型问题的同时,附上示范问题、示范答案及示范答案的思考过程。这样模型有样学样,就能回答的更好了。这里需要注意的是,仅给示范问题的答案而不给思考过程,效果会很差。
比如论文中给模型一个问题"罗杰有5个网球,他又买了2罐,每罐有3个网球,他现在有多少个网球?",如果只告诉它答案是11,而未解释原因,模型是无法做到举一反三的。
23-20+6=9,模型居然做错了如此简单的数学 。
如果之前的示范并非单纯告诉它答案是11,而是这样教它:“罗杰一开始就有5个球,而罗杰又买了2罐,每罐3个网球,这里就有6个网球,所以答案是5+6=11。” 它就明白了,回答新题就不会犯这种低级错误了。
是的,Jason Wei把这种方法称为Few-shot Chain-of-Thought,简称Few-shot-CoT。论文中该方法将模型性能从18%提升到57%,效果惊人。
正是如此。这个发现彻底改变了我们对大模型能力的认识。不过,这种方法也有局限性,人工设计示例对每个问题都写思考引导,有些麻烦。
2
咒语觉醒(Zero-shot-CoT)
什么咒语?
Let's think step by step。
这么一句话,就能让模型变厉害了?
看看论文中的例子:一个杂耍演员可以同时抛接16个球。一半的球是高尔夫球,一半的高尔夫球是蓝色的,有多少个蓝色的高尔夫球?
一半是高尔夫球,意味着有8个高尔夫球,再一半是蓝色的,所以是4个蓝色高尔夫球。
就像开启了某种隐藏模式一样!
实验数据更加惊人。在GSM8K数据集上,仅仅添加这个简单提示,模型性能从10.4%直接飙升至40.7%,提升近四倍!如下图所示。
这太神奇了!为什么简单的一句提示词能产生这么大的影响?
3
双剑合璧(Few-shot-CoT × Zero-shot-CoT)彬老师 
还是Jason Wei他们,在《Large Challenging BIG-Bench tasks and whether chain-of-thought can solve them》论文中,尝试了一个看似简单却极为有效的组合,即同时使用Few-shot-CoT和Zero-shot-CoT。 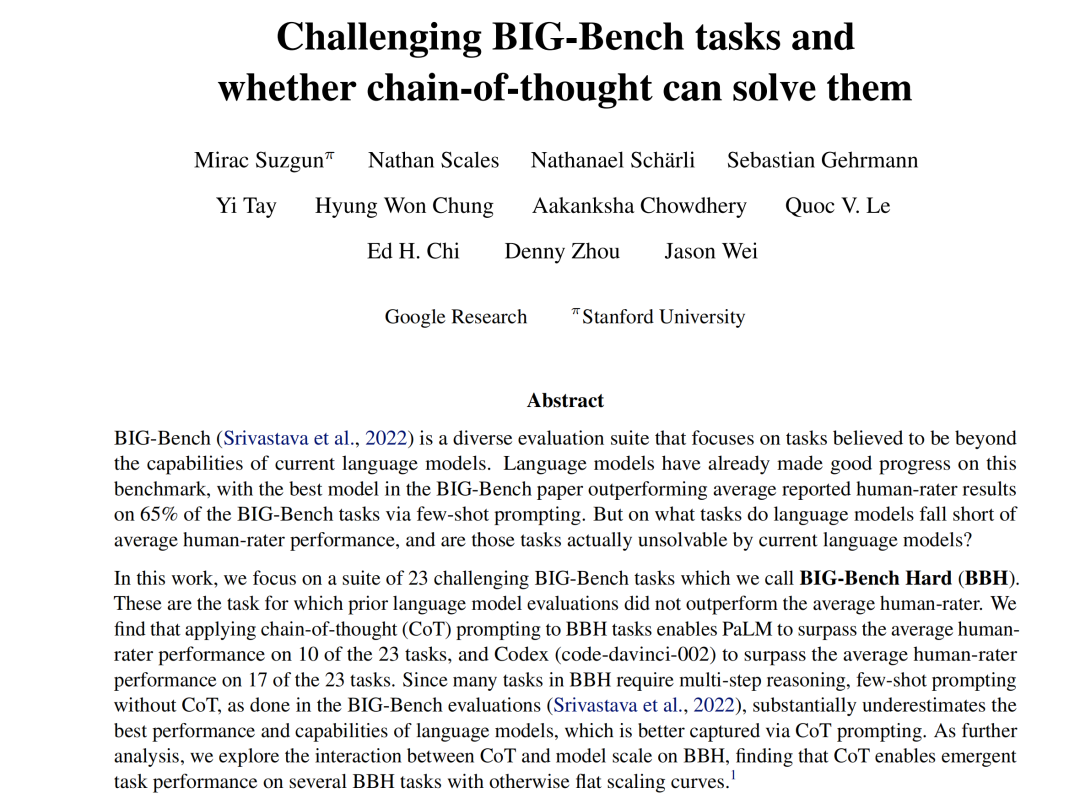
弘老师 简单来说,就是既提供详细的思考示例,又在最后加上 Let's think step by step 的提示。 
小渣 两种方法优势叠加,效果会更好吧?
弘老师 确实如此。论文中测试了一个时间推理问题:"今天,蒂芙尼去海滩了。他们可能在什么时间去的?" 如下图所示。 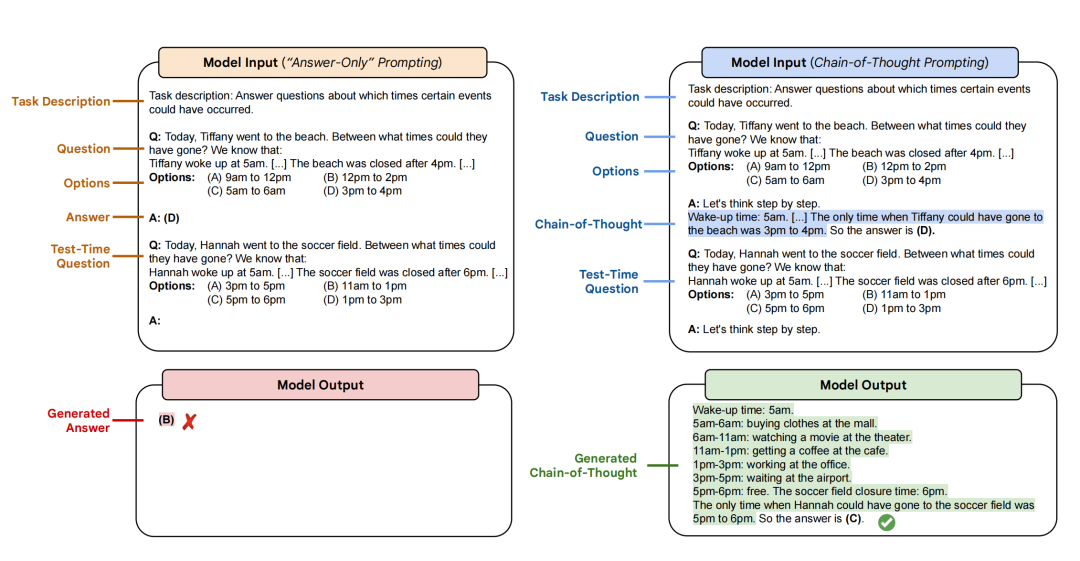
弘老师 首先,提供一个详细的示例,展示如何分析一个人的一天行程,从早上5点起床到最终得出"下午3点到4点去合适,答案为D"的完整推理。然后,在新问题后加上"Let's think step by step"。 彬老师 这种双重加持下,模型对新问题"今天,汉娜去了足球场。他们可能在什么时间去的?"的回答变得异常清晰:详细分析汉娜一天的时间安排,最终准确推断出"汉娜唯一可以去足球场的时间是下午5点到6点,所以答案是(C)"。 
大饼 这些方法在简单问题上效果好,那对于复杂任务呢? 弘老师 研究者们在Big-Bench Hard数据集上进行了测试,这是从Big-Bench中精选的23个极具挑战性的任务。结果令人震惊,传统方法在大多数任务上表现不如人类平均水平,但使用CoT后,模型在大部分任务上不仅大幅提升,超越了人类平均表现! 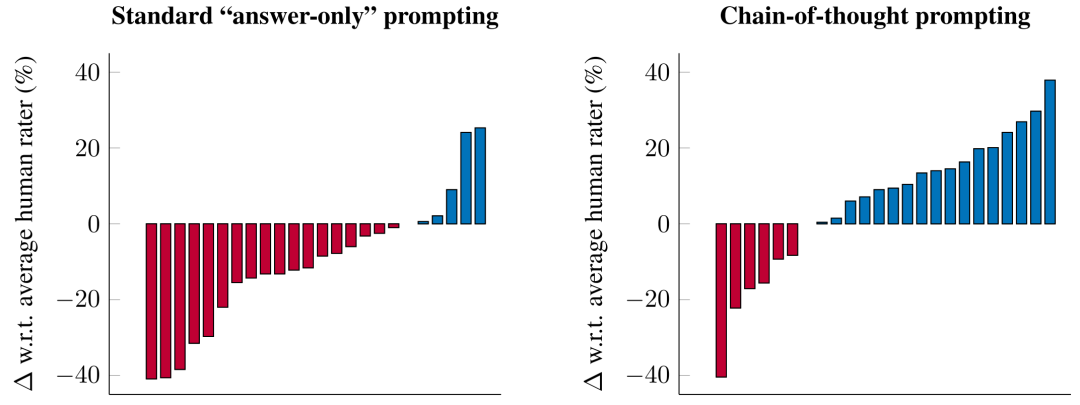
小渣 看似简单的调整,效果居然这么好?
彬老师 更有趣的是,研究发现CoT能力与模型规模密切相关——随着模型参数增加,使用CoT的性能提升幅度远大于不使用CoT的情况,呈现出典型的能力"涌现"特征。 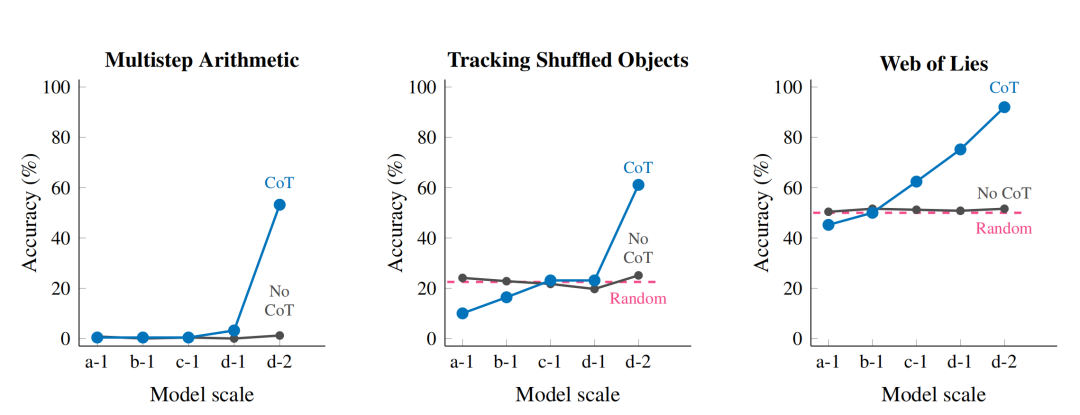
大饼 听起来,有些不可思议!
弘老师 是的,这一系列研究确实改变了我们对模型能力的理解。不过,这些方法本质上都属于提示工程,不改变模型本身。接下来我们要把研究目标转向改变模型本身的领域了,一起看看第四篇论文。
两种方法优势叠加,效果会更好吧?
看似简单的调整,效果居然这么好?
4
群体智慧(Self Consistency)

有点像投票系统?
生成的答案越多,投票基础就越大,准确率就会更高?
5
自我进化(Self Improvement)
这听起来有点像"自学成才"?
是的,具体过程是这样的:
1. 给模型提供一些人工设计的CoT示例;
2. 利用Self-Consistency方法让模型针对新问题生成多种思维链和答案;
3. 通过多数投票选出最可能正确的答案和对应的思维链;
4. 将这些高质量的"问题-思维链-答案"组合成新训练数据;
5. 用这些数据进一步训练(fine-tuning)模型。
如下图所示。
这意味着我们不需要大量人工标注的思维链数据,模型可以自己产生这些训练数据?
只是如此简单重复,还是有上限的。不过,提升大模型推理能力的手段还有许许多多,远不止今天探讨的这几篇思维链相关的论文,推理能力的爆发才刚刚开始。未来,像Jason Wei这样的做出杰出贡献的人工智能科学家会越来越多,未来可期!
各位兄弟抬举我Jason Wei了,亿点点心意,聊表谢意 。
所有看到 《CoT五论文解读—AI大模型思维链的进化揭秘与实践》的人,你们一定发大财!
小朋友都能懂的人工智能⓷ -惊世骇俗的狗故事 小朋友都能懂的人工智能⓸ -狗大师的修仙之路
小朋友都能懂的人工智能⓺ -注意,句中高能!
小朋友都能懂的人工智能⑪一滴墨汁成就一代画师
小朋友都能懂的人工智能⑫从画师到视频大师
小朋友都能懂的人工智能⑬AI时代,未来就业走势
数据库二十年目睹之怪现状⓵ 太!多!了!
数据库二十年目睹之怪现状⓶ 测评现形记
数据库二十年目睹之怪现状⓷ 隐蔽的套壳
数据库二十年目睹之怪现状⓸ 小黑入狱记
数据库二十年目睹之怪现状⓹ 真实的谎言
从DTCC专场变换窥探数据库风云
从围棋收官到秦楚大战的数据库SQL实现(上)
从围棋收官到秦楚大战的数据库SQL实现(中)
从围棋收官到秦楚大战的数据库SQL实现(下)
⓵悟!从12306改签困惑到数据库设计—高铁随记
⓶惊!12306业务系统升级也能被普通人推动?
⓷妙!探索12306车内换座的最优分配法
国产数据库第一股背后的秘密
“作弊”有理!——OceanBase2024发布会勾起我二十年前的回忆
SQL优化思想⓵--不优化或许是最好的优化!
SQL优化思想⓶--让SQL跑得更慢一些!
SQL优化思想⓷--时间都去哪儿了
A+B=C的融合AI模式已来,巨头怎么做?
警惕,对AI大模型的错误认知正在误导你