百度垂搜数据管理系统弹性调度优化实践
百 欢迎关注的约 13 分钟
。
点击蓝字,关注我们
作者 | 搜索在线架构团队
导读
introduction
百度垂直搜索系统将搜索核心能力赋能阿拉丁(百度搜索特型结果)、垂直领域搜索、应用内搜索等场景,支撑了数百个检索场景、百亿级内容数据的检索。随着接入业务数量和数据量不断增长,系统在海量数据管理与调度上遭遇新的挑战,通过垂搜数据管理系统弹性调度优化实践来满足业务增长需求。
全文6875字,预计阅读时间18分钟。
GEEK TALK 01 背景 1.1简介 百度垂搜架构的召回引擎经过历史架构演进确定了 异构 部署的架构模型,相较于同构部署在容量自动调整、数据按需存储等方面更具效率与成本的优势,同时在海量数据和海量检索方面也实现了高可用和高性能。目前系统已承接80+业务,全机房部署了 数百个检索服务,数千个索引库,共计数百亿文档收录 。 随着接入新业务数量的增加,以及存量业务的深入迭代,我们遇到了更加复杂多样的场景,进而对系统提出更高的要求。本文主要介绍我们的系统在海量数据管理与调度上面临的问题, 以及各项优化工作落地后在系统扩展性、稳定性等方面取得的效果。 1.2 当前数据管理架构存在的问题
此前我们的系统设计了弹性伸缩机制应对流量和数据量的上涨,冷热分离机制实现了资源按需部署。随着接入业务的增加,系统逐渐暴露出一些新的问题,主要体现在以下几点:
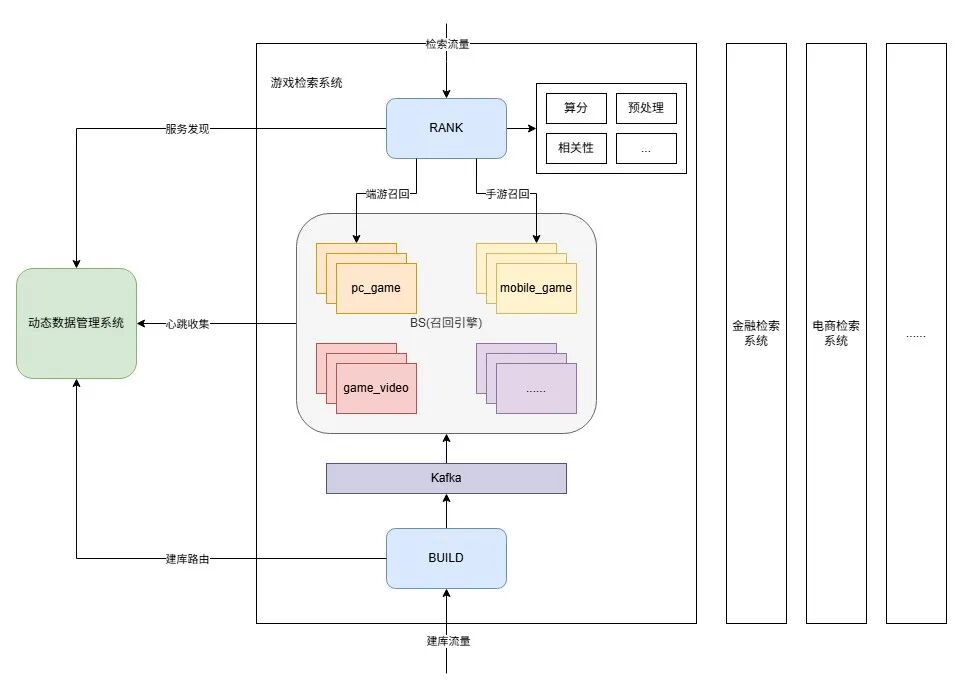
2.1 检索系统架构概览 首先简单介绍下垂搜检索系统的各模块,如下图所示:
2.2.1
中控服务
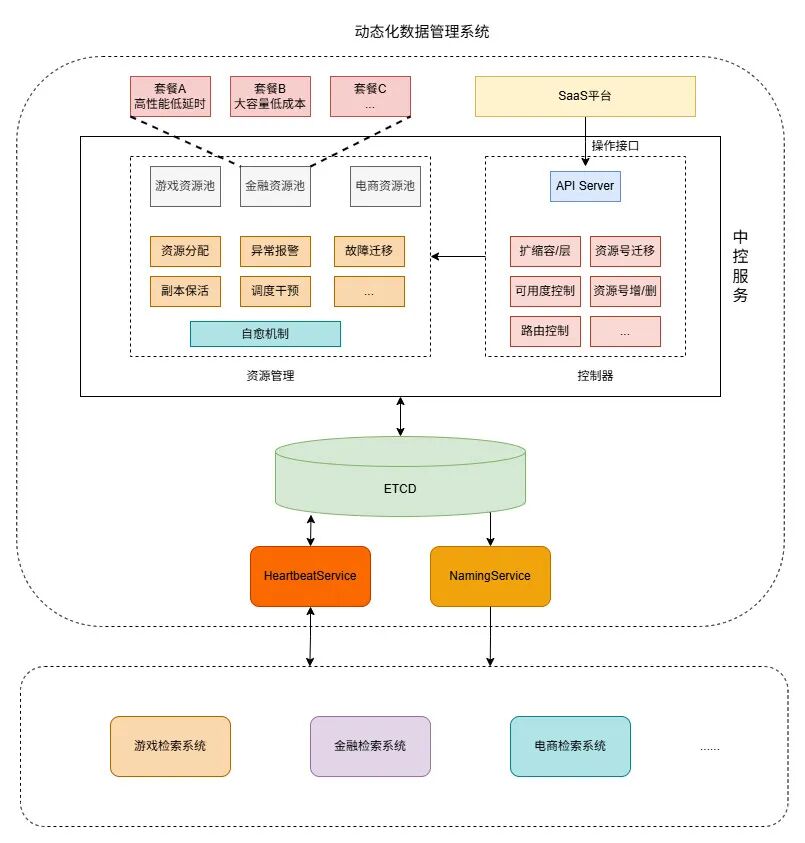
整个动态化数据管理系统的核心模块,负责各类调度任务的发起、控制等:
3.1 服务发现、心跳管理模块重构 3.1.1 原有架构
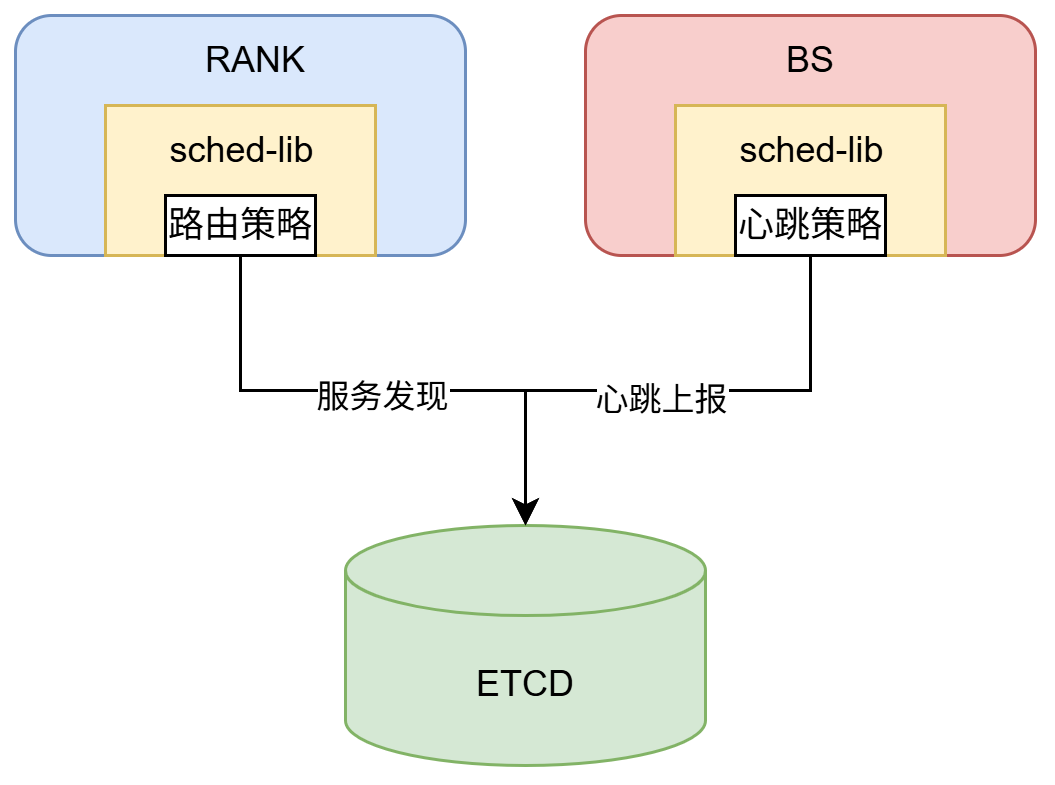
可以看到在原有架构,业务RANK和BS实例都是直连ETCD,随着业务接入数量的增加逐渐暴露出一些问题:
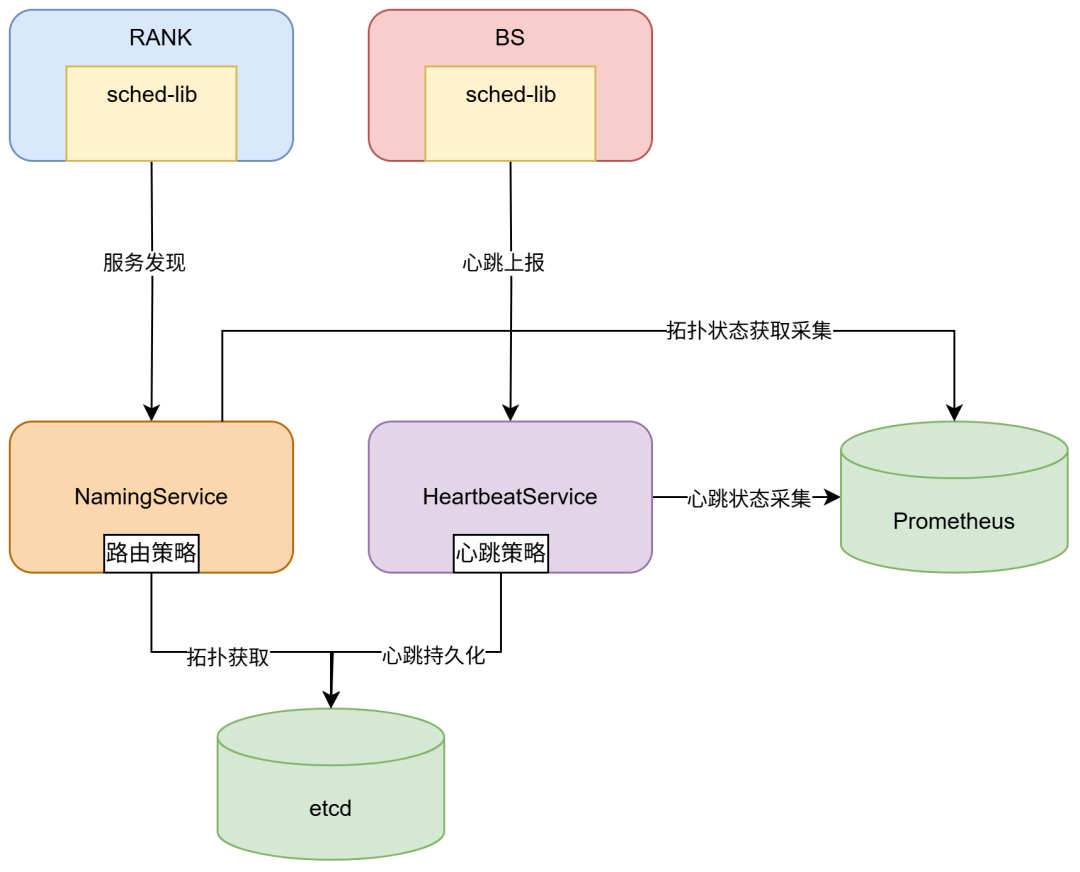
3.1.2
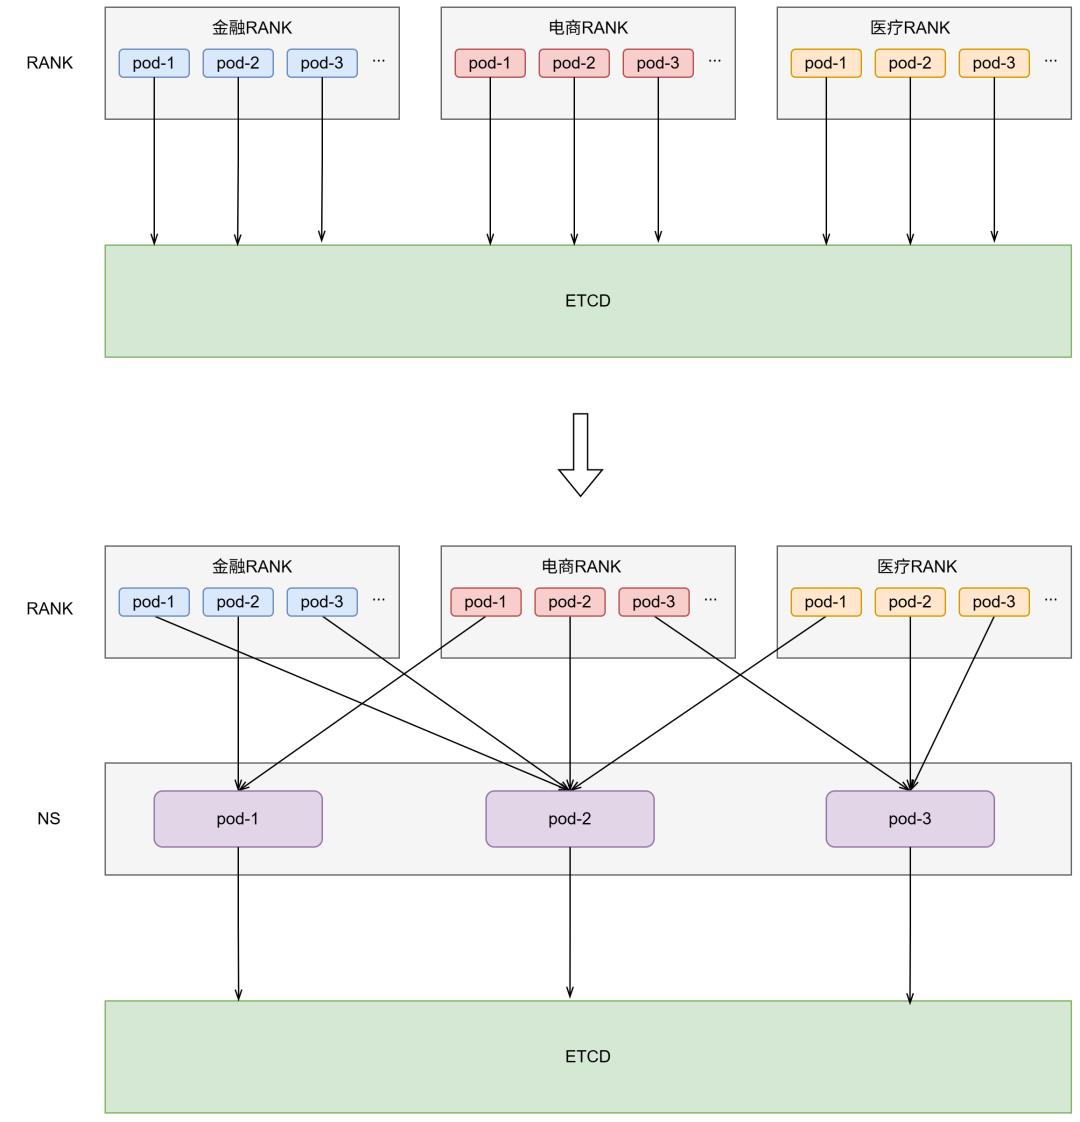
NS(NamingService)设计
我们对NS的定位是作为ETCD的cache,采用Read-Through的模式,对全量业务的RANK提供拓扑信息查询,RANK不再直接访问ETCD:
3.1.3
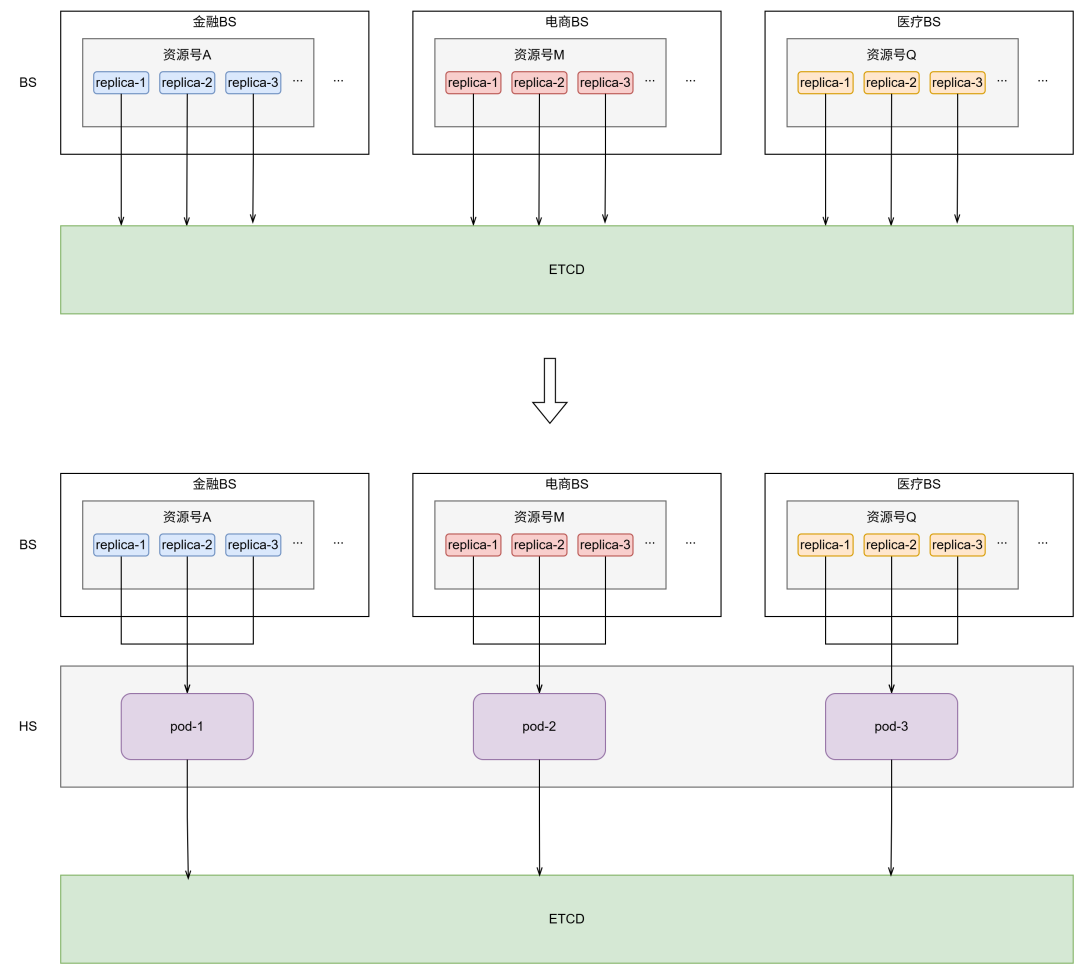
HS(HeartbeatService)设计
HS负责收集BS实例本身的心跳以及实例消费的分片的心跳,周期性
聚合写入
ETCD,并且向BS实例返回其最新的消费分片信息:
3.2
自动扩缩容
3.2.1
当前现状
BS是一个
多分片、异构
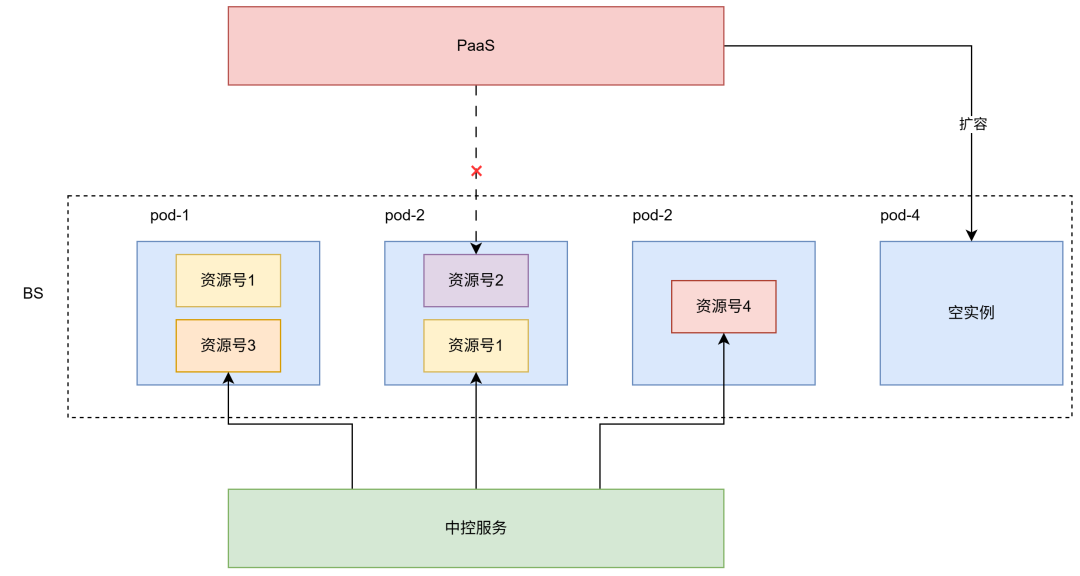
服务,即每个App内通常部署了多个资源号,各业务App在PasS层面隔离部署,在资源利用率、扩缩容管理等方面我们遇到以下问题:
3.2.2
自动扩缩容实现
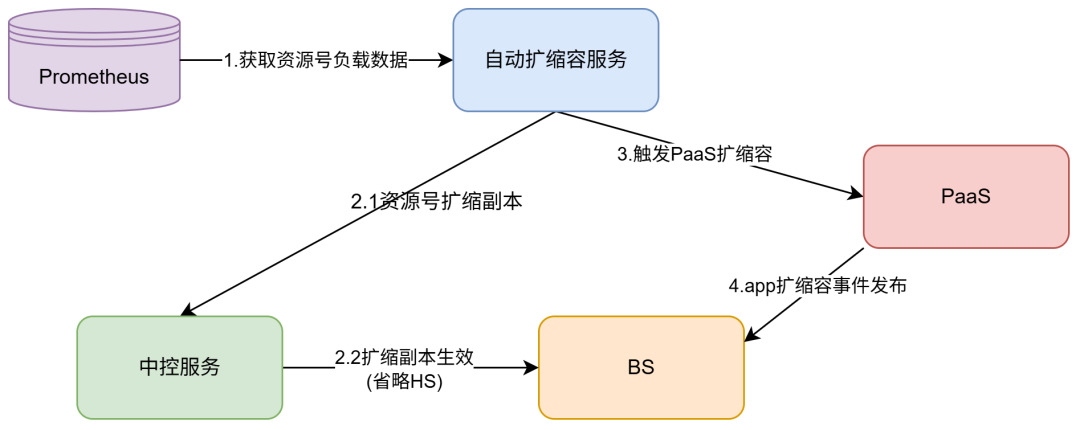
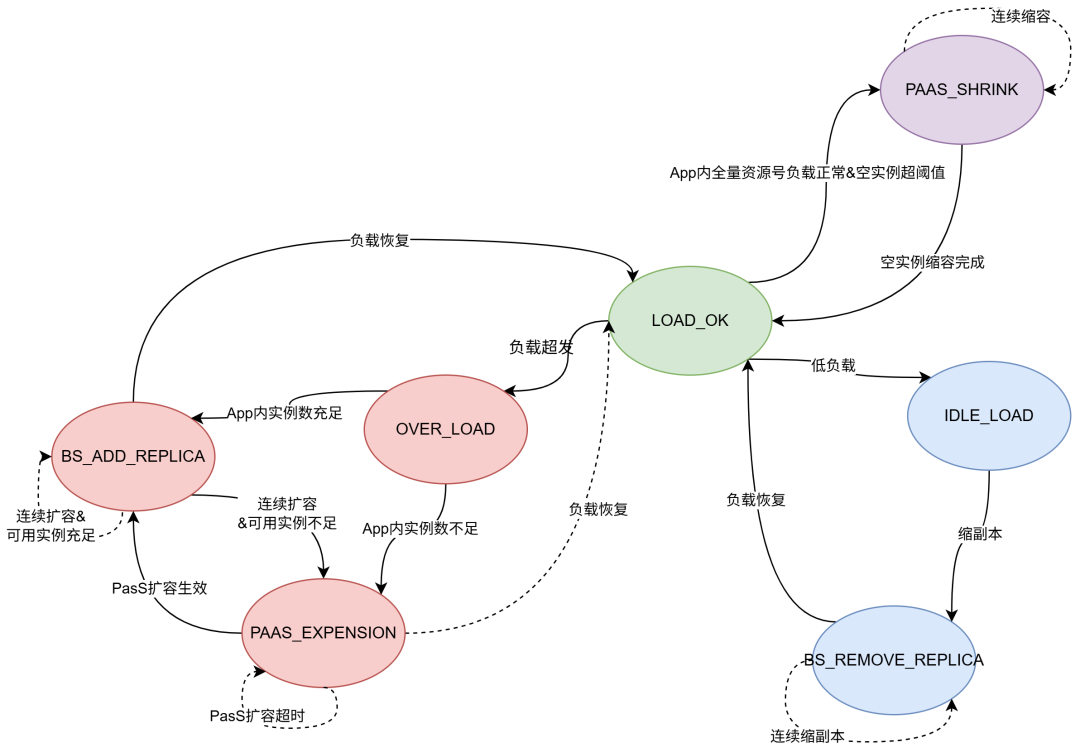
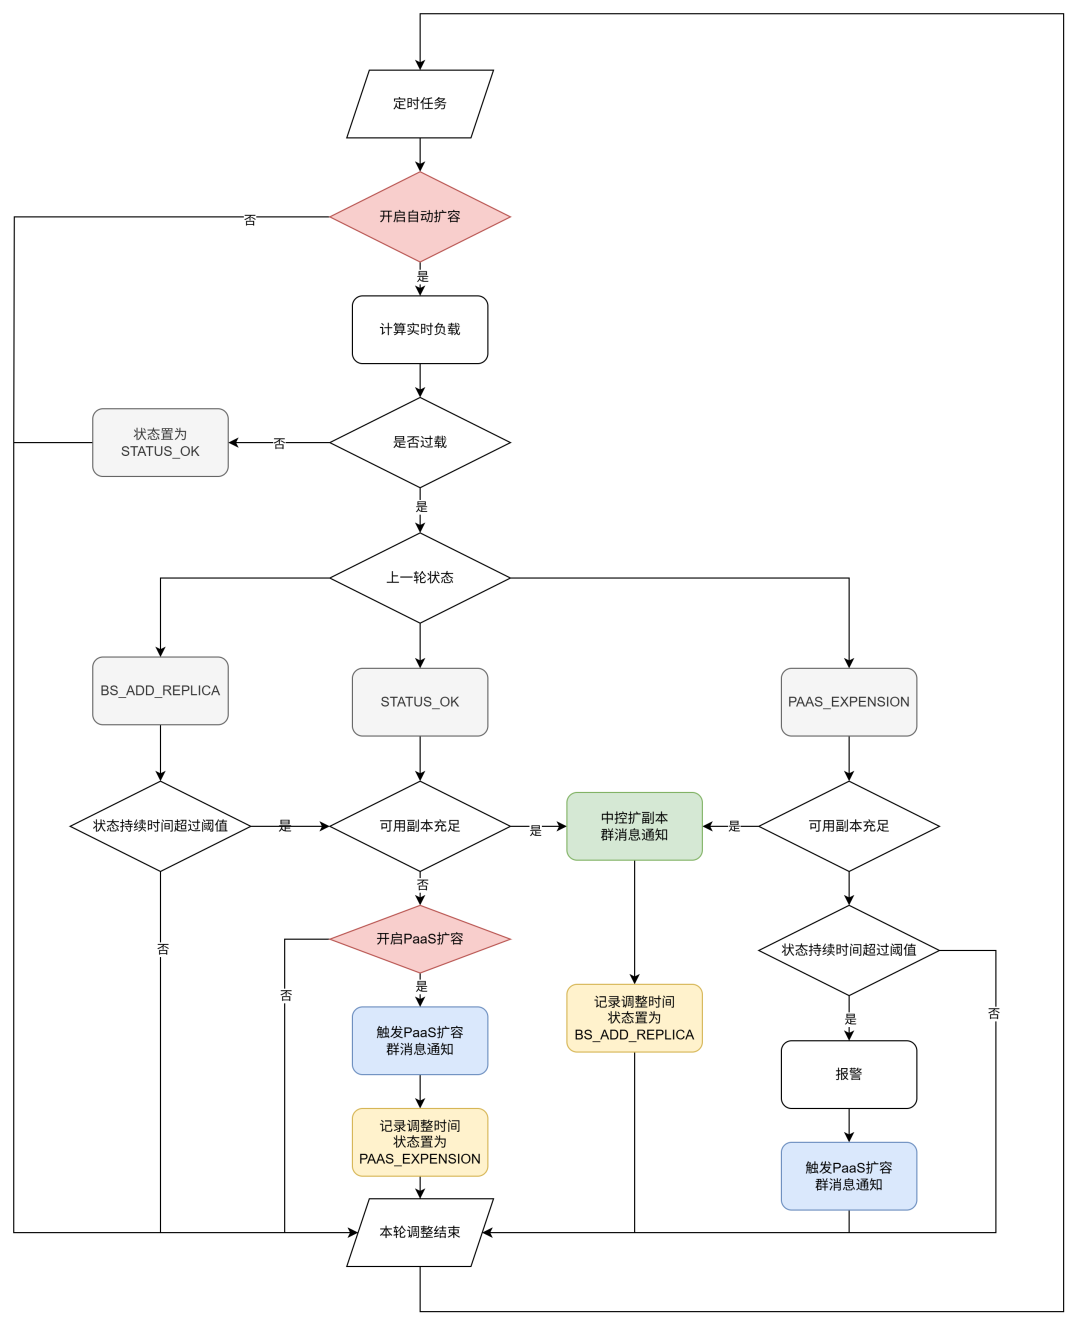
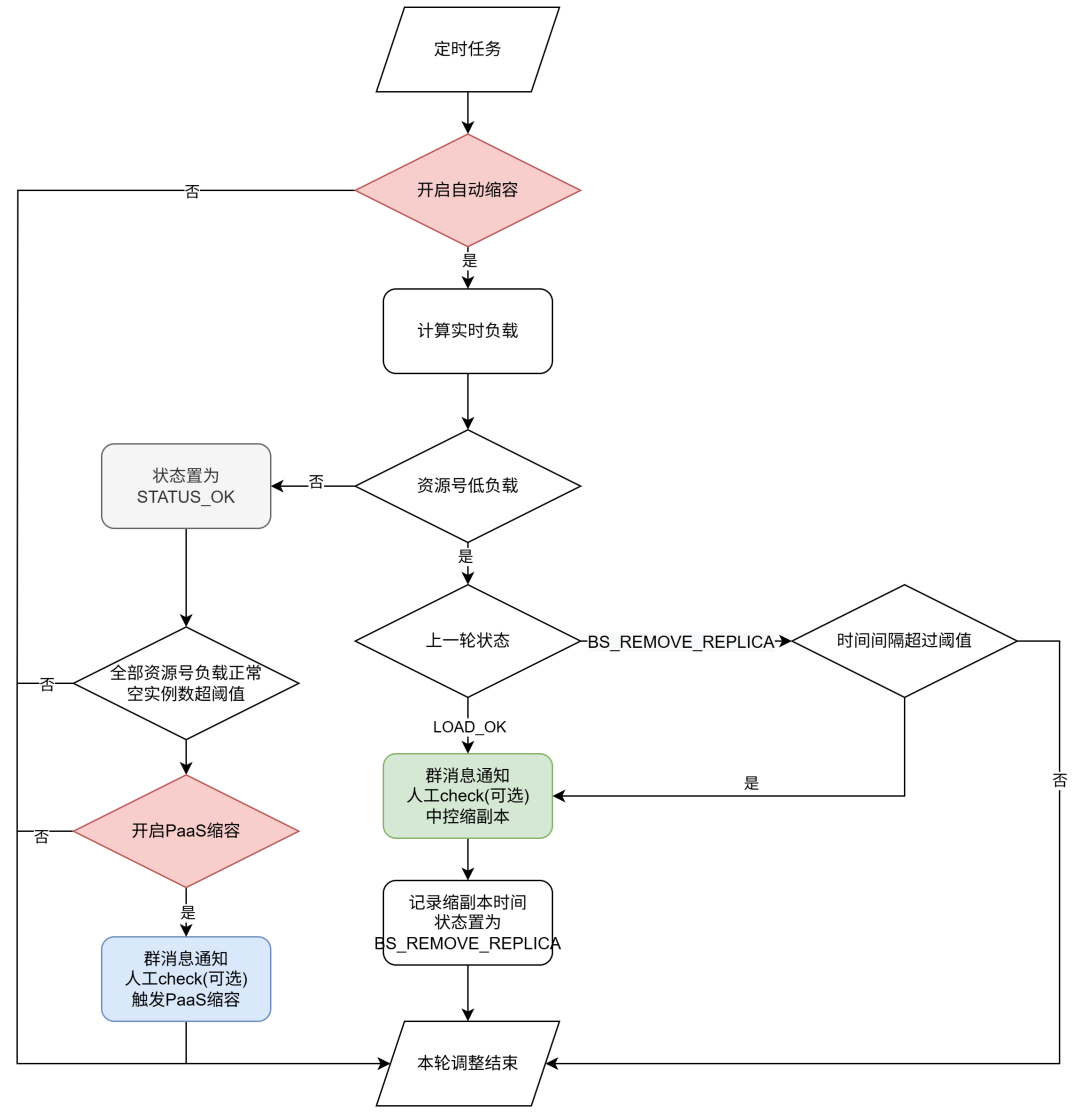
为了实现容量自适应调整,我们开发了一个自动扩缩容服务,对全量资源号进行容量管理。自动扩缩容服务周期性计算资源号维度负载,根据负载情况,触发中控服务进行资源号副本数调整,或者PaaS层面实例数调整。对于扩容,优先调度存量资源池中实例,如果存量实例不足则触发PaaS扩容;对于缩容,先将空闲副本数回收至空闲资源池,再触发PaaS缩容。对于自动扩缩容服务的设计我们主要考虑了以下几点:
3.3
资源号扩分片进阶
每个资源号随着数据量级不断增长,分片数也需要动态扩展,否则会出现分片内存超发的情况。
3.3.1
当前扩分片方案
每个资源号按resource->slice->slot的层级划分,slot 是数据划分最小单位与kafka partion一一对应,在业务接入时每个资源号slot(partion)的数量已经确定。扩层时,资源号的slot数量不变,
分片数变成原来2倍, 每个分片的slot数则为原来的1/2
。
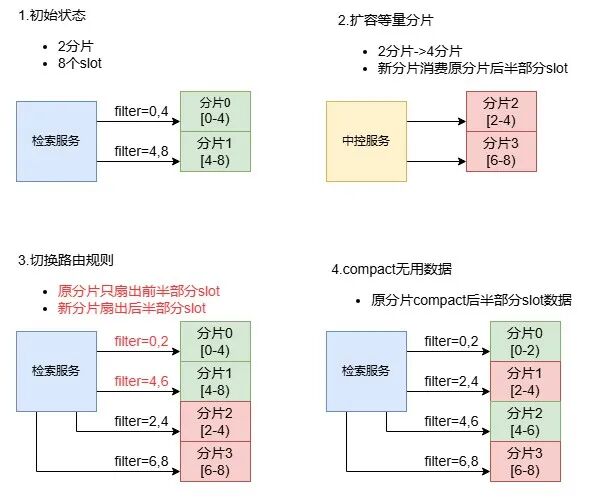
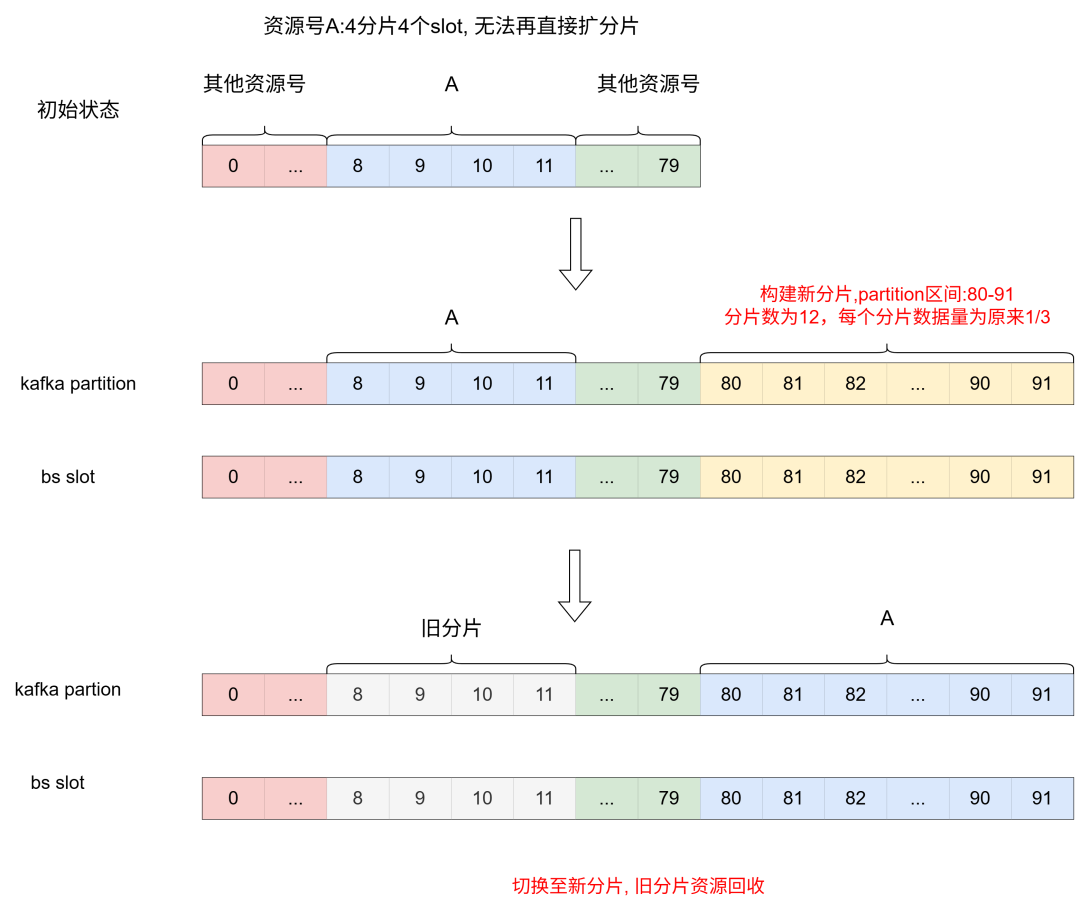
原有的扩分片方案可以在无需重新建库的情况下实现业务无感的原地分片扩缩操作,然而依旧存在两个问题:
GEEK TALK 04 总结与展望
4.1 总结 本文介绍了 百度垂搜 检索数据管理架构在弹性机制建设上的一系列优化工作,并且在扩展性、稳定性、以及成本效率等方面均取得了预期成果:
推荐阅读
百度沈抖:全栈自主可控,为应用而生
BaikalDB 架构演进实录:打造融合向量化与 MPP 的 HTAP 查询引擎
Redis 数据恢复的月光宝盒,闪回到任意指定时间
深入浅出DDD:从理论到落地的关键
中国自动驾驶研发解决方案,第一!
一键三连,好运连连,bug不见
👇
点击蓝字,关注我们
作者 | 搜索在线架构团队
导读
introduction
百度垂直搜索系统将搜索核心能力赋能阿拉丁(百度搜索特型结果)、垂直领域搜索、应用内搜索等场景,支撑了数百个检索场景、百亿级内容数据的检索。随着接入业务数量和数据量不断增长,系统在海量数据管理与调度上遭遇新的挑战,通过垂搜数据管理系统弹性调度优化实践来满足业务增长需求。
全文6875字,预计阅读时间18分钟。
GEEK TALK 01 背景 1.1简介 百度垂搜架构的召回引擎经过历史架构演进确定了 异构 部署的架构模型,相较于同构部署在容量自动调整、数据按需存储等方面更具效率与成本的优势,同时在海量数据和海量检索方面也实现了高可用和高性能。目前系统已承接80+业务,全机房部署了 数百个检索服务,数千个索引库,共计数百亿文档收录 。 随着接入新业务数量的增加,以及存量业务的深入迭代,我们遇到了更加复杂多样的场景,进而对系统提出更高的要求。本文主要介绍我们的系统在海量数据管理与调度上面临的问题, 以及各项优化工作落地后在系统扩展性、稳定性等方面取得的效果。 1.2 当前数据管理架构存在的问题
此前我们的系统设计了弹性伸缩机制应对流量和数据量的上涨,冷热分离机制实现了资源按需部署。随着接入业务的增加,系统逐渐暴露出一些新的问题,主要体现在以下几点:
- 元信息管理瓶颈。系统使用ETCD进行服务发现和心跳管理, 然而所有业务实例 直连ETCD 存在严重读写放大问题, 导致ETCD负载超发出现 单点瓶颈 , 限制集群规模进一步增长。
- 依靠人工评估资源。新业务的接入或者一些大事件运营保障依赖人工估算所需资源, 不仅耗费人力,而且不够准确 ,估算过高,服务长期处于低负载会造成资源浪费,估算过低,服务容易过载,进而导致稳定性问题。
-
数据量增长瓶颈。 当前的架构可以在无需重新建库的情况下原地扩分片,但是分片数只能倍数扩展,并且
分片数量有限制
,大库场景容易触发上限,进而导致数据量无法继续增长。
2.1 检索系统架构概览 首先简单介绍下垂搜检索系统的各模块,如下图所示:
- RANK。检索精排模块,负责query理解、请求构造、多队列拆分、正排数据获取、策略因子计算、算分排序、返回结果组装等流程。
- BS。检索召回引擎,负责基础召回/粗排,根据基础相关性等权重因子进行数据的粗筛,支持基于term倒排拉链和ANN向量基础召回。
- BUILD。数据建库模块,负责数据处理、切词、生成正排/倒排/向量/摘要等功能。
- 流式。业务经过离线建库环节产出建库包并生效到Kafka中,召回引擎再从Kafka消费,数据从建库到检索可实现 秒级生效 。
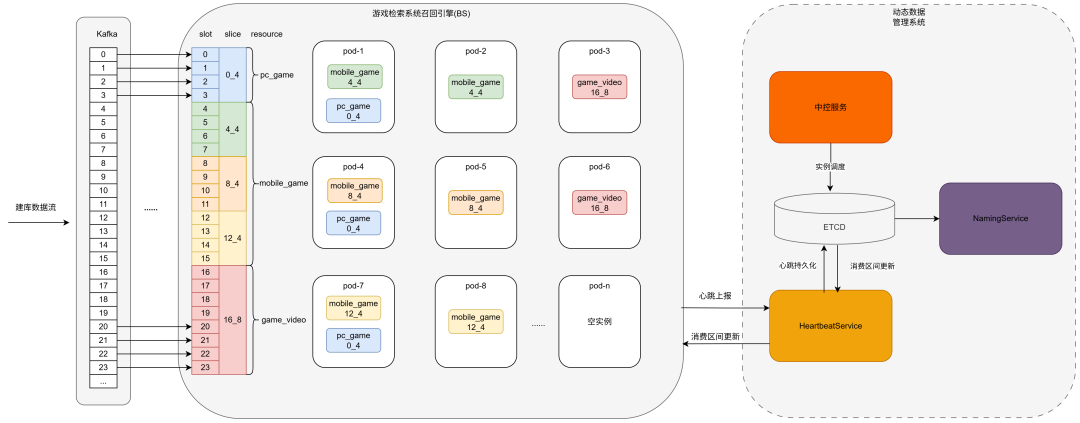
- 多分片。业务数据量超过单机存储上限,会被拆分成多个分片(slice),每个分片由PaaS层面实例承载,并对应Kafka的一段partition区间。
- 异构。单个业务的若干个资源号(resource)之间支持独占或者混部,一般根据服务负载设置不同副本数,根据数据量设置不同分片数。
- 有状态。每个实例承载一个或多个分片数据,周期性汇报心跳,消费分片由中控服务统一调度。
- resource(资源号): 一类或者一个场景的数据集合,即一个 索引库 ,一个业务通常包含多个资源号(如图中mobile_game,pc_game, game_video等)。
- slice(分片):数据调度基本单位,一个resource根据数据量可能会拆分成多个slice(mobile_game有三个slice, pc_game和game_video1个)。
- slot:数据划分的基本单位,一个slice下有若干个slot, 与Kafka的partition一一对应,在业务接入时根据数据量级确定。
- pod:PaaS层面实际的物理存储容器,一个pod会承载一个或多个slice,由中控服务统一调度。
- 资源号接入/下线。新增资源号(索引库),为每个资源号根据副本数、资源号之间部署关系等调度实例;下线资源号, 对应资源号的数据发起清理以及实例回收。
- 副本保活。每个资源号实际副本数可能由于扩缩副本或PaaS层面迁移,导致与目标副本数不一致,中控服务负责定期轮训所有资源号(分片),维持副本数与目标一致。
- 容量管理。自动扩缩容服务/人工基于负载调整资源号的副本数,并通过副本保活生效,基于数据量调整资源号分片数,通过任务控制器生效。
- 可用度控制。上线重启需要保证分片维度的可用度,变更由PaaS发起,每个实例重启前需要请求中控服务的探针,中控服务根据当前分片可用度决定实例是否可以重启。
- 服务发现。周期性加载并更新全量业务的资源号检索路由拓扑信息,对每个分片过滤心跳丢失、未消费完成、重启中等暂不可用实例。
- 实例屏蔽。支持异常实例的分片维度/App维度屏蔽,线上快速止损,并保留现场便于后续问题追查。
- 建库路由控制。提供离线建库侧全量业务资源号与Kafka partition映射关系查询,资源号倒排索引双写控制。
- 心跳管理。收集召回引擎实例上报的心跳信息,包括实例自身心跳以及消费分片信息, 并将心跳信息聚合后写入ETCD。
- 实例调度信息传递。获取由中控调度下发的最新消费分片信息,写入心跳请求response,实例感知到消费分片发生变化后,清理旧分片数据,并重新消费新分片数据。
- 实例心跳信息。包括版本号,实例唯一标识,上报时间戳,消费分片等。
- 分片路由拓扑信息。分片下全量副本状态信息,包括endpoint,snapshot版本,上报时间戳,消费状态等。
-
业务资源号拓扑信息、建库路由信息。单业务视角下全量资源号信息,包括版本号,分片数,副本数,对应Kafka partition区间,rpc参数配置等。
3.1 服务发现、心跳管理模块重构 3.1.1 原有架构
- 读流量放大。同业务的不同RANK实例会各自访问ETCD获取相同的路由拓扑,导致读流量放大,对于RANK实例数多的业务放大现象愈发明显。
- 写流量放大。每个分片含有多个副本,在进行更新时,一轮周期内同一个分片会被写入多次,导致写流量放大,对于副本数多的分片写竞争愈发激烈。
- 升级改造困难。路由筛选策略、心跳上报策略均内嵌在sched-lib中, 进行升级需要给每个业务RANK/BS上线,人力成本巨大。
- NS本身设计为一个 无状态服务 , RANK可以访问任意一台NS获取拓扑,NS实例之间拓扑路由 保证最终一致性 ,NS在拓扑变更时返回拓扑信息+MD5(拓扑)+更新时间戳,未变更时仅返回MD5和时间戳, RANK基于MD5和时间戳自行判断是否需要更新。
- 拓扑更新策略下沉到NS中,RANK获取到的拓扑即为直接可用拓扑,针对不同业务提供不同的控制策略并且后续升级改造只需上线NS,成本大幅降低。
- HS采用无主节点设计,也支持任意水平扩展。同一个业务的不同BS实例通过 一致性hash 方式请求同一台HS实例, 便于HS进行分片维度的信息聚合,这样在大部分时间,每个分片无论有多少个副本一个周期内只会被写入一次,实例本身的心跳采用批量更新形式,写竞争大幅降低。
- BS在上报心跳的同时会从HS的response中获取自身消费的最新分片信息,如果分片信息变化,则清理老分片数据,消费新分片数据,后续只上报新分片状态信息。
- 整体资源利用率低。全机房拥有上百个BS业务App、上千个资源号,PaaS层面的整体平均峰值CPU利用率低于平均水平,峰值CPU超过70%的资源号占比不足20%。
- 依赖人工进行资源号副本数调整。一般上线前通过人工压测评估放量后所需的资源然后进行申请,有时候通过压测难以估算真实的资源,并且后续业务迭代或者流量变化也会引起资源使用的变化,如果负载超发,服务稳定性难以保障,如果负载太过空闲,也会造成资源浪费。
- 无法直接接入PaaS层面自动扩缩容能力。一方面PaaS无法感知每个App内资源号维度负载信息,另一方面每个实例承载分片信息只能由中控服务调度,因此无法直接服用PaaS层面自动扩缩容能力。
负载指标选取
垂搜系统大部分业务BS为纯内存版本,且几乎没有下游网络请求,属于典型的计算密集型业务, 因此我们选择CPU作为负载计算参考指标,另外资源号混部场景进一步结合QPS和Latency进行判断。此前我们已经实现了基于Prometheus采集实分片维度CPU、MEM、QPS、Latency、建库数据量等指标全量业务覆盖,因此可以低成本的获取到全量 资源号维度 的负载数据。负载状态流转
每个资源号从扩容到缩容,共定义如下7种状态:每个资源号根据负载情况在上述状态之间流转:enum LoadStatus {LOAD_STATUS_LOAD_OK = 0; //正常负载LOAD_STATUS_OVERLOAD = 1; //超负载LOAD_STATUS_IDLELOAD = 2; //低负载LOAD_STATUS_BS_ADD_REPLICA = 3; //bs 扩副本中LOAD_STATUS_BS_REMOVE_REPLICA = 4; // bs 缩副本中LOAD_STATUS_TRIGGER_PAAS_EXPENSION = 5; // PaaS 扩容中LOAD_STATUS_TRIGGER_PAAS_SHRINK = 6; // PaaS 缩容中}
扩缩容执行流程
- 扩副本
- 优先调度App内空闲实例,不足则触发PaaS层面实例数扩容,循环执行直到负载恢复正常。
- 缩容
- 先将资源号多余副本释放为空闲实例,再触发PaaS层面缩容,循环执行直到资源号负载以及空闲实例数回到正常水平。
- 分片数按指数增长,当分片数超过一定数值,将带来不容忽视的资源成本。
- 如果初始分配slot数太少,当slice:slot=1:1时,无法再扩层,数据增长出现瓶颈。
- 每个资源号的slots是一段连续的区间。
- BS的slot与Kafka的partition一一对应。
- 初始分配slot数太少,且后续不支持调整。
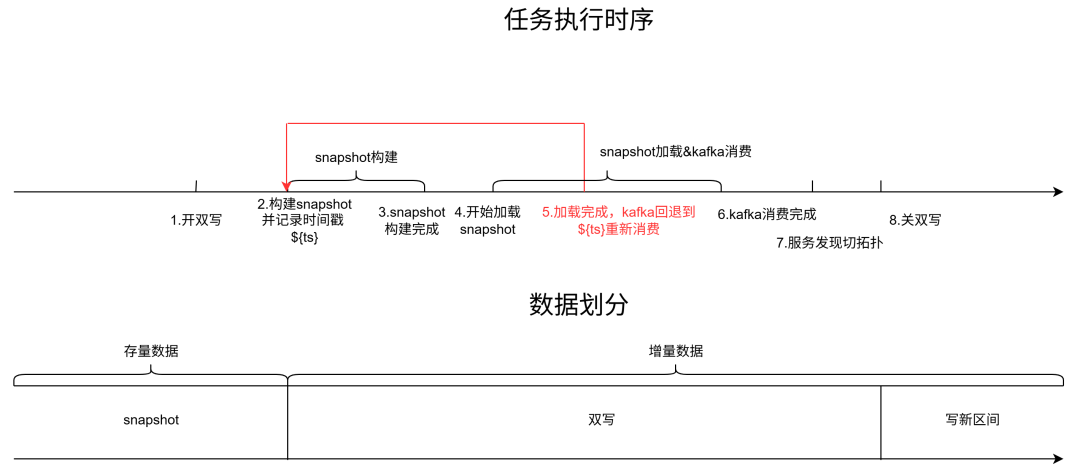
整体实现
对于一个流式建库系统,业务可能时刻都在进行数据建库,我们希望做到迁移过程中业务依旧可以持续建库,并且保证数据不丢失、时序不错乱。我们的方案是将数据分为存量数据(老分片中的全量数据)和增量数据(实时写入的新数据),对于增量数据可以通过双写机制,同时写入新旧分片,存量数据则通过构建snapshot的方法迁移至新分片,新分片数据ready后,再由服务发现层将检索流量切换至新分片,整体流程如下:- 离线侧开启双写,保证增量倒排索引数据同时写入新旧分片,正排和摘要部分数据无需变化。
- 基于旧分片构建新分片snapshot, 并记录构建时间点。将该时间点前旧分片所有数据进行resharding构建新分片snapshot。
- 新分片的BS实例加载构建好的snapshot,然后每个partition的消费offset 回退到snapshot构建时间点开始重新消费 。
- 服务发现层将资源号到slot区间映射切换到新分片上,检索流量从老分片迁移至新分片。
- 将旧分片BS实例回收,并关闭双写。
GEEK TALK 04 总结与展望
4.1 总结 本文介绍了 百度垂搜 检索数据管理架构在弹性机制建设上的一系列优化工作,并且在扩展性、稳定性、以及成本效率等方面均取得了预期成果:
- 扩展性
- ETCD负载下降一个量级,单机房BS、RANK集群规模提升两个量级, 单分片副本数上限提升至5000+。
- 分片扩展数量不再受限,解决了部分存量业务无法扩展分片导致的内存超发问题,并支持搜索创新业务数据量从百万级逐步增加至数十亿量级。
- 稳定性
- 存量调度问题被修复,新增多种路由调度策略以应对不同场景,分片可用度不足干预时间从小时级缩短至分钟级。
- ETCD负载不再超发,慢查询基本消失,稳定性风险基本消除,心跳上报、拓扑获取状态建立监控,异常情况及时感知。
- 成本效率
- 全机房BS接入自动扩缩容,实现容量自适应调整,整体峰值CPU利用率提升了15%+,同时相比之前减少了80%人工介入容量调整的情况出现。
- 部分业务通过分片合并,最终使用存储资源为下降至原来的20%,并且检索97分位耗时降低了20ms,业务侧效果与先前打平。
推荐阅读
百度沈抖:全栈自主可控,为应用而生
BaikalDB 架构演进实录:打造融合向量化与 MPP 的 HTAP 查询引擎
Redis 数据恢复的月光宝盒,闪回到任意指定时间
深入浅出DDD:从理论到落地的关键
中国自动驾驶研发解决方案,第一!