震惊|DuckDB疑被某Rust项目“抄袭”
 digoal约 6 分钟
DuckDB 迎来第一波“抄袭者”!
DuckDB 太火爆已30K star, 野心暴露见: ( DuckDB 暴露野心,日后与PG必有一战 ). 使用广泛, 甚至形成了用户习惯.
和PostgreSQL/MySQL有大量的追随者一样, DuckDB也迎来了第一波“抄袭者”:
GlareDB (Rust项目), 一样很小巧, 一样性能杠杠的!
看它的文档和使用方式, 几乎和DuckDB一致:
https://glaredb.com/docs
https://github.com/GlareDB/glaredb
定位:
DuckDB is a fast analytical|portable|in-process|open-source database system GlareDB is a fast, lightweight SQL database for running analytics.
安装:
curl https://install.duckdb.org | sh curl -fsSL https://glaredb.com/install.sh | sh
截取自GlareDB文档中的一些使用例句, 是不是很像DuckDB :
SELECT * FROM read_parquet(['file1.parquet', 'file2.parquet']);

SELECT * FROM csv.read('s3://bucket-name/path/to/file.csv',
                       region='us-east-1',
                       access_key_id='YOUR_ACCESS_KEY',
                       secret_access_key='YOUR_SECRET_KEY');

SELECT *
FROM iceberg.snapshots('wh/default.db/cities')

SELECT * FROM read_csv('https://example.com/cities.csv');

CREATE TEMP TABLE customer AS SELECT * FROM tpch_gen.customer(1);
CREATE TEMP TABLE lineitem AS SELECT * FROM tpch_gen.lineitem(1);
CREATE TEMP TABLE nation AS SELECT * FROM tpch_gen.nation(1);
CREATE TEMP TABLE orders AS SELECT * FROM tpch_gen.orders(1);
CREATE TEMP TABLE part AS SELECT * FROM tpch_gen.part(1);
CREATE TEMP TABLE partsupp AS SELECT * FROM tpch_gen.partsupp(1);
CREATE TEMP TABLE region AS SELECT * FROM tpch_gen.region(1);
CREATE TEMP TABLE supplier AS SELECT * FROM tpch_gen.supplier(1);
和DuckDB一样( https://shell.duckdb.org/ ), 可以在官网直接体验采用web assumbel的客户端( https://glaredb.com/ ), 注意它运行在你的WEB浏览器中.
glaredb> show tables;
┌────────────────┐
│ name           │
│ Utf8           │
├────────────────┤
│ show_databases │
│ show_schemas   │
│ show_tables    │
└────────────────┘
glaredb> .databases
┌───────────────┐
│ database_name │
│ Utf8          │
├───────────────┤
│ system        │
│ temp          │
└───────────────┘
glaredb>
     ... CREATE TEMP TABLE customer AS SELECT * FROM tpch_gen.customer(1);
     ... CREATE TEMP TABLE lineitem AS SELECT * FROM tpch_gen.lineitem(1);
     ... CREATE TEMP TABLE nation AS SELECT * FROM tpch_gen.nation(1);
     ... CREATE TEMP TABLE orders AS SELECT * FROM tpch_gen.orders(1);
     ... CREATE TEMP TABLE part AS SELECT * FROM tpch_gen.part(1);
     ... CREATE TEMP TABLE partsupp AS SELECT * FROM tpch_gen.partsupp(1);
     ... CREATE TEMP TABLE region AS SELECT * FROM tpch_gen.region(1);
     ... CREATE TEMP TABLE supplier AS SELECT * FROM tpch_gen.supplier(1); glaredb> .tables
┌────────────────┐
│ name           │
│ Utf8           │
├────────────────┤
│ customer       │
│ lineitem       │
│ nation         │
│ orders         │
│ part           │
│ partsupp       │
│ region         │
│ show_databases │
│ show_schemas   │
│ show_tables    │
│ supplier       │
└────────────────┘
glaredb>

glaredb> .timer on
glaredb> select count(distinct l_orderkey) from lineitem;
┌──────────┐
│ count    │
│ Int64    │
├──────────┤
│  1500000 │
└──────────┘
Execution duration (s): 0.27590
glaredb> select count(*) from lineitem;
┌──────────┐
│ count    │
│ Int64    │
├──────────┤
│  6001215 │
└──────────┘
Execution duration (s): 0.04120
继续看glaredb的文档结构
Get started
  Install
Clients
  CLI
Integrations
  File formats
    CSV
    Parquet
  Tables & catalogs
    Iceberg
  File systems
    Overview
    GCS
    HTTP
    Local
    S3
  Data generation
    TPC-H
SQL
...
  Benchmarking
是不是很像?
给人的感觉, glaredb在用Rust重写DuckDB! 功能也正在逐一对齐ing.
Rust就是牛!
怪不得小布老师除了“包分配”(留美JOB)的PG培训, 又看上了Rust培训
GlareDB 背后居然是 DataFusion
实际上GlareDB并不是“抄袭者”, GlareDB 是采用了DataFusion技术栈的产品.
DataFusion是Rust编写的, 将数据库拆成不同功能模块的多个开源项目, 包括交互协议、SQL解析优化执行器、存储、事务管理等, 是面向大数据的技术栈集合.
我之前写过一篇文章介绍DataFusion
《将 "数据结构、数据存储" 从 "数据库管理系统" 剥离后 - 造就了大量大数据产品(DataFusion, arrow-rs, databend等)》 https://github.com/digoal/blog/tree/master/202303/20230328_02.md
2023年就有 glaredb 项目, 下面的内容来自该文章的翻译 : https://hackernoon.com/what-the-heck-is-glaredb
概述
GlareDB 是一个利用DataFusion的开源项目, 该项目是 Apache Arrow 项目的一部分。DataFusion 是一个快速、可扩展的查询引擎,用于使用Rust语言构建高质量的数据中心系统,并采用Apache Arrow内存格式。它提供 SQL 和 Dataframe API,并内置对 CSV、Parquet、JSON 和 Avro 的支持。此外,它还提供Python 绑定以及广泛的自定义可能性。GlareDB 在其基础上添加了诸多功能,例如云存储和前面提到的混合执行功能,从而在各种计算引擎之上提供了一个层,可以:
查询本地和远程文件 查询其他数据库和数据源 存储数据和查询(作为视图) 将数据从源复制到目标 在 Python 中与 DataFrame 库进行互操作 从命令行运行一次性query
GlareDB在这张图中描述了它的位置:
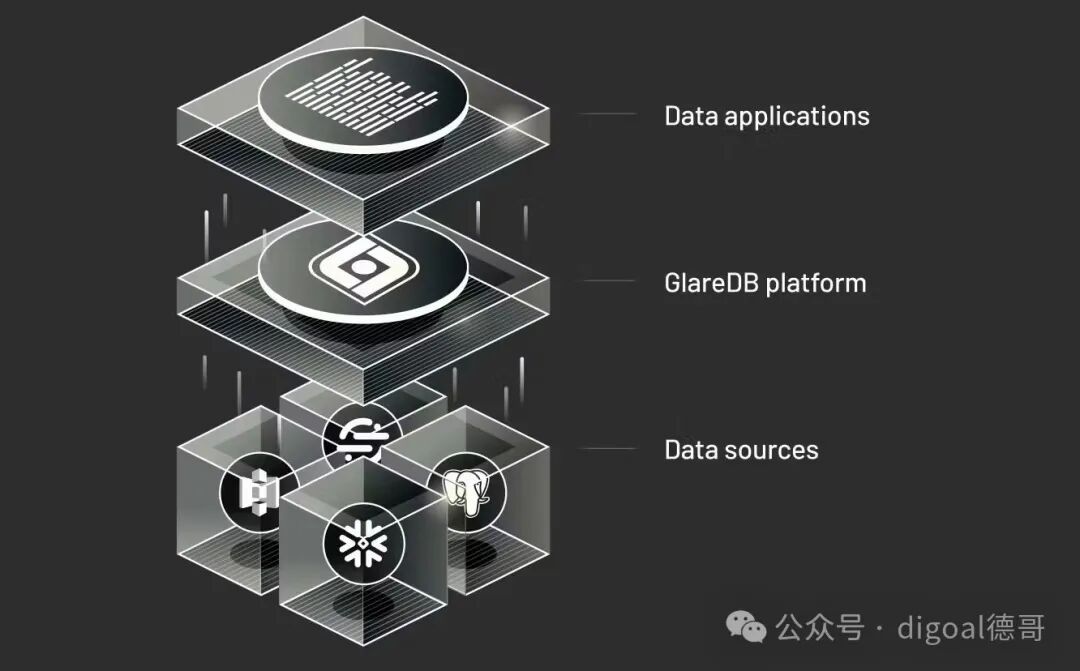
pic 它支持位于 GCS 或 S3 上的以下类型的数据:
BigQuery MongoDB(早期版本) MySQL Postgres Snowflake Iceberg Redshift(即将推出) ClickHouse(即将推出)
他们正在快速添加对各种引擎的支持,因此当您阅读本文时,此列表可能不完整。
我可以用GlareDB做什么?
乍一看,你看到这个GlareDB会想,嘿,这看起来很像trino ( https://trino.io/ )因为它是一个联合查询引擎。
乍一看,它有点像MotherDuck, 原因有几个。首先,与 DuckDB 类似( 我第一眼也被骗了, 以为是哪里冒出来的“抄袭者” ),GlareDB 是一个单一、紧凑的可执行文件,但它是用 Rust 而不是 C++ 编写的。其次,它们也支持混合执行模型(MotherDuck 首先做了这个) ( https://motherduck.com/blog/announcing-motherduck-duckdb-in-the-cloud/ )。
鉴于 Trino 是用 Java 编写的,这意味着如果要使用它,你需要处理大量的 Java 生态系统。当然,市面上有一些预构建的 Docker 容器可以缩短这个过程,但通常情况下,如果你“只是想做点什么”,那么安装和设置 Trino 会很费劲。而使用 GlareDB,你只需下载一个可执行文件即可使用,或者直接使用他们的 SaaS 产品,首次使用时如下所示:
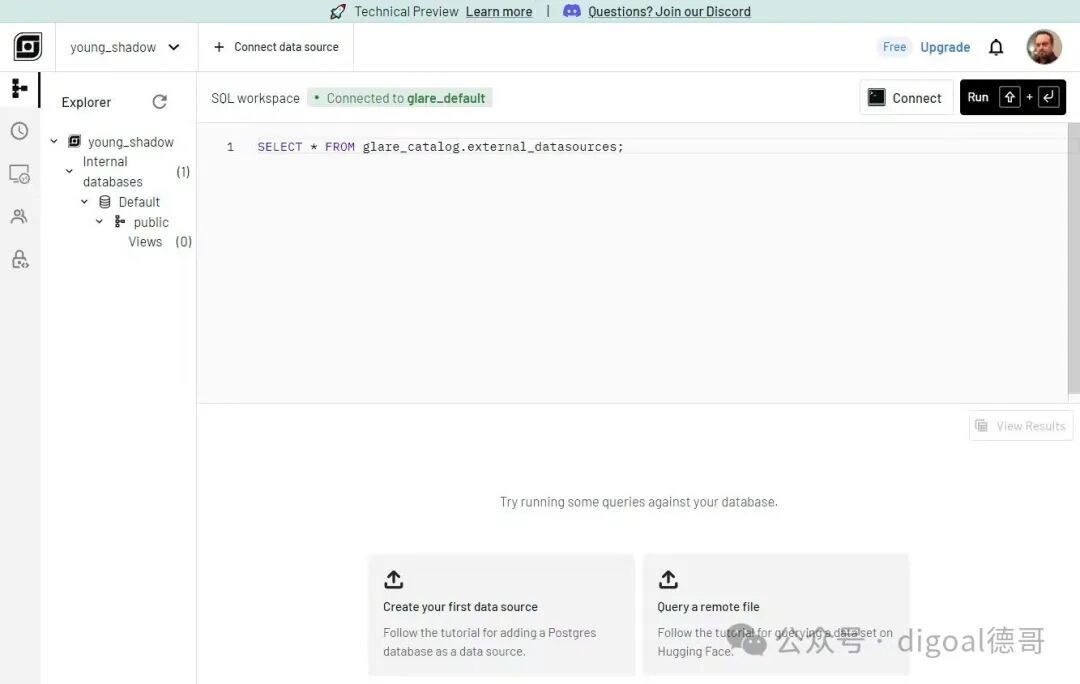
pic 现在来谈谈混合执行。我将转述 GlareDB 在其博客文章中关于此主题的部分内容。假设您有一个 CSV 文件,其中包含使用其他工具从数据库中提取的用户 ID 列表。现在,您想使用数据库中的一些用户人口统计信息来丰富这些数据。假设我们的表名为 user_demo,CSV 文件名为 user_id.csv,我们的查询如下所示:
SELECT
   m.user_id,
   m.first_name,
   m.last_name,
   m.birth_date
FROM
   user_demo m
INNER JOIN '/user_id.csv' u on m.user_id = u.id
GROUP BY m.user_id;
显然,这是一个简单的例子,但您可以对其进行增强,以便从其他已连接表中获取信息。您也可以反过来,假设您有一个包含关键字段的本地文件,其中包含您感兴趣的数据,您可以将这些数据连接到数据库中的某个表,而该文件中的额外数据在数据库中并不存在。这样做的好处是,您无需为这份临时报告创建新表并加载它,从而节省大量时间。
以上只是想让你快速了解一下 GlareDB 的功能和目前的发展情况。他们网站上的文档和博客写得非常出色,让你可以快速上手。
DuckDB 迎来第一波“抄袭者”!
DuckDB 太火爆已30K star, 野心暴露见: ( DuckDB 暴露野心,日后与PG必有一战 ). 使用广泛, 甚至形成了用户习惯.
和PostgreSQL/MySQL有大量的追随者一样, DuckDB也迎来了第一波“抄袭者”:
GlareDB (Rust项目), 一样很小巧, 一样性能杠杠的!
看它的文档和使用方式, 几乎和DuckDB一致:
https://glaredb.com/docs
https://github.com/GlareDB/glaredb
定位:
DuckDB is a fast analytical|portable|in-process|open-sourcedatabase systemGlareDB is a fast, lightweight SQL database for running analytics.
安装:
curl https://install.duckdb.org | sh curl -fsSL https://glaredb.com/install.sh | sh
截取自GlareDB文档中的一些使用例句, 是不是很像DuckDB :
SELECT * FROM read_parquet(['file1.parquet', 'file2.parquet']);
SELECT * FROM csv.read('s3://bucket-name/path/to/file.csv',
region='us-east-1',
access_key_id='YOUR_ACCESS_KEY',
secret_access_key='YOUR_SECRET_KEY');
SELECT *
FROM iceberg.snapshots('wh/default.db/cities')
SELECT * FROM read_csv('https://example.com/cities.csv');
CREATE TEMP TABLE customer AS SELECT * FROM tpch_gen.customer(1);
CREATE TEMP TABLE lineitem AS SELECT * FROM tpch_gen.lineitem(1);
CREATE TEMP TABLE nation AS SELECT * FROM tpch_gen.nation(1);
CREATE TEMP TABLE orders AS SELECT * FROM tpch_gen.orders(1);
CREATE TEMP TABLE part AS SELECT * FROM tpch_gen.part(1);
CREATE TEMP TABLE partsupp AS SELECT * FROM tpch_gen.partsupp(1);
CREATE TEMP TABLE region AS SELECT * FROM tpch_gen.region(1);
CREATE TEMP TABLE supplier AS SELECT * FROM tpch_gen.supplier(1);
和DuckDB一样( https://shell.duckdb.org/ ), 可以在官网直接体验采用web assumbel的客户端( https://glaredb.com/ ), 注意它运行在你的WEB浏览器中.
glaredb> show tables;
┌────────────────┐
│ name │
│ Utf8 │
├────────────────┤
│ show_databases │
│ show_schemas │
│ show_tables │
└────────────────┘
glaredb> .databases
┌───────────────┐
│ database_name │
│ Utf8 │
├───────────────┤
│ system │
│ temp │
└───────────────┘
glaredb>
... CREATE TEMP TABLE customer AS SELECT * FROM tpch_gen.customer(1);
... CREATE TEMP TABLE lineitem AS SELECT * FROM tpch_gen.lineitem(1);
... CREATE TEMP TABLE nation AS SELECT * FROM tpch_gen.nation(1);
... CREATE TEMP TABLE orders AS SELECT * FROM tpch_gen.orders(1);
... CREATE TEMP TABLE part AS SELECT * FROM tpch_gen.part(1);
... CREATE TEMP TABLE partsupp AS SELECT * FROM tpch_gen.partsupp(1);
... CREATE TEMP TABLE region AS SELECT * FROM tpch_gen.region(1);
... CREATE TEMP TABLE supplier AS SELECT * FROM tpch_gen.supplier(1); glaredb> .tables
┌────────────────┐
│ name │
│ Utf8 │
├────────────────┤
│ customer │
│ lineitem │
│ nation │
│ orders │
│ part │
│ partsupp │
│ region │
│ show_databases │
│ show_schemas │
│ show_tables │
│ supplier │
└────────────────┘
glaredb>
glaredb> .timer on
glaredb> select count(distinct l_orderkey) from lineitem;
┌──────────┐
│ count │
│ Int64 │
├──────────┤
│ 1500000 │
└──────────┘
Execution duration (s): 0.27590
glaredb> select count(*) from lineitem;
┌──────────┐
│ count │
│ Int64 │
├──────────┤
│ 6001215 │
└──────────┘
Execution duration (s): 0.04120
继续看glaredb的文档结构
Get started
Install
Clients
CLI
Integrations
File formats
CSV
Parquet
Tables & catalogs
Iceberg
File systems
Overview
GCS
HTTP
Local
S3
Data generation
TPC-H
SQL
...
Benchmarking
是不是很像?
给人的感觉, glaredb在用Rust重写DuckDB! 功能也正在逐一对齐ing.
Rust就是牛!
怪不得小布老师除了“包分配”(留美JOB)的PG培训, 又看上了Rust培训
GlareDB 背后居然是 DataFusion
实际上GlareDB并不是“抄袭者”, GlareDB 是采用了DataFusion技术栈的产品.
DataFusion是Rust编写的, 将数据库拆成不同功能模块的多个开源项目, 包括交互协议、SQL解析优化执行器、存储、事务管理等, 是面向大数据的技术栈集合.
我之前写过一篇文章介绍DataFusion
《将 "数据结构、数据存储" 从 "数据库管理系统" 剥离后 - 造就了大量大数据产品(DataFusion, arrow-rs, databend等)》 https://github.com/digoal/blog/tree/master/202303/20230328_02.md
2023年就有 glaredb 项目, 下面的内容来自该文章的翻译 : https://hackernoon.com/what-the-heck-is-glaredb
概述
GlareDB 是一个利用DataFusion的开源项目, 该项目是 Apache Arrow 项目的一部分。DataFusion 是一个快速、可扩展的查询引擎,用于使用Rust语言构建高质量的数据中心系统,并采用Apache Arrow内存格式。它提供 SQL 和 Dataframe API,并内置对 CSV、Parquet、JSON 和 Avro 的支持。此外,它还提供Python 绑定以及广泛的自定义可能性。GlareDB 在其基础上添加了诸多功能,例如云存储和前面提到的混合执行功能,从而在各种计算引擎之上提供了一个层,可以:
查询本地和远程文件 查询其他数据库和数据源 存储数据和查询(作为视图) 将数据从源复制到目标 在 Python 中与 DataFrame 库进行互操作 从命令行运行一次性query
GlareDB在这张图中描述了它的位置:
它支持位于 GCS 或 S3 上的以下类型的数据:
BigQuery MongoDB(早期版本) MySQL Postgres Snowflake Iceberg Redshift(即将推出) ClickHouse(即将推出)
他们正在快速添加对各种引擎的支持,因此当您阅读本文时,此列表可能不完整。
我可以用GlareDB做什么?
乍一看,你看到这个GlareDB会想,嘿,这看起来很像trino ( https://trino.io/ )因为它是一个联合查询引擎。
乍一看,它有点像MotherDuck, 原因有几个。首先,与 DuckDB 类似( 我第一眼也被骗了, 以为是哪里冒出来的“抄袭者” ),GlareDB 是一个单一、紧凑的可执行文件,但它是用 Rust 而不是 C++ 编写的。其次,它们也支持混合执行模型(MotherDuck 首先做了这个) ( https://motherduck.com/blog/announcing-motherduck-duckdb-in-the-cloud/ )。
鉴于 Trino 是用 Java 编写的,这意味着如果要使用它,你需要处理大量的 Java 生态系统。当然,市面上有一些预构建的 Docker 容器可以缩短这个过程,但通常情况下,如果你“只是想做点什么”,那么安装和设置 Trino 会很费劲。而使用 GlareDB,你只需下载一个可执行文件即可使用,或者直接使用他们的 SaaS 产品,首次使用时如下所示:
现在来谈谈混合执行。我将转述 GlareDB 在其博客文章中关于此主题的部分内容。假设您有一个 CSV 文件,其中包含使用其他工具从数据库中提取的用户 ID 列表。现在,您想使用数据库中的一些用户人口统计信息来丰富这些数据。假设我们的表名为 user_demo,CSV 文件名为 user_id.csv,我们的查询如下所示:
SELECT
m.user_id,
m.first_name,
m.last_name,
m.birth_date
FROM
user_demo m
INNER JOIN '/user_id.csv' u on m.user_id = u.id
GROUP BY m.user_id;
显然,这是一个简单的例子,但您可以对其进行增强,以便从其他已连接表中获取信息。您也可以反过来,假设您有一个包含关键字段的本地文件,其中包含您感兴趣的数据,您可以将这些数据连接到数据库中的某个表,而该文件中的额外数据在数据库中并不存在。这样做的好处是,您无需为这份临时报告创建新表并加载它,从而节省大量时间。
以上只是想让你快速了解一下 GlareDB 的功能和目前的发展情况。他们网站上的文档和博客写得非常出色,让你可以快速上手。
你怎么看? 欢迎留言说出你的观点!
马上快1万粉了,给粉丝们准备了一些小礼物。参与方法很简单:“关注本号及IF-Club的号、并在任何有本活动的文章下面留言”,sum(点赞数) group by uid order by sum desc limit 5的小伙伴将获得小礼物(每个uid每篇中只取最高点赞数的1条)。
到1万粉就开奖,冲鸭 ... ...
感谢 IF-Club社区赞助礼品,C姐最美。
记得关注:
都看到这了你我有缘, 加个微信? 如果你有国产数据库需求, 欢迎来撩.
讲真,随便哪家国产数据库,就没有我能勾搭的。