精选!专注于生物发展!博士被拒稿多次后终究登上顶刊,被评为“2025年生物领域顶刊TOP1”!
 pythonic生物人约 40 分钟
人工智能与多组学分析
深度学习基因组学
综合不同类型的生物数据对于全面了解癌症生物学至关重要,但由于数据的异质性、复杂性和稀少性,它仍然具有挑战性。针对这一点,我们的研究引入了一个无人监督的深层次学习模型MOSA(多组合成增强),专门设计来集成和增强癌症依赖性图(DEPMAP)。利用正交多组信息,该模型成功地生成了分子和表型谱,使多组谱增加了32.7%,从而生成了1523个癌细胞系的完整德普图。综合增强的数据增加了统计学的力量,揭示了较少研究的耐药性机制,并对癌细胞系的遗传相关性和聚类进行了改进.通过应用沙普利加性解释(Shap)进行模型解释,MOSA揭示了与药物和基因依赖性相关的细胞聚类和生物标记物识别所必需的多组特征。这一认识对于制定急需的有效战略以确定癌症目标的优先次序至关重要
癌症细胞系的分子和表型特征的增长使其成为研究最多的人类细胞模型之一。.这种不断增长和丰富的多组数据继续推动癌症基因的识别和治疗靶点的发现。虽然基因组学一直是癌症预测生物标志物研究的主要重点,但最近由癌症依赖关系图联合会进行的功能性基因筛查显示,不到20%的RNAI癌症依赖性可以通过突变和复制数量改变来解释。.这突出了开发能够垂直集成正交数据集的整体机器学习模型的重要性。在这种情况下,纵向整合不仅涉及基因组学,还涉及其他类型的OMIC数据
深度学习已经被广泛应用于基因组学研究中,利用已知的训练集对数据的类型和应答 结果进行预测 ,深度学习 ,可以进行预测和降维分析。深度学习模型的能力更强且更灵活, 在适当的训练数据下,深度学习可以在较少人工参与的情况下自动学习特征和规律。调控基 因组学,变异检测,致病性评分成功应用。深度学习可以提高基因组数据的可解释性,并将 基因组数据转化为可操作的临床信息。深度学习通过强大的深度神经网络模型从高维大数据 中自动挖掘数据潜在特征得以实现 ,过去 10 年 ,深度学习在计算机视觉、语音识别、 自然 语言处理领域取得了巨大成功。基因组学大数据与疾病表型间的复杂关系难以解析,运用深 度学习挖掘多组学数据探索复杂疾病致病机制及药物反应机制将会极大的提升精准医学和 转化医学的进度。,近两年国内外顶尖课题组 MIT、 Harvard University、 UPenn、清华大 学、复旦大学等都在从事深度学习基因组学的研究 ,这一研究成果更是多次发表在 Nature Reviews Genetics 、 Nature Methods 、 Science Advances 、 Cancer Cell 、 Nature、Biotechnology 等知名国际顶刊上 ,为我们发表顶刊鉴定了基础。
授课讲师
主讲老师来自荷兰博后陈老师授课。在国内外学术刊物发表论文数篇,包括Nature Communication, Cell Regeneration等知名期刊,研究方向主要为染色质三维结构,生物信息学,发育生物学和遗传学等。利用多组学数据,通过深度学习算法进行数据分析和挖掘,包括ChIP-seq,ATAC-seq,RNA-seq,CNV等,解决并回答领域内多个基础的生物学机制。
01
深度学习基因组学课表
第一天
理论部分
深度学习算法介绍
1.有监督学习的神经网络算法
1.1全连接深度神经网络DNN在基因组学中的应用举例
1.2卷积神经网络CNN在基因组学中的应用举例
1.3循环神经网络RNN在基因组学中的应用举例
1.4图卷积神经网络GCN在基因组学中的应用举例
2.无监督的神经网络算法
2.1自动编码器AE在基因组学中的应用举例
2.2生成对抗网络GAN在基因组学中的应用举例
实操内容
1.Linux操作系统
1.1常用的Linux命令
1.2 Vim编辑器
1.3基因组数据文件管理,修改文件权限
1.4查看探索基因组区域
2.Python语言基础
2.1.Python包安装和环境搭建
2.2.常见的数据结构和数据类型
第二天
理论部分
基因组学基础
1.基因组数据库
2.表观基因组
3.转录基因组
4.蛋白质组
5.功能基因组
实操内容
基因组常用深度学习框架
1.安装并介绍深度学习工具包tensorflow, keras,pytorch
2.在工具包中识别深度学习模型要素
2.1.数据表示
2.2.张量运算
2.3.神经网络中的“层”
2.4.由层构成的模型
2.5.损失函数与优化器
2.6.数据集分割
2.7.过拟合与欠拟合
3.基因组数据处理
3.1安装并使用keras_dna处理各种基因序列数据如BED、GFF、GTF、BIGWIG、BEDGRAPH、WIG等
3.2使用keras_dna设计深度学习模型
3.3使用keras_dna分割训练集、测试集
3.4使用keras_dna选取特定染色体的基因序列等
4.深度神经网络DNN在识别基序特征中应用
4.1实现单层单过滤器DNN识别基序
4.2实现多层单过滤器DNN识别基序
4.3实现多层多过滤器DNN识别基序
第三天
理论部分
卷积神经网络CNN在基因调控预测中的应用
1.Chip-Seq中识别基序特征G4,如DeepG4
2.Chip-Seq中预测DNA甲基化,DeepSEA
3.Chip-Seq中预测转录调控因子结合,DeepSEA
4.DNase-seq中预测染色体亲和性,Basset
5.DNase-seq中预测基因表达eQTL,Enformer
实操内容
复现卷积神经网络CNN识别基序特征DeepG4、非编码基因突变DeepSEA,预测染色体亲和性Basset,基因表达eQTL
1.复现DeepG4从Chip-Seq中识别G4特征
2.安装selene_sdk,复现DeepSEA从Chip-Seq中预测DNA甲基化,非编码基因突变
3.复现Basset,从Chip-Seq中预测染色体亲和性
4.复现Enformer,从Chip-Seq中预测基因表达eQTL
第四天
理论部分
深度学习在识别拷贝数变异DeepCNV、调控因子DeepFactor上的应用
1.SNP微阵列中预测拷贝数变异CNV,DeepCNV
2.RNA-Seq中预测premiRNA,dnnMiRPre
3.从蛋白序列中预测调控因子蛋白质,DeepFactor
实操内容
1.复现DeepCNV利用SNP微阵列联合图像分析识别拷贝数变异
2.复现循环神经网络RNN工具dnnMiRPre,从RNA-Seq中预测premiRNA
3.复现DeepFactor,从蛋白序列中识别转录调控因子蛋白质
第五天
理论部分
深度学习在识别及疾病表型及生物标志物上的应用
1.从基因表达数据中识别乳腺癌分型的深度学习工具DeepType
2.从高维多组学数据中识别疾病表型,XOmiVAE
3.基因序列及蛋白质相互作用网络中识别关键基因的深度学习工具DeepHE
实操内容
1.复现DeepType,从METABRIC乳腺癌数据中区分乳腺癌亚型
2.复现XOmiVAE,从TCGA多维数据库中识别乳腺癌亚型
3.复现DeepHE利用基因序列及蛋白质相互作用网络识别关键基因
通过课程学习您将得到
深入学习与了解深度学习基本框架与逻辑,同时掌握基本的生物信息学软件(Linux、R、python等)的使用,让学员能更好的应对基因组数据,挖掘出超越已有知识的新知识。而构建好的深度学习模型去探求新的研究思路和寻找新的潜在生物学机制,更好的服务于自身的科学研究和探索的过程中
机器学习代谢组学
授课讲师
主讲老师来自985高校神经科学博士,主要利用代谢组学、转录组学和分子生物学等技术研究神经内科慢性病的发病机制和生物标志物。擅长高效液相色谱-质谱联用(LC-MS)技术进行非靶向和靶向代谢组学从样本制备到数据分析的全流程研究,以及多组学大数据的生物信息学整合分析。5年内在J Clin Invest, EBioMedicine, Cell Death Dis, Cell Death Discov, Nanotoxicology等杂志发表SCI论文!
02
机器学习代谢组学课表
第一天上午
A1 代谢物及代谢组学的发展与应用
(1) 代谢与生理过程;
(2) 代谢与疾病;
(3) 非靶向与靶向代谢组学;
(4) 空间代谢组学与质谱成像(MSI);
(5) 代谢组学与药物和生物标志物;
(6) 代谢流与机制研究。
A2 代谢通路及代谢数据库
(1) 几种经典代谢通路简介;
(2) 三大常见代谢物库:HMDB 、METLIN 和 KEGG;
(3) 代谢组学原始数据库:Metabolomics Workbench 和 Metabolights. A3 参考资料推荐
第一天下午
A4 代谢组学实验流程简介
A5 色谱 、质谱硬件与原理解析
(1) 色谱分析原理与构造;
(2) 色谱仪和色谱柱的选择;
(3) 色谱的流动相:梯度洗脱法;
(4) 离子源、质量分析器与质量检测器解析;
(5) 质谱分析原理及动画演示;
(6) 色谱质谱联用技术(LC-MS);
第二天上午
B1 代谢物样本处理与抽提
(1) 各种组织、血液和体液等样本的提取流程与注意事项;
(2) 代谢物抽提流程与注意事项;
(3) 样本及代谢物的运输与保存问题;
B2 LC-MS 数据质控与搜库
(1) LC-MS 实验过程中 QC 和 Blank 样本的设置方法;
(2) LC-MS 上机过程的数据质控监测和分析;
(3) 代谢组学上游分析原理——基于 Compound Discoverer 与 Xcms 软件;
(4) Xcms 软件数据转换、提峰、峰对齐与搜库;
第二天下午
B3 R 软件基础
(1) R 和 Rstudio 的安装;
(2) Rstudio 的界面配置;
(3) R 中的基础运算和统计计算;
(4) R 中的包:包,函数与参数的使用;
(5) R 语言语法,数据类型与数据结构;
(6) R 基础画图;
B4 R 语言画图利器——ggplot2 包
(1) ggplot2 简介
(2) ggplot2 的画图哲学;
(3) ggplot2 的配色系统;
(4) ggplot2 数据挖掘与作图实战;
第三天上午
机器学习
C1 有监督式机器学习在代谢组学数据处理中的应用
(1) 人工智能、机器学习、深度学习的关系;
(2) 回归算法:从线性回归、Logistic 回归与 Cox 回归讲起;
(3) PLS-DA 算法:PCA 降维后没有差异的数据还有救吗?
(4) VIP score 的意义及选择;
(5) 分类算法:决策树,随机森林和贝叶斯网络模型;
C2 一组代谢组学数据的分类算法实现的 R 演练
(1) 数据解读;
(2) 演练与操作;
第三天下午
C3 无监督式机器学习在代谢组学数据处理中的应用
(1) 大数据处理中的降维;
(2) PCA 分析作图;
(3) 三种常见的聚类分析:K-means、层次分析与 SOM
(4) 热图和 hcluster 图的 R 语言实现;
C4 一组代谢组学数据的降维与聚类分析的 R 演练
(1) 数据解析;
(2) 演练与操作;
第四天上午
D1 在线代谢组分析网页 Metaboanalyst 操作
(1) 用 R 将数据清洗成网页需要的格式;
(2) 独立组、配对组和多组的数据格式问题;
(3) Metaboanalyst 中的上游分析(原始数据峰提取、峰对齐与搜库)
(4) Metaboanalyst 的 pipeline 以及参数设置和注意事项;
(5) Metaboanalyst 的结果查看和导出;
(6) Metaboanalyst 的数据编辑;
(7) 全流程演练与操作。
(8) 代谢联合多组学分析网页操作。
第四天下午
D2 代谢组学数据清洗与 R 语言进阶
(1) 代谢组学中的 t、fold-change 和响应值;
(2) 数据清洗流程;
(3) R 语言 tidyverse;
(4) 数据预处理:数据过滤与数据标准化(样本的 Normalization 和代谢物的 Scaling);
(5) 代谢组学数据清洗演练;
第五天上午
E1 文献数据分析部分复现(1 篇)
(1) 文献深度解读;
(2) 实操:从原始数据下载到图片复现;
(3) 学员实操。
第五天下午
E2 机器学习与代谢组学顶刊解读(3 篇);
(1) Signal Transduction and Targeted Therapy 一篇有关饥饿对不同脑区代谢组学影响变
化的小鼠脑组织代谢图谱类的文献;(数据库型)
(2) Cell 一篇代谢组学孕妇全程血液代谢组学分析得出对孕周和孕产期预测的代谢标志物
的文献;(生物标志物型)
(3) Nature 一篇对胰腺癌患者肠道菌群的代谢组学分析找到可以提高化疗效果的代谢物的
文献。(机制研究型)
通过课程学习您将得到
1. 熟悉代谢组学和机器学习相关背景知识以及硬件和软件;2. 入门 R 语言和机器学习理论和常规
使用;3. 掌握代谢组学从样本处理到上下游数据分析以及出图的全流程;4. 能复现 CNS 及其子
刊级别杂志中代谢组学相关文章中的图片;5. 能灵活熟练地分析自己的代谢组数据
机器学习微生物多组学联合分析
授课讲师
主讲老师Dr. Li,生物信息学博士,有十余年的测序数据分析经验。研究领域涉及机器学习,芯片数据分析,核酸及蛋白序列分析,宏基因组学,DNA,RNA,甲基化测序数据分析,单细胞测序数据分析,miRNA及靶基因分析,生存分析及预后模型构建等。具有丰富的培训经验,举办过线上线下培训50余场。培训内容涉及机器学习在生物医学中的应用,机器学习在微生物学中的应用,机器学习在蛋白组学中的应用,单细胞多组学数据挖掘,WGCNA共表达网络构建,ceRNA网络构建,R语言基础等。发表SCI论文30余篇,其中一作及并列一作15篇,h指数20
03
机器学习微生物多组学课表
第一天
微生物多组学简介
1.微生物学基本概念
2.微生物学常用分析介绍
3.代谢组学基本概念及检测方法
4.转录组学基本概念及检测方法
5.机器学习基本概念介绍
R语言简介及实操
1.R语言概述
2.R软件及R包安装
3.R语言语法及数据类型
4.条件语句
5.循环
6.函数
7.常用的机器学习和微生物多组学数据分析相关R包介绍
第二天
微生物多组学相关数据库介绍及数据检索
1.肠道微生物+代谢数据库
2.Curated Metagenomic Data
3.IBDMDB数据库
4.GEO数据库
微生物多组学应用案例分享
1.利用机器学习基于微生物组学+代谢组学数据预测样本类型
2.整合微生物组学数据和代谢组学数据鉴定疾病相关模块
3.肿瘤研究中微生物组学+宿主转录组学+免疫联合分析
4.基于微生物组学数据+转录组数组+代谢组数据纵向集成分析
第三天(实操)
零代码微生物多组学整合和网络可视化分析工具介绍和使用
1.数据上传(支持8种不同类型的数据,包括微生物,代谢,基因,蛋白等)
2.根据数据类型选择相应的数据库
3.构建网络
4.可视化
零代码微生物组-代谢组网络分析工具介绍和使用
1.构建菌群和代谢模型
2.使用代谢模型计算微生物对代谢物的贡献
3.计算群落水平的代谢潜能分值,使用回归模型评估潜能分值在不同样本中的差异
4.可视化特征微生物对特定代谢物的影响,并寻找关键微生物
零代码微生物组学和代谢组学相关性分析工具介绍和使用
第四天(实操+复现)
利用机器学习基于微生物组学+代谢组学数据预测样本类型
1.α-diversity,β-diversity分析
2.饮食与代谢物的动态关联分析
3.微生物组差异与疾病特异性分析
4.多组学因子分析
5.菌群功能与代谢表型关联分析
6.整合微生物组学数据和代谢组学数据预测样本类型
整合微生物组学和代谢组学数据鉴定疾病相关模块
1.微生物组学和代谢组学数据整合
2.鉴定疾病相关的多组学模块
3.模块交集分析
4.利用机器学习基于模块预测疾病状态
5.重要模块分析
第五天(实操+复现)
肿瘤研究中微生物组学,宿主转录组学和免疫联合分析
1.微生物组学分析
2.转录组学分析,差异表达基因鉴定
3.通过CCA方法对微生物组学数据和宿主转录组学数据进行关联分析
4.微生物免疫关联分析
基于微生物组学数据,转录组数组和代谢组数据纵向集成分析
1.肠道微生物组成分析
2.微生物组和代谢组联合分析
3.代谢组学和转录组学进行整合分析
4.微生物组-宿主互作分析
课程目标
1.了解微生物多组学相关概念
2.了解机器学习相关概念和常用的机器学习模型
3.了解R语言
4.掌握常用的微生物多组学数据分析以及机器学习相关R包的使用
5.掌握微生物组学/代谢组学/宿主转录组学联合分析思路和方法
6.复现SCI文章
通过课程学习您将得到
通过本次培训多个案例的系统讲解让参会学员学会机器学习在微生物组数据分析流程,通过机器学习微生物组学+代谢组学+转录组学联合分析让学员能够快速运用到自己的科研项目和课题上,能够实现文章快速发表
AIDD人工智能药物发现与设计顶刊复现
授课讲师
主讲老师来自天津大学,有十余年的计算机算法研究和程序设计经验。研究方向涉及生物信息学,深度学习,药物合成路径设计,药物不良反应等。发明专利5项,参与国家重点科研项目4项,发表SCI高水平论文10篇,包括BMC Bioinformatics, Journal of Biomedical Informatics, International Journal of Molecular Sciences等知名期刊
04
AIDD课表
第一天
环境搭建与深度学习基本知识讲解
1.AIDD概述:从CADD到AIDD
2.软件安装与环境搭建
(1)anaconda
(2)vscode
(3)环境变量的配置
(4)切换pip和conda镜像源
(5)虚拟环境的创建
3.RDKIT工具包的使用
(1)基于RDKit的分子读写
(2)基于RDKit的分子绘制
(3)基于RDKit的分子指纹与分子描述符
(4)基于RDKit的化合物相似性与子结构
4.药物综合数据库的获取方法
(1)基于requests的基本爬虫操作
(2)小分子数据库PubChem数据获取(pubchempy / requests)
(3)蛋白质数据库PDB、UniProt数据获取
5.深度学习辅助药物设计
(1)神经网络基本概念与sklearn工具包介绍
(2)图神经网络与消息传递机制基本知识
(3)Transformer模型基本知识:分词、位置编码、注意力机制、编码器、解码器、预训练-微调框架、huggingface 生态介绍
(4)模型的评估与验证:准确率、精确率、召回率、F1分数、ROC曲线、AUC计算,平均绝对误差、均方差、R2分数、可释方差分数,交叉验证等
第二天
顶刊复现专题1——分子与生化反应的表示学习与性质预测助力药物发现
培训背景:在人工智能辅助药物发现(AIDD)中,分子与生化反应的表示学习与性质预测是整个研究流程的基石。分子的结构决定其功能,如何将复杂的分子结构和生化反应过程有效地表示为计算模型能够理解的形式,是实现高效预测和优化的前提。通过构建合理的分子表示(如图神经网络、SMILES编码、指纹等),我们可以让AI模型捕捉关键的化学特征,进而用于预测分子的物理化学性质、生物活性、毒性等,为后续的虚拟筛选、分子生成与反应设计提供可靠基础。因此,本专题不仅奠定了AIDD中建模与预测能力的核心能力框架,也为整个药物发现过程中的智能决策打下了坚实基础。
培训内容1:
Nature Machine Intelligence|基于注意力的神经网络在化学反应空间映射中的应用《Mapping the space of chemical reactions using attention-based neural networks》
1.数据集
1.1.Pistachio数据集:包含260万化学反应,来自专利数据,涵盖792个反应类别。数据经过去重和有效性过滤(使用RDKit)。
1.2.USPTO 1k TPL数据集:基于USPTO专利数据,包含44.5万反应,通过原子映射和模板提取生成1,000个反应模板类别。
1.3.Schneider 50k数据集:公开数据集,包含5万反应,50个类别,用于与传统指纹方法对比。
2.模型。研究对比了两种Transformer架构:
2.1.BERT分类器:基于编码器的模型,通过掩码语言建模预训练后,在分类任务上微调,使用[CLS]标记的嵌入作为反应指纹(rxnfp)。
2.2.Seq2Seq模型:编码器-解码器结构,将分类任务分解为超类、类别和具体反应的层级预测。两者均采用简化版BERT(隐藏层256维),输入为未标注的SMILES序列,无需反应物-试剂区分或原子映射。
3.训练。模型训练分为两步:
3.1.预训练:BERT通过掩码SMILES令牌预测任务进行自监督学习,学习反应通用表示。
3.2.微调:在分类任务上优化模型,使用交叉熵损失,学习率2×10⁻⁵,序列长度512。评估采用混淆熵(CEN)和马修斯相关系数(MCC)以处理数据不平衡。
培训内容2:
TOP期刊|基于深度学习的生化反应产量预测《Prediction of chemical reaction yields using deep learning》
1.数据。研究使用了三类数据:
1.1.Buchwald-Hartwig HTE数据集:包含3955个Pd催化C-N偶联反应,涵盖15种卤化物、4种配体、3种碱和23种添加剂组合,产率通过统一实验测量,数据质量高。
1.2.Suzuki-Miyaura HTE数据集:包含5760个反应,涉及15对亲电/亲核试剂、12种配体、8种碱和4种溶剂的组合,产率分布均匀。
1.3.USPTO专利数据集:从公开专利中提取,包含不同规模(克级与亚克级)的反应产率,数据噪声大且分布不一致,需通过邻近反应产率平滑处理以提升模型表现。
2.模型。核心模型基于预训练的rxnfp(反应指纹)BERT架构,新增回归层构成Yield-BERT。输入为标准化反应SMILES,通过自注意力机制捕捉反应中心及关键试剂的上下文信息。模型无需手工特征(如DFT计算描述符),直接端到端预测产率。实验表明,其性能优于传统方法(如随机森林和分子指纹拼接),尤其在HTE数据上接近化学描述符的预测水平,且参数鲁棒性高(超参数调整影响小)。
3.训练。训练分为两步:
3.1.预训练:BERT通过掩码语言任务学习SMILES的通用表示。
3.2.微调:采用简单Transformers库和PyTorch框架,以MSE损失优化回归层,学习率(2×10⁻⁵)和dropout率(0.1–0.8)为主要调参对象。HTE数据采用随机/时间划分验证,USPTO数据通过邻近反应产率平滑缓解噪声影响。小样本实验(5%训练数据)显示模型能快速筛选高产反应,指导合成优化。
培训内容3:
TOP期刊|基于T5Chem模型的生化反应表示学习与性质预测: 《Unified Deep Learning Model for Multitask Reaction Predictions with Explanation》
1.数据来源和处理。通过自监督预训练与PubChem分子数据集进行训练,以实现对四种不同类型的化学反应预测任务的优异性能。模型处理包括反应类型分类、正向反应预测、单步逆合成和反应产率预测。
2.模型架构和原理。T5Chem模型是基于自然语言处理中的“Text-to-Text Transfer Transformer”(T5)框架开发的统一深度学习模型,该模型通过适应T5框架来处理多种化学反应预测任务。T5Chem模型包含编码器-解码器结构,并根据任务类型引入了任务特定的提示和不同的输出层,如分子生成头、分类头和回归头,以处理序列到序列的任务、反应类型分类和产品产率预测。
3.训练过程和细节。
3.1.T5Chem模型首先在PubChem的97 million分子上进行自监督预训练,使用BERT类似的“masked language modeling”目标。
3.2.在预训练阶段,源序列中的tokens被随机掩蔽,模型的目标是预测被掩蔽的正确的tokens。
3.3.预训练完成后,模型在下游的监督任务中进行微调,使用不同的任务特定提示和输出层。
3.4.模型在测试阶段通过生成分子token by token的方式进行预测,直到生成“句子结束标记”或达到最大预测长度。
第三天
顶刊复现专题2——蛋白质的表示学习与性质预测助力药物发现
培训背景:在AIDD中,蛋白质是药物作用的主要靶标,其结构与功能的复杂性决定了药物设计的成败。蛋白质的表示学习与性质预测是理解分子-靶点相互作用、发现候选药物的重要环节。蛋白质,尤其是酶,作为药物的主要作用靶点,其功能、结构与动力学性质直接影响药物的设计与效果。本专题通过两篇前沿研究工作展开讲解:*《Enzyme function prediction using contrastive learning》展示了如何利用对比学习从蛋白质序列中提取高质量的功能表征,实现对酶功能的精确预测;《CatPred》*则提出了一个整合性深度学习框架,用于体外酶动力学参数(如Km、kcat等)的预测,这对于建立药效模型与优化先导化合物至关重要。这些方法显著提升了蛋白质建模的准确性与泛化能力,为AI驱动的靶点发现、机制理解及候选药物筛选提供了强有力的支持。
培训内容1:
Nature Communication|体外酶动力学参数深度学习的综合框架《CatPred: a comprehensive framework for deep learning in vitro enzyme kinetic parameters》
CatPred 提出了一种全面的深度学习框架,用于预测体外酶动力学参数(kcat、Km、Ki),以解决实验测定成本高、数据稀疏和泛化能力差的问题。该方法不仅提供了准确的预测,还引入了对预测不确定性的量化,支持对训练集外(out-of-distribution)酶序列的稳健预测。此外,作者还构建了新的标准化数据集(CatPred-DB),并对多种酶表示方法进行了系统比较。
1.数据:CatPred 使用的数据集来自 BRENDA 和 SABIO-RK 数据库,作者构建了 CatPred-DB,包括:23197 条 kcat,41174 条 Km和11929 条 Ki 数据,每条记录都包含酶的氨基酸序列、AlphaFold 或 ESMFold 预测的结构、底物的 SMILES 表达式。数据经过清洗和标准化处理,去除缺失值和重复值,并对参数取对数转换以符合正态分布。
2.模型:CatPred 采用模块化设计,酶和底物分别通过不同的神经网络模块进行表征学习,并采用 概率回归 输出(高斯分布形式的均值和方差),允许进行 不确定性估计(aleatoric + epistemic)。
3.训练
3.1.所有模型采用负对数似然损失函数(NLL)训练,以同时预测参数均值和不确定性。
3.2.使用训练-验证-测试三分法(80%-10%-10%),并设立“训练集外”的测试子集用于泛化能力评估。
3.3.为了评估不确定性,CatPred 使用 10个模型的集成,通过不同初始参数训练,以此量化 epistemic uncertainty。
3.4.模型训练时考虑了不同相似性(序列identity<99%、80%、60%、40%)的测试集,体现其鲁棒性。
培训内容2:
Science|基于对比学习的蛋白质分类属性预测《Enzyme function prediction using contrastive learning》
1.数据来源和处理: CLEAN模型的训练基于UniProt数据库中的高质量数据,该数据库收录了约1.9亿个蛋白质序列。CLEAN模型以氨基酸序列作为输入,输出按可能性排序的酶功能列表(以EC编号为例)。为了验证CLEAN的准确性和鲁棒性,作者进行了广泛的in silico实验,并将CLEAN应用于内部收集的未表征的卤酶数据库(共36个)进行EC编号注释,随后通过案例研究进行体外实验验证。
2.模型架构和原理: CLEAN模型采用了对比学习框架,目标是学习一个酶的嵌入空间,其中欧几里得距离反映了功能相似性。嵌入是指蛋白质序列的数值表示,它由机器可读,同时保留了酶携带的重要特征和信息。在CLEAN的任务中,具有相同EC编号的氨基酸序列具有较小的欧几里得距离,而具有不同EC编号的序列则具有较大的距离。
3.训练过程和细节:
3.1.在训练过程中,CLEAN模型使用对比损失函数进行监督训练,通过优先选择与锚点(anchor)嵌入具有小欧几里得距离的负序列,以提高训练效率。
3.2.模型使用语言模型ESM1b获得的蛋白质表示作为前馈神经网络的输入,输出层产生细化的、功能感知的输入蛋白质嵌入。
3.3.预测时,通过计算查询序列与所有EC编号聚类中心之间的成对距离来预测输入蛋白质的EC编号。
3.4.CLEAN还开发了两种方法来从输出排名中预测自信的EC编号:一种是贪婪方法,另一种是基于P值的方法。
第四天
顶刊复现专题3——基于深度学习的分子生成助力药物发现
培训背景:分子生成是化学、生物学和材料科学等领域的关键技术,对于新药开发、新材料设计和化学反应预测具有重要意义。传统的分子生成方法依赖于专家知识和试错实验,耗时且成本高昂。随着人工智能技术的发展,特别是自然语言处理和扩散模型在分子生成中的应用,我们现在能够利用计算模型来加速这一过程。本课程将介绍从NLP到扩散模型的设计模式,这些模型能够理解和生成分子结构,从而提高分子设计的效率和准确性。通过本课程的学习,参与者将能够掌握分子生成的最新技术和方法,以及如何将这些技术应用于实际问题。
培训内容1:
Nature Communication|基于端到端的图生成框架的分子生成:《Retrosynthesis prediction using an end-to-end graph generative architecture for molecular graph editing》
1.数据来源和处理:Graph2Edits模型使用了公开可用的基准数据集USPTO-50k,包含50016个反应,这些反应被正确地原子映射并分类为10种不同的反应类型。数据集被分为40k、5k、5k的反应用于训练、验证和测试集。
2.模型架构和原理:Graph2Edits模型是一个端到端的图生成架构,基于图神经网络(GNN)预测产品图的编辑序列,并根据预测的编辑序列顺序生成中间体和最终反应物。该模型将半模板方法的两阶段过程(识别反应中心和完成合成子)合并为一锅学习,提高了在复杂反应中的适用性,并使预测结果更易于解释。模型的核心是图编码器和自回归模型,用于生成编辑序列,并应用这些编辑来推断中间体和反应物。
3.训练过程和细节:
3.1.Graph2Edits模型使用有向消息传递神经网络(D-MPNN)作为图编码器,以获取原子表示和全局图特征,并预测原子/键编辑和终止符号。
3.2.模型训练使用教师强制策略,即使用真实的编辑序列作为模型输入。在每个编辑步骤中,模型会计算所有可能的编辑的概率,并选择最高分的k个编辑,将这些编辑应用于输入图以获得k个中间体。
3.3.在生成过程中,如果达到最大步骤数或图表示指示终止,则生成分支将停止。
3.4.最终,根据可能性对前k个编辑序列和图进行排名,收集为最终预测结果。
培训内容2
Nature Computational Science|基于等变扩散模型的分子生成网络《Structure-based drug design with equivariant diffusion models》
1.简单介绍。这篇文献提出了一种基于结构的药物设计方法(SBDD),利用SE(3)-等变扩散模型(DiffSBDD)生成与蛋白质结合口条件匹配的新颖小分子配体。该方法通过将SBDD问题建模为三维条件生成任务,能够一次性生成所有原子位置,克服了传统自回归方法因顺序生成而丢失全局上下文的局限性。DiffSBDD不仅支持从头分子设计,还能通过属性优化、负向设计和分子局部修饰(inpainting)等多种任务灵活应用。
2.数据总结。该研究使用了CrossDocked和Binding MOAD两个数据集进行训练和评估。
2.1.CrossDocked数据集包含40,344个训练蛋白-配体对和130个测试对,验证集规模为246个,确保不同集合中的蛋白质来自不同的酶分类主类以避免过拟合。
2.2.Binding MOAD数据集经过筛选后用于测试,分析限于所有方法均能生成样本的78个CrossDocked和119个Binding MOAD目标。此外,数据集处理涉及移除损坏条目,并通过Zenodo公开提供处理后的数据和采样分子,确保研究可重复性。
3.模型总结。DiffSBDD是一个SE(3)-等变扩散模型,以蛋白质结合口为条件生成三维分子结构,采用3D图表示(原子坐标和类型),避免了传统方法中从密度图回推分子结构的复杂后处理。模型设计尊重三维空间的旋转和平
第五天
顶刊复现专题4: 结合分子动力学的蛋白质-配体复合物相互作用动态预测
培训背景:蛋白质-配体相互作用的预测是现代药物发现和生物工程领域的核心任务之一,其重要性不言而喻。在药物开发过程中,准确预测蛋白质与小分子配体的结合位点、三维结构以及亲和力,不仅能够揭示分子间相互作用的机制,还能显著加速候选药物的筛选与优化,降低研发成本和时间。传统实验方法如X射线晶体学和核磁共振虽然精确,但耗时长、成本高,且难以应对大规模筛选需求。而随着深度学习和人工智能技术的快速发展,计算方法在蛋白质-配体预测中展现出巨大潜力。
研究内容1:
Nature Communication|交互作用感知的蛋白质-配体对接和亲和力预测模型《Interformer: an interaction-aware model for protein-ligand docking and affinity prediction》
1.简要介绍:本研究提出了一种名为Interformer的基于Graph-Transformer架构的统一模型,用于蛋白-配体对接和亲和力预测。针对现有深度学习模型忽略蛋白与配体原子间非共价相互作用建模的不足,Interformer引入了交互感知混合密度网络(MDN)来明确捕捉氢键和疏水相互作用,并结合负采样策略和伪Huber损失函数,通过对比学习优化相互作用分布,提升对接姿势的准确性和亲和力预测的鲁棒性。
2.数据集:研究使用了PDBBind时间分割测试集(333个样本)评估对接准确性,Posebusters基准测试验证物理合理性,以及内部真实世界数据集测试泛化能力。训练数据来源于PDBBind晶体结构数据库。
3.模型:Interformer基于Graph-Transformer架构,包括:(1) 图表示模块,将原子作为节点、邻近关系作为边;(2) 掩码自注意力(MSA)机制,通过Intra-Blocks和Inter-Blocks分别捕捉配体/蛋白内部及两者间的相互作用;(3) 交互感知MDN,融合四种高斯分布模拟常规力、疏水作用和氢键;(4) 边缘输出层整合节点和边特征预测能量;(5) 姿势评分和亲和力模块基于虚拟节点预测正确姿势和实验亲和力值。
4.训练细节:训练分两阶段:首先基于晶体结构训练能量模型生成负样本,随后联合正负样本训练姿势评分和亲和力模型。采用负对数似然损失优化MDN,二元交叉熵损失优化姿势评分,伪Huber损失(σ=4)优化亲和力预测(单位IC50、Kd、KI,经负对数归一化)。蒙特卡洛采样生成候选姿势,
研究内容2:
Nature Communication|分子动力学驱动的蛋白质-配体复合物结构动态预测《DynamicBind: predicting ligand-specific protein-ligand complex structure with a deep equivariant generative model》
1.简单介绍:本研究提出了一种名为DynamicBind的深度学习方法,用于预测配体特异性的蛋白-配体复合物结构。传统分子对接方法通常将蛋白视为刚性或仅部分柔性,难以处理蛋白的大尺度构象变化,而分子动力学模拟虽然能捕捉动态构象,但计算成本高昂。DynamicBind通过等变几何扩散网络构建平滑的能量景观,高效模拟蛋白从无配体(apo)状态到配体结合(holo)状态的构象转变,无需依赖holo结构或大量采样。
2.数据集:研究基于PDBbind2020数据库(19,443个蛋白-配体复合物晶体结构),按时间划分:2019年前的数据用于训练和验证,2019年的数据用于测试。额外构建了Major Drug Targets (MDT)测试集(599对),聚焦激酶、GPCR等主要药物靶点,要求AlphaFold预测结构与晶体结构的pocket RMSD>2Å,确保测试难度。训练中通过AlphaFold预测结构与晶体结构插值生成蛋白部分的样本。
3.模型:DynamicBind是一个基于图神经网络的等变生成模型,使用粗粒化表示(蛋白以Cα节点和侧链二面角表示,配体以重原子节点表示),输出包括蛋白和配体的平移、旋转、扭转角更新,以及结合亲和力和cLDDT置信度评分。模型通过学习从apo到holo的“morph-like”变换,优化能量景观,包含63.67百万参数。
4.训练细节:训练在8块Nvidia A100 80GB GPU上进行5天,输入为添加morph变换的蛋白decoy构象和加高斯噪声的配体构象,目标是去噪操作。损失函数包括八项(配体和蛋白的平移、旋转、扭转等),通过Kabsch算法对齐apo和holo结构,结合扩散噪声调整构象过渡。推理时迭代20次更新初始结构。
通过课程学习您将得到
本次培训主要掌握深度学习在化学反应预测中的应用,应用于真实药物研发场景的思维框架建立从蛋白质建模到下游任务(如药物筛选、作用机制分析)的系统性理解,增强将AI方法应用于实际生物医药问题的能力,自然语言处理(NLP)在分子生成中的应用 ,扩散模型在分子生成中的应用,通过案例分析(如Interformer筛选出高亲和力小分子),学习如何将这些预测技术应用于酶工程和药物发现,加速候选分子的筛选和优化
以下为免费录播课!报名直播课可全部赠送
01
第一天
机器学习及生物医学中应用简介
1. 机器学习及生物医学中应用简介
2. 机器学习基本概念介绍
3. 常用机器学习模型介绍(GLM,BF,SVM)
4. 主成分分析(PCA)
5. 一致性聚类分析
6. ROC曲线和时间依赖的ROC曲线
7. 生存分析基本概念介绍(生存曲线)
8. 预后模型介绍(单因素,多因素cox回归,lasso回归)
1. R语言简介
1.1 R语言概述
1.2 R软件及R包安装
1.3 R语言语法及数据类型
2. 条件语句
2.1 循环
2.2 函数
3. 常用的机器学习相关的R包介绍
第二天
机器学习在生物医学中的应用案例分享
1. 机器学习在生物医学中的应用案例分享
1.1 利用机器学习方法筛选疾病相关的生物标志物
2. 机器学习+生存分析预测患病风险
2.1 机器学习+生存分析预测患者预后
3. 常用生物医学公共数据库介绍
3.1 TCGA数据库介绍
3.2 TCGA数据库下载RNAseq,miRNA-seq数据
3.3 TCGA临床数据下载
3.4 合并TCGA表达谱数据
4. GEO数据库介绍
4.1 GEO数据库检索
4.2 GEO数据下载
第三天
机器学习应用于TCGA公共数据,复现科研文章
1. 机器学习应用于TCGA公共数据,复现科研文章
1.1 差异表达分析
1.2 主成分分析(PCA)
1.3 火山图,热图绘制
1.4 GO和KEGG富集分析,柱形图,气泡图绘制
2.生存分析,生存曲线绘制
2.1 一致性聚类分析(ConsensusClusterPlus)
2.2 训练集,测试集拆分
3. R语言简介
3.1 单因素,多因素cox分析
3.2 Lasso回归分析
4.风险评估模型构建
5.riskscore计算
6.Nomogram模型构建
6.1时间依赖ROC曲线(Time-dependent ROC)
6.2 矫正曲线,决策曲线绘制
第四天
机器学习应用于GEO公共数据,复现科研文章
1. 机器学习应用于GEO公共数据,复现科研文章
1.1 差异表达分析
1.2 主成分分析(PCA)
1.3 构建预测模型(SVM,RF,GLM)
2. 特征筛选及重要性评估
2.1 模型评估(ROC曲线绘制)
3. 构建nomogram模型
3.1 矫正曲线绘制
3.2 决策曲线绘制
4. 一致性聚类分析
4.1 GSEA分析
第五天
ceRNA网格构建
1.miRNA
2.circRNA
3.lncRNA的产生,作用机制,功能
4.miRNA,circRNA,lncRNA相关数据库及工具介绍,使用及数据下载
5.ceRNA案例分享
实操内容:
1.ceRNA网络构建(实操,基于R)
2.差异mRNA,lncRNA,miRNA分析
3.火山图,热图,聚类图,柱状图
4.差异表达基因GO,KEGG富集分析,气泡图,柱状图,KEGG通路图展示
5.生存分析,生存曲线绘制
6.mRNA,lncRNA表达相关性分析,相关性散点图
7.mRNA, lncRNA, miRNA网络构建
8.cytoscape展示,hub基因筛选
学员提问及讨论
部分案例图片
可以上下滚动查看
02
第一天
理论内容:
1.单细胞组学研究简介
2.单细胞转录组测序技术进展及其原理:1992\2009-至今
3.单细胞多组学和空间转录组技术;
4.单细胞转录组测序技术的常见应用和重要生物学发现;
5.单细胞重大项目及数据库介绍。
实操内容:
1. Linux命令入门讲解及实操训练。
2. R语言简介及安装。
3. R语言简单语法及常见命令。
4. 数据挖掘及其统计应用。
5. R语言实操画图ggplot2为主。
第二天
理论内容:
1. 单细胞实验介绍,常见建库结构(以10*建库为例)。
2. 单细胞转录组Pipeline软件和代码介绍。
3. 单细胞转录组转录因子及其细胞通讯介绍。
4. 单细胞组学在肿瘤、发育、免疫及其它等领域的研究思路。
实操内容:
1. 10X官方单细胞软件Cellranger讲解及实操。
2.质控基因和细胞。
3.选取高可变基因。
4.降维与分群。
5.Biomarker定义细胞类型。
6.寻找差异基因
7. 通过Seurat 合并多样本及消除样本异质性:
8.通过harmony合并多样本及其消除样本异质性。
第三天
实操内容;
1. 通过Monocle软件对单细胞转录组进行拟时序的分析。
2. 对单细胞各个簇进行通路的功能富集分析。
3. 通过GSVA给细胞通路打分等。
4. 利用cellphonedb软件对细胞互作进行分析。
5. 讲解单细胞WGCNA,利用关联共表达找到某些细胞中有关联作用的基因list(也就是模块)。
6. 全面解析SCENIC软件进行转录因子预测分析。
理论内容:
1. 空间转录组技术的介绍。
2. 空间转录组技术的应用。
3. 空间转录组文章图表的解读。
4. 空间转录组技术在癌症、发育、神经科学等领域的研究思路。
第四天
空间转录组数据比对、降维以及聚类等分析
空间转录组多样本及与单细胞数据关联分析
实操内容:
1. 10x Visium 组织优化及文库制备。
2. 10x Visium官方分析软件Space Ranger讲解及实操。
3. Space Ranger输出结果解读。
4. Loupe Browser软件安装及使用。
5. 通过Seurat软件进行降维、聚类和可视化。
6. 通过Seurat进行基因表达可视化。
理论+实操内容
1. 通过Seurat进行空间变量特征的识别。
2. 与单细胞数据关联分析(空间细胞类型定义)
3. 通过Seurat处理多个切片。
4.单细胞及空间转录组数据分析总结。
可以上下滚动查看
03
第一天(背景知识)
二代基因组测序技术原理
三代基因组测序技术原理
Hi-C 技术测序技术原理
基因组测序策略
基因组的评估标准
基因组学的研究进展
比较基因组学的概念与分析方法
常用数据库的介绍与使用
Linux 操作系统介绍 Linux 常用命令
第二天
基因组 Survey 分析
基因组的 de novo 组装
Hi-C 数据挂载、染色体级别基因组的组装
基因组组装结果的评估
重复序列注释
基因组结构注释之同源注释法
基因组结构注释之从头注释法
基因组结构注释之 RNA-seq 法
ncRNA 注释
基因组功能注释
第三天
第三天(比较基因组学分析)
基因组数据的准备
蛋白序列比对
基因家族聚类 Single-copy tree的构建
物种分歧时间
基因家族扩张/收缩分析
基因家族的富集分析
串联法构建全基因组树
第四天
ASTRAL分析
Densitree基因多序列比对
正选择分析
基因组共线性分析
Circos plot的绘制
SNP calling
SV的检测与注释
CNV的检测与注释
PAV的检测与注释
可以上下滚动查看
04
第一天
1.机器学习基本概念介绍
2.常用机器学习模型介绍
3.混淆矩阵
4.ROC曲线
5.主成分分析(PCA)
6.蛋白组学基本概念
R语言简介及实操
1.R语言概述
2.R软件及R包安装
3.R语言语法及数据类型
4.条件语句
5.循环
6.函数
7.常用的机器学习相关R包介绍
第二天
1.利用机器学习鉴定疾病相关蛋白标志物
2.利用机器学习基于蛋白组学数据预测表型
3.利用机器学习基于蛋白组学数据进行分类
4.利用机器学习基于蛋白组学数据构建预后模型
蛋白组学相关数据库介绍
1.Uniport
2.HPA
3.TCPA
4.CPTAC
第三天:零代码工具利用机器学习分析蛋白组学数据
利用PLOS Computational Biology(IF:5分)发表零代码工具,轻松完成差异表达分析,常见统计分析,常见可视化,内置7种机器学习方法,轻松调用。
1.数据导入(两套数据,二分类,多分类)
2.数据可视化(散点图,热图,柱形图,相关性热图,火山图,层次聚类图)
3.缺失值填充
4.数据归一化
5.离群值检测/清理
6.常见统计方法应用(t-test, limma, Kruskal-Wallis ,ANOVA, PCA, k-means, 相关性分析)
7.机器学习方法应用(RF, lasso, SVM等)
第四天
利用机器学习基于蛋白组学数据预测表型,基于蛋白组学数据复现cell中机器学习分析结果
实操内容
1.蛋白组学数据处理,差异表达分析
2.火山图,多分组热图,多组箱型图展示差异表达分析结果
3.构建Random Forest模型
4.重要蛋白筛选
5.绘制ROC曲线
6.独立测试集检测模型表现
利用机器学习鉴定疾病相关蛋白标志物,基于Olink数据,复现影响因子17分文章中,蛋白数据常规分析+时序蛋白聚类分析+机器学习分析结果
实操内容
1.读取蛋白表达数据
2.差异蛋白挑选,火山图绘制,箱型图绘制
3.时序蛋白表达数据聚类分析
4.构建随机森林模型
5.挑选重要特征
6.独立测试集进行验证
第五天
实操内容
1.鉴定与不同肝病显著相关的蛋白
2.比较22种不同的机器学习分类器,挑选最优算法构建不同肝病的分类模型
3.独立队列验证模型准确性
4.构建预后模型
5.绘制生存曲线和时间依赖的ROC曲线
可以上下滚动查看
授课时间


01.深度学习基因组学
2025.07.26--2025.07.27(09:00-11:30)-(13:30-17:00)
2025.08.02--2025.08.03 (09:00-11:30)-(13:30-17:00)
2025.08.09 (09:00-11:30)-(13:30-17:00)
02.机器学习代谢组学
2025.07.29--08.01 (19:00-22:00)
2025.08.05-2025.08.08 (19:00-22:00)
2025.08.09 (09:00-11:30)-(13:30-17:00)
03.机器学习微生物多组学联合分析
2025.09.06--2025.09.07(09:00-11:30)-(13:30-17:00)
2025.09.13--2025.09.14 (09:00-11:30)-(13:30-17:00)
2025.09.20 (09:00-11:30)-(13:30-17:00)
04.AIDD人工智能药物发现设计顶刊复现
2025.09.06--2025.09.07(09:00-11:30)-(13:30-17:00)
2025.09.13--2025.09.14 (09:00-11:30)-(13:30-17:00)
2025.09.20 (09:00-11:30)-(13:30-17:00)
腾讯会议直播上课 课后提供直播回放

培训费用


课程报名费用:
深度学习基因组学、机器学习代谢组学、机器学习微生物多组学联合分析
公费价:每人每班¥4980元 (含报名费、培训费、资料费)
自费价:每人每班¥4680元 (含报名费、培训费、资料费)
AIDD:
公费价:每人每班¥5880元 (含报名费、培训费、资料费)
自费价:每人每班¥5580元 (含报名费、培训费、资料费)
重磅优惠:
优惠1:
报二送一(同时报名两个班免费赠送一个学习名额赠送班任选)
两班同报:10880元 (可学习三个直播课)
三班同报:14880元 (可学习四个直播课)
四班同报:18880元 (可免费学习一整年本单位举办的任意课程)
特惠2:28880元(可免费学习两整年本单位举办的任意课程)
优惠3:提前报名缴费可享受300元优惠(仅限十五名)
特惠福利:报一送二、报二增四(额外送的回放)(包含全套课程回放和课件资料ppt)

培训特色及福利 
1、课程特色--全面的课程技术应用、原理流程、实例联系全贯穿
2、学习模式--理论知识与上机操作相结合,让零基础学员快速熟练掌握
3、课程服务答疑--主讲老师将为您实际工作中遇到的问题提供专业解答
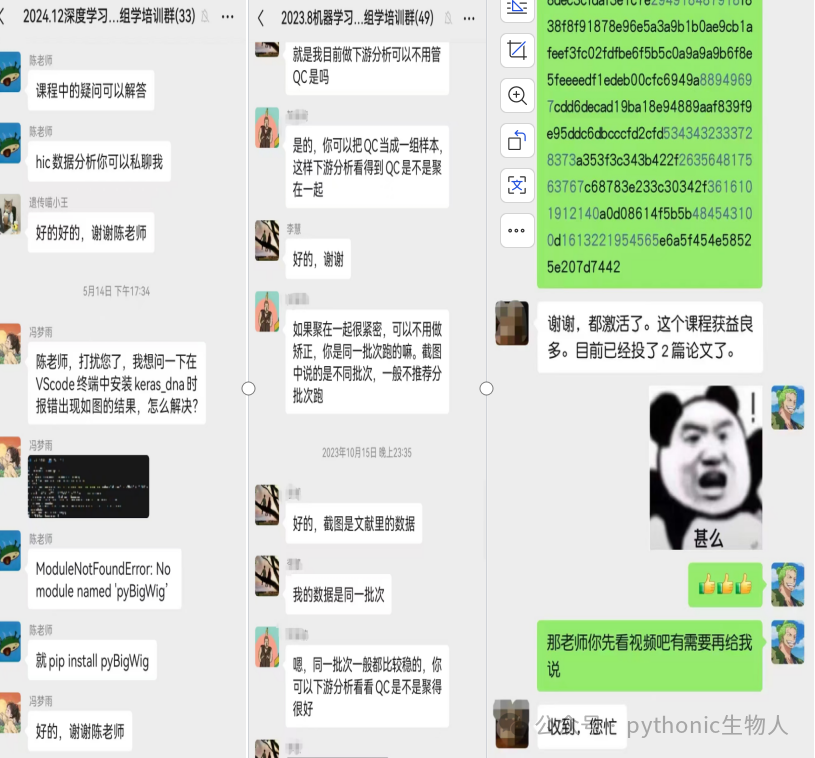
授课方式:通过腾讯会议线上直播,理论+实操的授课模式,老师手把手带着操作,从零基础开始讲解,电子PPT和教程开课前一周提前发送给学员,所有培训使用软件都会发送给学员,有什么疑问采取开麦共享屏幕和微信群解疑,学员和老师交流、学员与学员交流,培训完毕后老师长期解疑,培训群不解散,往期培训学员对于培训质量和授课方式一致评价极高!
腾讯会议实时直播解答|手把手带着操作
报名咨询方式(请二维码扫描下方微信) 
联系人:江老师 报名电话:13017692038
( 微信同号)
引用往期参会学员的一句话: 发现真的是脚踏实地的同时 需要偶尔仰望星空
非常感谢各位对我们培训的认可! 祝愿各位心想事成!
授课时间
01.深度学习基因组学
2025.07.26--2025.07.27(09:00-11:30)-(13:30-17:00)
2025.08.02--2025.08.03 (09:00-11:30)-(13:30-17:00)
2025.08.09 (09:00-11:30)-(13:30-17:00)
02.机器学习代谢组学
2025.07.29--08.01 (19:00-22:00)
2025.08.05-2025.08.08 (19:00-22:00)
2025.08.09 (09:00-11:30)-(13:30-17:00)
03.机器学习微生物多组学联合分析
2025.09.06--2025.09.07(09:00-11:30)-(13:30-17:00)
2025.09.13--2025.09.14 (09:00-11:30)-(13:30-17:00)
2025.09.20 (09:00-11:30)-(13:30-17:00)
2025.09.06--2025.09.07(09:00-11:30)-(13:30-17:00)
2025.09.13--2025.09.14 (09:00-11:30)-(13:30-17:00)
2025.09.20 (09:00-11:30)-(13:30-17:00)
2025.09.06--2025.09.07(09:00-11:30)-(13:30-17:00)
2025.09.13--2025.09.14 (09:00-11:30)-(13:30-17:00)
2025.09.20 (09:00-11:30)-(13:30-17:00)
04.AIDD人工智能药物发现设计顶刊复现
2025.09.06--2025.09.07(09:00-11:30)-(13:30-17:00)
2025.09.13--2025.09.14 (09:00-11:30)-(13:30-17:00)
2025.09.20 (09:00-11:30)-(13:30-17:00)
2025.09.06--2025.09.07(09:00-11:30)-(13:30-17:00)
2025.09.13--2025.09.14 (09:00-11:30)-(13:30-17:00)
2025.09.20 (09:00-11:30)-(13:30-17:00)
腾讯会议直播上课 课后提供直播回放
培训费用
课程报名费用:
深度学习基因组学、机器学习代谢组学、机器学习微生物多组学联合分析
公费价:每人每班¥4980元 (含报名费、培训费、资料费)
自费价:每人每班¥4680元 (含报名费、培训费、资料费)
AIDD:
公费价:每人每班¥5880元 (含报名费、培训费、资料费)
自费价:每人每班¥5580元 (含报名费、培训费、资料费)
AIDD:
公费价:每人每班¥5880元 (含报名费、培训费、资料费)
自费价:每人每班¥5580元 (含报名费、培训费、资料费)
AIDD:
公费价:每人每班¥5880元 (含报名费、培训费、资料费)
自费价:每人每班¥5580元 (含报名费、培训费、资料费)
重磅优惠:
优惠1:
报二送一(同时报名两个班免费赠送一个学习名额赠送班任选)
两班同报:10880元 (可学习三个直播课)
三班同报:14880元 (可学习四个直播课)
四班同报:18880元 (可免费学习一整年本单位举办的任意课程)
特惠2:28880元(可免费学习两整年本单位举办的任意课程)
优惠3:提前报名缴费可享受300元优惠(仅限十五名)
特惠福利:报一送二、报二增四(额外送的回放)(包含全套课程回放和课件资料ppt)
1、课程特色--全面的课程技术应用、原理流程、实例联系全贯穿
2、学习模式--理论知识与上机操作相结合,让零基础学员快速熟练掌握
3、课程服务答疑--主讲老师将为您实际工作中遇到的问题提供专业解答
授课方式:通过腾讯会议线上直播,理论+实操的授课模式,老师手把手带着操作,从零基础开始讲解,电子PPT和教程开课前一周提前发送给学员,所有培训使用软件都会发送给学员,有什么疑问采取开麦共享屏幕和微信群解疑,学员和老师交流、学员与学员交流,培训完毕后老师长期解疑,培训群不解散,往期培训学员对于培训质量和授课方式一致评价极高!
腾讯会议实时直播解答|手把手带着操作
报名电话:13017692038
( 微信同号)