首次实现第一视角视频与人体动作同步生成!新框架攻克视角-动作对齐两大技术壁垒
量 关注前沿科技约 5 分钟
闻乐 发自 凹非寺
量子位 | 公众号 QbitAI
AI生成第三视角视频已经驾轻就熟,但第一视角生成却仍然“不熟”。
为此,新加坡国立大学、南洋理工大学、香港科技大学与上海人工智能实验室联合发布
EgoTwin
,
首次实现了第一视角视频与人体动作的联合生成
。
一举攻克了
视角-动作对齐
与
因果耦合
两大瓶颈,为可穿戴计算、AR及具身智能打开落地新入口。
第一视角视频与人体动作同步生成
核心挑战:第一视角生成的“两难困境”
第一视角视频的本质是 人体动作驱动的视觉记录 ——头部运动决定相机的位置与朝向,全身动作则影响身体姿态与周围场景变化。 二者之间存在内在的耦合关系,无法被单独分离。传统视频生成方法难以适配这一特性,主要面临两大难题:-
视角对齐难题
生成视频中的相机轨迹,必须与人体动作推导的头部轨迹精准匹配。但现有方法多依赖预设相机参数生成视频,而第一视角的相机轨迹并非外部给定,而是由穿戴者头部动作内生决定,需要二者同步生成以保证对齐。 -
因果交互难题
每一时序的视觉画面为人体动作提供空间上下文(如“看到门把手”引导伸手动作),而新生成的动作又会改变后续视觉帧(如“开门”导致门的状态与相机朝向变化)。这种“观察-动作”的闭环依赖,要求模型捕捉二者随时间的因果关联。
三大创新破解核心难题
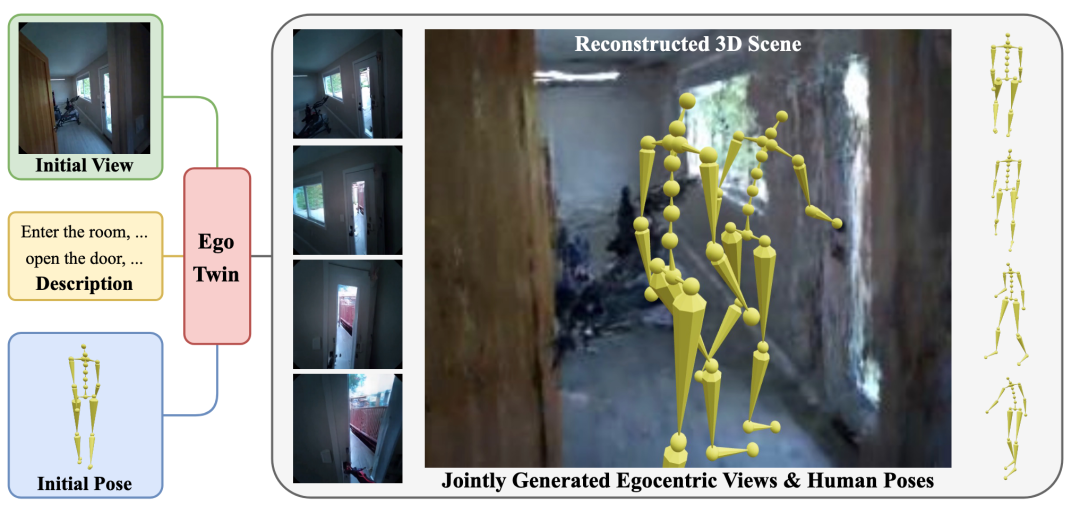 △
EgoTwin能同时生成“第一视角的场景视频”和“匹配的人体动作”
为解决上述挑战,EgoTwin基于扩散Transformer架构,构建了
“文本-视频-动作”三模态的联合生成框架
,通过三大关键设计实现突破两大难题。
三通道架构是指动作分支仅覆盖文本与视频分支下半部分的层数。
每个通道均配备独立的tokenizer与Transformer模块,并以相同颜色标示跨通道共享的权重。
创新1:以头部为中心的动作表征,让视角对齐“一目了然”
传统人体动作表征以身体根部为中心,头部姿态需通过人体运动学计算推导,容易造成误差累计。 EgoTwin提出以 头部为中心的动作表征 ,直接将动作锚定在头部关节,实现与第一视角观测精准对齐:-
明确包含头部绝对/相对位置(
,
)与旋转角度(
,
),其他关节的位置与速度(
)则基于头部坐标系定义;
-
初始帧头部姿态归一化为“零平移+单位旋转”,让相机视角与头部动作的对应关系更直接,无需额外复杂计算。
实验证明,相比传统表征,该设计使头部姿态回归误差显著降低,为视角对齐奠定基础。
创新2:控制论启发的交互机制,捕捉因果关联“动态闭环”
借鉴控制论中“观察-动作”反馈循环原理,EgoTwin在注意力机制中加入 结构化掩码 ,实现了视频与动作之间的双向因果交互:- 视频 tokens 仅关注前序动作 tokens:体现“当前视觉画面由过去动作产生”;
- 动作 tokens 同时关注当前与后续视频 tokens:实现“基于场景变化推断动作”;
- 初始姿态与初始视觉帧允许双向注意力,保证生成序列的起点一致性。
创新3:视频动作联合的异步扩散训练框架,平衡效率与生成质量
考虑到视频与动作的模态差异(如动作采样率通常是视频的2倍),EgoTwin采用 异步扩散训练策略 :为视频与动作分支分别设置独立采样时间步、添加高斯噪声,再通过统一时间步嵌入融合,适配不同模态的演化节奏。 同时,框架采用 三阶段训练范式 ,兼顾效率与性能:- 动作VAE预训练:单独训练动作变分自编码器,通过重构损失与KL散度正则化,确保动作表征的有效性;
- 文本-动作预训练:冻结文本分支(保留预训练文本理解能力),仅训练动作分支,加速模型收敛;
- 三模态联合训练:加入视频分支,学习文本条件下视频与动作的联合分布,支持多种生成任务。
实验验证:性能全面超越基线
模型能够根据文字和视频生成动作,或者根据文字和动作生成视频,甚至能把生成的视频和动作变成3D场景(比如还原出房间的 3D 结构,再把人的动作放进去)。 首先看一下可视化结果。
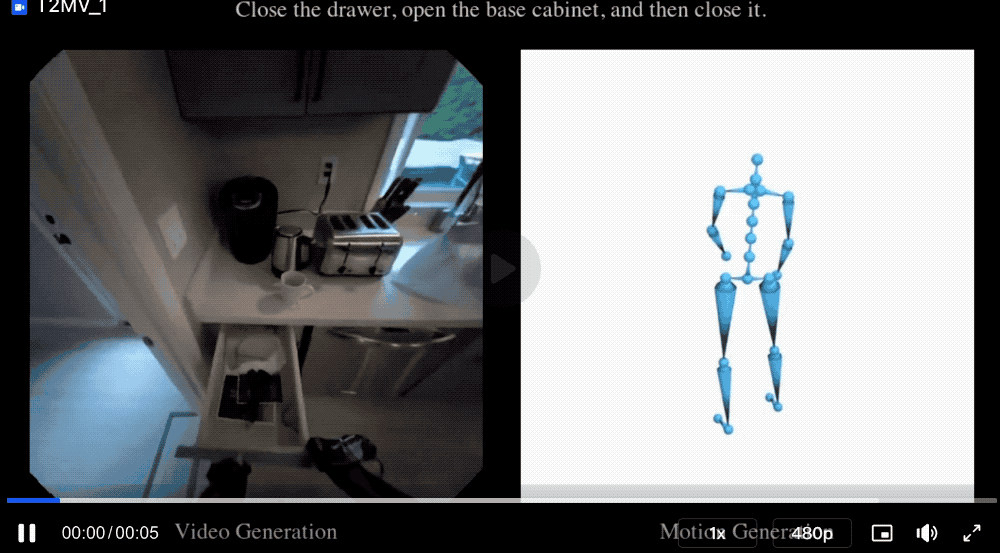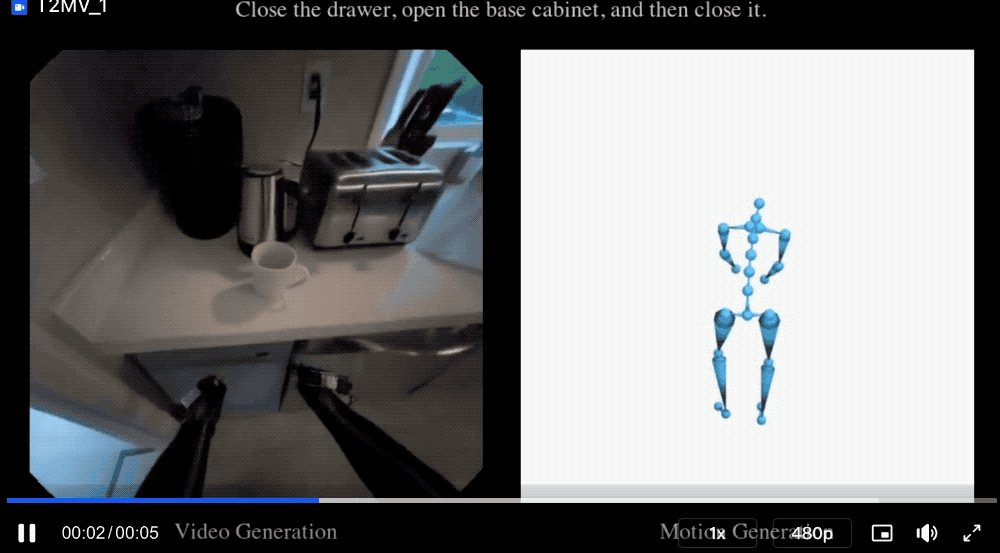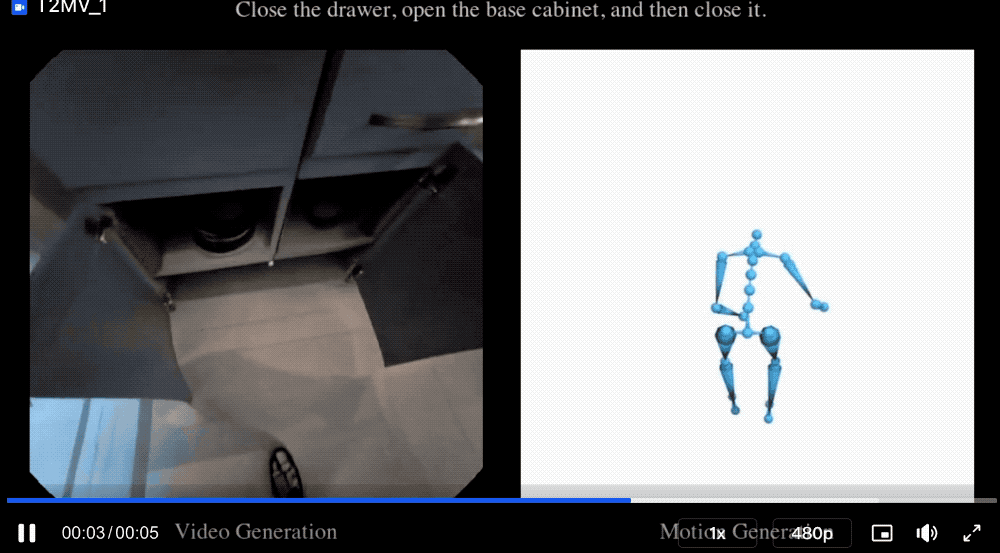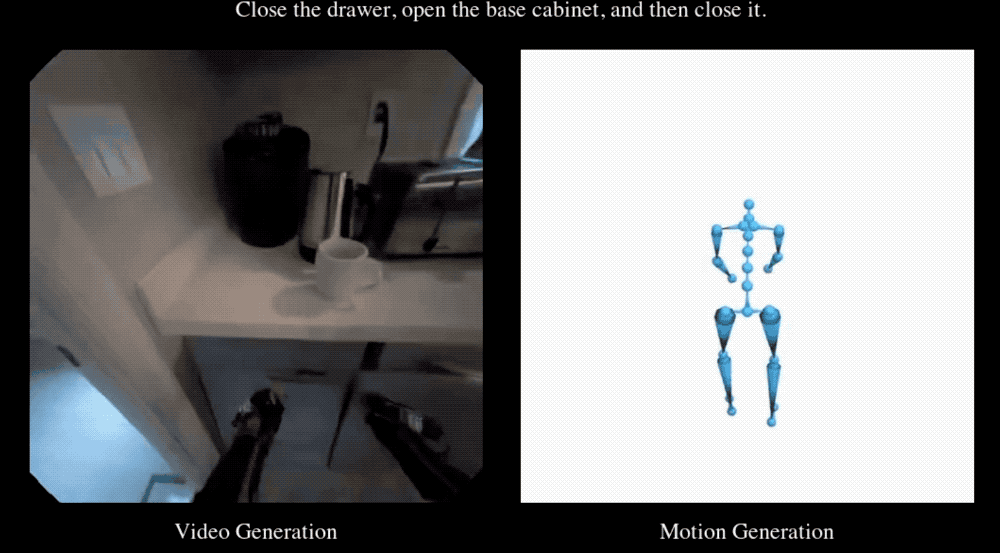 △
基于文本联合生成视频和动作
EgoTwin还支持根据动作和文本生成视频(TM2V)、根据文本和视频生成动作(TV2M)额外二种生成模式。
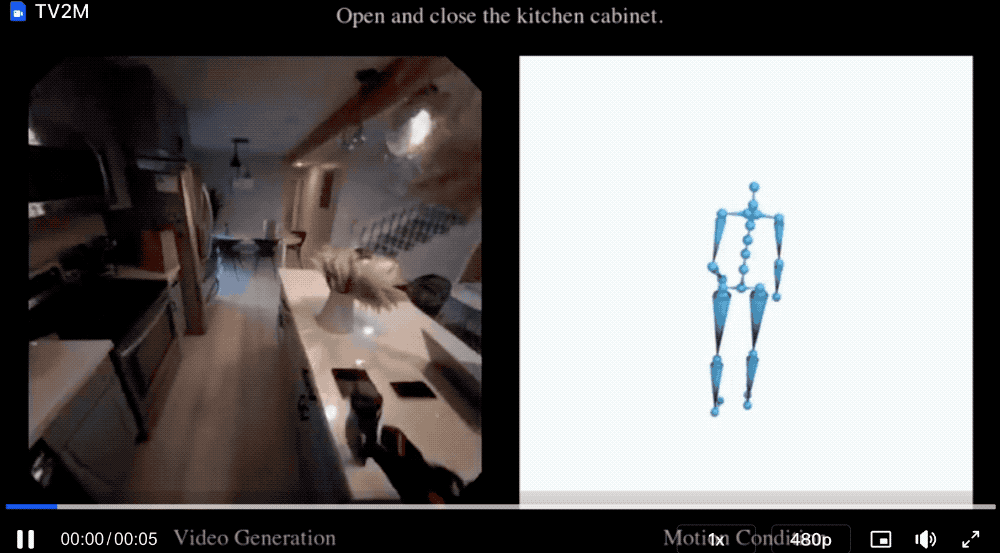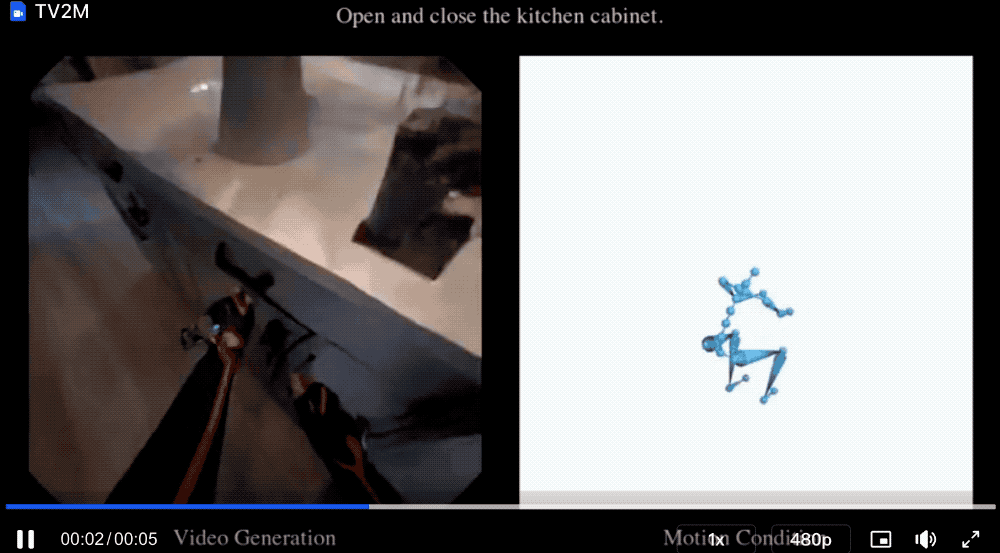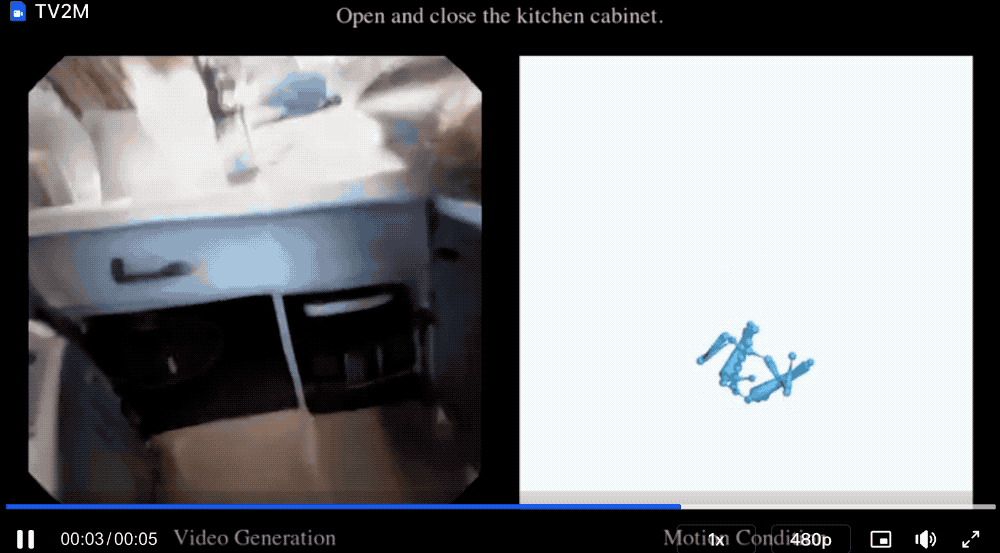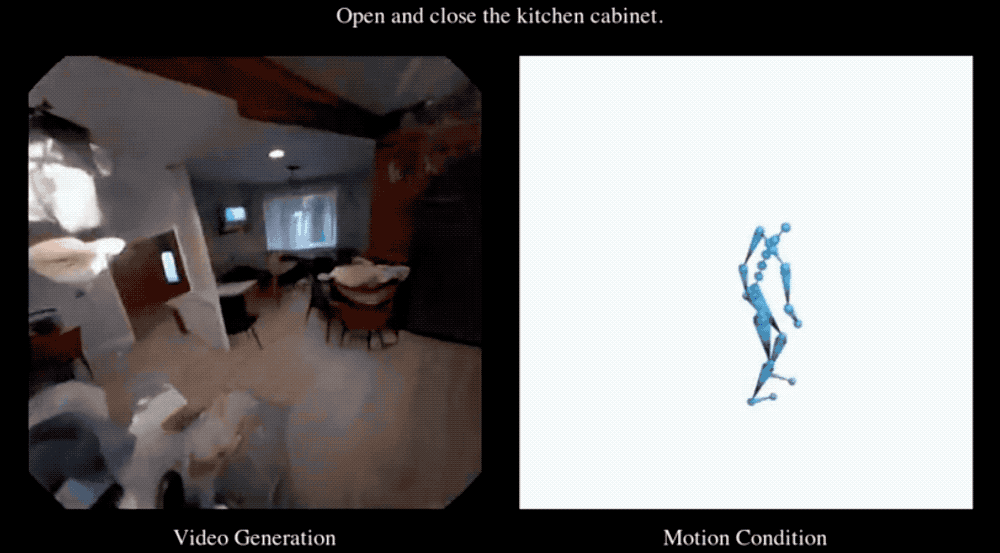 △
基于文本和动作联合生成视频
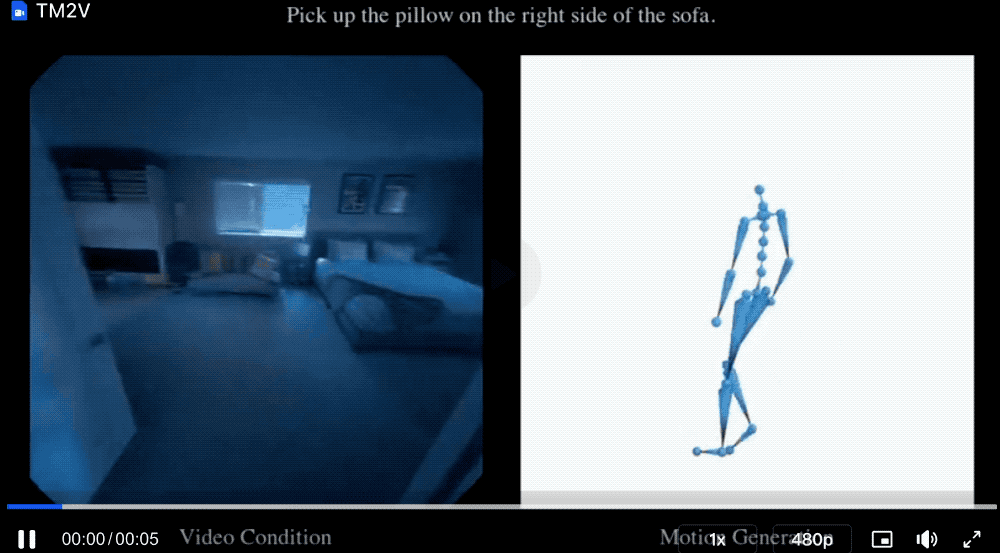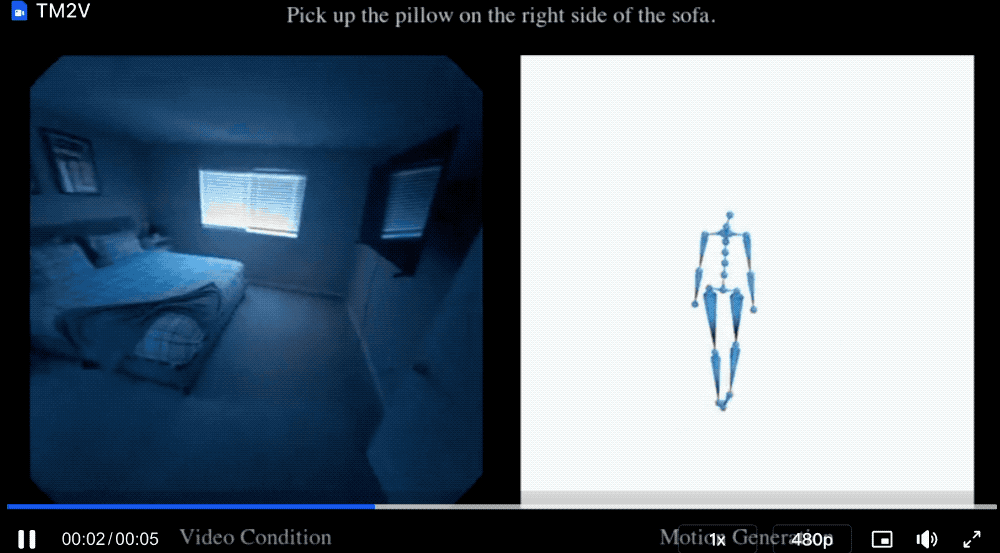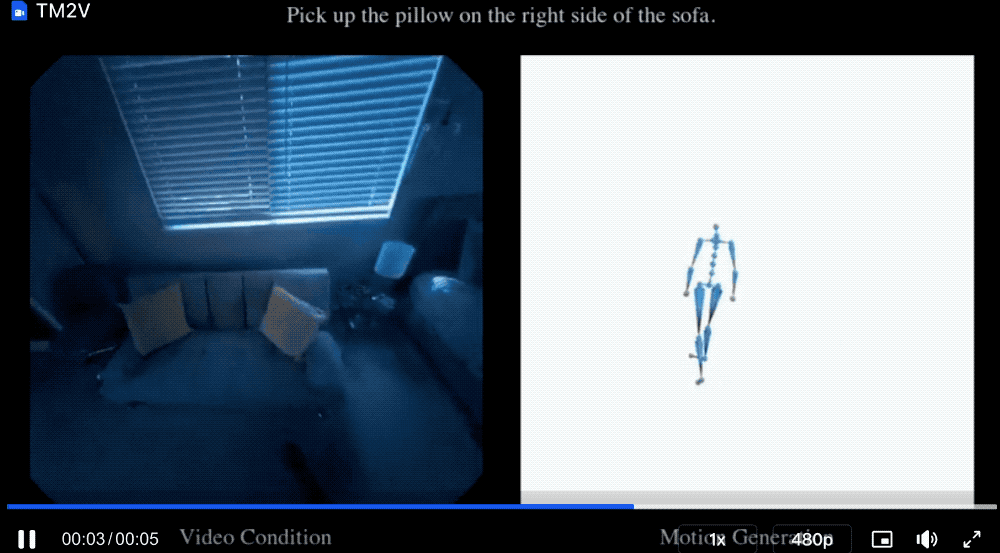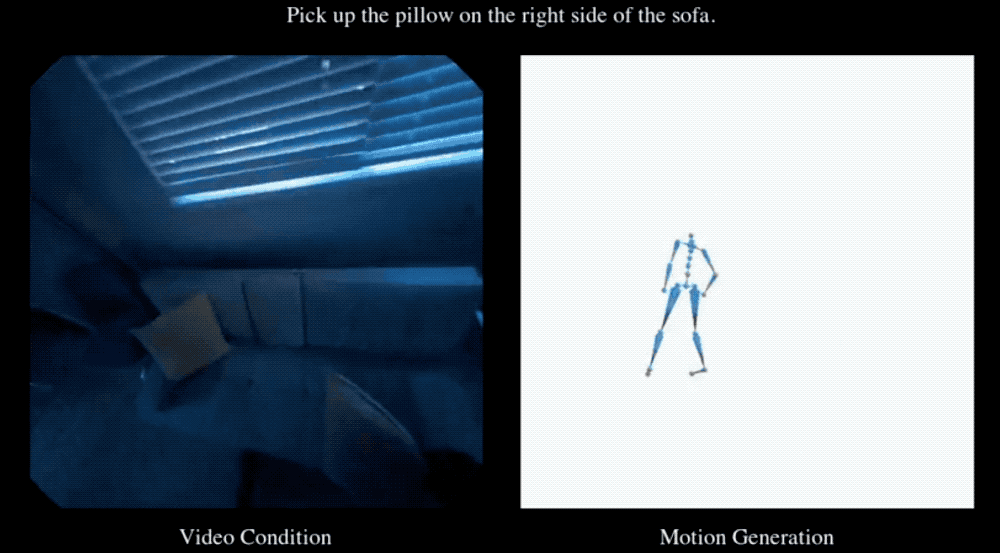 △
基于文本和视频联合生成动作
为客观评估,团队还从数据、指标、结果三方面系统展开测试。
项目主页与示例:https://egotwin.pages.dev 一键三连 「点赞」「转发」「小心心」 欢迎在评论区留下你的想法! — 完 —