刷新 Google AlphaEvolve 进化结果,百度开源 Agent 开发框架 LoongFlow
百 百度Geek说约 11 分钟
。
 点击蓝字,关注我们
LoongFlow 是
百度百舸团队发布的
一个开源的、旨在让 AI 学会「专家级思考」的智能体开发框架。我们
相信,设计一个能解决复杂问题的专家级 Agent,关键在于其思考模式——它决定了 Agent 能解决问题的复杂度和效果上限。
基于 LoongFlow 框架,我们开发了「通用算法发现」和「机器学习」两个开
箱即用的 Agent,
它们已在多项顶尖挑战中证明实力:
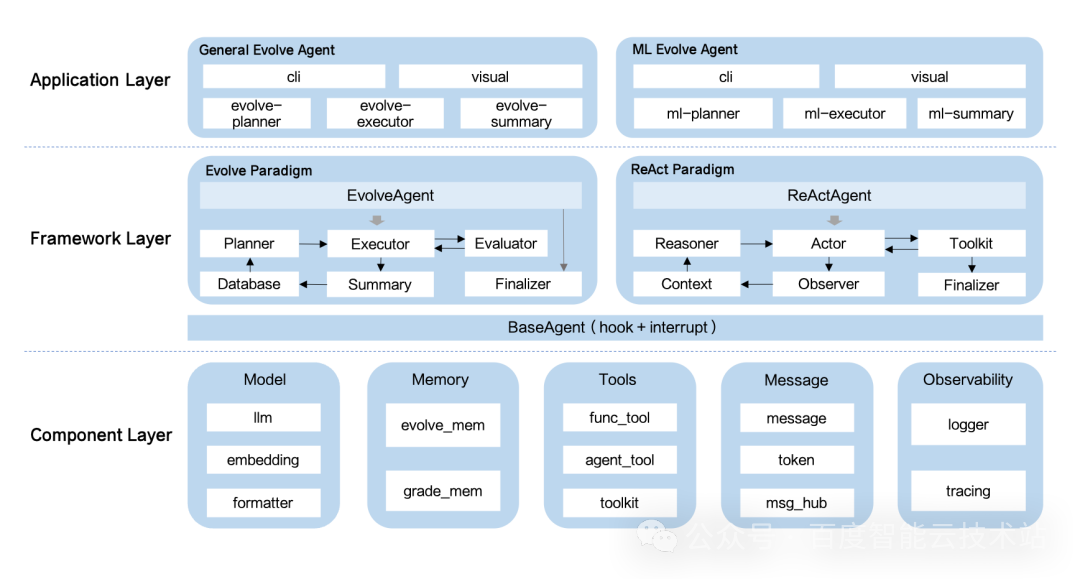
LoongFlow
的核心创新在于两套相互咬
合的设计,即 PES(Plan-Execute-Summarize
)和混合进化记忆系统(Hybrid Evolutionary Memory
),系统化地实现了 「如何智能地进化」:
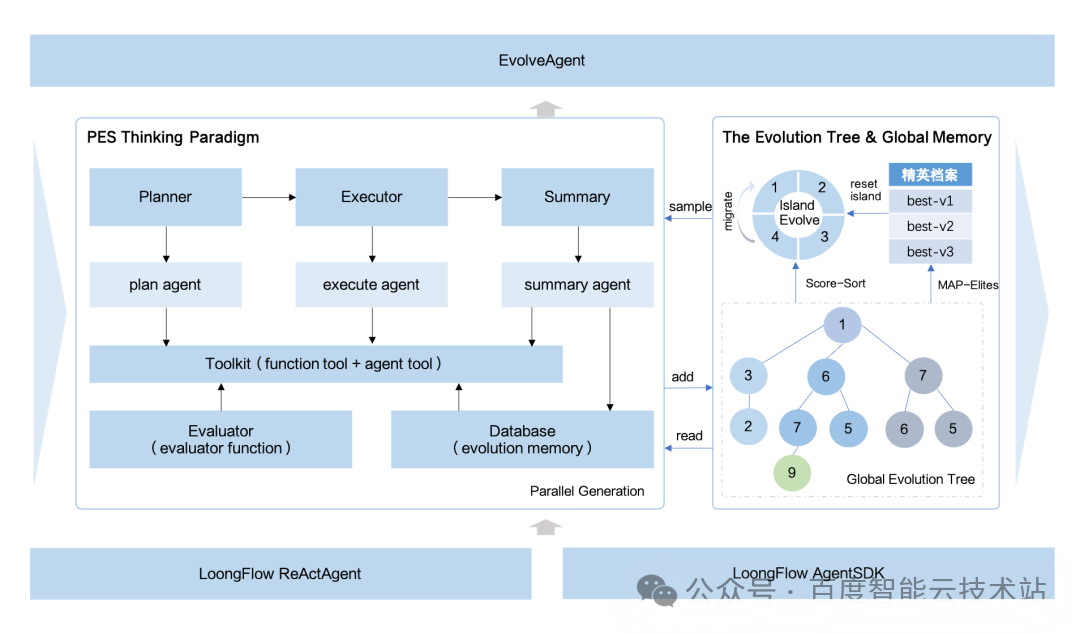
二者结合,LoongFlow 实现了从 「随机演化」到「定向认知进化」 的范式升维。智能体的探索不再是蒙眼狂奔,而是在历史智慧照亮下的、有策略的远征。
4. 实战验证:顶尖竞技场上的性能标杆
任何方法的价值,最终由实践检验。基于 LoongFlow 框架,百度百舸团队开发了「通用算法发现」和「机器学习」两个开箱即用的 Agent,它们在高难度测试集上的表现,验证了该框架的普适性与领先性。(详见技术报告,文末有报告链接)
数学成就:全面刷新人类与 AI 的纪录
在陶哲轩和 AlphaEvolve 发布的数学挑战
中,LoongFlow 取得了令人瞩目的成绩:
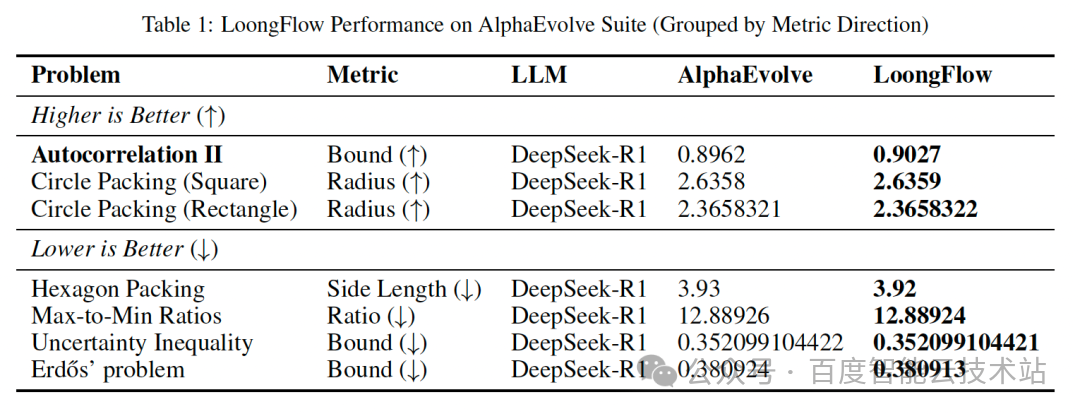
备注:上图来自于技术报告中的截图,
未能包含从技术报告完成到本文发布时间差内新增的成就
工程成就:在 23 项真实挑战中夺得金牌
在 OpenAI 发布的模拟 Kaggle 数据科学竞赛的 MLE-bench 评测中,由 LoongFlow 驱动的机器学习智能体, 已独立斩获了 23 枚金牌。
任务涵盖从 「病理切片癌症检测」 到 「预测火山喷发」 等高度专业且数据复杂的现实场景。这证明 LoongFlow 不仅能解决抽象数学问题,更具备构建、优化端到端工业级解决方案的工程能力。
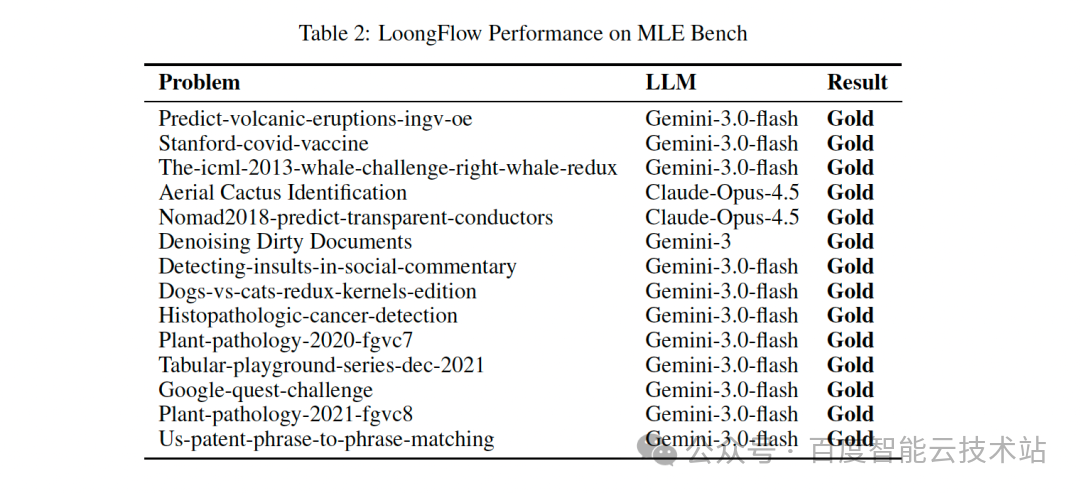
备注:上图来自于技术报告中的截图,
未能包含
从技术报告完成到本文发布时间差内的新增
金牌
效率成就:以 60% 的效率优势稳定胜出
在相同任务下,与 OpenEvolve、ShinkaEvolve 等进化智能体框架对比
:
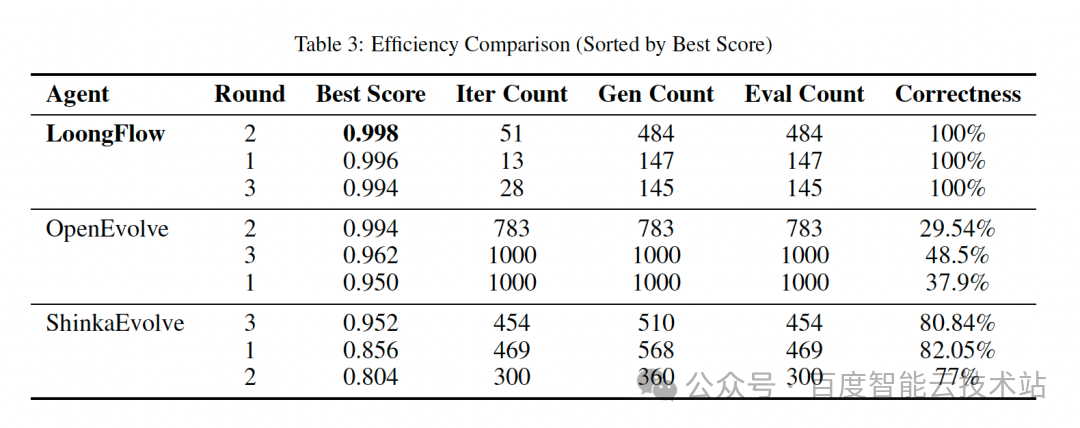
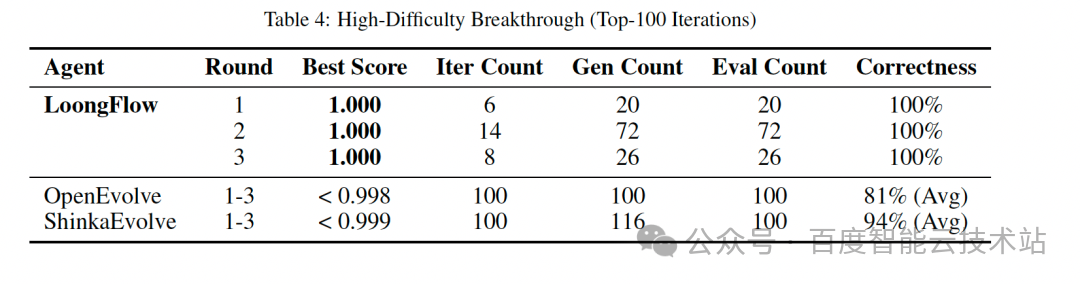
这意味着,使用 LoongFlow,研究者与企业能以显著更低的计算成本与时间成本,获得更可靠、更优质的解决方案。
5.
专家级思考
机制解
构:智慧如何从系统中涌现
LoongFlow 的高效源于其精妙的架构设计,它通过微观的认知循环与宏观的经验管理紧密协同,催生出系统的智慧。
PES 范式:高质量的定向认知循环
PE
S(Plan-Execute-Summarize)是驱动每一次迭
代的核
心引擎,它确保进化过程中的每一步都是深思熟虑的。
推荐阅读
了解你的 AI 编码伙伴:Coding Agent核心机制解析
百度流式计算开发平台的降本增效之路
百度智能云网络智能化运维系统设计和实践 百度一站式全业务智能结算中台 播放器视频后处理实践(二)氛围模式
一键三连,好运连连,bug不见
👇
- 在数学领域 11 个问题上 超越人类数学家已知最佳结果 ,在 7 个问 题刷新了 Google AlphaEvolve 的进化结果,刷新 SOTA。
- 在 模拟 Kaggle 数据科学竞赛的 MLE-bench 评测中 独立斩获 23 块金牌 。
- 在相同任务下,与 OpenEvolve、ShinkaEvolve 等进化智能体对比:进化效率提升超 60%,迭代成功率 100%。
- 可能性空间巨大:成千上万种材料、不同的处理工艺、多种形状尺寸。
- 需要多轮迭代:不能一次性得出答案,必须「尝试 - 观察 - 调整」循环。
- 结果反馈延迟:只有完整实施后,才能知道效果如何。
- 需要积累智慧:每一次失败都应让下一次尝试更聪明。
- PES 范式:为进化注入「科学家思维」 LoongFlow 没有将进化交给随机性,而是为每一次迭代设计了结构化的认知阶段:规划、执行、总结。这确保了每次尝试都是目的明确、过程可控、结果可学的,从根本上将「随机漫步」转变为「定向探索」。
- 混合进化记忆系统:构建专属的「战略智库」 框架为智能体配备了一套精密的经验管理系统。它不仅仅是存储过去的解决方案,更是按照策略与特征对其进行分类、索引与动态调取,确保历史智慧能被高效复用,防止探索陷入重复或僵局。
- 在 11 个问题上超越了人类数学家已知最佳结果。
- 在 7 个问题上超越谷歌 AlphaEvolve 的进化结果,刷新 SOTA。
- 进化效率提升超 60%:用最少的生成评估次数,发现最好的结果。
- 迭代成功率 100%:在多次重复实验中稳定达成目标,而基线方法常因陷入局部最优或进化太慢而失败。
- Plan 规划:在生成新一代方案前,智能体会扮演「战略分析师」的角色。它首先深度分析当前采样方案,然后检索「战略智库」(混合进化记忆系统)中所有的历史经验与失败教训,最终制定出一份目标清晰、规避已知陷阱的「进化蓝图」。这从根本上杜绝了盲目尝试。
- Execute 执行:「执行」阶段如同一个配备了全系专业工具包的智能施工队。其关键在于 「因题施策」 的动态适配能力:面对数学证明,它是严谨的「逻辑验证器」;编写代码时,它是即写即测的「交互解释器」;进行数据分析时,它又化身为高效的「智能查询生成器」。这种灵活性,结合「快速本地验证」机制,确保了高质量输出,从源头节省了计算资源。
- Summarize 总结:行动之后,「总结」模块承担起「复盘官」的职责。它不满足于简单的得分,而是深入剖析「规划蓝图」与「执行结果」之间的差距,提炼出「为何成功或失败」的因果洞察。这些结构化的经验被转化为下一代规划时可检索的宝贵知识。
- 多岛模型:它在内部建立多个独立的「探索特区」,允许不同的技术路线并行发展,相互隔离又定期交流,有效维持了探索的多样性,避免思维过早趋同。
- MAP-Elites:它如同一个多维的「杰出方案陈列馆」。系统不仅按成绩,更按行为特征(如算法复杂度、计算效率)对解决方案进行归档。这意味着,一个在某项特性上表现极佳但总分并非最高的方案,同样会被珍藏,为未来的跨界创新保留火种。
- 自适应玻尔兹曼选择:这个模块是智能的「资源调度官」。它根据种群探索的实时状态(如多样性熵值), 动态调节关键参数,智能切换策略 :是在全局鼓励冒险开拓新边疆,还是在局部集中力量深耕最优领地。
推荐阅读
了解你的 AI 编码伙伴:Coding Agent核心机制解析
百度流式计算开发平台的降本增效之路
百度智能云网络智能化运维系统设计和实践 百度一站式全业务智能结算中台 播放器视频后处理实践(二)氛围模式