刚刚,百度最新开源神作:PaddleOCR-VL-1.5上线了
M 池建强 池建强约 7 分钟
现在这个世道真是变了,我们写代码那会儿,使用的开源基本上都是国外开源组织和大公司维护的开源软件和开源社区,用的嘎嘎香,国内好的开源项目极少。到了 AI 时代,这个局面彻底扭转过来,国外好的模型大部分是闭源的,反观国内,顶级的开源模型和相关产品层出不穷,性能足以媲美甚至超过西方的闭源模型,极大地促进了技术的普及和应用创新,并迅速在全球范围内产生巨大影响……
这不,1 月 29 日,也就是今天晚上,我看到百度正式发布并开源了新一代文档解析模型 PaddleOCR-VL-1.5,模型参数仅 0.9B,在全球权威文档解析评测榜单 OmniDocBench V1.5中取得全球综合性能第一的成绩,整体精度达到 94.5%,超过 Gemini-3-Pro、DeepSeek-OCR2、Qwen3-VL-235B-A22B、GPT-5.2 等模型。
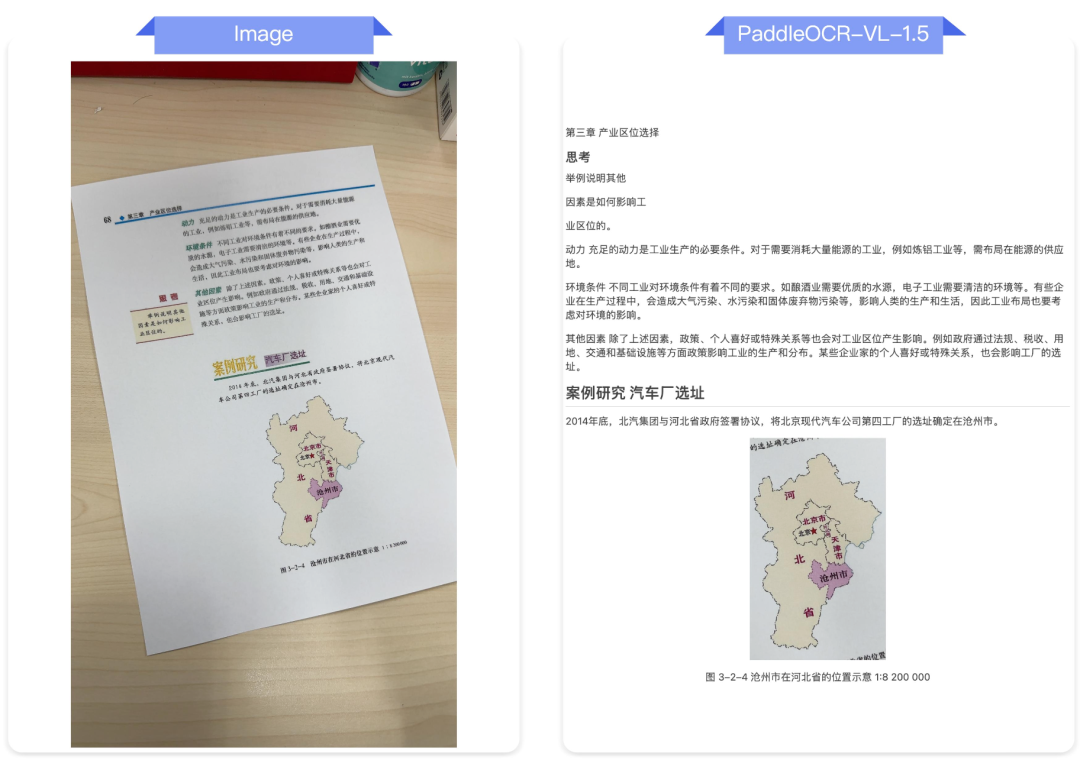
PaddleOCR 这个产品我此前在 MacTalk 就介绍过,开发者和企业用户对它是赞不绝口。PaddleOCR 把一个看起来很老派的技术做出了新花样。PaddleOCR-VL-1.5 创新性地支持了文档元素的异形框定位,是全球首次突破这项难题,使得 PaddleOCR-VL-1.5 在扫描、倾斜、弯折、屏幕拍摄及复杂光照等真实场景中均表现非常优秀。
可以这么说,PaddleOCR-VL-1.5 把 OCR 的能力从识别字升级到了看懂文档。
1
全球 SOTA 其实就是个说法,重要的是真实场景的应用和数据指标。
首先,基于文心大模型研发的 PaddleOCR-VL-1.5,在 OmniDocBench V1.5的评测数据全面领先,包括文本、公式、表格等领域。
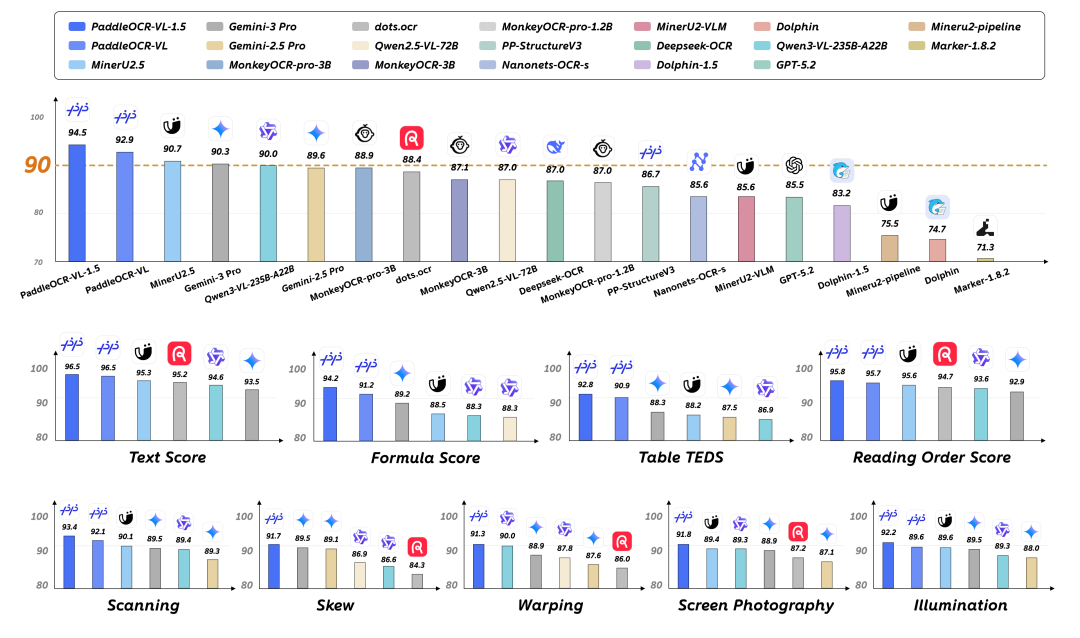
具体来说,PaddleOCR-VL-1.5 在表格结构理解上拿到了 92.8 分,在阅读顺序预测 95.8 分,这两项核心指标上都是第一,分别领先 Gemini-3-Pro、DeepSeek-OCR 等主流模型 2–5 分不等。在文档阅读顺序预测任务中,其版面逻辑解析错误率仅为同类其他模型约一半。
这些数据说明了 PaddleOCR-VL-1.5 在复杂文档结构还原与版面逻辑理解方面具备更高稳定性,在合同、财报等高复杂度业务场景中拥有更高可用性。
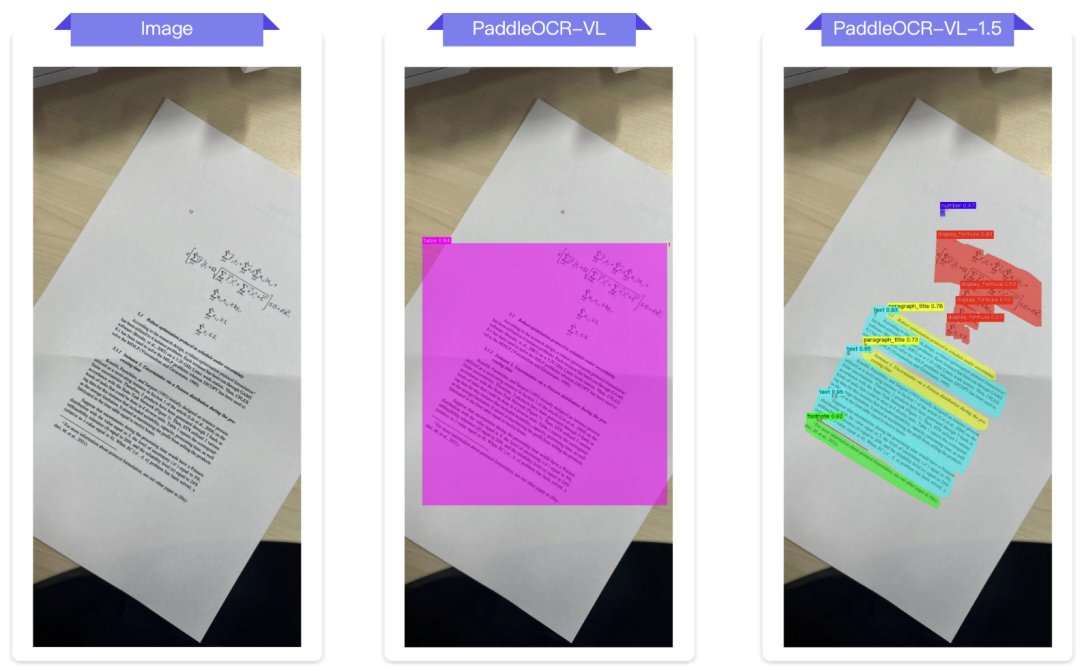
除此之外,PaddleOCR-VL-1.5 还是全球首个支持异形框定位的 OCR 模型。它可以在倾斜、弯折、拍照获取的文档中,精确定位表格、公式、文本等各类 block 结构,解决了真实文档“形态不规整、无法可靠解析”的老大难问题——第一次让大规模、不规则文档的精准识别变得可行。
在可用性上,它也完成了一次明显跃迁:在扫描、弯折、倾斜、屏幕拍照、光线变化这五类高频真实场景里,PaddleOCR-VL-1.5 都做到了全球 SOTA,整体稳定性领先所有开源/闭源模型。
2
说了这么多,啥是异形框定位技术呢?
你别说,我和 PaddleOCR 的研发同学聊过之后才知道,这个技术的含金量还真高。字对了不算赢,结构对了才是可用的。
在很多产品展示的功能里,OCR 的胜利往往是“把字识别出来”,产业真正要的是“数据和数据结构”。
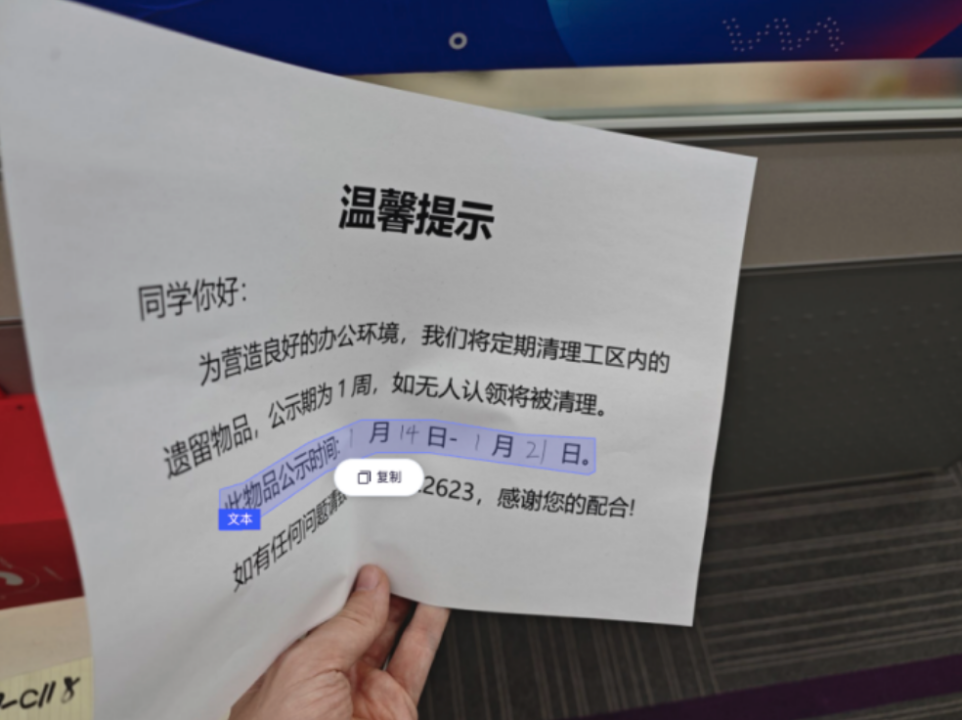
手机随手拍一份合同,广角透视有变形,表格列立刻错位;折过的发票 / 报销单,一道折痕就把公司名硬生生切成两段;会议现场拍 PPT,带梯形的表格再加一点反光,最后 OCR 只能给你吐出“一坨文字”;老档案卷边、发黄又模糊,默认的“规则矩形框”假设直接失效。
PaddleOCR-VL-1.5 瞄准的目标则是“自动拉正结构、单元格精准还原”“跨折痕识别 + 结构重建”“表格完整还原”,把那些最乱、最难、最关键的细节,一个个捋顺搞定。
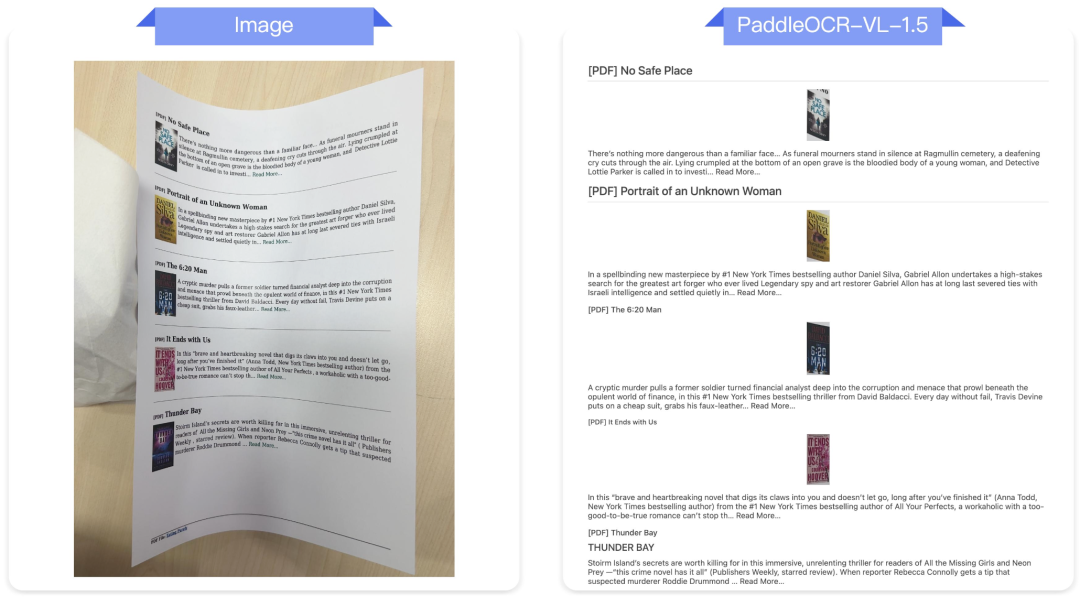 这就是 OCR 支持“异形框定位” 的价值。
传统 OCR 即便把字认对了,也分不清字属于哪一行、哪一列、哪一个单元格,结果可能是“字对了,结构乱了”,数据没法直接用。PaddleOCR-VL-1.5 在模型层面就支持了异形框定位,即使文档是梯形或弯折的,也能把表格和文本结构“一格一格准确标记并还原出来”,让 OCR 在真实拍照场景中做到稳定可用,从“认字”升级为“看懂整张文档和表格”。
这里依然是工程能力的胜利:没有结构,LLM 只能做“阅读理解”,很难做“业务处理”;
有了结构,合同里的金额、发票上的税额、清单里的每一条明细,才能被稳稳进入业务系统,后续才会有风控、核销、归档、检索、审计这一整条数据流水线。
这是一种硬核技术的胜利:不光是喊喊多模态的口号就完了,老老实实把“结构几何”这个难题搞定,让业务顺畅的跑起来。
3
AI 时代,大家都在谈大模型,OCR 还有什么价值?多模态模型可以看图,会读字,能总结——还要 OCR 干什么?
我的理解是,OCR 在大模型时代,从“识别工具”变成了“现实世界的输入法”。
大模型会读,不等于系统会用。大模型时代的文档处理,真正的流程通常是这样的:
一份合同/票据/档案进入系统 → 结构化解析(段落、表格、公式、阅读顺序) → 关键信息抽取与校验 → 入库 → 检索与推理(RAG/Agent) → 回写业务系统。
在这个业务流程里,OCR 不是终点,而是入口。入口不准确的话,后面的行动都是“沙地上盖楼”。
再看长远一点,OCR 越来越像 AI 系统连接现实世界的一种“输入法”。纸、屏幕、照片、扫描件、历史档案——这些仍是企业知识的主要载体。谁能把这些载体稳定变成机器可用的数据,谁就扼住了“企业知识与流程自动化”的咽喉。
也正因为如此,最近半年多的时间里,全球主流模型厂商在 OCR 领域密集布局。
今年 1 月 27 日,DeepSeek 发布了新一代 OCR 模型 DeepSeek-OCR-2,引入“因果流查询”机制,并将语言模型融入视觉编码,在 OmniDocBench V1.5 中实现 91.09% 精度。与此同时,Mistral AI、字节跳动、腾讯等企业也相继推出新一代 OCR 模型,行业竞争持续升温。而今天发布的 PaddleOCR-VL-1.5 ,则让 OCR 在精度、复杂场景适应性与工程化能力上取得了进一步突破。
随着大模型加速进入金融、政务、制造等高复杂度业务流程,文档解析能力正从“能用”走向“稳定的规模化应用”。
 4
开源在中国的发展是越来越猛了,那开源的意义是什么?在我看就是,快速推动产业链的发展,并帮助企业和开发者做出自己的产品和服务用户。
像 PaddleOCR 这样的技术,开发者和企业可以直接通过 GitHub、Hugging Face 获取模型权重,而且已经和昆仑芯、海光、昇腾、此芯科技、Intel、ARM、AMD等核心硬件厂商,以及百度智能云、国家超算互联网平台、硅基流动、魔搭社区、Dify、等平台实现集成。
另外,PaddleOCR 可不是一夜爆红的项目:PaddleOCR 在 GitHub 社区是 唯一Star 超过 60k 的中国 OCR 项目,开源 5 年,自 2020 年开源以来累计下载量突破 1000 万,并被超过 6k 开源项目直接或间接使用,比如 DeepSeek-OCR 在论文致谢里还感谢了 PaddleOCR。
截至 2026 年 1 月,百度在 OCR 领域申请了 1700 余件中国发明专利,其中 900 余件已授权;同时在美欧日韩均布局 100 余件OCR相关专利。“异形框定位”恰恰是这种从专利与工程里长出来的能力。
这非常了不起。
5
最近 AI 领域的产品发布还真不少,文心 5.0 正式发布了,PaddleOCR-VL-1.5 发布并开源了,阿里的千问 Qwen3-Max-Thinking 也发布了;DeepSeek OCR2 发布之后,大家都等着 V4 和 R2 呢……
到了现在这个阶段,中国 AI 竞争已从“单模型能力比拼”进入了“系统级综合能力竞争”的阶段,文心、千问、DeepSeek几位主要玩家,近期的频繁发布,已然形成了AI“三国杀”格局:
文心更像用“工程化系统能力”搭起全栈路线:无论是文心5.0、PaddleOCR-VL-1.5、文心数字人大模型、还是昆仑芯,这些背后是百度芯片-云-模型-智能体的全栈布局,推进产业发展。
千问更像“模型族谱与生态扩张”的路线:持续推出不同形态的开源模型,最新的Qwen3-Max-Thinking则是把推理能力推向极致,同时赋能自己的业务和 AI 助手、浏览器。
DeepSeek 不止是近期发布的Deepseek-OCR-2, V4 和 R2 更是呼之欲出,这家公司更像是走在“通过试验追求极致效率和成本”的路线上:用压缩、效率、开源速度,把某些任务做到又强又省钱。
……
文心、千问、DeepSeek三大家,形成了非常良性的竞争,在这种环境里,我想类似 PaddleOCR-VL-1.5 这样的创新会越来越多。很多技术的价值,就是在这种“看起来很小的麻烦”里长出来的。
这是个信号,在大模型时代,中国开源正在把越来越多“工程性质”的基础能力,做成全世界都能用的工具。
时代变了。开源也变了。OCR 也变了。
感兴趣的朋友,欢迎体验:
感兴趣的朋友,欢迎体验:
- 在线使用/API:https://www.paddleocr.com
- 开源项目地址:https://github.com/PaddlePaddle/PaddleOCR
- 模型下载地址:https://huggingface.co/PaddlePaddle/PaddleOCR-VL-1.5