持续暴涨!MSA 重磅开源!
G 小 G 小 G约 5 分钟
你们有没有发现一个问题,AI 用得多了,经常会记不住很多东西。
比如,上下文一长就丢信息,跨对话就失忆,精心设计的多轮对话逻辑,在第 8 轮开始胡说八道。
这是因为,目前底层模型的记忆能力,上限就到这了。
当下最强的大模型,有效上下文也就在 1M token 左右。而据研究人员估算,人类一生能存储并调用的信息,大约在 2-3 亿 token 这个量级,这之间,整整差了两个数量级。
业界试过两条路:拉长 context window(计算成本二次方增长,到头了),挂载 RAG(检索和生成割裂,精度有上限)。
两条路,现在也都走到了瓶颈。
正当大家思考下一步该如何突破时,EverMind 团队在 GitHub 悄然开源了一个
MSA(Memory
Sparse
Attention)
项目。
它提供
了与以往完全不同的思路,不拉长上下文,不外挂检索,而是
把记忆直接嵌入注意力机制本身
。
项目在
GitHub
开源后没多久,便引起了诸多开发者关注,短短几天内,暴涨了
2600+ Star
。
GitHub:
https://github.com/EverMind-AI/MSA
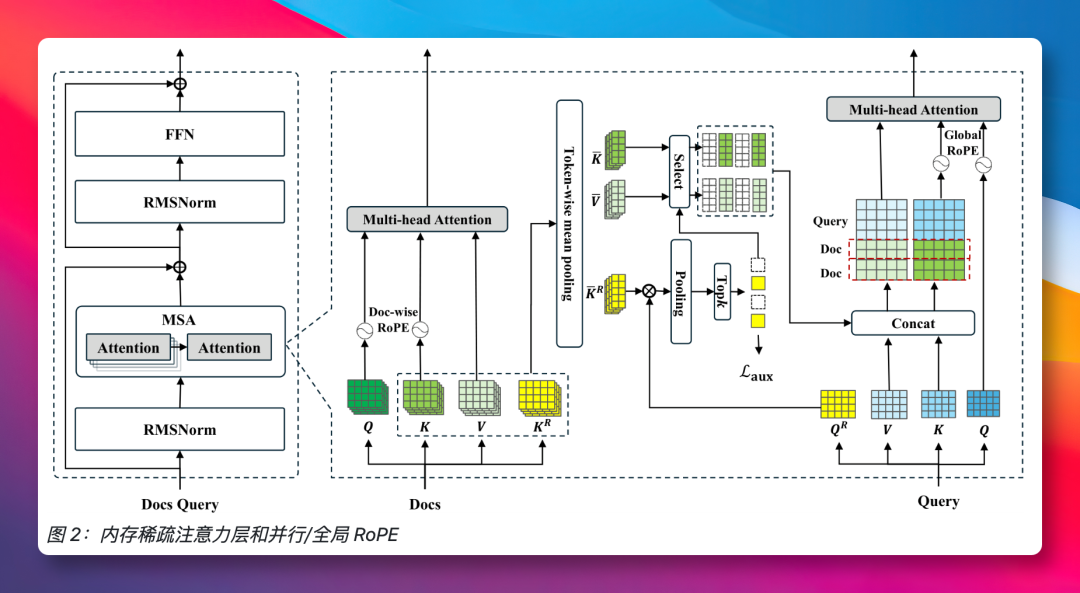
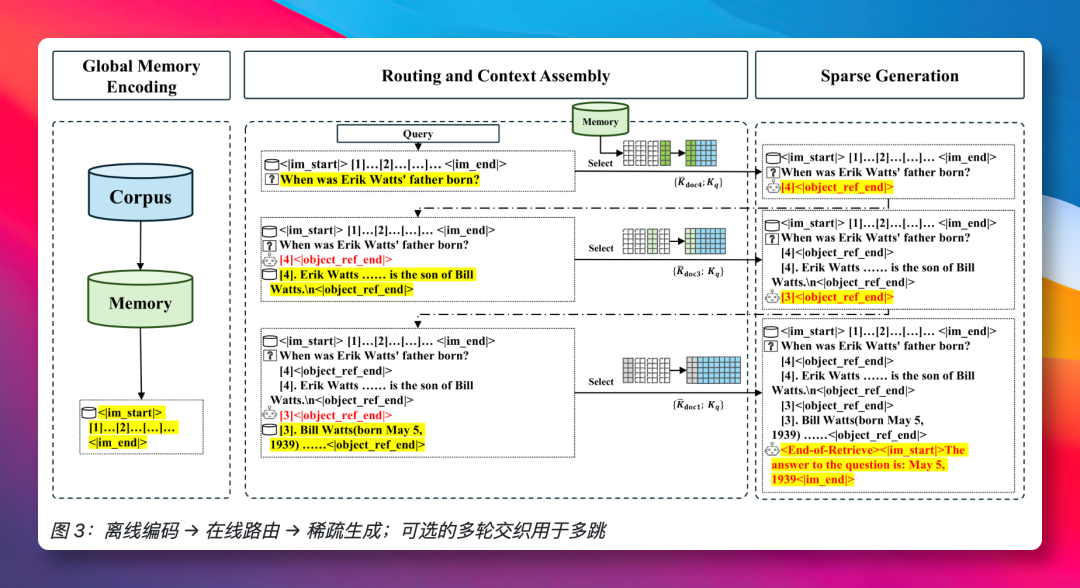
模型自己学会了什么该记、怎么找、怎么用。没有人工规则干预,无需管道拼接适配。
而且,MSA 是即插即用的,开发者只需替换标准 Transformer 的 Self-Attention 层就行,不需要改模型整体架构。
关于相关技术细节,团队已经写了一篇非常完整的解读文章,这里便不再赘述。
这几个关键核心细节如下:
参数量差了将近 60 倍,效果反而更好。从这也不难看出,在 AI 记忆这件事上, 架构选对远远要 比 模型堆大 更重要。 硬件门槛极低。 项目可直接跑在一台配备两张 A800 显卡的机器上,不需要集群,不需要特殊硬件。 也就是说,从现在开始,中小团队甚至个人开发者也有机会用上亿级 token 的长期记忆能力。
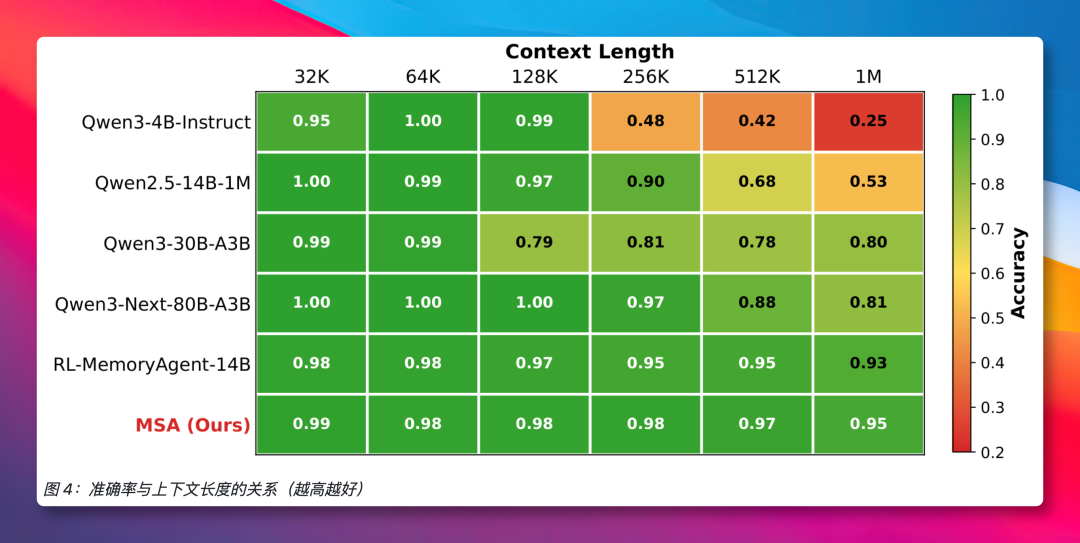
一句话理解 MSA
对比以往的 RAG,MSA 有着完全不同的记忆机制。 传统 RAG 是给模型配了一个外置硬盘,需要的时候自己去查。MSA 不一样,它是给模型装了一个原生记忆芯片,让记忆成为模型自身能力的一部分。 这意味着寻找和调用不再是两个独立步骤,而是整合在同一个神经网络里,端到端完成。- 用压缩把 1 亿 token 的存储降到可接受范围;
- GPU 放路由索引、CPU 放内容详情,让总容量取决于内存而非显存;
- 稀疏路由把复杂度从 O(L²) 降到 O(L);
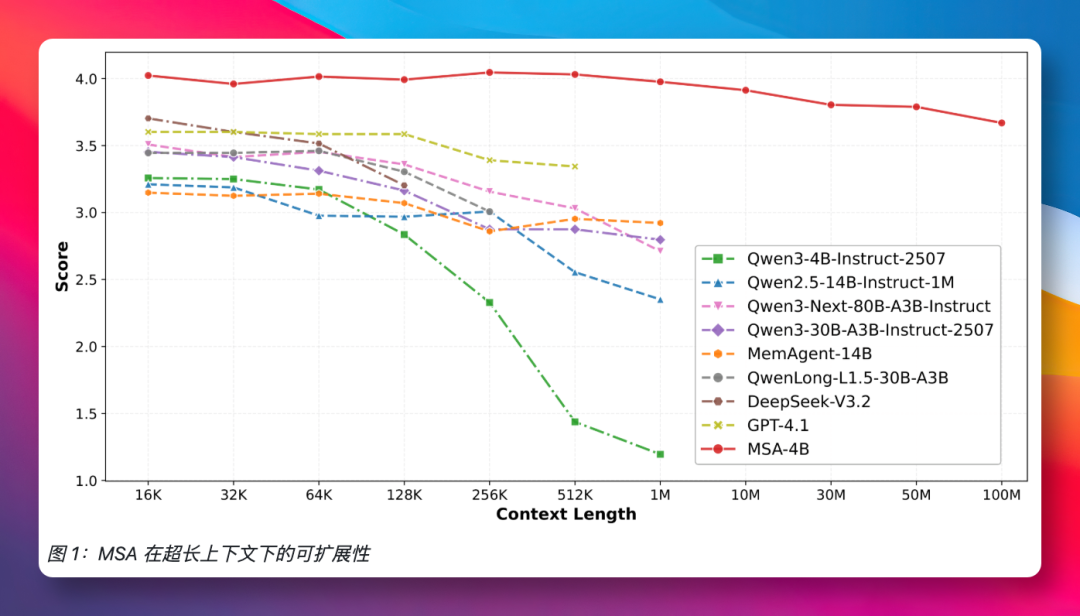
- 每篇文档位置编码独立编号,训练 64K 就能外推到 100M。
效果有多强?
说再多架构设计,最终也不如看数据来得直观。 MSA 基于 Qwen3-4B 构建,经过 159B token 持续预训练,有着以下几项核心特性: 不仅记得多,还记得准。 从处理 1 万多 token 到 1 亿 token,跨越了近四个数量级,然而 MSA 的回答质量,却仅仅只下降了不到 9%。 打个比方:别人读完一本书就开始忘前面的内容,MSA 读完 100 本类似《红楼梦》的著作。还能准确告诉你第 3 本第 47 回里的细节。 小模型打赢大模型。 在 9 项标准问答测试中,MSA 用一个 40 亿参数的模型,平均得分就超过传统 RAG 方案 16%。 更夸张的是,当对手换成行业顶级检索器 + 2350 亿参数大模型组成的豪华阵容时, MSA 依然在多项测试中胜出。参数量差了将近 60 倍,效果反而更好。从这也不难看出,在 AI 记忆这件事上, 架构选对远远要 比 模型堆大 更重要。 硬件门槛极低。 项目可直接跑在一台配备两张 A800 显卡的机器上,不需要集群,不需要特殊硬件。 也就是说,从现在开始,中小团队甚至个人开发者也有机会用上亿级 token 的长期记忆能力。
团队背景与研发历程
MSA 来自 EverMind(盛大旗下),团队之前做过 GAIA 榜单 SOTA 的多 Agent 框架 Omne,以及开源记忆平台 EverOS 。 在把 Omne 落地到真实业务时,他们发现,Agent 的记忆缺失,不是在框架层面就能解决的问题,而必须得从模型底层入手。 从立项到论文完成,历时九个多月,总的来说,其过程并不顺利。 第一版模型,在一些团队认为应该很简单的任务上表现不佳,一度让人怀疑方向本身是否就是错的。 随后的转折点,主要来自团队的一个关键洞察:模型在「 找资料 」和「 写答案 」时,需要的信息是不一样的。 找资料需要的是宏观判断:这堆文档哪部分内容,跟我的问题有关? 写答案则需要微观细节:具体哪句话,解答了我的问题? 早期版本是让同一套机制同时干这两件事,结果两头都做不好。 把这两个职能拆开,各自用专门的模块来处理,再配合更适合的训练策略,性能反而出现了质的飞跃。 论文里也坦诚提到了当前的局限:在需要多篇文档复杂关联,进行深度推理的场景中,纯内在记忆方案仍面临挑战。 这种对技术边界的坦诚与敬畏,反而让人对团队的判断力,以及项目的长期发展更有信心。写在最后
如果后续 EverMind 的技术理论可以真正落地,那么 AI 行业之前面临的诸多问题,或许能得到妥善解决。 从真正实现长记忆的那一刻起,AI 助手才算开始真正认识你。 它会记得你三个月前提过的饮食偏好,记得你上周讨论的项目进展,记得你孩子的性格和你对周末出行的喜好。 不用你每次重复告诉它,而是它自己就记得。 如果方向成熟,这种具备终身记忆的 AI 伙伴,将不再是科幻概念。 不仅如此,长期记忆能力打开的产品想象空间也非常大。 真正个性化的 AI 教育、能跟踪患者完整病史的医疗助手、能记住十年项目积累的企业知识库。 这些今天因为模型记不住而做不好的产品形态,都可能因为记忆层的突破而变成现实。 最后,MSA 这个方向,还自然引出了一个很有想象力的可能性:记忆即服务。 记忆层可以作为独立的、可插拔的模块与各种大模型自由组合。 这意味着用户的记忆资产,不再被锁定在任何单一模型或厂商中。 也就是说,模型可以随时更换,但记忆会永远跟着你走。 我觉得,这或许也将成为 AI 行业下一个重要的基础设施方向。 目前,该论文已发布,相关代码也已开源,后续还将会有模型开源。 对这项前沿技术感兴趣的朋友,不妨去 GitHub 点个 Star,关注最新开源进展。- MSA: https://github.com/EverMind-AI/MSA
- EverOS :https://github.com/EverMind-AI/EverOS