每当你敲下
ollama serve
,要等 5 到 10 秒,眼睁睁看着 680MB 的进程吞下 200MB+ 内存。
就为了跑一个本地模型。
这个场景,所有在本地跑过 LLM 的人都经历过。Ollama 已经是最好的方案了——但它本质上是一个平台产品:管理模型、下载模型、服务模型。对只想要一个轻量推理服务的开发者来说,太重了。
上周我在 Hacker News 上看到 Shimmy。一个 8MB 的单文件二进制,Rust 写的,纯粹的 OpenAI API 兼容层。更惊人的是,v2.0 之后它把 llama.cpp 整个扔掉了,
自己写了一个 GPU 推理引擎
。
● ● ●
一句话:Shimmy 是什么
Shimmy 是一个单文件本地 LLM 推理服务器。下载、运行、把 OpenAI SDK 指向
localhost:11435/v1
——所有兼容 OpenAI API 的工具直接能用。
差异化就两条:
-
01
纯 Rust 的 GPU 推理引擎(Airframe)
——不依赖 llama.cpp,不依赖 CUDA,不依赖 Python。WebGPU 一次编译,NVIDIA/AMD/Intel/Apple Silicon 全部通跑。
-
02
8.3MB vs Ollama 的 680MB
——81 倍尺寸差距。启动 <100ms vs Ollama 5-10s。
5.7K GitHub Stars,MIT 许可证,作者承诺永久免费。
● ● ●
最快上手:30 秒
# 下载(Linux) curl -L https://github.com/Michael-A-Kuykendall/shimmy/releases/download/v2.2.0/shimmy-linux-x86_64 -o shimmy chmod +x shimmy # 启动,Shimmy 自动发现 ~/.cache/huggingface/ ~/.ollama/models/ ./models/ 下的模型 ./shimmy serve # 搞定。现在任何 OpenAI SDK 指向 http://localhost:11435/v1
如果你已有 Ollama 模型,Shimmy 直接读取
~/.ollama/models/
——零迁移成本。
● ● ●
比"小"更重要的:自研 GPU 引擎
Shimmy v1.x 确实是 llama.cpp 的 Rust 薄封装。到了 v2.0,作者 Michael Kuykendall 做了一个激进的决定:
完全丢掉 llama.cpp,从零写纯 Rust 的 GPU 推理引擎。
这个引擎叫
Airframe
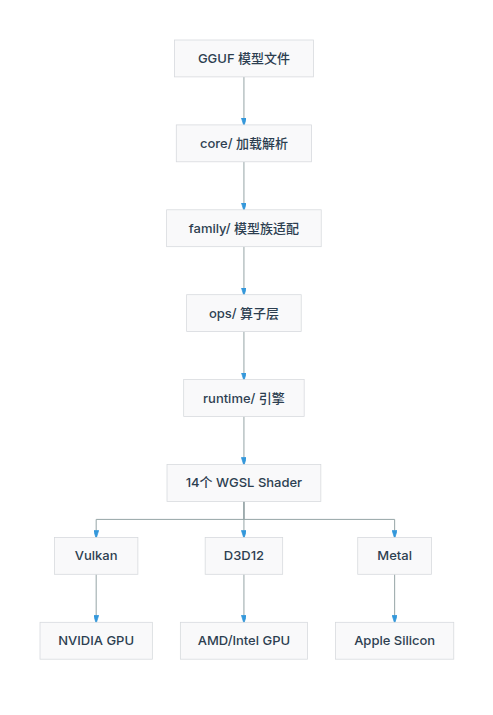
,核心是 14 个 WGSL compute shader——在 WebGPU 上跑 GPU 计算:
Airframe 架构
GGUF 加载 → 模型族适配 (Llama/Phi-2/Gemma-2 等)
→ 算子层 (Attention, FFN, RoPE, RMSNorm)
→ 运行时 (引擎, KV Cache, Sampler)
→ 14 个 WGSL compute shader (dequant, matmul, RoPE, attention)
↓
Vulkan / D3D12 / Metal (自动选择)
这一层 WebGPU 抽象是关键——写一次 shader,跑在 NVIDIA、AMD、Intel、Apple Silicon 上。
不需要 CUDA Toolkit,不需要 Metal API,不需要安装任何 GPU 驱动 SDK。
Airframe 的数学精度也做了交叉验证:所有量化格式(F32, F16, Q4_0, Q8_0, Q4_K, Q5_K, Q6_K)都与 CPU 参考实现核对过。
Mac 实测
:M3 Ultra 上下载 shimmy-macos-arm64(7.1MB),启动瞬时完成。
WSL 实测
:Linux x86_64 二进制 8.3MB,启动 <100ms。
● ● ●
把 KV Cache 压到 7 分之一
v2.1 加了一个叫
TurboShimmy
的功能:在 GPU 上做 KV cache 的 INT4 压缩。
KV cache 是 LLM 推理中最大的显存开销。默认存 F32 精度,Llama-3.2-3B 在 2048 token 上下文下,KV cache 要占 ~512MB 显存。TurboShimmy 把它压到
72MB
——7 倍差距。
效果很直接:3B 模型能在 4GB 显存的显卡上跑了。而这一切是在 GPU 上完成的(WGSL shader),没有 CPU 往返。
# 一行启用 ./shimmy serve --kv-quant int4
● ● ●
实测对比:Shimmy vs Ollama vs llama.cpp
|
维度
|
Shimmy
|
Ollama
|
llama.cpp
|
|
二进制大小
|
8.3MB
|
680MB
|
89MB
|
|
启动时间
|
<100ms
|
5-10s
|
1-2s
|
|
内存开销
|
~50MB
|
200MB+
|
~100MB
|
|
OpenAI API 兼容
|
100%
|
部分
|
无
|
|
GPU 后端
|
WebGPU(跨平台)
|
CUDA/Metal
|
CUDA/Metal/Vulkan
|
|
Python 依赖
|
零
|
Go+Python
|
Python 脚本
|
|
LoRA 支持
|
原生(运行时合并)
|
需转换
|
需转换
|
|
INT4 KV Cache
|
✅原生 GPU
|
❌
|
❌
|
|
模型热切换
|
✅
|
❌
|
❌
|
Shimmy 做的事更窄,但做得更极致。
● ● ●
目前支持哪些模型
Shimmy 的模型支持是它最大的短板——只有 6 种架构:
|
模型
|
大小
|
最低显存
|
|
TinyLlama 1.1B
|
638MB
|
~800MB
|
|
Llama-3.2-1B
|
770MB
|
~1GB
|
|
Llama-3.2-3B
|
1.9GB
|
~2.5GB
|
|
Phi-2
|
1.7GB
|
~2.2GB
|
|
Gemma-2-2B
|
1.6GB
|
~2GB
|
|
StarCoder2-3B
|
1.8GB
|
~2.3GB
|
7B+ 模型(DeepSeek-Coder、Qwen2、Llama-3)在 roadmap 上,但需要 ≥16GB 显存。和 llama.cpp 的 100+ 模型覆盖比,差距明显。
不过对于 IDE 辅助编程场景(Continue.dev + StarCoder2 或 Cursor + Llama-3.2-3B),当前覆盖已经够用了。
● ● ●
谁适合用 Shimmy
-
已有 GGUF 模型的开发者
:模型在 HuggingFace 缓存或 Ollama 目录下,Shimmy 自动发现
-
想嵌入推理到自己的工具里的
:8MB 二进制,打包进 DuckDB、桌面 App、CLI 工具都毫无压力
-
在意启动速度的
:打开 IDE 的同时推理服务就绪,不用等
ollama serve
-
用 WebGPU 的
:NVIDIA/AMD/Intel/Apple Silicon 通吃,不用装 CUDA
谁不适合:
-
需要 7B+ 大模型的(等 roadmap)
-
需要 Ollama 的模型下载/管理功能的(Shimmy 只管服务,不管下载)
-
第一次接触本地 LLM 的(Ollama 的一键体验更友好)
● ● ●
风险
5.7K stars 的项目,核心维护者只有一个人。这是最大的单点风险。好在 MIT 许可证——真出问题可以 fork。
v2.3.0 和 v2.3.1 是 tag-only 发布(只有源码,没有预编译二进制),v2.2.0 是最后一个有预编译的版本。这可能是 CI 暂时没跟上,也可能是作者在调整发布流程。不过从源码编译也不复杂。
Windows 老显卡(GTX 10xx/16xx)需要加
--prefill-chunk 8
避免超时——这是 WebGPU 在老硬件上的已知限制。
Shimmy 证明了纯 Rust + WebGPU 能做完整的 LLM 推理引擎。不需要 C++,不需要 CUDA,不需要 Python。本地推理的 680MB 时代可能快结束了。
GitHub: github.com/Michael-A-Kuykendall/shimmy
 alitrack alitrack约 4 分钟