快、稳、成功率 99.9%!七牛云 Token 服务完成信通院性能攀登
七 推进模型迭代的 推进模型迭代的约 3 分钟
企业第一次接入大模型时,关注的是:有哪些模型?API 怎么接?价格怎么算?
当 AI 应用真正跑起来,问题会变得更加具体:AI Coding 生成代码时能不能持续稳定输出?智能体连续调用多个模型和工具时,会不会因某个环节不稳定而中断?
企业需要的是一个响应够快、调用够稳、能够支撑生产业务的 Token 服务。 最近,七牛云在这件事上交出了一份成绩单。
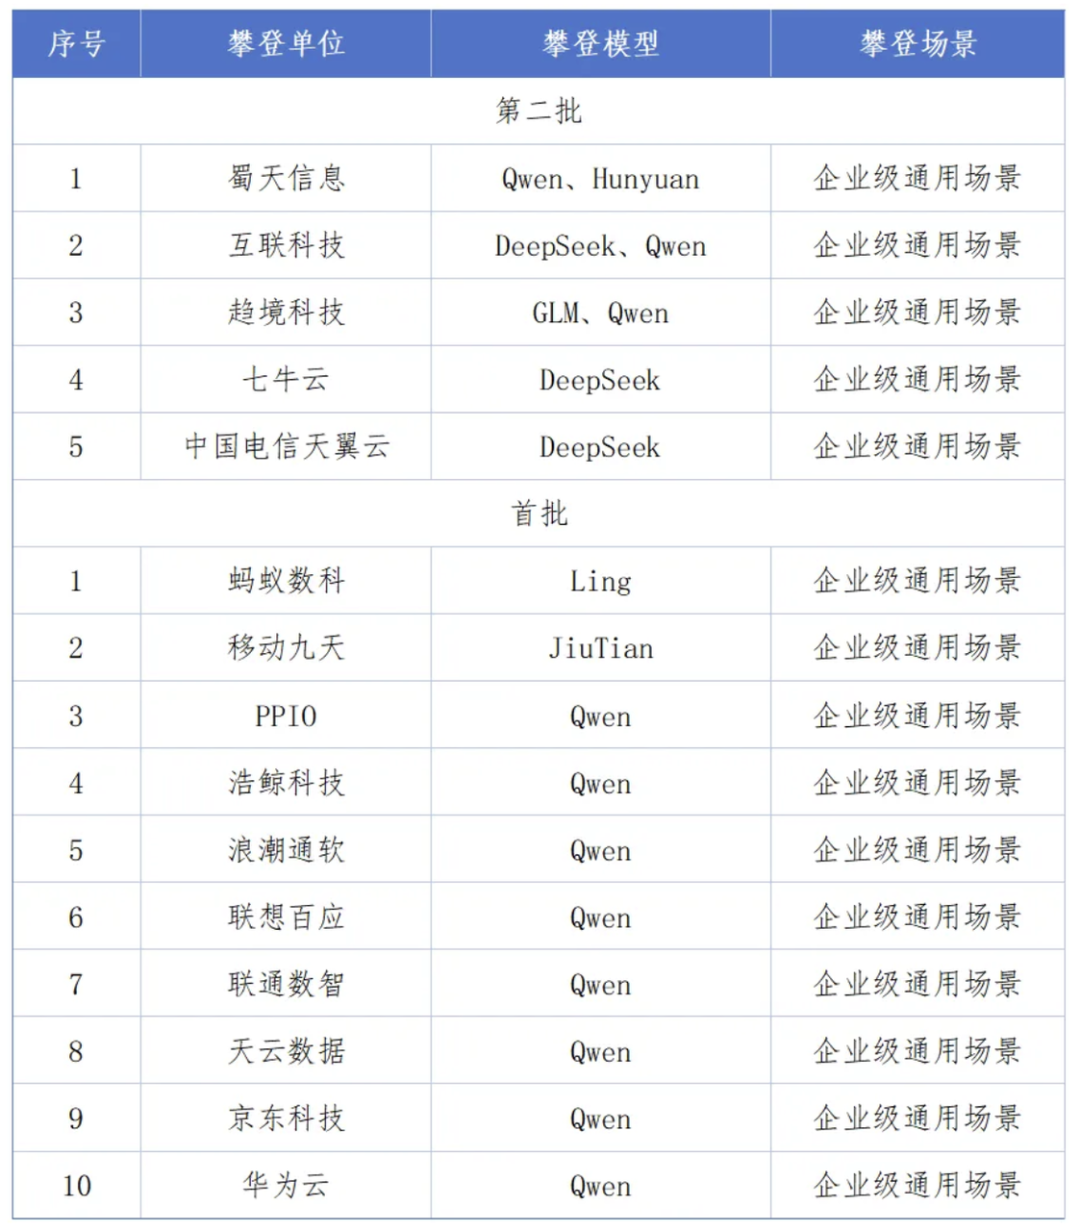
中国信息通信研究院正式公布第二批“词元(Token)服务能力攀登计划”结果, 七牛云达到“企业级通用场景 Token 服务性能攀登基线”,成为本批次五家攀登成功单位之一 。
相较于首批参评服务主要集中在 Qwen 系列模型,第二批攀登进一步覆盖了 DeepSeek 、 GLM 等主流模型服务。随着参评模型类型和服务场景更加丰富,本次攀登也对平台的多模型适配、推理调度和稳定服务能力提出了更综合的要求。
01 三项指标,检验企业级 Token 服务能力
随着大模型加速进入企业业务,Token 调用正在从零散试用走向规模化、高频化。
国家数据局统计数据显示,截至 2026 年 3 月底,我国日均 Token 调用量已突破 140 万亿,较 2024 年初增长逾千倍。调用规模快速增长,也让行业需要一套统一、客观的性能标准,衡量不同 Token 服务能否真正支撑企业级业务。
在此背景下,中国信通院启动“词元(Token)服务能力攀登计划”。该计划围绕 Token 服务工程化落地中的性能、稳定性和成本等关键问题,通过中国信通院“大模型 Token 服务性能监测平台”开展测试,并按季度动态更新行业统一的性能基准。
本次企业级通用场景性能攀登主要考察三项核心指标:
放到企业真实业务中,这些指标的价值会在持续调用中被进一步放大:
一次业务可能需要发起成百上千次模型请求,一个 Agent 任务也可能需要连续完成多轮模型调用。单次调用中看似细微的性能差异,会在长期、高频运行中不断累积,最终影响整体业务效率、资源消耗和服务稳定性。
七牛云 AI 大模型推理服务聚合多类主流模型能力,覆盖文本生成、代码生成、复杂推理、图像、语音及多模态等应用方向。
企业可以通过统一入口接入和调用不同模型,减少重复适配不同模型接口的开发工作,并根据业务需求灵活选择和切换模型。
目前, 七牛云提供按量调用、融合资源包和企业级 Token Plan 等服务方式,满足企业从产品验证、应用开发到规模化调用的不同需求 。
02 以行业标准推动 Token 服务高质量发展
中国信通院“词元(Token)服务能力攀登计划”以“建基准、提性能、稳服务、降成本、聚生态”为核心方向,聚焦 Token 服务工程化落地中的关键问题,并通过监测数据动态更新行业统一的性能基准。
此次达到中国信通院企业级通用场景 Token 服务性能攀登基线,是对七牛云 Token 服务性能和工程化能力的一次行业验证,也为企业评估和选择 Token 服务提供了更加客观的参考。
接下来,七牛云将完善 AI Cloud 服务体系,让企业能够更简单、更稳定、更高效地使用大模型能力,加速 AI 应用从想法走向落地。
推荐阅读
当 AI 应用真正跑起来,问题会变得更加具体:AI Coding 生成代码时能不能持续稳定输出?智能体连续调用多个模型和工具时,会不会因某个环节不稳定而中断?
企业需要的是一个响应够快、调用够稳、能够支撑生产业务的 Token 服务。 最近,七牛云在这件事上交出了一份成绩单。
中国信息通信研究院正式公布第二批“词元(Token)服务能力攀登计划”结果, 七牛云达到“企业级通用场景 Token 服务性能攀登基线”,成为本批次五家攀登成功单位之一 。
相较于首批参评服务主要集中在 Qwen 系列模型,第二批攀登进一步覆盖了 DeepSeek 、 GLM 等主流模型服务。随着参评模型类型和服务场景更加丰富,本次攀登也对平台的多模型适配、推理调度和稳定服务能力提出了更综合的要求。
01 三项指标,检验企业级 Token 服务能力
随着大模型加速进入企业业务,Token 调用正在从零散试用走向规模化、高频化。
国家数据局统计数据显示,截至 2026 年 3 月底,我国日均 Token 调用量已突破 140 万亿,较 2024 年初增长逾千倍。调用规模快速增长,也让行业需要一套统一、客观的性能标准,衡量不同 Token 服务能否真正支撑企业级业务。
在此背景下,中国信通院启动“词元(Token)服务能力攀登计划”。该计划围绕 Token 服务工程化落地中的性能、稳定性和成本等关键问题,通过中国信通院“大模型 Token 服务性能监测平台”开展测试,并按季度动态更新行业统一的性能基准。
本次企业级通用场景性能攀登主要考察三项核心指标:
- 每秒输出 Token 数(TPS)≥55 个/秒
- 首 Token 时延(TTFT)≤0.9 秒
- 调用成功率≥99.9%
放到企业真实业务中,这些指标的价值会在持续调用中被进一步放大:
- 更高的输出速度: 面对长文本、代码生成和 Agent 长任务,可以缩短单次生成及整体任务执行时间;
- 更低的响应时延: 在高频请求和多轮链式调用中,每一步都能更快启动,减少整条任务链的累计等待;
- 更高的调用成功率: 在大量、持续的 API 请求下,能够减少任务中断和重复调用,为生产业务的稳定运行提供支撑。
一次业务可能需要发起成百上千次模型请求,一个 Agent 任务也可能需要连续完成多轮模型调用。单次调用中看似细微的性能差异,会在长期、高频运行中不断累积,最终影响整体业务效率、资源消耗和服务稳定性。
七牛云 AI 大模型推理服务聚合多类主流模型能力,覆盖文本生成、代码生成、复杂推理、图像、语音及多模态等应用方向。
企业可以通过统一入口接入和调用不同模型,减少重复适配不同模型接口的开发工作,并根据业务需求灵活选择和切换模型。
目前, 七牛云提供按量调用、融合资源包和企业级 Token Plan 等服务方式,满足企业从产品验证、应用开发到规模化调用的不同需求 。
02 以行业标准推动 Token 服务高质量发展
中国信通院“词元(Token)服务能力攀登计划”以“建基准、提性能、稳服务、降成本、聚生态”为核心方向,聚焦 Token 服务工程化落地中的关键问题,并通过监测数据动态更新行业统一的性能基准。
此次达到中国信通院企业级通用场景 Token 服务性能攀登基线,是对七牛云 Token 服务性能和工程化能力的一次行业验证,也为企业评估和选择 Token 服务提供了更加客观的参考。
接下来,七牛云将完善 AI Cloud 服务体系,让企业能够更简单、更稳定、更高效地使用大模型能力,加速 AI 应用从想法走向落地。
推荐阅读