复现Nature子刊图,换数据可用!
p pythonic生物人约 2 分钟
本次使用R复现Nature biotechnology上的两张图。
下面介绍R语言快速复现该图。
✅读入测试数据,
✅关键代码,
# 核心代码
for(column in seq_len(n_cols)){#遍历每一个序列位点(列)
for(row in seq_len(n_rows)){#遍历每一种氨基酸(行)

#将矩阵行号转换为绘图坐标
#因为R矩阵第1行在顶部,而base plot的y=1在底部
#所以通过n_rows-row+1实现“上下翻转”
y<-n_rows-row+1

#绘制一个矩形格子,表示一个(氨基酸×位点)的替换
rect(
column-0.5,#矩形左边界(x方向)
y-0.5,#矩形下边界(y方向)
column+0.5,#矩形右边界
y+0.5,#矩形上边界

#根据score值映射到对应的颜色
col=score_to_color(score[row,column]),

#格子边框颜色(灰色)
border="#66717a",

#边框线宽
lwd=0.45
)
}
}
✅该图中,
子图b,野生型 BoNT/X 在 VAMP1 来源的 17-mer 肽段上的底物富集图谱,该肽段已比对至 procaspase-1 的底物序列背景中。黄色线标示预测剪切位点。 子图c,突变体 X(PC) 在用于进化的 17-mer procaspase-1 底物上的底物富集图谱。黄色线标示预测剪切位点,黄色框标示天然氨基酸。星号表示终止密码子。
本期结束!
获取绘图代码+测试数据+数据处理方法+依赖包安装方法,
👇(备注:299)
更多干货👉2026可视化工具TOP3,旨在引导如何系统学习Python/R可视化,部分展示如下: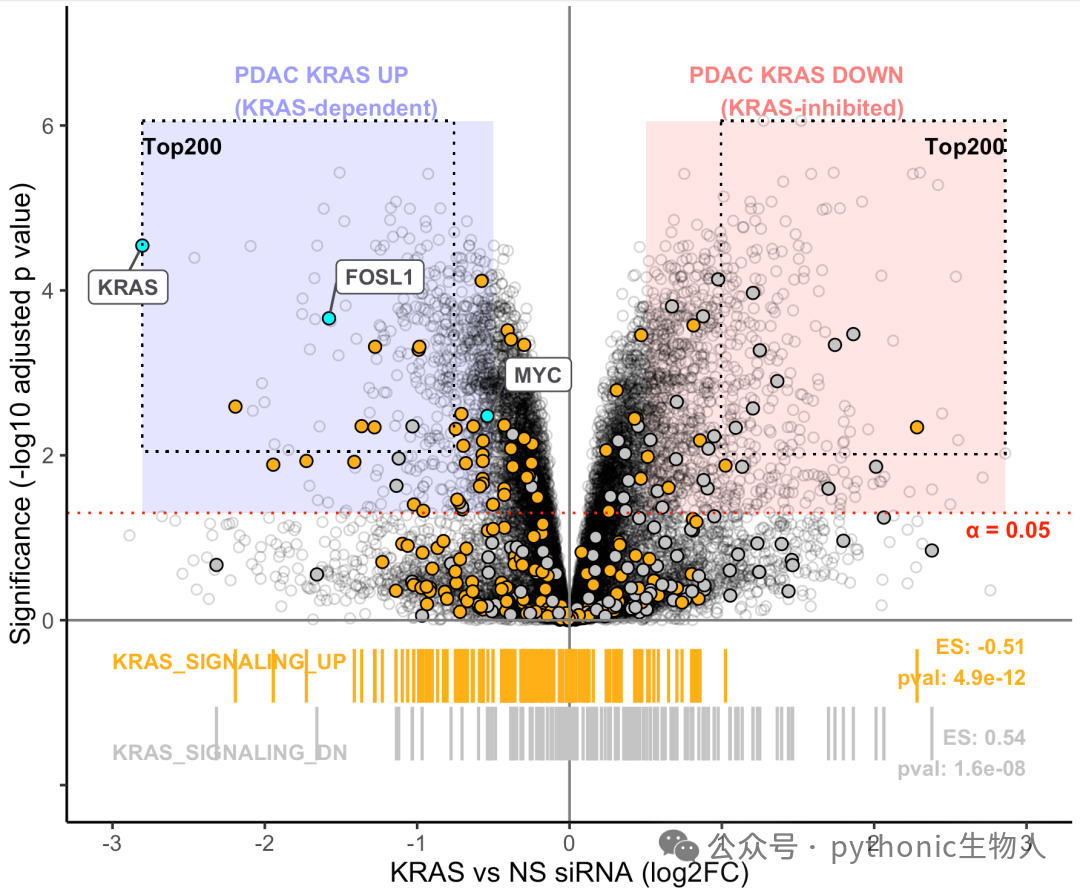
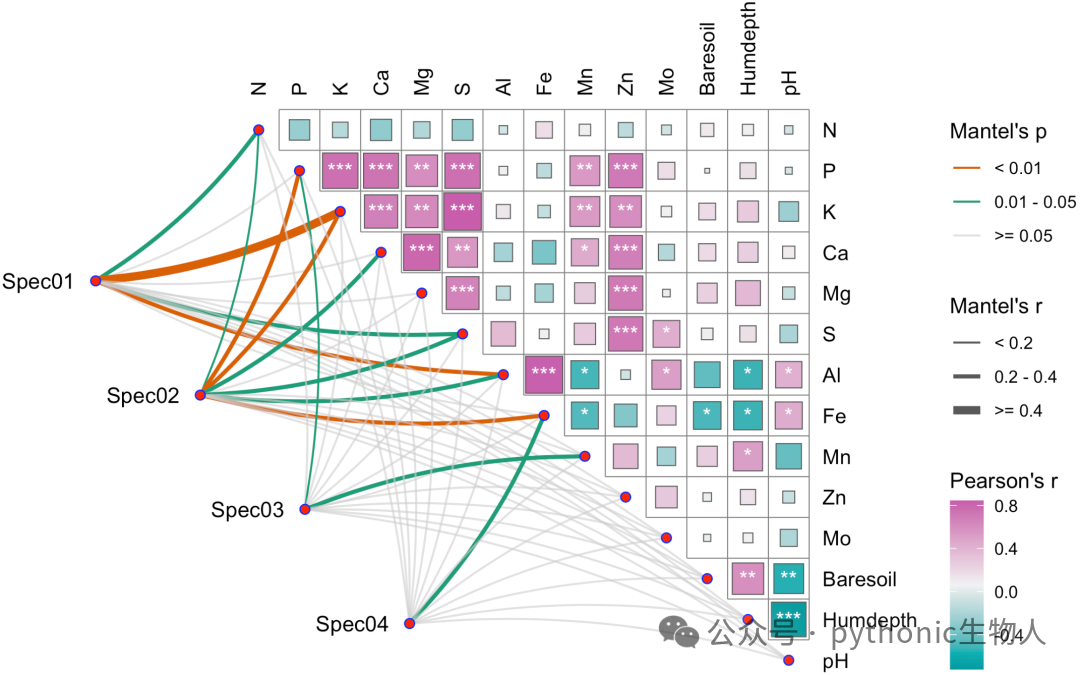
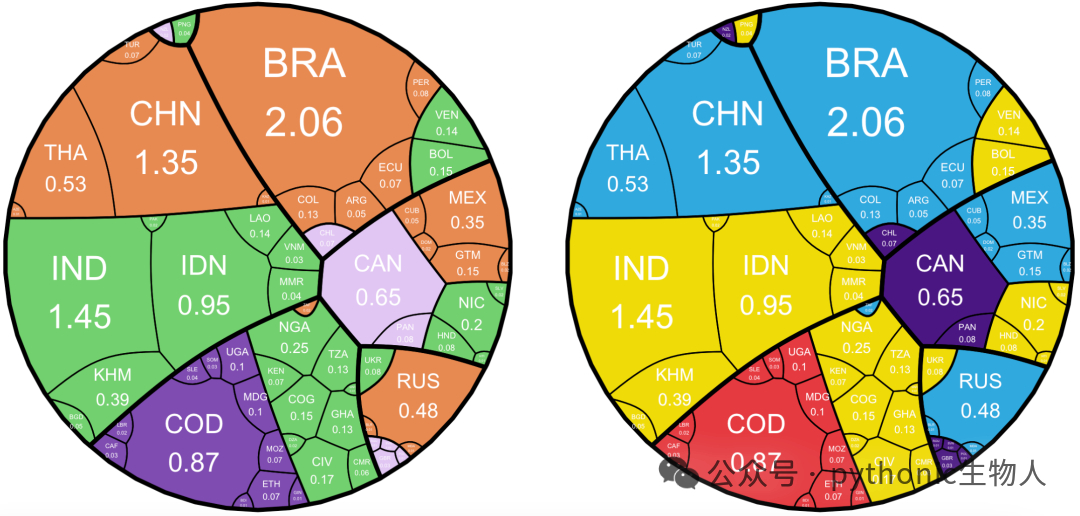
(加入学习,收费,备注:299)