Pigsty v4.5 发布:575扩展、Silo、Valkey、Kafka与MySQL
非 冯若航 冯若航约 12 分钟
Pigsty v4.5 正式发布。
上一版发布
的时候说过,5.0 之前可能会有一个 4.5 版本。现在它来了,只是做着做着发现,这个 “过渡版本” 塞得比正经大版本还满。
本来老冯还想放更多的东西进来,但是正好赶上了一个关键时间节点,也就是
PostgreSQL 发布了紧急的号外小版本
,修了 28 个 CVE 和 110 个 bug。 很明显,这个小版本的升级优先级会非常高,所以我们也立刻跟进发布了 Pigsty v4.5
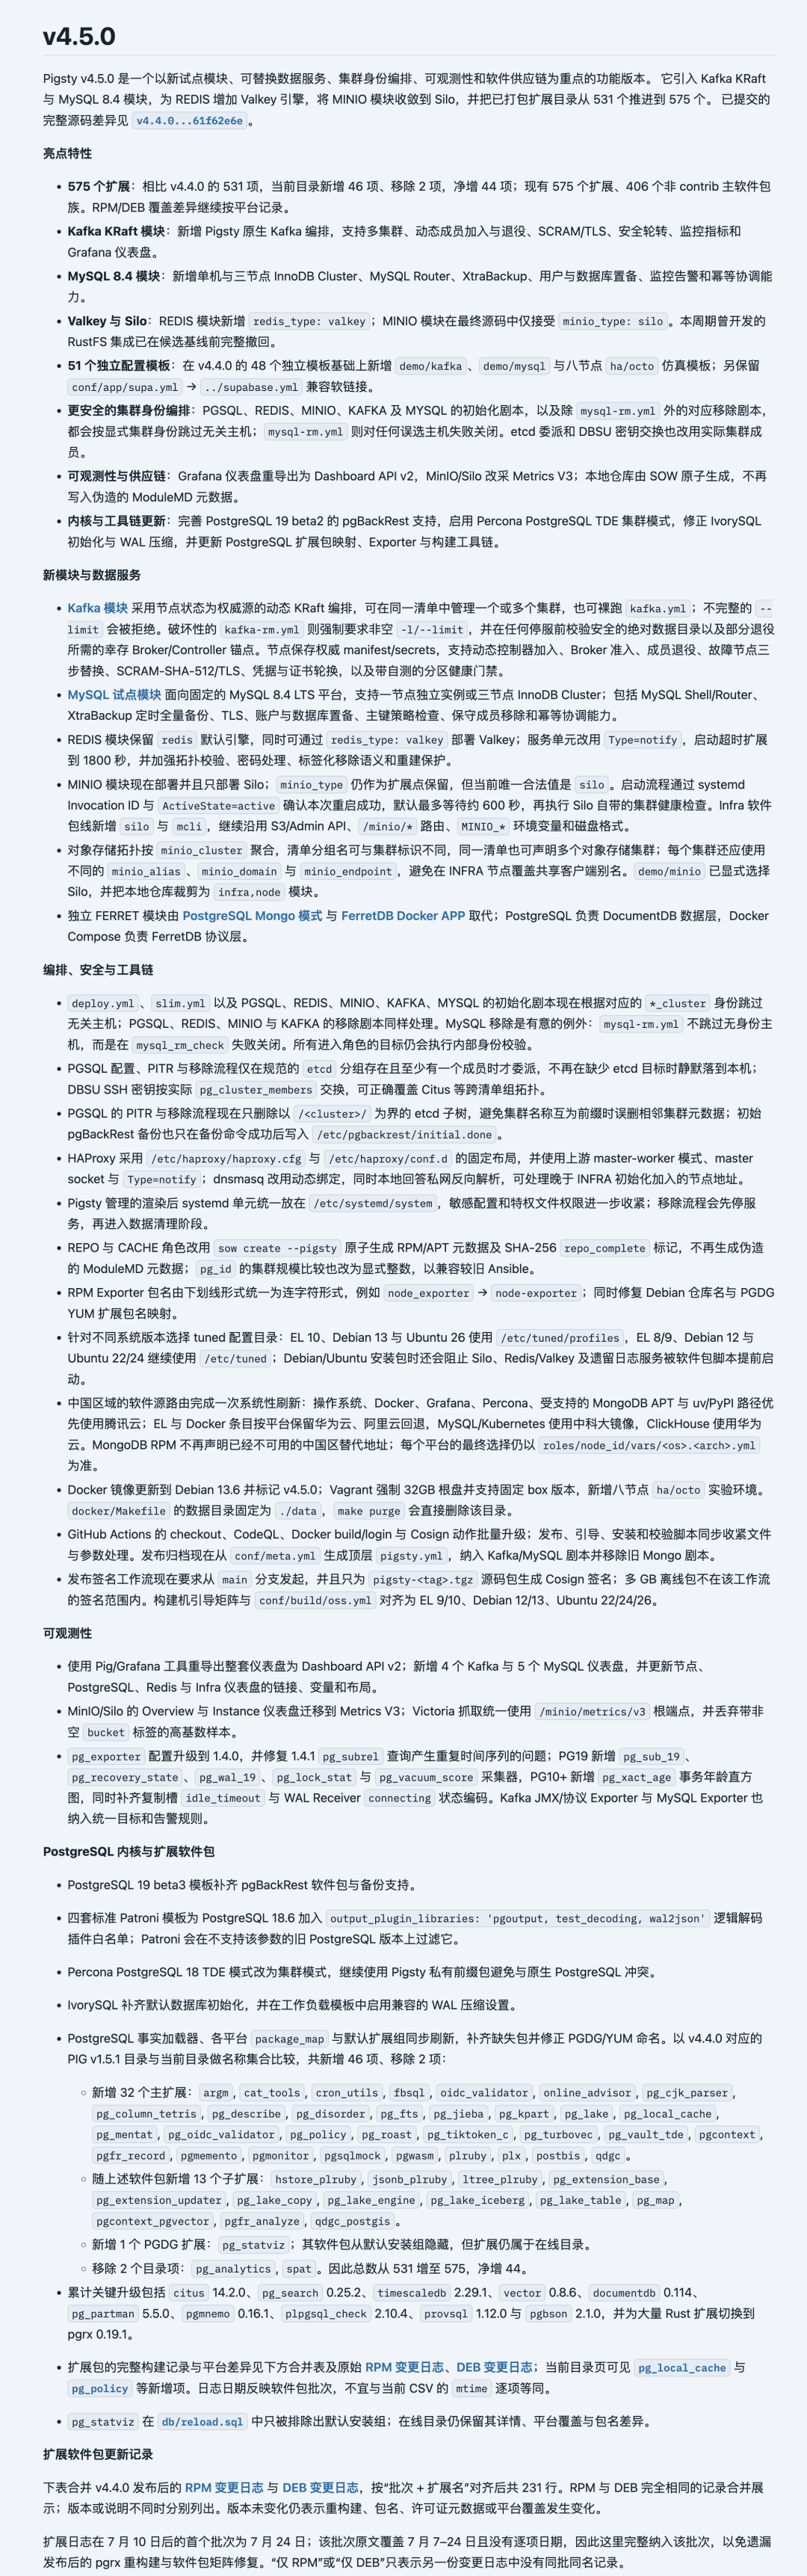
先拉个清单,v4.5 里有什么:
•
575 个 PostgreSQL 扩展
:从 531 涨到 575,pg_lake、pg_jieba、plruby 这些都进来了。
•
Silo 对象存储
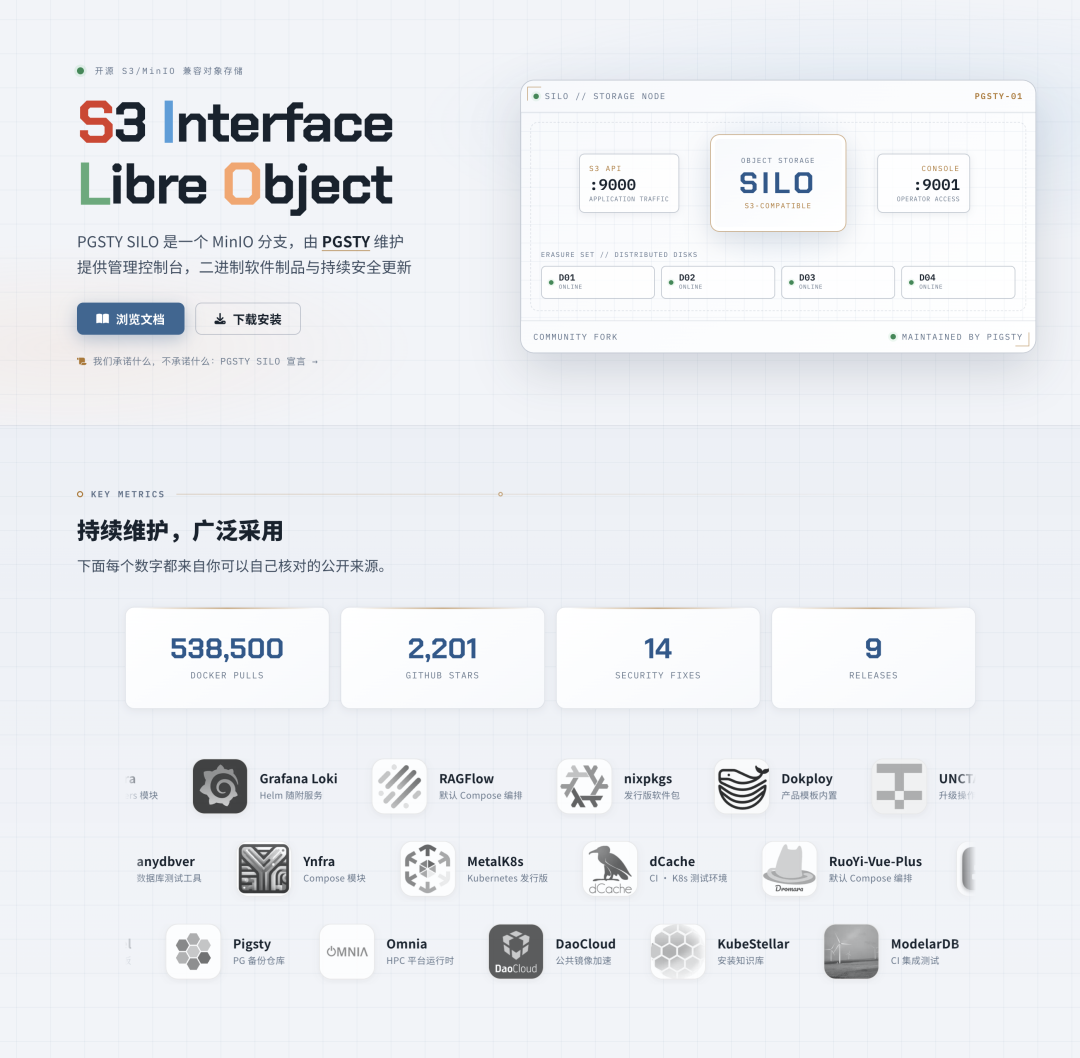
:MINIO 模块正式换芯,切换到 Pigsty 自家维护的 MinIO 分支 —— Silo。
•
Valkey
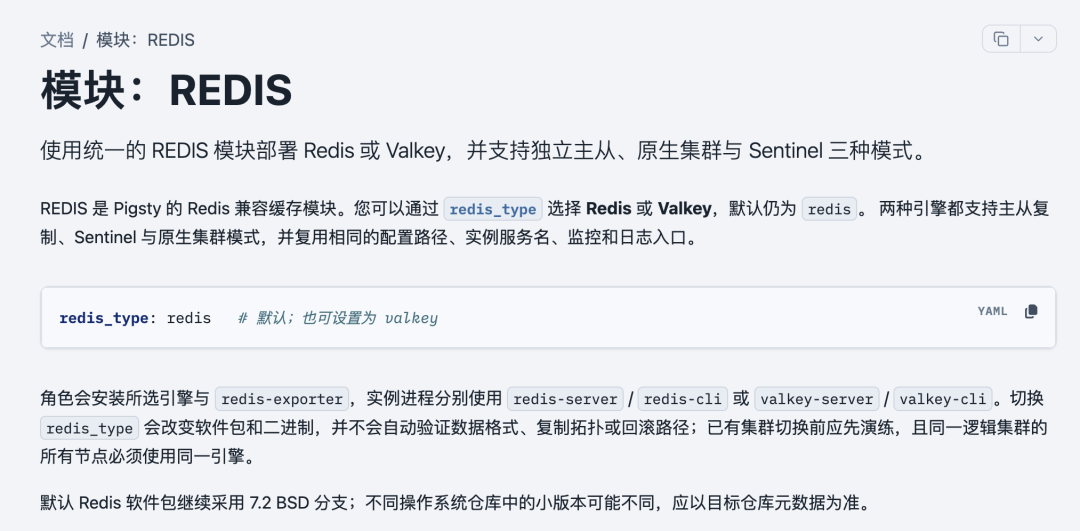
:REDIS 模块新增 Valkey 引擎,一个参数切换,清单、监控、面板原样保留。
•
Kafka 模块
:全新试点模块,Pigsty 原生 KRaft 编排:多集群、动态成员、SCRAM/TLS、四个监控面板。
•
MySQL 模块
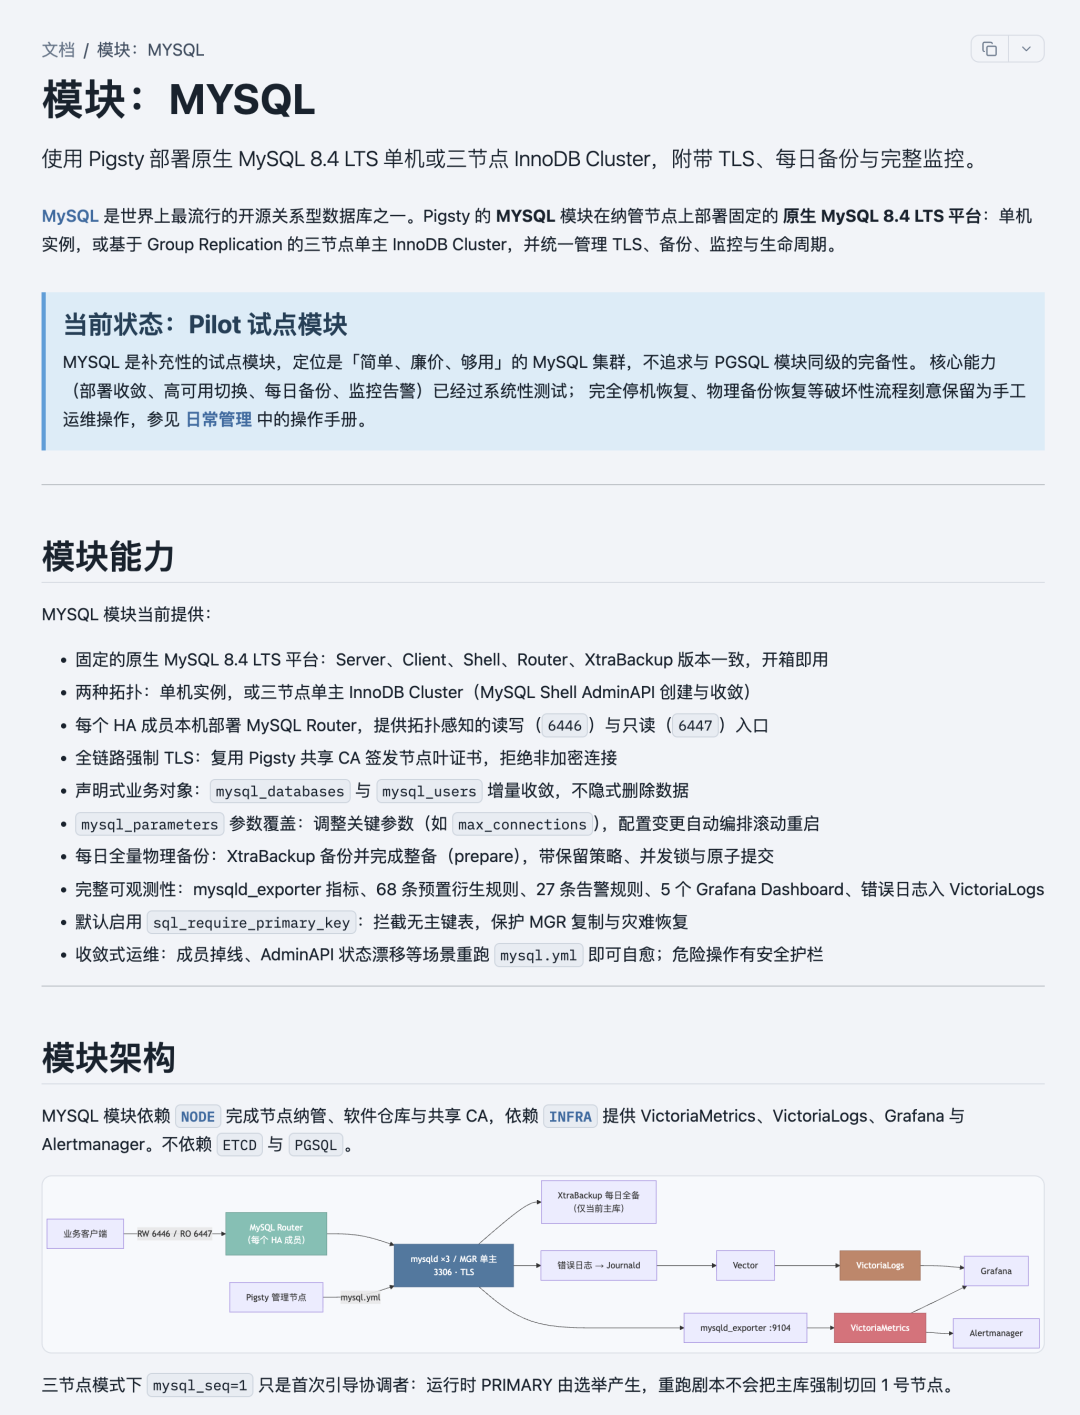
:是的,MySQL,你没看错。8.4 LTS,单机或三节点 InnoDB Cluster,同样是试点。
•
剩下是一堆零碎但有用的东西:显式集群身份、更稳的移除流程、pg_exporter 1.4、SOW 仓库工具、51 套配置模板……
下面按这个顺序,一项一项说。
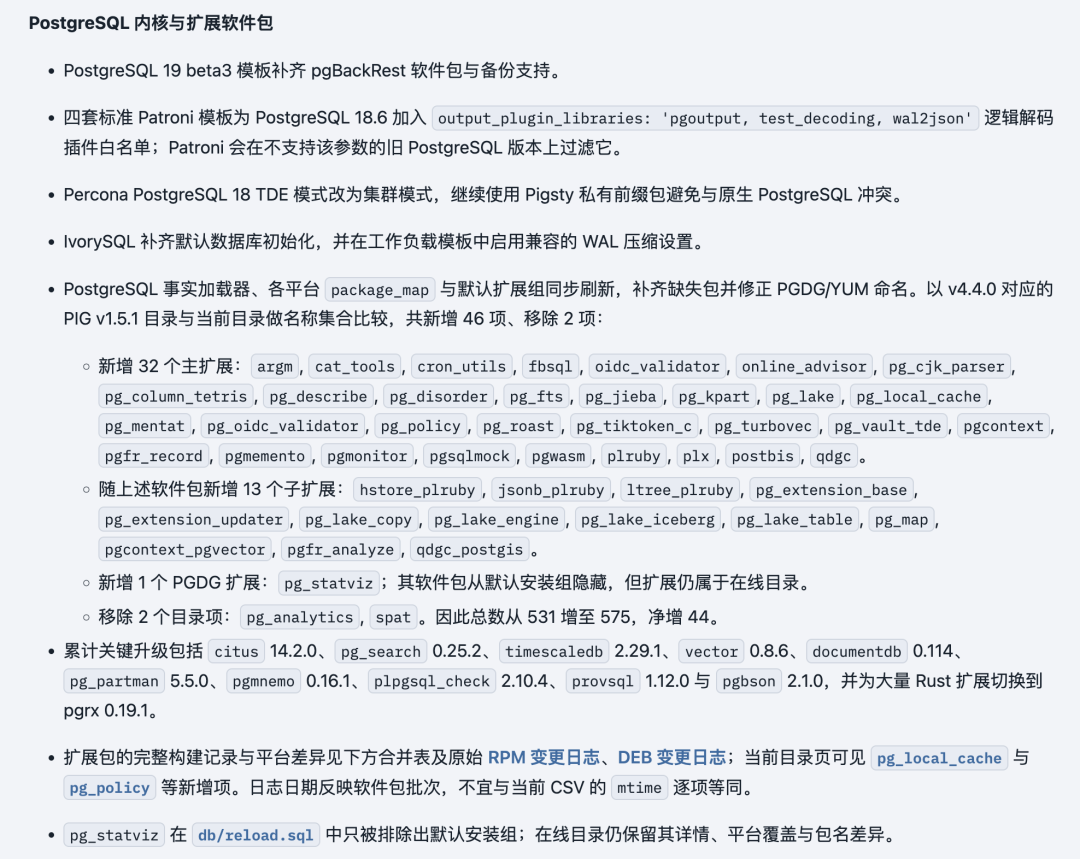
常规升级也没停:Citus 14.2、TimescaleDB 2.29.1、pgvector 0.8.6、pg_search 0.25.2、DocumentDB 0.114、pg_partman 5.5、pgmq 1.12……完整的软件包变更表见
发布注记
[3]
。 两百多行,很壮观的一个表格,就不搬过来了。
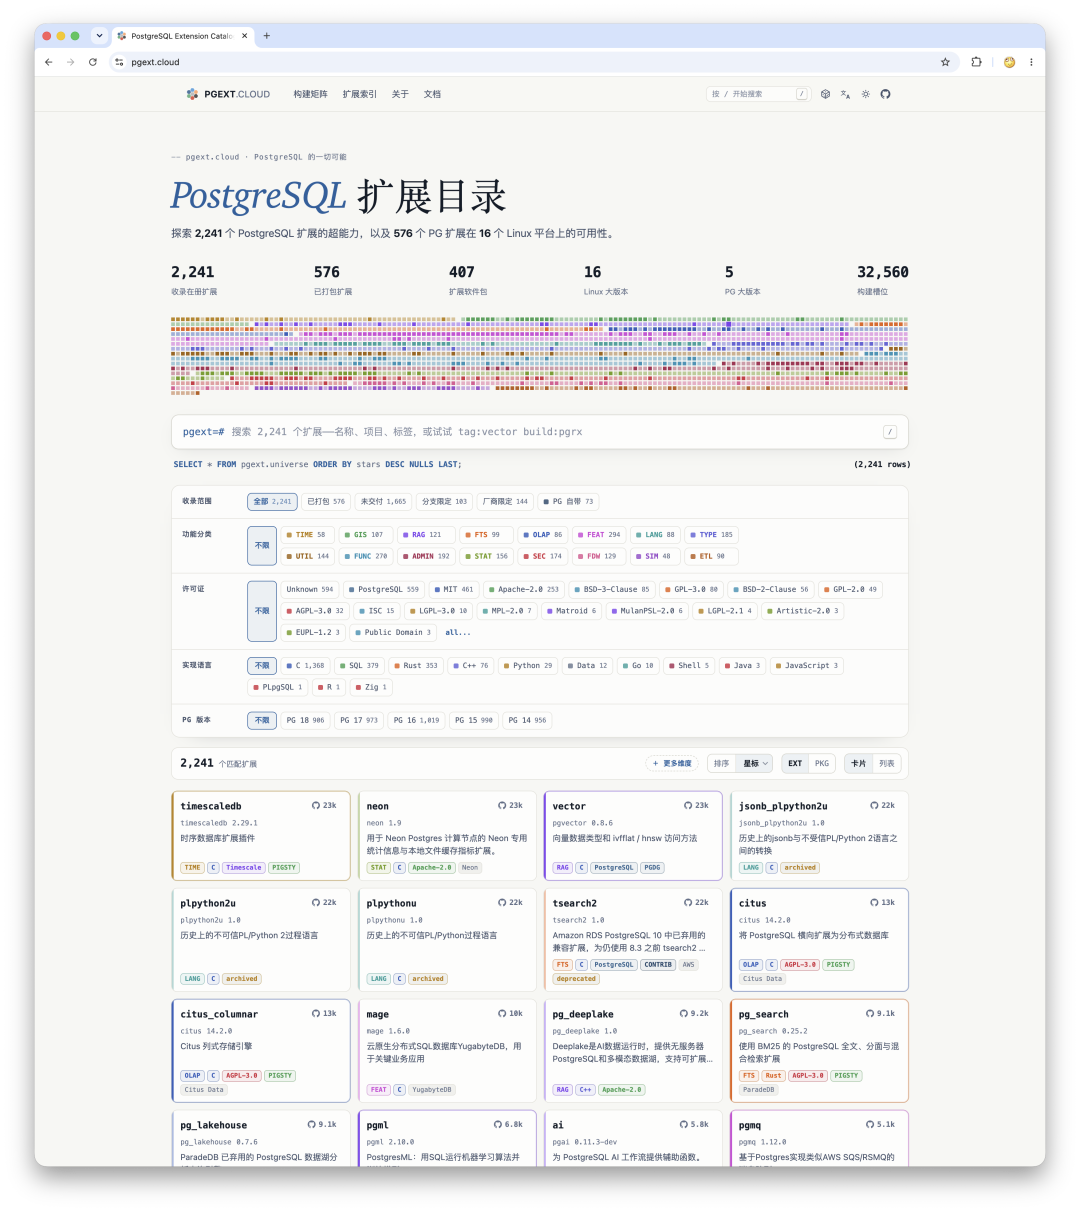
除此之外,我们还发布了 PGEXT.CLOUD 的全新版本,这是一个面向 PostgreSQL 扩展的云端索引与搜索服务,提供扩展的搜索、版本对比、依赖关系分析等功能,还提供中英文双语文档。
v4.5 把这件事做到了头:
MINIO 模块现在部署并且只部署 Silo
,
设计上我们刻意做成了 "无感切换":装的是
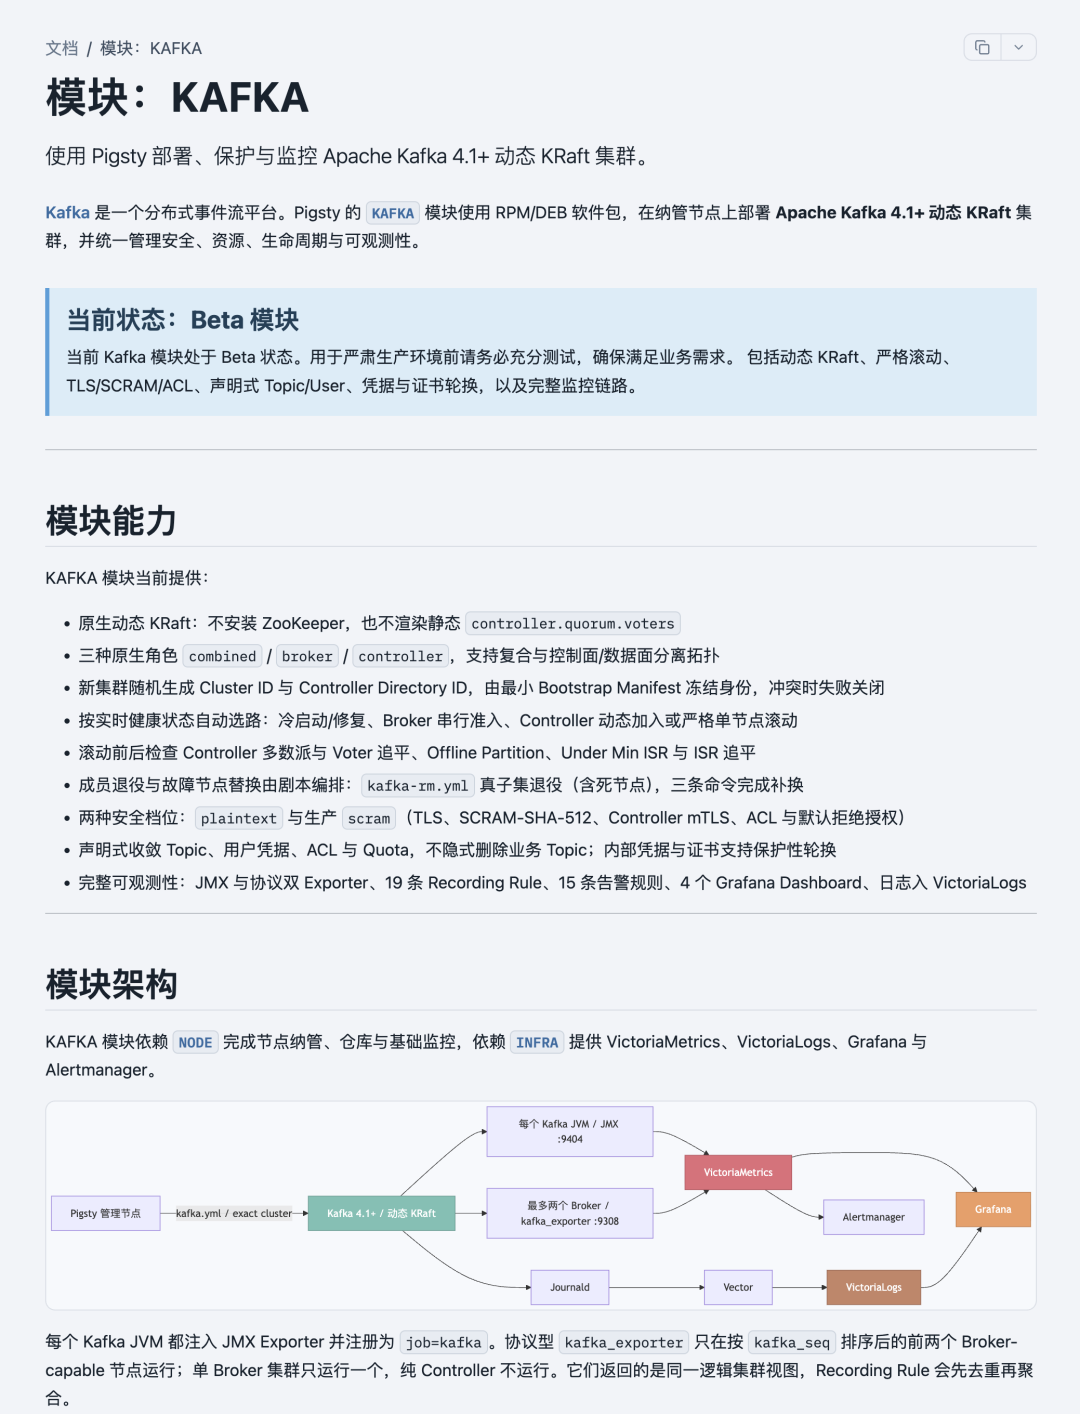
当然,虽然 Kafka 还是一个 Beta 模块,但是客户已经急不可耐地拿去用了。毕竟再怎么说起码监控高可用这些都做好了,也还是比自己手搓装上去要强多了。
这套模块基于 Kafka 4.3,纯 KRaft,没有 ZooKeeper,按 Pigsty 的习惯从头写的编排:想试的话有现成模板:
demo 模板:
数据库老司机
点一个关注 ⭐️,精彩不迷路
对 PostgreSQL, Pigsty,下云 感兴趣的朋友 欢迎加入 PGSQL x Pigsty 交流群 (QQ 619377403 )
扩展来到 575 个
每个版本都要报一遍扩展数字,这次是 575 —— 相比 v4.4 的 531,新增 46 个、移除 2 个,净增 44。完整目录照旧在 扩展列表 [1] 里,这里只点几个值得说道的新面孔: •
pg_lake
[2]
全家桶:Snowflake 收购 Crunchy Data 之后开源的湖仓扩展,用 DuckDB 做向量化执行引擎,把 Iceberg 与 Parquet 直接接进 PostgreSQL。这是今年 PG 生态在数据湖方向上最重要的新东西,Pigsty 第一时间打好了包(PG 16–18,RPM 侧目前仅 EL9/10)。
•
pg_jieba
与
pg_cjk_parser
:中文与 CJK 分词。做中文全文检索的用户应该知道这意味着什么 —— 以前要自己编译 pg_jieba 的朋友可以省事了。
•
plruby
:Ruby 存储过程语言,连带 hstore / jsonb / ltree 三个类型转换子扩展一起打包。PL 语言拼图又补上一块,至于谁会真的用 Ruby 写存储过程,我也很好奇。
•
pgmemento
:纯 SQL 实现的审计与数据变更追踪,给表上加一条完整的时光轴。
•
online_advisor
:根据实际执行的查询在线给出索引建议。
•
pg_turbovec
、
pgcontext
、
pg_tiktoken_c
:向量与 RAG 方向继续加码,
•
做 Agent 记忆的
pgmnemo
扩展。
•
还有
pgwasm
(WebAssembly)、
postbis
(生物信息序列)、
qdgc
(地理网格,含 PostGIS 子扩展)、
pg_vault_tde
(对接 Vault 的透明加密)这些各有各用处。
除了上新,这一轮还把几乎所有 Rust 扩展迁移到 pgrx 0.19.1 ,整体重新构建了一遍。表面上看很多包版本号没变,背后是整个构建矩阵的重跑。
移除了两个:
pg_analytics
(上游已归档)和
spat
(废弃的 alpha 项目)。另外有五个扩展(
emailaddr
、
explain_ui
、
oidc_validator
、
pg_summarize
、
smlar
)因为上游没有提供许可证,从默认安装组里移了出来,软件包都还在,只是从默认安装集里去掉了。
Silo:对象存储换芯
MinIO 的事,老读者都熟:上游把管理界面砍成登录页,社区版接近弃疗,我 fork 了一份续命,修了 CVE,写过《 MinIO已死 [4] 》和《 续命 MinIO:承诺兑现 [5] 》。 这个分支后来有了自己的名字: Silo ,筒仓。猪圈(Pigsty)旁边立一个饲料塔(Silo),再配上包管理器小猪(pig)和仓库工具母猪(sow),一家人整整齐齐。 Silo 发布:兼容 S3/MinIO 的开源对象存储
minio_type
参数目前唯一合法值就是
silo
。 兼容性不用担心:S3 与 Admin API、
/minio/*
路由、
MINIO_*
环境变量、磁盘数据格式全部保持原样, 变的只是软件包、二进制与 systemd 服务的名字。对存量用户来说,这更像换了个牌子的发动机,底盘和方向盘都没动。
当然,协议兼容不等于迁移自动验收。切换生产对象存储之前,备份、回滚预案、真实读写验证,一样都不能省。
围绕 Silo 还有一圈配套改进:
•
启动流程用 systemd Invocation ID、
ActiveState
与 Silo 集群健康三重确认,最长等待约 600 秒,不会再把旧进程的状态误判成本次启动成功。
•
对象存储集群按
minio_cluster
身份聚合,同一份清单可以声明多套集群,各用各的
minio_alias
与
minio_endpoint
。
•
高可用模板
ha/trio
从单节点对象存储改成三节点单盘 Silo(EC:1),通过 VIP 与 HAProxy 暴露 9002 端口。
•
分布式 Silo 强制要求
/data/minio
是独立文件系统,根分区下的普通目录会被直接拒绝 —— 这条是在帮你避开 "把生产对象存储放在根分区上" 这类事故。
至于 RustFS:这个开发周期里我们确实把 RustFS 后端做进去过,最后在发布前撤了回来。 它还差一口气,我听作者说 9.16 正式 GA,那就等它真正 GA 稳定之后再说。 仓库里保留了 rustfs 软件包(1.0.0-rc.1),想自己折腾可以装着玩,在 Pigsty 5.0 的时候希望能把它正式纳入 MINIO 模块的可选类型中。
Valkey:Redis 之外的选项
Redis 许可证的 Drama 我写过不少,比如《 Redis不开源是"开源"之耻,更是公有云之耻 [6] 》。 后来 Redis 8 又回到了 AGPL,但社区分叉出来的 Valkey 已经自成一派:Linux 基金会背书,主流发行版全都收了。总有用户问:Pigsty 能不能用 Valkey? 现在可以了:
redis_type: valkey
,一个参数的事。我没有想好要不要把 Valkey 作为
默认的 redis 替代
,但这个决定应该在 5.0 落地。
valkey-server
/
valkey-cli
,但配置路径、数据目录、服务名、监控 job、模块参数全部沿用
redis
命名空间。 已有的清单、面板、告警规则一行都不用改。注意引擎选择以集群为单位,同一套集群别混着用;存量 Redis 集群要切 Valkey,请先在测试环境演练,数据与复制兼容性自己验证过再动手。
顺便说一句,老冯还在打包 Valkey 的时候挖出了官方上游和 Debian 里的一个 Bug —— 《
上游没有的 Bug,为什么会出现在官方包里?
[7]
》。
这次 Redis/Valkey 的 systemd 单元也顺手改成了
Type=notify
,启动超时放宽到 1800 秒, 大实例加载数据不会再被 systemd 掐死。拓扑构建、密码处理、移除保护也都加固了一轮。
Kafka:从软件包到模块
为什么一个 PostgreSQL 发行版要管 Kafka?因为在真实的大规模企业级数据架构里,PG 旁边十有八九蹲着一套 Kafka:CDC 变更捕获、消息队列、事件流,这些活总得有人干。 其实在很早以前,Pigsty 就提供了 Kafka 的试点模块,在 4.0 的时候就已经引入了。但是直到最近,我们的一个企业客户需要这样的一个功能,问我们有没有。 我想了一下,那就把它打磨做好一点吧,所以这次就跟着一起发布了。
conf/demo/kafka.yml
。
MySQL:没想到吧
说好的《 PostgreSQL 正在吞噬数据库世界 [8] 》呢?怎么反手就在 Pigsty 里发了个 MySQL 模块? 现实世界里 MySQL 存量巨大,很多用户的处境是新业务上 PG,老业务的 MySQL 还得养着;或者已经下定决心迁移,但迁完之前,这几十套 MySQL 总得有人管。 与其让用户为了遗留系统再单独搭一套监控、备份、高可用体系,不如让 Pigsty 的底座顺手把它管起来 —— 反正监控告警、备份恢复、集群编排这些基础设施本来就是通用的。 先圈进来,再慢慢消化,这很合理。 v4.5 的 MYSQL 模块 [9] (试点)长这样:demo 模板:
conf/demo/mysql.yml
。另外,如果你要的其实是 "让 PG 说 MySQL 协议",Pigsty 里还有
OpenHalo
[10]
这个选项。
零碎清单
大件说完了,下面是零碎但值得知道的部分。FERRET 模块拆分
独立的 FERRET 模块和
mongo.yml
剧本移除了。MongoDB 兼容这件事现在拆成两层:PostgreSQL 加 DocumentDB 扩展负责数据层(用
conf/mongo.yml
配置模板) ,FerretDB 作为 Docker 应用负责协议层。原来的 ferretdb systemd 服务、专属监控和面板不再提供。这样职责更清楚:数据的事归数据库,协议翻译的事归容器。
另一个更重要的原因是 FerretDB 看上去已经不再维护了。老冯知道背后的原因是 MongoDB 把 FerretDB 给告了, 但是它不敢告微软出品的 DocumentDB,所以 FerretDB 现在并入到 DocumentDB 的模板里面了
编排更安全了
这个版本在 "剧本不要误伤" 上花了不少功夫,值得单独列一下: • PGSQL、REDIS、MINIO、KAFKA、MYSQL 的初始化与移除剧本都按显式集群身份(
pg_cluster
等参数)选择成员,不再单纯依赖清单分组名。跑错分组的剧本会跳过无关主机,而不是 "顺手" 给它们装点什么。
•
PITR 与移除只清理以
/<集群名>/
为边界的 etcd 子树。以前两个集群名互为前缀时(比如
pg-test
和
pg-test2
),清理有机会误删邻居的元数据,现在不会了。
•
初始 pgBackRest 备份只在备份命令确实成功之后才写标记文件,不会再出现 "标记说备过了,其实没有" 的情况。
•
所有模块的移除流程统一为先停服务、再清理数据;Kafka、MySQL 与对象存储还额外检查数据目录、仲裁与幸存成员。
•
pgsql.yml
完整剧本现在明确标记为仅用于首次初始化。它会重启 Patroni/PostgreSQL 并重放配置与初始化 SQL,不是日常收敛工具,别在生产集群上整本重跑。
•
DBSU 的 SSH 密钥按实际集群成员交换,Citus 这类跨分组拓扑也能正确覆盖;Pigsty 渲染的 systemd 单元统一收进
/etc/systemd/system
,敏感配置与特权文件的权限进一步收紧。
这些改动没有一条是新功能,但每一条背后都对应着一类真实的生产事故。
可观测性
• 整套 Grafana 面板用 pig 的工具链重新导出为 Dashboard API v2 格式,新增 4 个 Kafka 面板与 5 个 MySQL 面板,Node / PGSQL / Redis / Infra 面板同步刷新。 •
pg_exporter
升级到 1.4 系列:为 PG19 预置了订阅、恢复状态、WAL、锁等待与 vacuum 压力等新采集器;PG10 以上增加
pg_xact_age
事务年龄直方图 —— 距离事务号回卷还有多远,现在可以直接画出来。
•
MinIO/Silo 面板迁移到 Metrics V3 端点,顺手丢掉了高基数的 bucket 标签样本,大桶用户的时序库会轻松不少。
仓库与供应链
• 本地软件仓库改由 SOW 生成 —— 就是 v4.4 结尾预告过的那个仓库管理工具(母猪)。
sow create --pigsty
原子生成 DNF/APT 元数据与 SHA-256 完成标记,彻底移除了以前注入的伪造 ModuleMD 元数据。
•
离线软件包现在可以附带版本化的源码包;自建软件包统一使用 SHA-256 固定输入、SPDX 许可证表达式与
1PGSTY
release 后缀。
•
RPM Exporter 包名从下划线统一为连字符(
node_exporter
→
node-exporter
),旧名通过 Provides/Obsoletes 平滑过渡。
•
中国区镜像路由整个刷了一遍:腾讯云优先,华为云、阿里云、中科大按平台兜底。
内核与平台
• 默认 PostgreSQL 更新到 18.6 ;四套标准 Patroni 模板加入
output_plugin_libraries
逻辑解码插件白名单(
pgoutput
/
test_decoding
/
wal2json
),旧版本内核会由 Patroni 自动过滤该参数。
•
PG19 beta 模板补上了 pgBackRest 2.59 的备份支持。v4.4 的时候 pgBackRest 还认不出 PG19 的控制文件,现在 PG19 尝鲜环境也能正经做备份了。
•
Percona PostgreSQL 18 TDE 启用集群模式;IvorySQL 修复了默认数据库初始化并启用兼容的 WAL 压缩。
•
操作系统基线推进到 Rocky 9.8 / 10.2、Debian 12.15 / 13.6、Ubuntu 22.04.5 / 24.04.4 / 26.04;Docker 基础镜像切到 Debian 13.6。
•
配置模板来到
51 套
:新增
demo/kafka
、
demo/mysql
与八节点仿真环境
ha/octo
;
ha/trio
改为三节点 Silo 拓扑。
•
Vagrant 根盘大小可配置(
root_disk
,默认 64G),
disk
继续表示额外的
/data
数据盘;虚拟机登录 Shell 统一为 Bash。
完整的 Infra 与扩展软件包变更记录见
发布注记
[11]
。
获取 v4.5
在一台受支持的全新 Linux 节点上:curl -fsSL https://repo.pigsty.io/get | bash -s v4.5.0什么,你问我怎么升级。哈哈,要我说,你还是新弄几台部署 pg_dump 过去最简单。
cd ~/pigsty
./bootstrap
./configure
./install.yml
写在最后
v4.4 的主题是 "从集成到发行",这个 v4.5 的主题,大概可以叫 "边界扩张":往 PG 生态内部看,扩展目录推进到 575;往外看,对象存储、缓存、消息队列、甚至 MySQL,都被收进了同一套编排、监控与交付体系。 有人可能会问:一个 PostgreSQL 发行版,管这么宽干嘛?我的看法是,用户要的从来不是 "一个数据库",而是一整套能跑业务的数据基础设施。 PostgreSQL 是这套基础设施的核心,但核心旁边的东西 —— 缓存、对象存储、消息队列、遗留数据库 —— 同样需要有人用同样的标准管起来。Pigsty 本来就是个猪圈,圈里从来不止一头猪。 下一站是 5.0。九月 PostgreSQL 19 正式发布,Pigsty 5.0 会带着完整的 PG19 支持一起来,大概会在九月底十月初。 5.0 的一个重要变化是我们将会切换到使用 仓库管理器 sow 构建的新的企业级制品仓库,提供 latest 与 stable 还有每月快照等多版本渠道,此外,GUI 管控工具 boar 也大概率会在这个版本实装。对 PostgreSQL, Pigsty,下云 感兴趣的朋友 欢迎加入 PGSQL x Pigsty 交流群 (QQ 619377403 )