跳到主要内容
MacTalk字节 Seed 团队发现了 DeepSeek-V4 的一种周期性弱点
M 池建强//约 5 分钟
墨问群里使用 DeepSeek-V4 的朋友跟我反馈过一些问题,比如:同一个问题,昨天问答挺好,今天换个说法,质量掉了一大块。按道理说,提示词没改啥啊,怎么模型像换了个人呢?偶尔一次没啥,次数多了,就应该是不确定性里确定的事儿了。昨天看了一篇文章,讲的是字节 Seed 团队的一项发现,为这种不确定性提供了一个工程层面的解释。(喜欢看结论的直接拉到最后看使用技巧)https://ultimatejupiter.github.io/blog/periodic-weak-spots/他们发现,在特定的检索和代码补全测试中,DeepSeek-V4 系列模型的表现会随着输入信息所处的位置,以 4 个 Token 为周期规律性波动。在 128K 长上下文的检索测试里,Flash 基础模型最好与最差位置组的准确率相差 40.2 个百分点。这能解释一种位置相关的波动,但还不足以确定群友遇到的问题就是这个原因。40 个百分点是啥概念?拿考试打个比方,30 分和 70 分之间,就隔着 40 分。不过这里测的是一组检索任务的准确率,不能直接换算成日常聊天质量,意思是这么个意思。咋回事呢,我和 AI 讨论了几轮,大概知道原因在哪了。DeepSeek-V4 采用分块 KV Cache 压缩技术来降低长上下文的开销,其中 CSA 使用 8 个 Token 的压缩窗口,每隔 4 个 Token 启动一个新窗口。窗口有重叠,不同位置的信息在压缩和检索过程中,被保留下来、重新找回来的能力存在系统性差异。大概可以这么理解,班里同学排长队,老师每次把连续八个人的情况记在一张纸上(摘要),然后往前走四个人,再记下一张。摘要之间有重叠,但每个人的信息未必都记得一样清楚。模型稍后要找某个人的信息时,他站在这张些摘要里的哪个位置,就可能影响找回来的效果。这叫相位敏感性。这里的相位,就是 Token 位置除以压缩步长后的余数。在研究测试的模型和任务中,弱点会沿着这个相位重复出现。示意图在这里: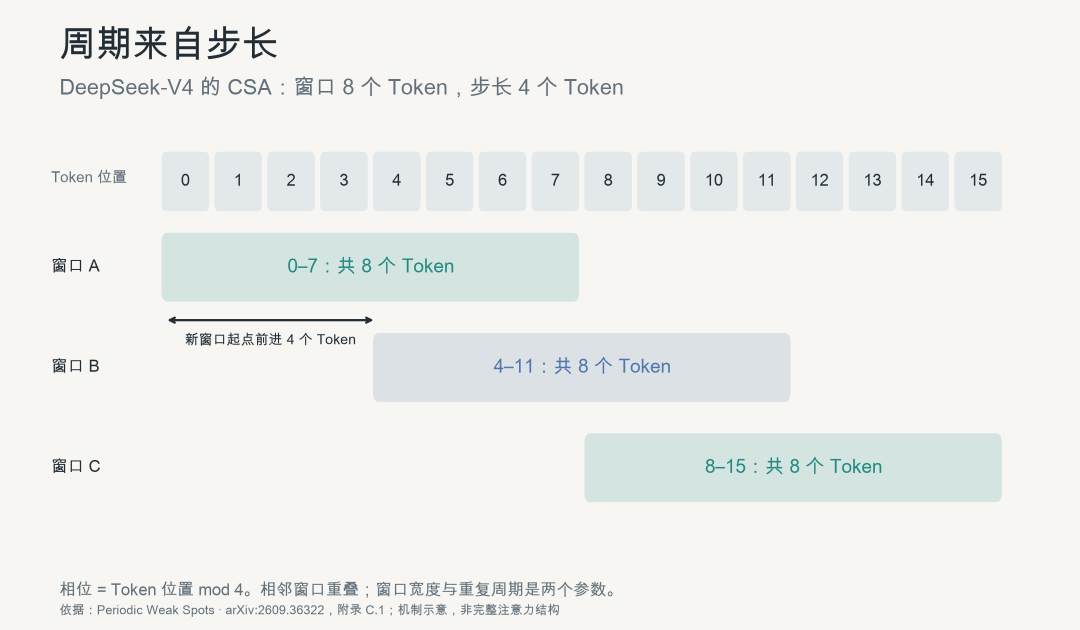 压缩窗口和步长示意。周期与步长对应,图中只展示 CSA 的分块关系研究还提到,后训练能够提高准确率、缩小差距,但在已测试版本中,周期性差异仍然存在。比如 Flash 后训练版的差距降到 19.1 个百分点,Pro 后训练版为 14.8 个百分点。DeepSeek-V4.1-Flash 在这个测试中的差距进一步缩小到 6.1 个百分点,但周期也随压缩步长变成了 2 个 Token。
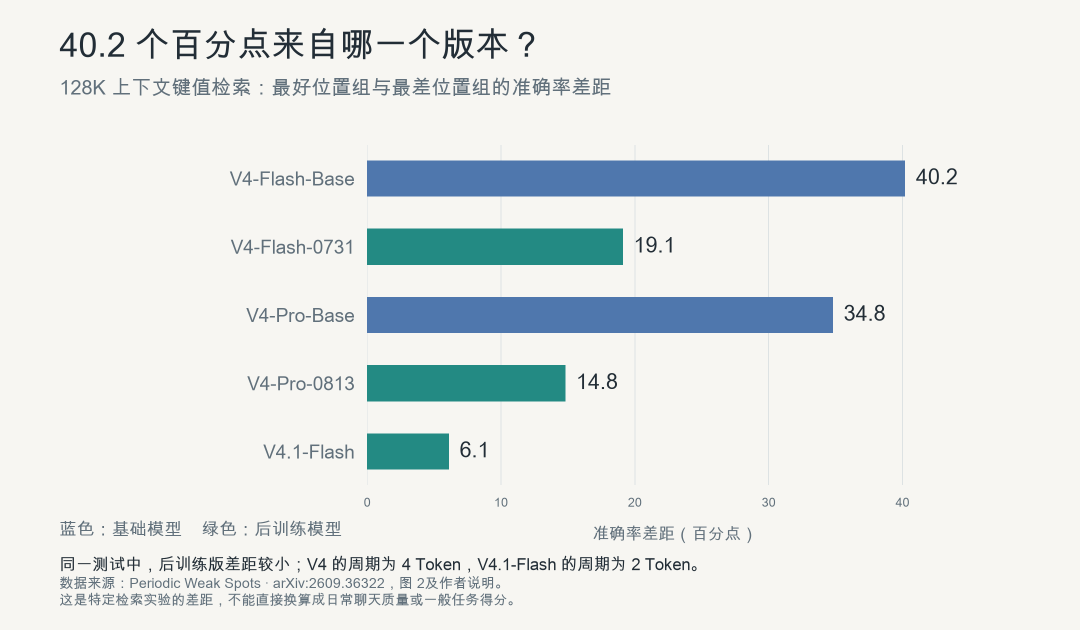 同一检索实验中的位置组差距。40.2 个百分点来自 Flash 基础模型,后训练版本的差距较小采用类似分块 KV Cache 压缩的模型,原理上也可能有。这口锅不能只让 DeepSeek 背,研究者在从头训练的小模型中也复现了这种现象。长上下文场景下 KV Cache 的内存开销太大,降低内存和注意力计算开销是常见的优化方向:有的按块压缩,有的用稀疏注意力,有的用滑动窗口。这几种机制并不等同。固定分块可能带来和位置相关的差异,但具体会不会出现、强弱如何,还要看架构和训练,不能仅凭“切块”两个字就下结论。DeepSeek-V4 的波动之所以呈现规律的 4 Token 周期,是因为它与压缩步长对应。窗口大小是 8,步长是 4。别家实现不同,表现出来的周期和强弱可能不一样,甚至没有明显周期性。就这个问题我咨询了做模型的朋友,他说,就算不用分块压缩,模型也大概率会对位置敏感。学术界早就有“Lost in the Middle”的说法:在所测试的模型和任务中,相关信息放在长上下文的开头或结尾时,模型通常利用得更好,放在中间时表现容易下降。貌似人也有点这样,看文章能记住的可能就是头和尾。这种现象在未采用上述分块 KV 压缩的模型中也出现过,但它和每隔几个 Token 重复一次的相位弱点,是两种不同的位置现象,也不能简单归结为注意力机制必然有这个缺陷。滑动窗口也不能一概理解成窗口外信息全都丢了。单层的局部注意力无法直接访问窗口外的位置,但多层网络可以间接传递更早的信息,混合架构还可能保留其他记忆路径。具体能记住多少,要看模型怎么设计。回到使用上,我们能做的,是让关键信息更容易被找到,再检查模型是否真的用对了。1、重要的话可以优先放开头或结尾。长文档、长代码、长对话里,把最关键的指令和相关信息放在这些位置,是有研究依据的经验做法。不过效果仍取决于模型和任务,不能保证彻底解决分块压缩的相位弱点。2、关键信息可以简洁地说两遍。开头提一次,结尾呼应一下,增加一点 Token 成本,看看模型能不能更好地抓住重点。重复要一致,别越说越复杂,也别指望重复就一定有效。3、对结果不满意,别忙着 PUA 人家,核心信息可以挪挪位置再问一遍。很多人看到 AI 事没做好,就忙着改提示词,越改越复杂。研究说明,小幅调整位置也可能影响结果。但相位按 Token 计算,挪动一两句话后,可能进入不同相位,也可能仍在原相位。4、关键结论做交叉验证。这个我之前就写过,尤其做 Coding,一次做到 95% 的都很少,让模型自己做几次 review,或者模型多可以多模型交叉验证,质量会好很多。这是我的绝活,买多个模型就为了干这事,不是 MacTalk 读者我不告诉他。btw,这类缺陷有可能随着训练和架构迭代逐步缓解,但何时消失、能否完全消失,目前还没有答案。今天总结的这些技巧,也许会随模型变化而失效。这大概是 AI 时代技巧类产品和内容的某种宿命:保质期难预测,有用的时候也得看场景。