突发,DeepSeek新模型开源,RSI立大功
 数据STUDIO约 3 分钟
昨天,DeepSeek官宣发布并开源DeepSeek-V4.1-Flash-1017,并首次官宣了一项新技术:RLSF(Reinforcement Learning with Self-Feedback)。一个RSI神器,来自字节豆包
这次,自研搜索引擎的 Search & Fetch API 全面开放,$0.75 / 千次——这台引擎每天已经在内部扛数亿次请求。
官方给的口径这只是一次minor update,但reddit社区的反应是:“wtf wow”,“Proceeds to obliterate GLM5.3, Kimi K3 and GPT5.6 Sol”。
官方基准对比表
11 项基准,全部上涨,更强的分数、更快的完成速度、更短的输出——性能与成本的帕累托改进。
意味着 Agent 跑同一个任务,账单直接变薄
01RLSF:自反馈强化学习
本次,官宣推文里最容易被忽略、但最关键的一句原文:Anthropic公开内部代码审查最佳实践
DeepSeek-V4.1-Flash-1017 uses reinforcement learning with self-feedback to improve end-to-end project development — from game creation to 3D modeling.”
要注意的是,RLSF在此前DeepSeek-V4.1-Flash那篇技术报告通篇没有这个词。
也就是说,这是 1017 这次后训练更新新引入的机制,奖励信号具体怎么构造、如何防止自我强化跑偏,官方都还没有披露技术细节。
不过论文里的 RL scaling 曲线可以佐证这条路的潜力:随着 RL 步数累积,DeepSWE、SWE-Bench Pro、Terminal-Bench 全线爬升,且把上下文拉到 1M 后长程任务继续涨。
论文 Figure 7:RL 训练规模扩大带来的持续提升
自反馈强化学习并非 DeepSeek 生造的词,杜塞尔多夫大学团队发表过RLSF(Reinforcement Learning from Self-Feedback)技术论文。
核心要点三条:
奖励来自模型自己:冻结模型采样多条 CoT 推理路径,按每条答案的 token 置信度排序构造偏好对,再用 PPO / DPO 微调——全程不需要人类标注、标准答案或外部奖励模型
RLSF 论文 Figure 1:自反馈流水线——不同起始 token 引出多条推理路径,按答案置信度排序成偏好
一石二鸟:既修复校准(答错时的置信度从 0.993 降到 0.712,不再”迷之自信”),又提升推理(校准较差的 Qwen 2.5 7B 上,GSM8K 准确率 53.7% → 58.6%)
RLSF 论文 Table 1:RLSF 与基线在 MultiArith / GSM8K 上的准确率与校准误差对比
RLSF 论文 Figure 3:同一道错题,RLSF 后模型给出更好的解释且置信度明显下降
适用边界:对校准差的模型收益最大;但该工作只验证了单轮推理任务,多轮、长程 Agent 场景怎么做自反馈,仍是开放问题
对照来看,DeepSeek 推文只写了self-feedback几个字——是否采用同款置信度奖励、如何在端到端项目开发里构造自反馈信号,只能等后续技术报告揭晓。
落到实际效果,DeepSeek官方也给出了从零造完整项目:3D 建模故宫、网页版赛车游戏、Godot 引擎复刻 Portal 2、以及一个从史前演化到现代的 3D 场景Valley of Ages:
故宫 3D 建模
网页赛车游戏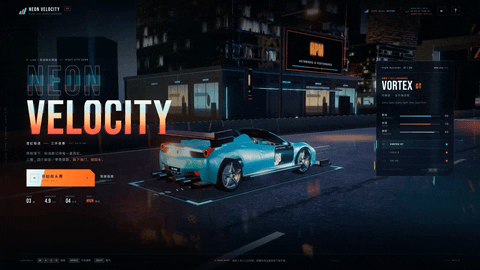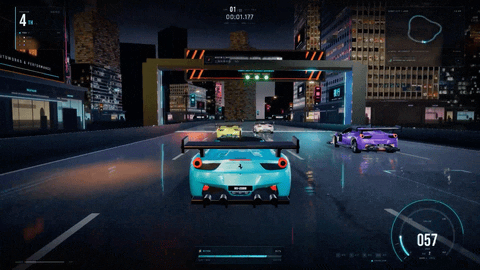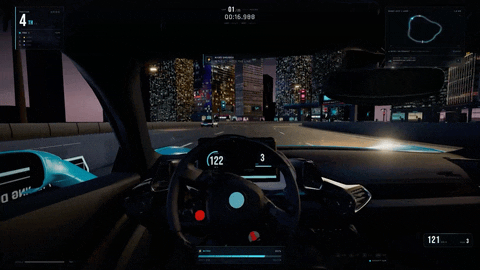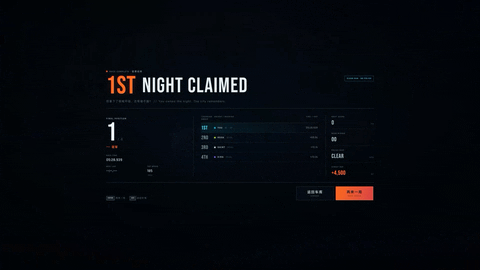
Godot 复刻 Portal 2
Valley of Ages 3D 场景
02写在最后
DeepSeek Harness 需升级到 v0.2.1-rc.1+;Search & Fetch 通过 Harness / Claude Code / Codex 调用,10 月 31 日前免费。
一次minor update,基准全涨、输出更短、价格不变,还顺手把权重 MIT 开源了。Reddit网友说得好:It’s the deepseek way.
完爆 Grok 4.7,逼近 Opus 5.5/ Gemini 4 Argon 水平
Post-Training Large Language Models via Reinforcement Learning from Self-Feedback
https://arxiv.org/pdf/2507.21931
https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017/tree/main