duckdb-ivf 进社区扩展:0.5MB,零依赖
a alitrack alitrack约 5 分钟
昨天,我写的 DuckDB 扩展 duckdb-ivf 合并进了官方社区扩展仓库(duckdb/community-extensions,commit 4f11e2e,2026-11-03)。今天官方页面已经上线,现在任何人在 DuckDB 里敲一行就能装上:
duckdb-ivf 六个函数两条线
在这个地基上,仓库里配了一层 SQL 宏(
duckdb-ivf 适合谁
● ● ●
INSTALL ivf FROM community;我自己在 DuckDB 2.0.0(WSL2)里从零装了一遍:一次过,扩展文件 0.5MB,纯 Rust,零第三方依赖。这篇文章介绍它是什么、能干什么、什么时候该用它。 ● ● ●
LOAD ivf;
它是干什么的:两条能力线
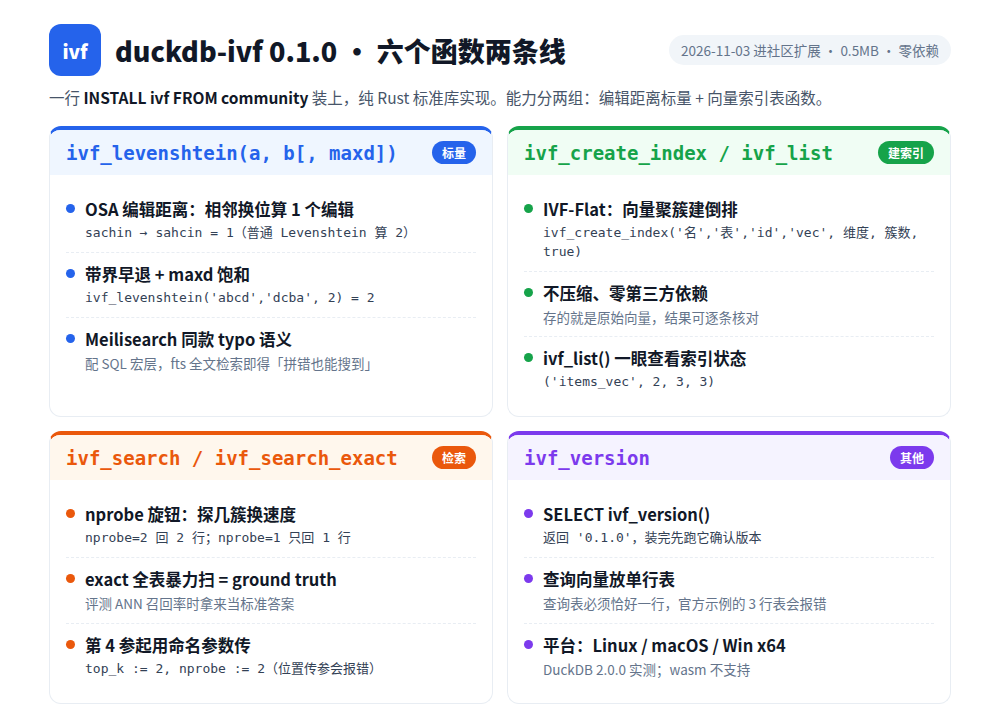
duckdb-ivf 0.1.0 一共六个函数,分两组。 第一组:
ivf_levenshtein(a, b[, maxd])
,编辑距离标量函数。
SELECT ivf_levenshtein('sachin', 'sahcin'); -- 1,相邻字符打反,OSA 算 1 个编辑关键在第一行的语义:把 sachin 打成 sahcin 这种相邻换位,它算 1 个编辑(OSA Damerau-Levenshtein),普通 Levenshtein 算 2。相邻换位是真实键盘打错里最大的一类,算 2 就意味着「容错 1 个编辑」的搜索全纠不动它。Meilisearch 的 typo 容错用的就是这个语义。
SELECT ivf_levenshtein('cruide', 'crude'); -- 1,多打了一个字母
SELECT ivf_levenshtein('abcd', 'dcba', 2); -- 2,maxd 饱和,超过 2 就不算了
test/fts_typo.sql
),把 DuckDB 官方 fts 全文检索包成 Meilisearch 风格的容错搜索:按词长分档容错预算(3 个字母以内永不纠正,4 到 5 个容忍 1 个编辑,6 个以上容忍 2 个)、同义词优先于纠正、原查询和纠正后的查询一起搜再融合,纠错不会毁掉原本能搜到的结果。
这部分昨天刚写过一篇完整的方法文章(《DuckDB 拼错也能搜到:typo 容错的反直觉坑》,文末有链接),120,000 篇新闻语料上的全部实测数字都在那篇里,这里不重复展开。
第二组:IVF-Flat 向量索引,四个表函数。
CREATE TABLE items(id BIGINT, vec FLOAT[]);
INSERT INTO items VALUES (0, [0.0,1.0]), (1, [1.0,0.0]), (2, [0.9,0.1]);

SELECT * FROM ivf_create_index('items_vec', 'items', 'id', 'vec', 4, 10, true);

-- 查询向量放进一张单行表
CREATE TABLE q(vec FLOAT[]);
INSERT INTO q VALUES ([0.95, 0.05]);

SELECT * FROM ivf_search_exact('items_vec', 'q', 'vec', top_k := 2);
-- ┌───────┬────────────┐
-- │ id    │ distance   │
-- │ 1     │ 0.95       │
-- │ 2     │ 0.9497     │
-- └───────┴────────────┘

SELECT * FROM ivf_search('items_vec', 'q', 'vec', top_k := 2, nprobe := 1);
-- nprobe=1 只探 1 个簇,只回来 1 行:召回换速度的旋钮
ivf_search
探 nprobe 个最近的簇(近似检索),
ivf_search_exact
全表暴力扫(精确检索),
ivf_list
看索引里有什么,
ivf_version
报版本。上面的结果是我今天真跑出来的:nprobe 从 2 调到 1,同一查询从 2 行掉到 1 行,这就是召回和速度之间 tradeoff 的最小可验证例子。
● ● ●
官方示例照抄会报错(两个坑)
写这篇时我把官方文档页的示例原样跑了一遍,翻车两处,都是照抄必踩的。 坑一:第 4 个参数必须用命名参数传。 官方示例写的是
ivf_search_exact('items_vec', 'items', 'vec', 2)
,第 4 参按位置传。实际跑会报 Binder Error,候选签名提示第 4 参是命名参数,正确写法:
SELECT * FROM ivf_search_exact('items_vec', 'items', 'vec', top_k := 2);
坑二:查询表必须恰好一行。
官方示例拿 3 行的 items 表当查询表。源码要求查询表 exactly one row,多行会直接报错。所以查询向量要先放进一张单行表(或者用子查询
(SELECT ...)
包一层)。
两个坑都不难绕,但你第一次用的时候大概率会在这卡十分钟。我踩完了,你不用再踩。
● ● ●
为什么叫 ivf:向量组不跟 ANN 引擎卷
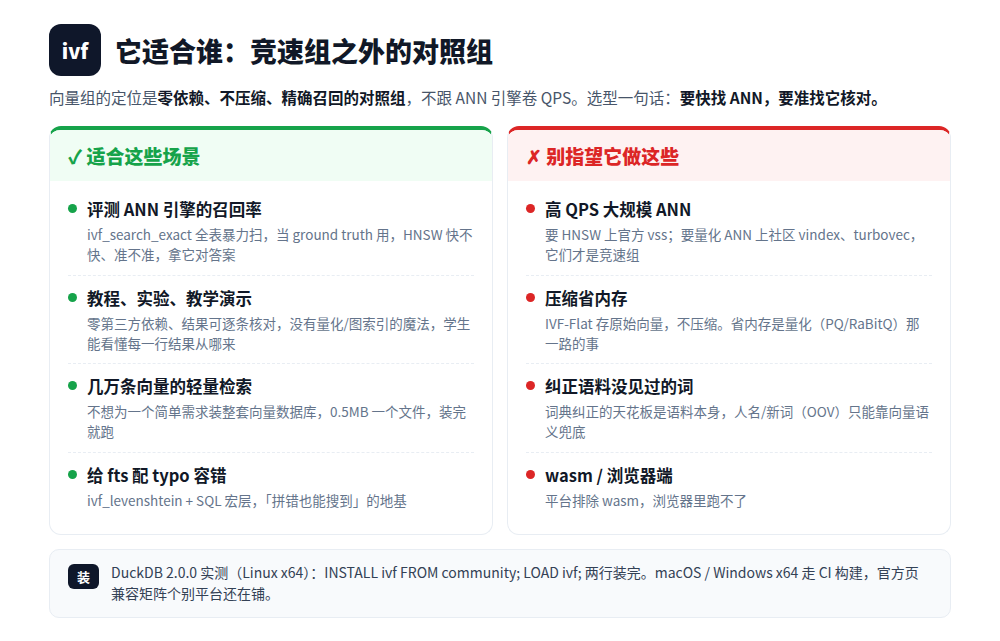
IVF 是 inverted file index,向量检索里的经典结构:把向量聚成簇,查询时只扫最近的几簇。这是它的能力基线。 但 duckdb-ivf 的向量组 没打算跟 ANN 引擎竞争 。它的定位是:一个零依赖、不压缩、精确召回的对照组。 什么时候需要它?你在评测一个 ANN 引擎(HNSW、量化索引)召回率的时候,需要 ground truth;你在写向量检索的教程或实验的时候,需要一个不引入任何魔法就能核对结果的下界;你只想在几万条向量里做个简单检索,不值得装一套向量数据库。这些场景要的是「结果可信、依赖干净」,不是每秒十万 QPS。 真要卷性能:官方 vss 扩展有 HNSW,社区里的 vindex、turbovec 有量化和更全的 ANN 实现。它们是竞速组,duckdb-ivf 是那个站在终点拿秒表的。前一篇的数字,一句话版
昨天的容错方法文里,全部实测都在 ag_news 120,000 篇英文新闻上:拼错一个词的短查询,命中率从 0.838 提到 0.880;六成词被打坏的长查询,从 0.884 到 0.962;词典纠正的天花板是语料本身(13/50,人名和新词纠不动)。方法论、完整表格和复现包都在那篇,这里只留一句:那些数字的地基,就是这次进社区的这个 0.5MB 扩展。 ● ● ●安装与边界
- DuckDB 2.0.0 实测可用(Linux x64,我在 WSL2 里从零装的);macOS 和 Windows x64 是 CI 构建的,官方页兼容矩阵里个别平台还在铺,装不上就等一两天 CI 补齐,或者去仓库提 issue
- wasm 不支持
- MIT 协议,纯 Rust 标准库实现,不拉任何第三方 crate,构建产物就一个 0.5MB 的文件
- 词典纠正救不了语料没见过的词,那是向量检索的活