GPT-6之后,具身大模型画地为牢!明年自研预算估计悬了
量 关注前沿科技 关注前沿科技约 9 分钟
田晏林 发自 凹非寺
量子位 | 公众号 QbitAI
GPT-6 Astra发布才两个月,GPT-6.2 Astra眼瞅着就要来了。
然而具身智能行业还没从上一轮打击中缓过神来。
一切都是那么猝不及防。
还记得GPT-6 Astra刚出来时,一批具身从业者被打懵了。特别是在一线搞预训练的工程师,更是人人自危。
近期,业内又传出消息,一些具身智能公司开始裁撤算法岗。
过去需要大量数据、算力和算法工程师一点点啃下来的能力,GPT-6 Astra在部分测试中,却不需要针对具体任务进行额外后训练,就能够展现出来。
这还让人怎么卷???
比起具身智能迟迟没有出现新的范式级突破,以Astra为代表的通用大模型,正在以coding的方式垂直打击具身行业,这才是真冲击。冲击带来的压力,不完全来自硅谷。 相比OpenAI等海外大模型公司的技术进展,国内具身公司对本土大模型玩家的下一步动作更敏感。 Kimi、DeepSeek、智谱……这些名字正在成为具身行业不得不关注的变量。 在最近火热的RoboDojo评测中,越来越多团队也开始尝试将通用大模型(如GPT-6 Astra)引入自己的机器人系统,泛化很强,能力惊人。
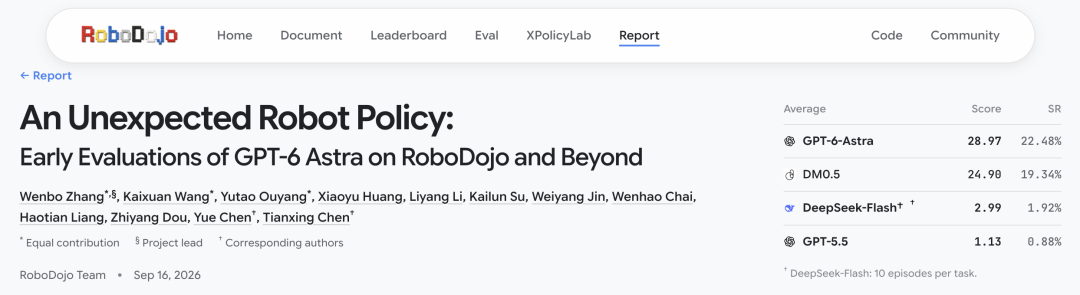 △
RoboDojo团队对GPT-6 Astra的早期评估报告
回忆起9月中旬的一天,陈天行告诉量子位,当伙伴们陆续把测试结果拿来,他愣了好几秒:
你能看到它对3D重建、对数学等各个领域的冲击都是空前的。 吓人,真挺吓人的。
都被GPT-6打懵了
“具身自研模型还在80分上不断加0.1、加0.2,GPT-6 Astra已经一次性从80分跳到了90分。” 这是陈天行复盘这次评测时,给出的一个形象比喻。 更扎心的是,在部分测试中,Astra甚至没有针对具体任务进行额外后训练,也没有使用任务示范,仅凭语言指令,就能完成不少机器人操作任务。 最让他意外的,还是Astra一下子展现出了三项具身模型过去需要重点攻克的能力。 第一项是ICL(In-Context Learning,上下文学习)。 简单来说,就是让机器人通过少量上下文信息,快速学会一个新任务。 比如,人类拍一段自己操作的视频,再配上文字说明,机器人就能理解人是怎么做的,并尝试让机械臂复现。 今年7月,ICL还是具身圈一个相当热门的研究方向。常见的范式是展示人类操作,让机器人模仿以习得新技能——即所谓的单次情境学习。 但社区发现,给Astra提供图像或文字示范,成功率可以高于不提供示范。 更让人意外的是它的在线适应能力。研究人员故意改变摄像头画面和动作坐标系,Astra能够根据实际执行结果,在几轮尝试后调整策略,顺利完成任务。 也就是说,它不光能理解上下文,还能边做边修正。 在陈天行看来,因为通用模型本身就有很强的上下文理解能力。平时聊天时,它能记住之前的对话历史,给它一段视频,它也能理解视频内容和文字之间的关系。 把这些能力迁移到机器人操作上,原本需要专门研究的ICL问题,突然就有了现成的解法。 第二项是OOD(Out-of-Distribution,分布外泛化)和Correction(纠错能力)。 机器人在真实环境里,很容易碰到训练数据之外的情况。 比如,机械臂正准备抓一个杯子,结果杯子突然被碰了一下,位置变了。 一个过度依赖训练数据的模型,可能还会沿着原来的轨迹执行,最后抓了个空。 而Astra能够根据变化后的视觉信息重新调整动作,尝试把物体抓起来。 听起来只是一个很小的动作,背后却是机器人能不能适应真实世界的问题。 毕竟,现实世界可没有人负责把每一个杯子都摆回训练时的位置。 第三项是Open-Vocabulary Manipulation(开放词汇操作)。 这项能力涉及语言与动作之间的对齐。 比如,用户换不同的说法提出操作要求,机器人依然能够听懂并执行。 过去,语言理解和动作执行之间往往存在断层,具身模型需要针对具体任务进行后训练,才能更好地完成对齐。 但Astra在这方面展现出了更强的能力。在部分测试中,即使没有针对具体任务额外后训练和示范,它也能仅凭语言指令完成不少机器人操作。 在陈天行看来, 以上三项曾是具身领域极具分量的技术命题,过去都属于可以单独拿出来讲创业故事的。 如今,Astra一次性把这三道题都做了,对原有具身模型研发路线是一场近乎爆裂的冲击。△ 在RoboDojo-Sim基准测试中的零样本测试结果,不代表Astra已经能够在真实机器人上稳定完成这些任务。
报告中,RoboDojo团队提示, Astra的真机测试曾因安全问题中止。 仿真榜单上的高分,还不能直接等同于真实世界中的生产力。 但它已经足以让具身公司重新审视过去的研发投入。 为什么一个原本不是为机器人操作而生的通用大模型,能快速逼近具身公司多年积累的能力? 说起来有点无心插柳。 虽然通用大模型不是从零开始学机器人,但它是带着在大规模预训练中,攒下的语言、视觉、推理和Coding等一系列能力进入的机器人领域。 这些能力原本各有各的用处,没想到放到机器人身上,竟也能直接派上用场。 反观具身公司,很多团队从零开始训练机器人大脑,手里的数据主要来自机器人操作本身。自研模型还有必要吗?
GPT-6 Astra确实很强,但它还没强到让具身公司可以直接缴械投降。 至少在真实物理世界里,还有不少硬骨头等着啃。 破壳机器人创始人许华哲把具身智能的能力拆成了语义、空间和物理泛化三个层次。 他认为,Astra在前两项上表现突出, 但到了复杂物理接触、受力变化、物体形变和高精度操作,仍然面临挑战。 比如,让机器人知道一个杯子在哪里、应该伸手去拿,和让它稳稳抓住一个杯子,完全是两回事。 杯子是软是硬?抓取时该用多大的力?物体被挤压、碰撞后会发生什么变化? 这些问题,光靠看懂画面、理解指令还不够。△ 报告截图
RoboDojo团队在评测中也发现,Astra并非在所有任务上都占优。 几何对齐、语言指令理解是它的强项,但到了连续接触和多步骤物理操作,现有VLA仍然有不少机会。 自变量创始人王潜的观点是,通用大模型要进入具身,依然必须面对机器人数据、现实世界评测、硬件、仿真和部署等基础设施问题。这些难度不会因为拥有一个更强的语言模型而自动消失。问题是, Astra今天做不好的事情,明天会不会突然就做到了? 目前,业内吐槽Astra比较多的,还有 推理速度太慢。
推理慢仍然可以控制快,牺牲的只是反应速度。对于比较吃节拍类型的流水线任务来说,反而无关紧要。比如快递分拣,机器人需要连续、稳定地抓取和投放。高层模型负责理解任务、规划动作,底层控制系统则以更高频率执行控制指令。 只要任务允许提前规划,或者对反应延迟有一定容忍度,大模型未必需要参与每一个底层控制周期。 当然,遇到高速动态变化、复杂接触等任务,反应速度依然重要。 但至少,推理慢未必意味着机器人的控制不快。
△ 陈天行博客
「开放任务可以更多借助通用模型,稳定任务可以采用规则或轻量策略,中间的场景则给场景优化模型留下了空间。」陈天行说。 依我看,两条轴线放在一起,就一句话: 能用规则/轻量策略解决的事,没必要上大模型;能用小模型完成的任务,也没必要每次都请Astra出场。 反过来,如果任务变化太多,专用模型需要不断采集数据、重新训练,直接调用通用模型可能更合算。 决定采用哪种方案,最终还得算一笔完整的经济账。一次任务的成功率是多少?要花多少时间?失败后需要多少人工介入?数据采集、模型训练和长期部署又要花多少钱?这些实打实的数字,决定了一套机器人系统有没有商业价值。 所以说, 不是自研不重要,而是具身公司的「自研方向」需要重新排序了。 通用模型已经擅长的语言理解、任务规划等能力,可以考虑直接利用;涉及物理交互、特定本体控制、真实场景适配和部署效率的问题,仍然需要大量专门研发。 至于有没有必要继续从头训练一个更大的具身基础模型,就要看它能否在实际任务中提供足够明显、足够持久的优势。 有行业朋友和量子位吐槽, 很多具身团队现在还带着比较强的学者心态,总想着做一个通用智能模型,恨不得把所有任务都装进自己的模型里。 但现在情况变了。GPT-6.2 Astra都快要来了。 若企业研究方向和目标产业脱节,模型训得再漂亮,商业闭环也未必成立。
One more thing
过去的60天里,很多具身从业者私下聊起来,仍旧迷茫。 只不过到了公开场合,大家该捍卫自己的利益和立场,还是要坚持到底。 可以肯定的是,GPT-6 Astra确实搅乱了具身行业原本的节奏…… 马太效应、宇树上市后的行业重估、RSI成为新风口……叠加在一起,最终形成的是近期的行业情绪—— 「投资人开始不投具身了」。 或许有夸张的成分,但具身智能机器人创业告别Demo、烧投资的阶段,却是无比真实的。 百机大战的淘汰赛,已经开始了。 一键三连 「点赞」「转发」「小心心」 欢迎在评论区留下你的想法! — 完 —🌟 点亮星标 🌟 科技前沿进展每日见