【2022新书】实用深度强化学习,398页pdf
 数据STUDIO约 5 分钟
介绍使用 Python、PyTorch 和 TensorFlow 进行实用强化学习开发
本书适用于机器学习工程师、深度学习狂热者、人工智能软件开发人员、数据科学家和其他渴望学习并将强化学习应用于正在进行的项目的数据专业人士。不需要机器学习的专业知识;但需要精通 Python。
强化学习是人工智能的一个引人入胜的分支,它在几个方面不同于标准机器学习。在不可预测的环境中适应和学习是该项目的一部分。如今,强化学习有许多现实世界的应用,包括医疗、赌博、人类模仿活动和机器人技术。
本书从实用的角度向读者介绍了强化学习。这本书确实涉及数学,但它并没有试图让读者负担过重,因为读者是强化学习领域的初学者。
这本书在许多实际学习中为读者带来了许多创新方法,包括蒙特卡洛、深度 Q 学习、策略梯度和 Actor-Critical 方法。在您详细了解这些技术的同时,本书还使用 TensorFlow 和 PyTorch 的强大功能提供了这些方法和技术的真实实现。这本书涵盖了一些展示强化学习力量的诱人项目,更不用说所有内容都是简洁、最新和直观的解释。
读完本书后,读者将对现代强化学习及其应用有一个透彻、直观的理解,这将极大地帮助他们深入研究强化学习这个有趣的领域。
你会学到什么
-
熟悉强化学习和深度强化学习的基础知识。 -
利用 Python 和 Gym 框架对外部环境进行建模。 -
应用经典的 Q-learning、Monte Carlo、Policy Gradient 和 Thompson 采样技术。 -
探索 TensorFlow 和 PyTorch 以练习深度强化学习的基础知识。 -
使用特定技术为特定问题设计智能代理。
强化学习是机器学习中最具活力的研究领域之一。它研究一个代理如何在一个未知和不断变化的环境中适应和学习完美的行为。许多科学家认为,强化学习将使我们更接近于达到人工智能。在过去的几年里,强化学习发展迅速,已被用于从股票交易到自动驾驶汽车的复杂应用中。这种增长的主要原因是深度强化学习的参与,它是深度学习和强化学习的结合。
尽管它很受欢迎,但对于一个新手数据科学家来说,强化学习似乎是一个相当复杂的研究领域。通常情况下,许多资料都是以复杂的数学概念、证明和公式为载体的。本书对强化学习进行了实用的介绍。当然,这本书包含了数学,但它并没有试图压倒刚接触这个主题的读者。每一章都是针对一个特定的项目,用一种特定的方法来解决这个问题。因此,这本书带来了一个令人兴奋的旅程,从强化学习的起源到使用PyTorch和TensorFlow的最先进的深度强化学习方法。
主要特征
-
接触著名的 RL 技术,包括 Monte-Carlo、Deep Q-Learning、Policy Gradient 和 Actor-Critical。 -
在强化学习项目中使用 TensorFlow 和 PyTorch 的实践经验。 -
一切都是简洁的,最新的,并用简化的数学直观地解释。
目录
本书分为2部分。第一部分介绍了经典的强化学习。它涵盖了强化学习的基础知识,解释了Q-learning、Monte-Carlo方法和Thompson Sampling等著名技术。第二部分专门介绍一种叫做深度强化学习的先进方法。它展示了神经网络和深度学习的新成就如何使用深度Q网络、双深度Q网络、政策梯度和演员批判方法帮助解决现实生活中的常见问题。
-
第一章对强化学习做了一个简短的介绍。我们将研究强化学习的基础知识。同时,我们将研究强化学习与其他机器学习方法的不同之处。最后,还展示了一些强化学习。同时,我们将研究强化学习与其他机器学习方法有什么不同。最后,还展示了一些强化学习问题的例子和它们的重要性。 -
第二章将介绍马尔科夫奖励过程理论的基础知识,该理论是整个强化学习的基础。我们将用大富翁棋盘游戏的例子来研究马尔可夫奖励过程。 -
第三章介绍了Gym框架。Gym框架是一个Python库,它为强化学习问题建立了一个环境。Gym统一了测试强化学习问题解决方案的过程,并提供了很多非常迷人的环境,对初级数据科学家来说非常有用。 -
第四章将重点讨论多臂匪徒问题。尽管这个问题的表述和解决方案都很简单,但它有很大的实用价值。在这一章中,我们将研究解决多臂强盗问题的两种策略:ε-贪婪策略和汤普森采样策略。本章涉及的概念影响了强化学习的许多方面。 -
第五章说明了应用于21点的蒙特卡洛方法的原理。在这一章中,我们将尝试制定一个玩21点的最佳策略,然后挑战庄家。你将被引入Q(s, a)行动-价值函数的重要概念,它是强化学习的基石之一。 -
第六章介绍了Q-learning,并解释了这种方法如何被用来寻找逃离迷宫的最短路线。Q-learning是一种非常有效的强化学习方法,而迷宫问题很好地说明了这种方法。 -
第七章介绍了一种方便的离散化技术,它有助于将具有连续状态空间的环境适应于经典的强化学习方法。本章提供了一个从经典强化学习到深度强化学习的桥梁。 -
第八章介绍了TensorFlow和PyTorch的基本深度学习技术。它解释了如何设计和应用一个神经网络。而作为最后一步,我们将演示如何为一个手写数字识别问题创建一个神经网络。 -
第九章展示了最流行的深度强化学习算法之一,称为深度Q-Network或DQN。许多先进的深度强化学习算法都是基于DQN的。DQN是强化学习和深度学习相互结合的起点。这种方法大大扩展了可以实际解决的强化学习问题的范围。 -
第十章介绍了双深Q网络方法。我们将应用这种方法来训练一个玩视频游戏的代理! -
第十一章涉及政策梯度方法。这种方法使我们能够解决Q-learning方法不够好的问题。我们将研究这种技术的优点和缺点,并将其应用于经典的CartPole问题。 -
第十二章告诉我们关于演员批评法。Actor-Critic方法结合了策略梯度法和Q-learning技术的优点,是强化学习的最重要成就之一。我们将把Actor-Critic模型应用于一个现实生活中的股票交易问题。 -
第十三章通过对强化学习理论进行全局性的概述来结束本书的写作。在这一章中,我们将看到读者在完成本书后可以遵循的各种方向。
便捷阅读
398页 《实用深度强化学习:算法的简洁实现,简化的数学,TensorFlow和PyTorch的有效使用》高清epub下载:
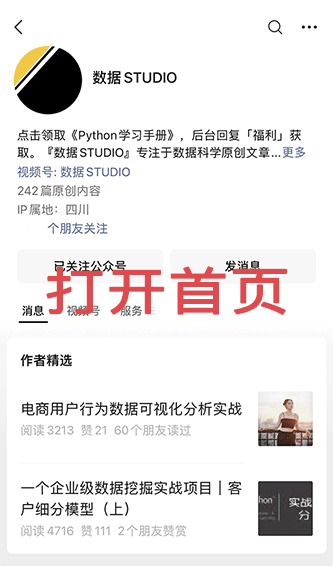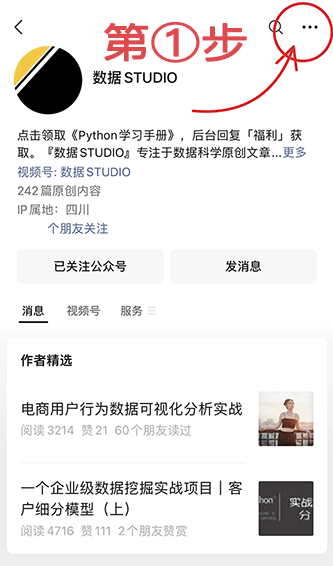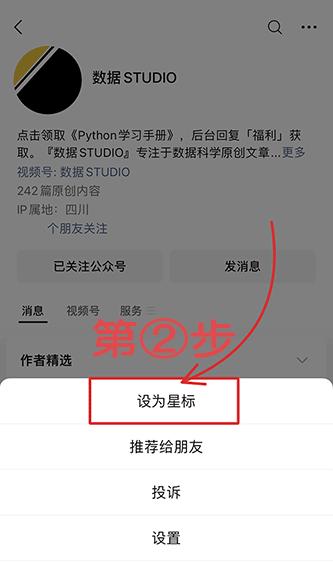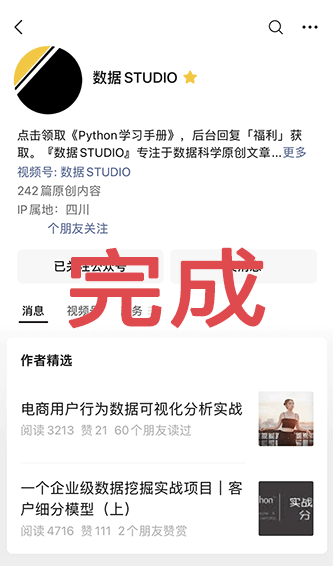
需要您先星标公众号,然后扫码添加云朵君微信,务必备注【PDRLWPY】,将星标截图发我即可。
🏴☠️宝藏级🏴☠️ 原创公众号『 数据STUDIO 』内容超级硬核。公众号以Python为核心语言,垂直于数据科学领域,包括 可戳 👉 Python | MySQL | 数据分析 | 数据可视化 | 机器学习与数据挖掘 | 爬虫 等,从入门到进阶!
长按👇关注- 数据STUDIO -设为星标,干货速递