VOP消息仓库演进之路|如何设计一个亿级企业消息平台
 京东零售 李孟冬约 9 分钟
并且,随着618、双11等各类促销活动的开展,VOP侧客户不断增加,消息激增成为亟需解决的问题,限流、缓存等手段虽能保证系统的高可用及并发能力。但是消息大量积压、消费水平有限、消息同步不及时等问题越发严重,随之带来的就是对业务有损,所以在综合评估后决定对系统升级,通过分析发现最掣肘平台的核心还是数据库(此时消息表行数亿行,容量超过10G)。
因此在读写分离无法满足业务需要时(已经历过数据归档),分库分表的模式也就需要登上舞台了。具体如何分库分表,注意事项等不多加赘述。 推荐对分库分表感兴趣的读者可以翻阅“菜鸟积分系统的分库分表实践”:
星花,公众号:阿里技术菜鸟积分系统稳定性建设 - 分库分表&百亿级数据迁移
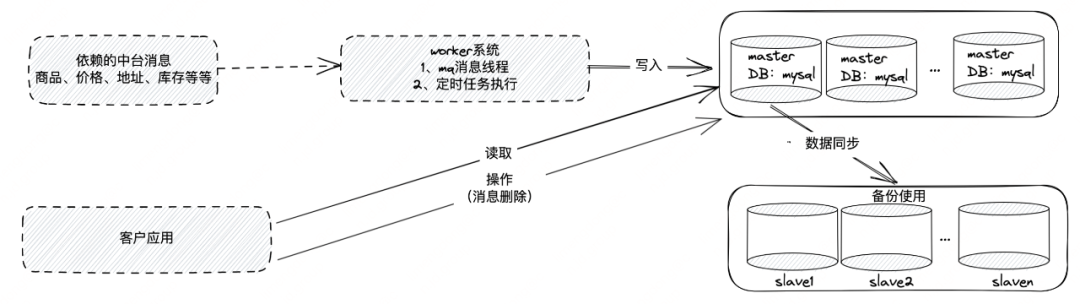
图3.数据读写过程示意V2.0
分库新旧流程对比
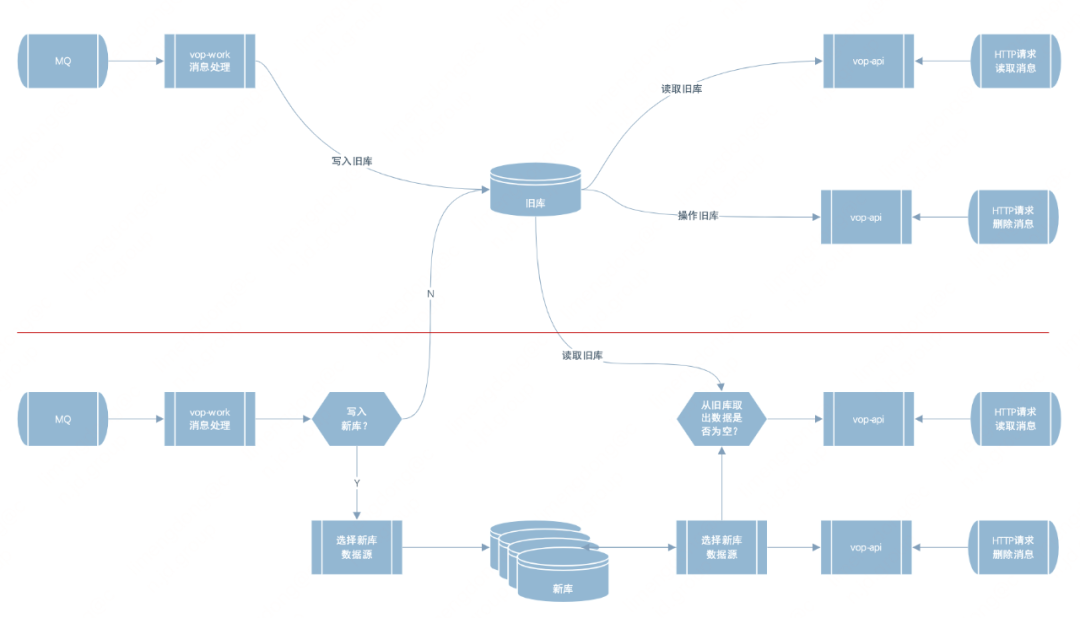
图4.分库新旧流程对比图 分库新旧流程比对切换依据(供参考) 1. 根据 ducc和 clientId决定是否写入到新库,ducc(bizMsgTransDbJson)中配置了切换开关、白名单、黑名单和分流范围;
2. 使用新库写入时,根据 clientId.hashCode % dbSource.size,得出使用哪个 dbSource;
3. 客户读取时,先从旧库查出,若无数据,则再读取一遍新库,dbSource选取方式同上;
4.客户删除时,判断删除 ID是否大于一万亿(1000000000000),大于取新库,小于取旧库。
由于是多master的架构,分库分表除了包含读写分离模式的所有优点外,还可以解决读写分离架构中无法解决的 TPS 过高的问题,同时分库分表理论上是可以无限横向扩展的,也解决了读写分离架构下从库数量有限的问题。 当然在实际的工程实践中一般需要提前预估好容量,因为数据库是有状态的,如果发现容量不足再扩容非常麻烦,应该尽量避免。 在分库分表的模式下可以通过不启用查询从库的方式来避免主从延迟的问题,即读写都在主库。因为在分库后,每个 master 上的流量只占总流量的 1/N,大部分情况下能扛住业务的流量,从库只作为 master 的备份,在主库宕机时执行主从切换顶替 master 提供服务使用。 优化后的前期情况是美好的,无论从客户角度还是从内部消费水平都得到了大幅提升,其跳点和峰值消息下高TPS影响CPU等问题都得到了解决,整个消息仓库性能和稳定性趋于稳定。 为什么说前期情况好,相信读者也有所预料:虽然分库大幅提升了系统整体的吞吐能力和稳定性,但是由于前期的容量评估问题(业务增长加剧)及本身现有架构的局限性(单体应用),在仓库稳定运行一年左右,又出现了一些显而易见的痛点问题,如下展开说明。
05 痛点问题
1. 海量数据:19年客户量及商品品类(商品量级)大幅增加,以及最初分库时将消息数据的存储时长由2-3天提升至7天(原因:考量政府、银行等客户重保期间不消费消息的空档期,但是后期验证空档期长达月维度)。消息仓库的流量出现了频繁翻倍的增长,数据不均衡的情况也逐渐显现出来; 2.字段扩展:随着业务不断的演进,消息内容也逐渐复杂(如售后消息会附带各环节信息,整个JSON消息体较大),入库或存在字段长度限制,调整字段较难; 3. 高可用&扩展性:原有单体架构的情况,会有热点数据的冲击及热点商品类消息数据,订单类、对账类消息数据的写入和同步出现严重的时延问题及服务性能跳点问题;
推荐对分库分表感兴趣的读者可以翻阅“菜鸟积分系统的分库分表实践”:
星花,公众号:阿里技术菜鸟积分系统稳定性建设 - 分库分表&百亿级数据迁移
图3.数据读写过程示意V2.0
分库新旧流程对比
1. 根据 ducc和 clientId决定是否写入到新库,ducc(bizMsgTransDbJson)中配置了切换开关、白名单、黑名单和分流范围;
2. 使用新库写入时,根据 clientId.hashCode % dbSource.size,得出使用哪个 dbSource;
3. 客户读取时,先从旧库查出,若无数据,则再读取一遍新库,dbSource选取方式同上;
4.客户删除时,判断删除 ID是否大于一万亿(1000000000000),大于取新库,小于取旧库。
为什么说前期情况好,相信读者也有所预料:虽然分库大幅提升了系统整体的吞吐能力和稳定性,但是由于前期的容量评估问题(业务增长加剧)及本身现有架构的局限性(单体应用),在仓库稳定运行一年左右,又出现了一些显而易见的痛点问题,如下展开说明。
05 痛点问题
4. 运维成本高:由于面向广大开发者,因此系统必须兼顾各种各样的网络环境问题、开发者能力问题等。企业对接客户常咨询消息量及消息消费情况,但无对应的审计数据可供参考。
06 目标
07 方案分析
07 消息仓库V3.0
综上分析,MongoDB不仅完全满足业务需求,同时在其他方面也优于其他方案,因此最终选用MongoDB分片集群作为了最底层的数据存储方式,并对系统架构重新梳理,分为四个阶段:消息接收阶段、消息中转阶段、消息写入阶段 、消息可视化阶段,主要职责如下:
1. 消息接收阶段(vop-worker):该系统仅关注不同消息源的接入,当前已接入中台近百个消息源,且依赖BTE任务平台、订单&商品池&主数据&消息中心等服务,通过过滤、清洗、封装等手段封装需入库的业务消息数据中转发出;
2. 消息中转阶段(JMQ集群):将消息中转出来,分级管控,当前分为四级,以此解决核心消息消费不及时、部分时段CPU内存飙升的问题。分级别设置消费线程数,低级别消息不影响高级别消息消费,低级别消息具备降级能力;
3. 消息写入阶段(vop-msg-store):消息写入阶段,批量双写,MongoDB+ES(支持多维度的运维审计查询及数据导出)。MongoDB解决tps10000+、数据量日均5亿+、多查询条件和数据分布不均匀的问题,解决数据库无法支撑租户数据均匀和消息内容可扩展的问题;创建mongo表,设置租户id和事件id索引、设置租户id的分片规则、设置唯一索引和超时时间45天。ES解决消息运维过程中,审计、核查等问题;
4. 消息可视化阶段(vop-support-platform):解决对客户生产/消费能力无认知、全局消息不可控和消息可视化的问题。并且数据可视化的不断完善又会反哺架构的可用性提升,为后续优化专题打下坚实的数据基础。
图5.消息四个阶段图示
支撑日均消息写入量5亿,现支持6wTPS和1wQPS; TP99从100ms提升至40ms,在高吞吐量情况下性能表现平稳; 新架构边界清晰,新需求不涉及核心系统的改造; 数据有效期7天提升至45天; It成本0增长; 消息可视化方面大幅提升运维效率,已全面开放技术客服使用。
08 消息仓库V3.0(回首往事)
之前作者团队一直铆足劲的往前追赶,如今系统稳定,为实现未来客户和商品的增量对消息仓库无影响&稳定运行3年+的目标,决定在限制资源有限性的情况下,转换角度思考问题和优化目标。随即针对消息数据开展了几个专题的治理,核心围绕流量治理、系统稳定性建设、降低成本三个方面出发。
流量治理(峰值情况下裁剪亿级消息量)
2. 无效客户管控(LoadingCache),由于其他端外界客户接入VOP,存在部分不消费消息的无效客户,需进行主动屏蔽,以此解决无效客户消息中转存储的问题;缓存,减少耗时操作等。
3. 消息过滤器(jimdb),通过防重控制+时间窗口对客户未消费且重复sku进行去重,以此解决客户消息消费延迟、客户消息量大、重复消息多、客户系统重启后消息量巨大的问题,并大幅减少MongoDB存储数据量。
系统稳定性(解决cpu毛刺及分片热点问题)
图7.作用过程示意
降低成本(非活动期间,白天消息量级相对晚上较少)
serverless自动扩缩:采用秒级消息接收量阈值和机器CPU阈值来触发自动扩缩策略,通过调优后非大促期间消息仓库整体资源成本下降52%。