迈进人工智能世界 01-03
卷积神经网络初探 04-06
惊世骇俗的狗故事 07-10
狗大师的修仙之路 11-14
谈起2023年最震撼的技术突破,莫过于ChatGPT大模型,其影响力远超2016年阿尔法狗在围棋领域的成就,让人工智能成为了热议的中心。人工智能时代已经到来了,不少人表现出些许焦虑,或担心自己失业,或纠结找不到合适的工作。什么,你不担心?好,让我们来体验一下AI的能力:“请创作一幅融合科技元素的春节庆祝画作”。(注:本文所有图片,均由人工智能生成)怎么样,惊艳吗?仅“请创作一幅融合科技元素的春节庆祝画作”这短短十七字指令,人工智能便开启了推理的过程,提炼出了2024、龙、灯笼来展示新春元素,提炼出电路板来展示科技元素,拿捏的这般恰到好处,厉害不?接下来,在相同指令下人工智能又画出一幅画,我们再来体验体验。
怎么样,如此喜庆是不是让你眼睛为之一亮。众多机器人在一片祥和喜庆中,载歌载舞....以上只是简单的一句话指令,实际上输入的指令越细致专业,输出图片就越能满足你的需求。交流中,大家不约而同的想到,在这人工智能发展如此迅猛的时代,我们的孩子们应如何装备自己,以便更好地迎接未来的挑战?这时,有人提出了一个想法——是否可以由我来为他们的孩子进行一次关于人工智能的科普,帮助他们更好地理解这一领域,并为将来做好准备。这个建议一经提出,立即得到了众人的积极响应。
给小朋友讲人工智能,虽说有一定的挑战,但是感觉挺有趣的。正好家中又有一个3年级的小朋友可以顺道一起科普,当即便答应下来。于是大家约好,第二天带娃相聚。
「02 人工智能是什么」
A:是机器人!
L:不完全对,人工智能(Artificial Intelligence),简称AI,指的是让计算机做一些需要人类智能才能完成的事情,比如认字、识图、写作、对话、下棋等。如果机器人只能做一些机械的重复性工作,就不算是人工智能哦。
B:L老师,人工智能是怎么做到这么厉害的啊?
L:厉害吗?你们认字、识图、写作、对话、下棋不是也会吗,又是如何做到的呢?C:有些是我自己学会的,通过看书我知道了很多以前不知道的动物,比如考拉和树懒等。L:很好,人工智能其实和你们差不多,通过两种方式让自己变厉害。一种是人类教他各种规则,告诉他事物的规律,称之为专家系统(Expert system)。还有一种是计算机通过自学来寻找数据的规律。被称之为机器学习(Machine Learning)。
A爸:哦,这么说,机器学习是人工智能的分支啊,我还一直以为人工智能和机器学习是同一个东西的不同叫法。
L:并非同一个东西。基于规则专家系统实现简单,易于上手,但覆盖面有限,不适合复杂场景。而机器学习是自己去发现规律,灵活全面,能适合复杂场景,但是成本高,不适合简单场景。两种方法各有所长。A爸:L老师,好比您教孩子们知识,他们学起来会比较轻松,但是所学有限。而自学虽然更辛苦,但是可以学的更全面。小A,如果你善于自学,就能青出于蓝而胜于蓝哦。L:A爸说的都很有道理,如今机器学习这个分支发展迅猛,已经在多个领域实现了超越人类的水平,因此我们交流的人工智能技术也会聚焦在机器学习上。「03 机器是如何学习的」
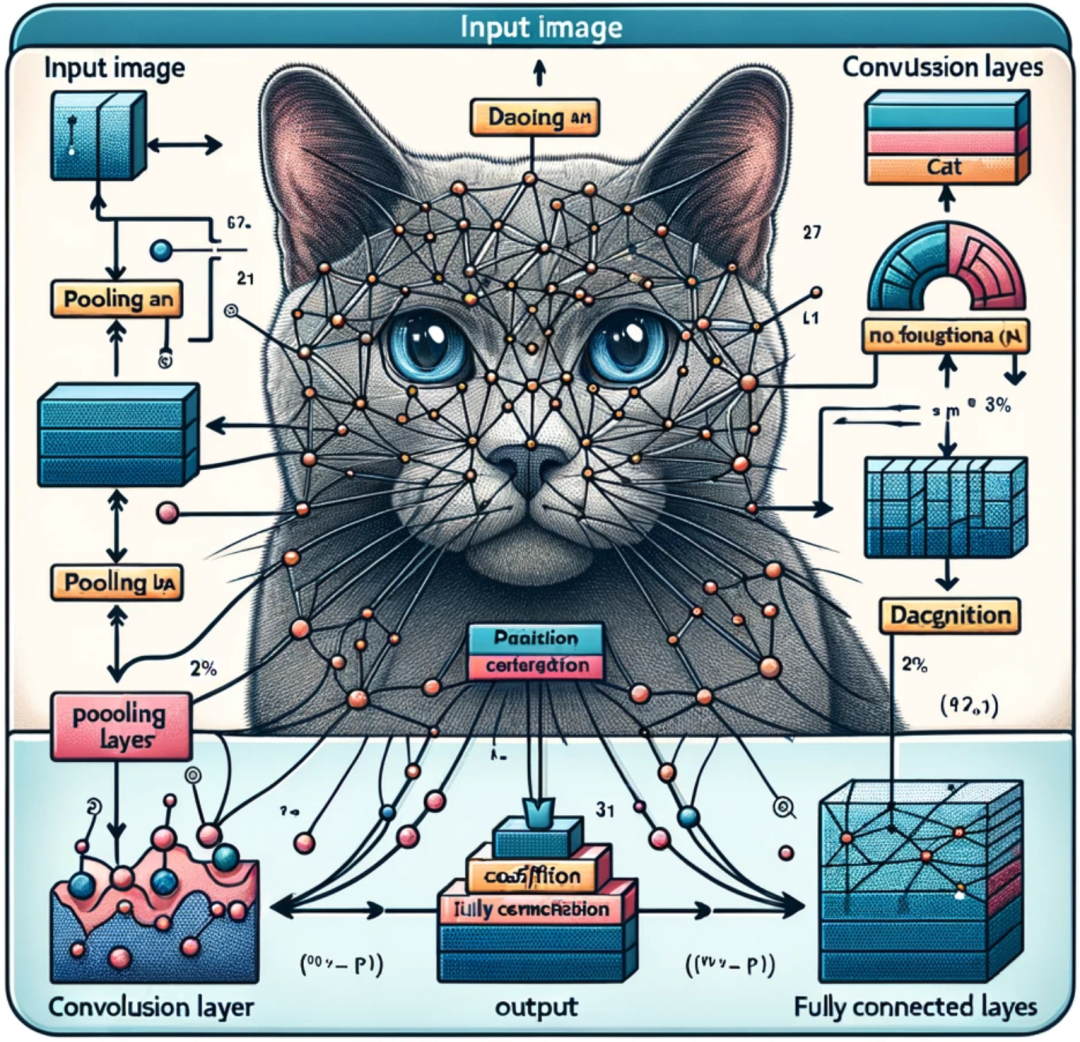
L:好问题。其实,让机器学习就像是让它通过观察世界来学习。比如,我们教机器识别猫,会给它看很多猫的图片,每张图片都告诉它这是猫。C:妈妈,这不是很简单嘛,你们告诉我猫长什么样后,我就会认识猫啊,我想机器也是一样的。L:小C真聪明,机器用到了一个叫作“神经网络”的算法模型,让它从大量数据中学习和提取规律来分析图片的体征。比如,它可能注意到猫有尖尖的耳朵,有绒绒的毛,有长长的尾巴。这些特征就像是线索,帮助机器理解“猫”是什么,确实和你学习猫的过程是差不多的。不过想要保证学的正确,并不容易。
C:为什么呢?
L:如果一只猫的耳朵掉了,或者尾巴断了,你还能分辨出这是一只猫吧。L:如果机器只是提取了耳朵和尾巴这些特征,他可就无法分辨出猫了。还有,如果你妈妈用一只白猫来教你识别猫,当你看到一只黑猫时,你还能分辨的出来吗?L:说明猫的颜色并非主要特征,如果机器以颜色作为主要特征,可能又要分辨错误了。是不是很不容易?L:虽然困难,但是总会有办法的,原理就像我们学习中的试错一样。如果机器猜测一张图片是猫,我们告诉它正确或错误,机器就会根据反馈调整自己的理解,不断尝试,每一次都在进步,慢慢就开始真正的了解猫了。L:是的,机器学习中的神经网络算法模型,就是模仿人脑的工作方式。只不过机器可以在非常短的时间内做成千上万次尝试,速度和效率远超我们人类。通过这种方式,机器不仅会识别猫,还能完成语言学习、下棋等更复杂的任务。众人纷纷点头,此时A爸面露困惑。
A爸:L老师,我有一个疑问,神经网络到底是如何提取出猫的这些特征的,一张图片在计算机的眼里,不就是一堆010101的数字吗?
L:问得真好,这个问题要让孩子理解可不容易哦。咱们下回分解。L:想了解人工智能,有一个必要的基础知识是不可或缺的,就是理解计算机是如何认识这个世界。小朋友们,你们知道计算机眼中的世界和我们一样吗?L:小朋友们,其实我们眼中的世界与计算机眼中看到的是大不相同。我们能直接识别各种信息,如数字、英文、汉字及日夜星辰、花草虫鱼、飞禽走兽、人间烟火、万事万物......但计算机看到一切都只是0和1的组合。
A:L老师,仅仅用0和1,真的能表示那么多东西吗?”
L:如果只有两位的数字,那只有00、 01、 10、 11这4种组合,确实没法玩了,但是位数可不止这么少哦,比如英文字母对应的就是八位的编码,理论上有00000001、00000010、00000011、00000101...... 等256种组合,其中小写字母a对应的二进制表示就是01100001。L:我说的是字母哦,包含大小写在内字母也就52个,所以256种组合已经绰绰有余,由于英文单词由字母组合而成,所以英文单词展示也就很容易实现了。A:我懂了。那汉字没法像英文这样进行字母组合,就需要更多的位数吧?L:小A真聪明!是的,汉字是十六位编码,理论上有0000000000000001、0000000000000010、0000000000000011、0000000000000101......合计65536种组合,足以覆盖所有常用汉字。我们一般把八位称之为一个字节,所以汉字的编码方式也称之为双字节编码。
L:图片更有趣了。图片是由许多被我们称之为像素的小点组成的,每个像素包含了红、绿、蓝三种颜色的信息。通过调整这三种颜色的强度,我们可以在屏幕上显示出各种颜色。C妈:L老师,这些像素都能转成计算机识别的二进制编码01组合,是吧。L:我再用一个简单的游戏来理解。这里有一张纸,上面画了很多小格子。如果想在这张纸上画一个笑脸,只需要在特定的格子里涂上颜色就可以了,每个格子就像是计算机的一个像素。同样大小的纸张,格子越多,即表示像素越多,画起来也就更加平滑,越能画出更精巧的图画。
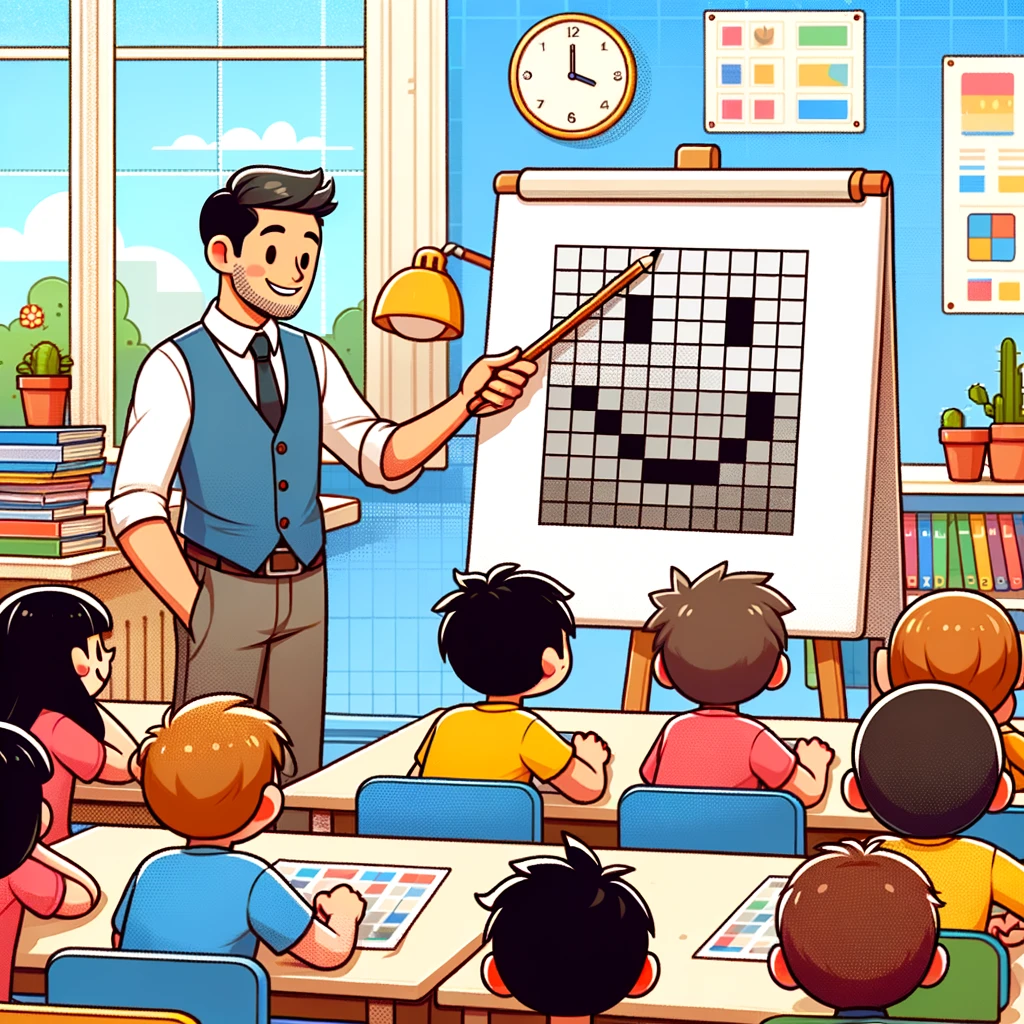
L:视频本质就是图片的快速组合,所以识别视频自然没问题。计算机如果能认识照片中的你,也能认出奔跑中的你。其实计算机不仅能“看到”万物,也能“听到”声音,还能“感受到”环境.....一切皆可转换成0和1的组合。只认识0和1的计算机,几乎无所不能。
L:这里需要提醒大家,相同的01组合输出对应的结果并非一定是唯一的,比如小写字母a对应的二进制表示就是01100001,而十进制的97对应的也是01100001。L:放心,一个是字母,一个是数字,它们的类型不同,计算机在存储它们时已经根据规则将它们打上了类型标识,这样不就区分开了啊。当然了,这个类型标识也是某种0和1的组合串。L:OK,了解了计算机眼中的世界后,我们可以继续探索人工智能的奥秘。「05 人脑的神经认知模型」
L:之前我和大家说过机器是如何学习的。提到了神经网络模型,同时也说明了依据这个模型可以提取到一些猫的特征,比如尖尖的耳朵等,同时也说明了机器根据反馈机制来试错,从而调整自己的理解,最终真正了解到猫。大家还记得吧。L:今天我们要进一步展开这个过程。其实识别猫的算法有一个更准确的名字,叫卷积神经网络(CNN),是神经网络模型的一种。CNN涉及到复杂数学模型,大家理解起来是比较困难的,不过有趣的是,神经网络和我们人的认知模式很相似,所以大家还是比较容易理解的。因此我会避开算法细节,通过和我们人类认知模式的对比,来给大家进行CNN的科普。在科学界有一种被称之为神经认知模型的主流学术观点。认为人的大脑里有很多的皮层,是一层一层对视觉信号进行处理的。光从眼睛进去之后,先进入第一个皮层,接着第二个皮层,一直往下。L:大致5到6个皮层。每个皮层对信号的处理方式是不一样的。最开始刚进到眼睛的视网膜里的时候,我们看到的光线是一大堆的像素点,在第一个皮层之中,这些像素点抽象出一些特征,比如说边缘。而且边缘具有方向性,有横、竖、斜之分。这些特征找完后到下一个皮层把这些特征组合起来,形成这个物体的轮廓以及这物体更多的细节。这样再往下不断细化,最后把轮廓和细节组合成一个整体,最终才会做出一个判断。A:可是,L老师,为什么我觉得我一眼就看到你了啊。L:小A,其实你一眼看到的并不是我,而是一个一个的像素点,这些像素点进到你的脑子后,首先会抽象出边缘和方向信息,你发现我是直立行走,应该不是一只猫。接着又发现了更多的细节,比如四肢、脑袋、鼻子、嘴....嗯,判断应该是一个人。继续观察下去,哦,原来就是L老师。只是,只是这些过程进行的太快了,所以你觉得是一眼就认出了我。
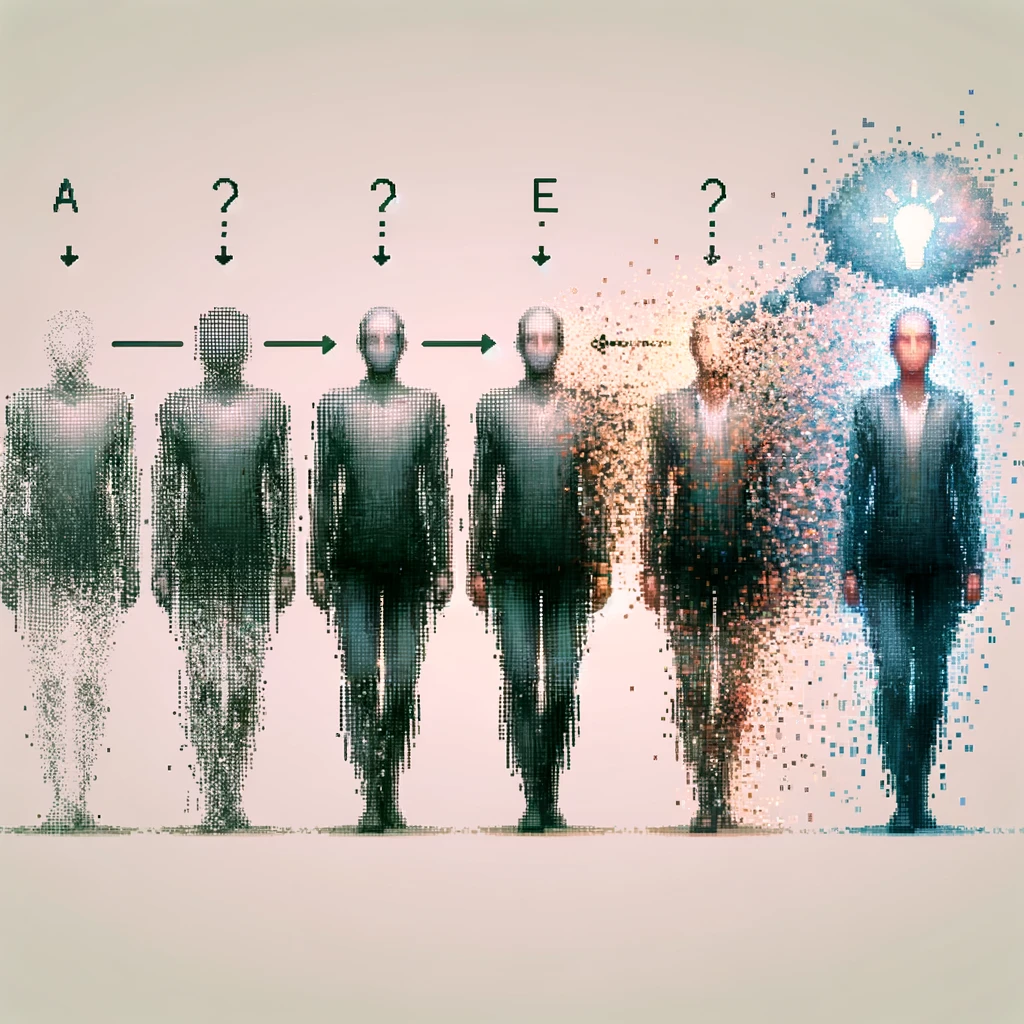
L:是的,受到神经认知模型的启发,科学家杨立昆就发明出了一种实用的图像识别方法,即大名鼎鼎的卷积神经网络。C妈:原来卷积神经网络是基于人脑的认知模型发明出来的啊,真神奇。L:是的,我也觉得很神奇。
「06 卷积神经网络」
L:现在,让我们深入探讨卷积神经网络(CNN)是怎样工作的。与我们的大脑认知模型通过一层层的处理,从简单的边缘和方向开始,逐步识别出复杂的形状,最终认出一个物体相类似。典型的CNN包括三个主要部分:输入层、隐藏层和输出层。隐藏层不仅仅是一层,而是多层,每一层都负责从图像中提取不同级别的特征。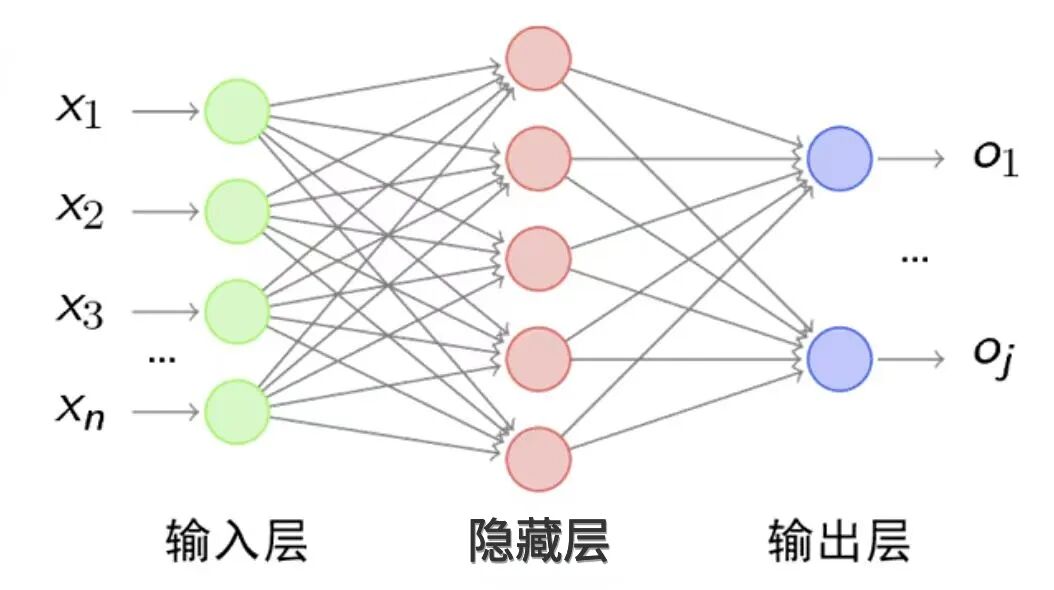
其中隐藏层可以有多层,每层都有卷积层和池化层。最后的输出层实际是一个全连接层,通过一个激活函数来输出概率的大小,得出最后的判断。L:隐藏层,顾名思义,就是在输入层和输出层之间的那些层,它们对我们来说是不可见的。在这些层中,卷积神经网络通过一种叫做“卷积”的操作来提取图像特征。简单来说,卷积就像是一个滤镜,它在图像上滑动,捕捉特定的图案,比如边缘、角点或更复杂的形状。滑动的动态过程示例如下图所见。B爸:那它是怎么识别猫的呢?
L:假设我们给网络一个猫的图片作为输入。在第一层隐藏层,通过卷积与池化,网络能识别出简单的边缘和角点。随着图像数据进入更深的层,继续卷积与池化,网络开始识别出猫的眼睛、耳朵等更复杂的特征。这些特征会被进一步组合,直到最后几层,网络已经能够识别出整个猫的轮廓。当然了,我这里说的眼睛,耳朵等只是打比方,卷积神经网络所提取的特征值只能被机器读懂,是我们人类所不能理解的。L:在网络的最后,有一个输出层。这一层通常包含一个或多个神经元,每个神经元代表一个特定的分类,比如猫、狗或者车等。每个神经元会给出一个分数,表示输入图像属于该分类的可能性有多大。在我们的例子中,如果“猫”这个神经元的分数最高,那么网络就会判断这张图片是一只猫。C:我懂了,原来最后是依据打分的结果来判断最后是不是一只猫啊。A爸:我明白卷积是用来提取图像特征,方式如前面动图所示(有些闪瞎我的眼),不过具体如何实现我还是不明白?L:这问题有些复杂,本想只示意不细说,既然A爸有兴趣了解,我就简化说明一下。我们把图像从彩色改为黑白,把识别猫改成识别一个简单的X图形,看卷积神经网络是如何利用卷积提取特征的。请看一幅7乘7的图片,如何让计算机来识别该图片是不是一个X。
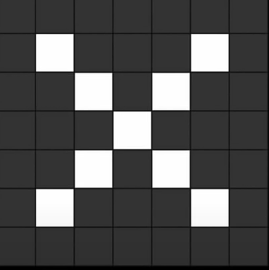
因为是黑白图,我们把所有亮的地方设置为1,黑色的地方设置为0,转换如下:
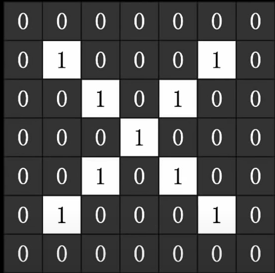
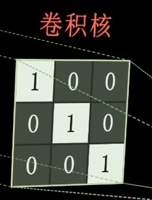
接下来是用一个叫卷积核的东西,来做卷积运算。卷积核也是一个方块,一般为3X3或者5X5。该卷积核从左到右从上到下依次是1、 0、 0、 0、 1 、0、 0、 0 、1。如下图所示:
该卷积核和上面的图像做卷积运算,如何运算,把这个3X3方块放到图片上的某个3X3部位,如下图所示:
让他们对应元素相乘,然后相加,最后放在图片3X3的中间部位。
0*1+0*0+0*0+0*0+1*1+0*0+0*0+1*1=2,于是特征图第一个元素就是2,同理把卷积核往右平移一下,和图片新的3X3方块进行对应元素的相乘相加,最后得出0,最后所有的元素都写出来,整体结果如下图所示。
做完这个有啥用呢,我们分析就明白,卷积核只有斜着的三个元素是1,所以原来那张图上如果斜着的这三个元素也是1的话,最后一做卷积,这个数字就会变大,我们在特征图上找那些数字特别大,这就是提取到的特征了。总结起来,这个卷积核其实就是对应了一个特征,这个特征为:一个斜向右下的线条。数字比较大的部位就说明它满足特征。这就是用数学方法提取图像特征。同理,X的另外一半是左下方斜的线段,新的卷积核如何设置,这里就不再赘述了。现在你再回过头看我刚才画的动图,是不是很好理解了。A爸:原来如此啊,有意思。对了,我看你有提到池化,池化什么意思?
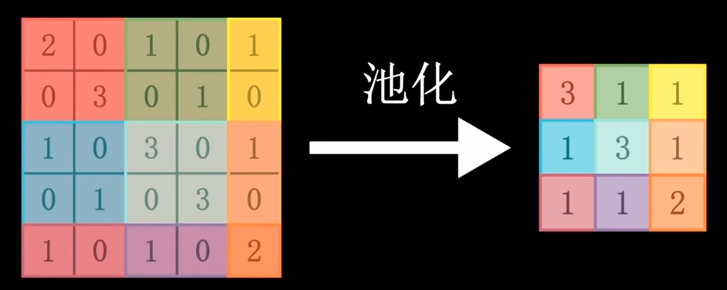
L:池化就是对特征图的元素做进一步简化。我们可以这么做,把每4个格子为单元,找出最大的那个数,其他剔除,这样组成一个比较小的特征图,却依然保留了原来特征图的重要信息,我们仍然可以看出这是一条右下斜着的线条。
L:这部分内容比较复杂,孩子们即便一时没听明白,也没关系,大家只要知道计算机可以通过某种手段将特征值提取出来,也就够了。L:卷积神经网络的应用可不只是识图哦,大名鼎鼎的阿尔法狗正是结合了卷积网络神经后,忽然功力大进,成为了吊打人类棋手的围棋之神。
A爸:不对啊,卷积神经网络不就是用在图像识别上吗,图像识别和围棋有啥关系呢?
L:好问题!放心,你很快就会明白这背后的真相的。我这里问大家一个问题,阿尔法狗水平忽然提高,是否是和计算机运算能力大幅提升后,棋盘上的计算量越来越大有关。A:肯定啊,我和爸爸都是围棋5段,我觉得计算是最重要的,我们下不过阿尔法狗,就是因为它的计算量太大了。
L:如果我说阿尔法狗碾压人类是和他在棋盘上的计算量越来越少有关,你们信吗?
L:我也是围棋5段,还是围棋AI工具的深度使用者哦,我很理解你们的困惑,咱们下回分解。
L:2016年1月Google旗下的人工智能实验室DeepMind团队在国际学术期刊《自然》杂志上发表封面文章,介绍AlphaGo在分先的情况下以5:0 完胜欧洲冠军、职业围棋二段樊麾。这是职业围棋高手第一次被电脑围棋程序击败,消息瞬间引爆围棋界。A爸:Google牛啊,居然以《自然》封面的方式来对外宣布消息。
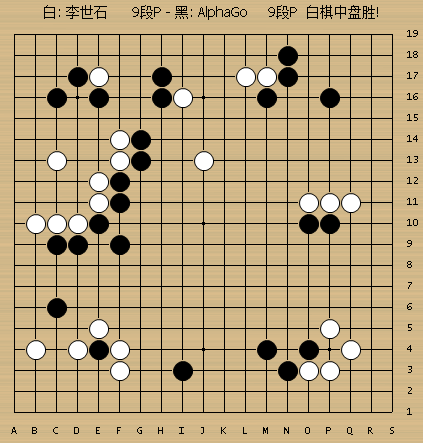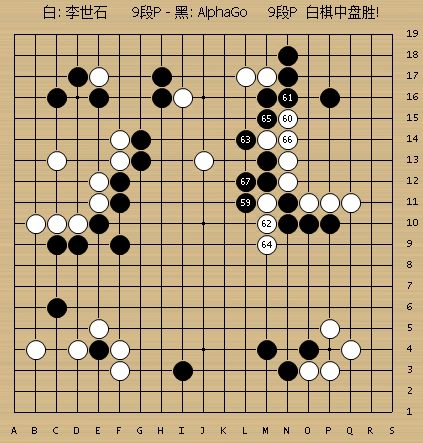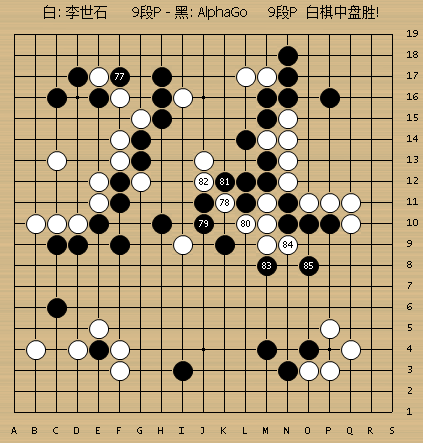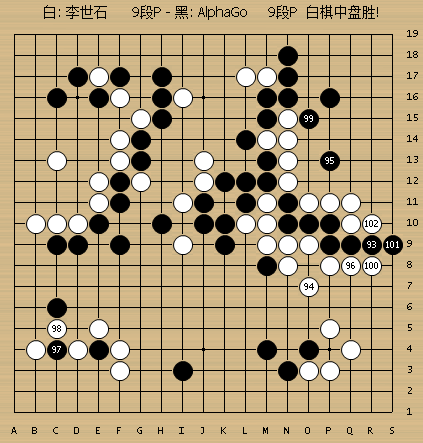
L:是的,不得不佩服谷歌的霸气。因为该版本AlphaGo和樊麾对弈,所以称之为AlphaGo Fan。C妈:为啥2015年的比赛结果在2016年公布呢?L:好问题!一会儿你会明白的。我们接着往下说,AlphaGo打败职业棋手固然令人震惊,但樊麾毕竟还不是最顶尖的职业棋手。在五局棋谱公布于世后,一个普遍的观点是,AlphaGo也不过如此,他能赢只是因为还没碰到真正的高手。2016年3月,Google邀请了手握十四项世界冠军的世界围棋第一人韩国李世石九段,与AlphaGo进行五番棋较量,胜者100万美金。李世石当即答应,并给自己设定了目标,输一盘都算自己失败。L:是的,结果大家也都知道了,李世石以1:4的成绩不敌AlphaGo,不过唯一的一胜却值得大书特书,李世石在第四局下出了实际不成立,却击中AlphaGo Bug的第78手,神之一挖,杀的AlphaGo方寸大乱,取得了畅快淋漓的一胜。可谁又能想到,这一胜,会成为人类棋手对围棋AI的最后一胜。
A:李世石输的这么惨,之前还如此自信。
L:当时棋界大多是看好李世石获胜的,不过Google内部其实早已知道李世石绝无获胜的可能。L:短短几个月,击败樊麾的AlphaGo Fan已经迭代出更强大的版本了,我们把这个版本称之为AlphaGo Lee。Google内部评估AlphaGo Fan战力为2900分,而即将与李世石对战的这个AlphaGo Lee,战力则高达惊人的3700分!工程师们认为,这两个版本实力的悬殊程度远超李世石与樊麾之间的差距,李世石再怎么顶尖,也不会有任何机会。C妈:我明白为啥2015年的比赛结果到2016年才公布,Google套路深啊。L:是的,Google没有对外说明其实力的进步,让外界对李世石获胜寄予厚望,套路确实深。此次决战万众瞩目,总观战人数过亿,堪称围棋史上的奇迹,结局更是轰动全世界,AlphaGo的一战成名,让Google成为了最大的赢家,市值连续大涨。L:是的,Google的运作能力远超你的想象。2017年初,AlphaGo化身"Master"的网络身份对战多位顶尖围棋职业选手,并取得了惊人的60连胜!在一片猜测中,Master宣布自己就是AlphaGo,我们把这个版本称之为AlphaGo Master。
此时,等级分超过李世石的当前世界第一人柯洁坐不住了,由于尚未与AlphaGo交手,柯洁宣称AlphaGo虽然赢得了李世石,却赢不了他。这引发了AlphaGo与柯洁的三番棋对决,2017年5月,一场毫无悬念的比赛开始了,AlphaGo Master以3:0的成绩轻松拿下柯洁。比赛结束,柯洁泪洒赛场。至此,Google用行动来告诉全世界,讨论围棋AI与人类棋手实力孰高孰低的问题,是毫无意义的。
A:这个AlphaGo Master比起之前的AlphaGo lee实力如何。L:Google内部对两个版本进行PK,,AlphaGo Master轻松碾压AlphaGo Lee。A爸:不断进步,真是让人佩服啊!至此,“狗”故事告一段落了吧。L:A爸,别急,精彩还在延续哦。AlphaGo碾压人类棋手只是牛刀小试而已,不过接下来,它可要放大招了。A爸:什么,要放大招,难道碾压人类顶尖棋手都还不算大招?L:是的。
「08 抛弃束缚,能力全面飙升」
L:2017年10月,Google推出了AlphaGo Zero,该版本仅依靠自我对弈,无需任何人类棋谱,从零开始自学围棋,仅经过3天的训练....你们猜发生了什么?L:仅训练3天的AlphaGo Zero,便以100:0 击败了AlphaGo Lee。A:3天?100比0?是那个击败李世石的AlphaGo Lee吗?A爸:L老师,您说AlphaGo Zero依靠自我对弈,无需任何人类棋谱,那就是说AlphaGo Lee和AlphaGo Master有依靠人类棋谱,是吗?L:是的,AlphaGo Lee主要是依赖人类棋谱进行训练的,研发团队为其输入了3000万张人类高手的棋谱进行训练;而AlphaGo Master虽然在前期的训练中也使用人类棋谱,但后期更多的是依赖自我对弈强化学习来提升水平的,对人类棋谱的依赖较小;而AlphaGo Zero则是完全摆脱了人类棋谱的依赖。
A爸:我算是看明白了,哪个版本对人类棋谱的依赖性越强,哪个版本的实力就越弱。这么说,AlphaGo的进步是被人类给耽搁了啊。
L:是的,A爸说得有道理。咱们接着往下,又有大招了。L:受到AlphaGo Zero成功的鼓舞和启发,Google推出了AlphaZero,大家观察一下,这个名字有什么特别之处吗?L:是的,小C观察得很仔细。这个版本厉害了,Go就是围棋的意思,没有了Go ,就表示不只是围棋。AlphaZero可以同时支持围棋、国际象棋、将棋等多个棋类游戏,展现了此方法的广泛适用性和强大通用性。不仅如此,更为可怕的是其超强的能力。
L:围棋能力自不用说了,在国际象棋中AlphaZero仅训练4小时就超越了世界冠军程序Stockfish;在日本将棋中,仅训练2小时就超越了世界冠军程序Elmo。AlphaZero再度惊艳全球,2018年12月7日,登上了当年Science杂志的封面。《科学》杂志评价称,通过单一算法就能够解决多个复杂问题,是创建通用的机器学习系统、解决实际问题的重要一步。C妈:妈呀,4小时,2小时,分别打败不同领域的最强者,难以想象!
L:是难以想象,AlphaGo不仅抛弃了人类棋谱,还跨越了围棋本身,在消除人类知识的束缚后,变得越来越强!不过,接下来还有更让你们难以置信的事的发生,终!极!大!招!来!了!众人:啊......
「09 无师自通,彻底放飞自我」
L:2019年底,Google推出一个更具有颠覆性的版本,叫MuZero,这个版本最神奇的地方在于,MuZero根本不知道围棋的规则是什么?
L:是的,我简要说说围棋规则吧。1.地多者胜;2.气尽棋亡;3.禁止全局同型再现。对此,Muzero是不!知!道!的!L:是的!当然了,围棋还有一些类似交替落子、棋子只能落在交叉点上、不允许悔棋等浅层规则,属于棋局环境预设,就不在讨论范围内了。L:哦,这里要澄清一下,不知道规则并不是没有规则,规则是存在的,只是MuZero不知道,我们并没有教它。准确的说法是,MuZero在深度神经网络和蒙特卡洛树搜索运行的过程当中,没有使用到上述围棋规则。而AlphaGo家族四大成员中的另外三位,AlphaGo、AlphaGo Zero、AlphaZero在运行中是知道这些规则的。L:其实,MuZero要做的事情说起来也很简单,既然没人教我规则,那就自己观察,自己学呗。
比如,在下棋的过程中,MuZero发现,哎呀,黑子放这里,怎么就把白子拿起来,慢慢就琢磨出了“气尽棋亡”;终局后MuZero在想,黑棋为什么就被判输啊,慢慢就明白了“地多者胜”;下着下着,哎呀,这子怎么就不能吃,奇了怪了,等一等怎么又可以吃了,哦,慢慢就悟出了“禁止全局同型再现”....然后,就可以开始碾压人类顶尖棋手了。
A爸:从老老实实学习大量人类高手棋谱的AlphaGo,到放弃人类棋谱自己琢磨怎么下的AlphaGo Zero,再到不满足围棋而将国际象棋将棋一并拿下的AlphaZero,最后演化出连规则都不用告诉他的MuZero。我的天啦,这也太魔幻了吧!L:这里最逆天的当属MuZero,通过在没有明确规则指南的情况下实现自我学习和决策,MuZero开辟了人工智能应用于解决任意复杂环境问题的新途径,其影响力已远远超出了围棋领域,预示着未来人工智能技术在更多领域的广泛应用和深远影响。A爸:AlphaGo这是升华了啊!
「10 阿狗远去,江湖英雄辈出」
L:AlphaGo以碾压人类顶尖围棋高手的方式出道,可谓技惊四座。正当我们用出道即巅峰来形容AlphaGo时,不想AlphaGo居然用一套让人眼花缭乱的组合拳告诉大家。嗨,哥出来的那个位置,其实只是山脚哦。无论是具体知识、所处领域、还是领域规则,没有什么限制是不能突破的,AlphaGo已经开悟了,在推出MuZero后AlphaGo决定不再投入任何与围棋相关的研究与活动,而转战他处。至此,围棋江湖只留下了AlphaGo的传说。A爸:您讲述的AlphaGo系列让我大为震撼,我都不知道该用什么语言来表述我的心情。
L:我也很受震撼。AlphaGo淡出围棋圈后,其公开的论文成为了围棋AI江湖的武学宝典,Leela Zero、KataGo、绝艺、星阵等围棋AI接过了AlphaGo手中的大旗,成为了围棋AI中耀眼的明星,并解决了AlphaGo留下的诸多不足,实实在在推进了围棋AI的发展,在提升人类棋手棋艺方面,做出了巨大的贡献。
A:什么,大杀四方的AlphaGo,还会什么不足之处吗?
L:是的。AlphaGo是基于深度学习网络(卷积神经网络)和蒙特卡洛树搜索结合的产物。其中深度学习网络主要是训练出来两个网络,分别是价值网络和策略网络。而这个价值网络在AlphaGo这里体现的是胜率,如果对价值的判断仅仅停留在胜率上,对人类棋手的学习和理解,是不够的。L:围棋的输赢取决于谁的地盘更大,所以目差对于人类棋手来说,是一种更直观的感觉。比如分析一手棋掉了15%胜率时你会觉得非常惶恐,但是当你知道这个15%对应的实际损失的目数才2目时,你又没那么紧张了。所以这些明星围棋AI大多都在判断胜率的同时增加了目差,这种改变让人类棋手大为受益。具体实现的原理,我后续也会进行相应的科普。L:围棋本质是比较谁的地盘越大谁赢。但是胜率最高的下法,是否就一定是对围地盘最好的下法呢?L:那可不一定,围棋虽说是谁围得大谁赢,但是赢半目也是赢,赢100目也是赢,从赢棋的角度来说,这两者是没区别的。AlphaGo围棋的策略是胜率优先,所以它会在领先的时候不断的退让,在终局时稳稳的收住胜利的成果,往往不多不少就赢你那么一点点。比如他分先赢你一点点,让两子也赢了一点点,让三子依然只赢你一点点。你永远无法逼出让他使出全力的时候,我们也就永远无法从他那学到真正的棋艺。A:原来是这样啊,那AlphaGo之后的围棋AI做到了吗?
L:是的,各围棋AI基本都做到了,其中典型代表就是星阵围棋,多次获得AI围棋世界大赛的冠军,号称不退让围棋,不走自己心中认定的最佳变化不罢休。要是能赢你100目,就绝不只赢你99目!所以星阵围棋的棋很激烈,观赏性很高,棋手也更容易从星阵中学到妙手,是完美主义者心中的最爱。
此外KataGo围棋也很有趣,甚至允许通过一定的参数调整,让其下出类似“欺招”这类的过分手段,来考验人类的应对能力。L:有啊,比如可以通过仅和你下一盘棋,就可以评估出你的围棋实力,为你定级定段,准确度相当的高。还有许多实用的优化策略,这里就不一一赘述了。至此,“阿狗”简史告一段落。
「 11 阿狗附体的小A」
L:接下来,是时候对其运行原理进行科普了,今天就来和大家探索一下阿尔法狗强大的秘密。
L:先问问5段小高手一个问题。小A,假如你爸爸正在参加围棋比赛,你到现场观战时会做什么?
A:我会判断棋局形势,如果是爸爸大优,我会出去给妈妈报喜。如果不利则会为爸爸想想有没有什么地方可以拼一拼。L:了不起!你的思路和阿尔法狗一模一样,看来小A和狗大师一样强了。L:是的。你判断局面优劣的方式,在AlphaGo这对应着一个专业名词,叫价值网络。而你找机会拼一拼的尝试,在AlphaGo这也对应一个专业名词,叫策略网络。A:有意思,原来阿尔法狗和我们人类棋手思考方式是一样的啊。L:是的,小A,当你觉得某些地方可以拼一拼时,你会立即落子呢,还是会沿着这些选点往下计算,等可行性验证完毕后再落子。A:当然先计算啊,如果计算后发现这些选点并不好,我就要考虑换选点。L:恭喜!你对选点可行性进行计算验证的思路,依然和AlphaGo是一模一样的,其对应的专业名词为蒙特卡洛树搜索。小A,你真是阿狗附体啊。
笑声再起,小A有些不好意思了。
A:L老师,我觉得自己的思考方式也没啥特别之处,棋手不都是这么做吗?L:你觉得没有什么特别的,可对围棋AI而言,有这样人类棋手的思考方式,可是不得了的事了。A爸:L老师,难道就是因为有了类似人类棋手的思考方式,阿尔法狗才变厉害的吗?L:A爸,你说对了!
「 12 裁剪才是王道」
L:接下来我给大家讲一件趣事。有两位棋友展开一场特别较量。一位是拿过市冠军的围棋业余高手,一位是实力更为强大的围棋职业高手,比赛规则是业余棋手用时150分钟,而职业棋手则被限制为5秒内必须落子。此外,为避免职业棋手利用对手时间思考,还增设了对手落子前职业棋手只可看书不可看棋盘的规定。双方分先对弈,大家猜猜输赢。
L:大家猜对了。不过,你们说这局棋谁计算的更多呢?B爸:业余棋手能拿全市冠军,其计算力自是不弱,加上思考时间充足,必然会完成大量计算。而职业高手5秒一步则根本没时间细算。肯定业余棋手算的多。L:B爸说的有道理!这是不是说明算的多也不一定能赢。L:输赢还是和棋力有关。棋力弱的思考的方向往往不太对,在错误的方向行棋,想的再多也不会有太好的结果,而棋力强的思考的方向往往是对的,在正确的方向行棋,即便无暇细算也不容易出现太差的结果。C妈:会不会是150分钟还不够,如果给业余棋手更多的时间,让他把棋的各个方向都考虑一下,逐一比较选出最佳一手,这样应该能赢吧,毕竟职业棋手的思考时间太少了。L:C妈,即便无限时也不可能各个方向都考虑的,围棋的复杂度太高了,遍历是绝无可能的。我们来评估一下围棋的复杂度。围棋棋盘有19*19=361个交叉点,A先行,有361种落子可能,B则有360种落子可能,接下来A有359个选择,以此类推......这样所有可能出现的流程数量可用361的阶乘来估计,大约为10的768次方,这里尚未考虑棋子被吃后,空出的地方依然可落子的情况。不过很多流程实际是不会出现的,如禁着点不能落子,如不可能密密麻麻的把棋盘全摆满......剪裁后更为准确的评估结果是,围棋复杂度大约为10的360次方。可能大家对这个数字没概念,如果我说可观测宇宙所有原子的总数为10的80次方上下,这么一对比,是不是吓到你了。
A爸:难以置信!
L:早先的围棋对弈程序就是遍历的思路,由于不可能穷尽所有变化,所以不得不引入人为或随机性规则,这种模式以蒙特卡洛树搜索为代表,一直未取得突破。AlphaGo出现后,巧妙的将蒙特卡洛树搜索与深度学习结合,于是人类棋手就抵挡不住了。其核心在于:AlphaGo在下棋时能裁剪大部分无效的计算,从而将计算量大幅缩小。C妈:那AlphaGo是如何裁剪?
L:那人类是如何裁剪的,如果职业棋手不具备很强的裁剪能力,如何5秒一步战胜市冠军?
C妈:是啊,这位职业棋手如何裁剪?
L:直觉!他一眼就识别出棋局好坏,一眼就看出局面大致应对方法。这种直觉也可以称之为棋感。
L:训练出来的。职业棋手通过大量学习和对弈,在积累足够多经验后,就产生了棋感。C:我明白了,AlphaGo和这位职业棋手一样,也有直觉。能一眼识别出棋局好坏,一眼看出局面大致应对方法。也是通过大量的学习和对弈训练出来的。L:回答的太好了,完全正确!
「 13 棋局与图片,特征与权重」
L:一眼识别出棋局好坏的能力在AlphaGo这里对应的就是价值网络,而一眼看出局面大致应对方法的能力则对应策略网络。对了,大家是不是觉得有些耳熟。A:是啊,您之前问我观战爸爸对局时做什么时,也提到过。L:嗯,很棒!狗大师成功的秘密就在这两张网络上,大家还记得我在讲述卷积神经网络时提到的图像识别吗,包括识别猫,识别X图形等。A爸:记得,其中用卷积核进行特征值提取的数学应用,给我留下了很深的印象。当时我还有一个问题没搞明白,卷积神经网络主要用在图像识别等场景,这和AlphaGo提升棋力有啥关系。L:其实还是比较好理解的。一个能识别猫的卷积神经网络可以识别出各种各样的猫,那如果你把围棋的每个局面当成一个图片,是不是也就认识各种局面了。L:卷积神经网络经过无数的训练,比如通过识别大量的猫图片,了解了猫的特征。比如其整体轮廓,尖尖的耳朵,有绒绒的毛,有长长的尾巴....最后终于形成了对猫的认识。同样,通过学习大量的人类高手棋谱及自我对弈产生的棋谱后,AlpahaGo就对各种各样的局面进行了分类总结,可以类比为识别出什么样的棋型是死棋,什么样的棋型是活棋,什么样的棋型是危险的,什么样的棋型是安全的,什么样的棋型是厚的,什么样的棋型是薄的......好比了解了这是猫,这是狗,这是猪,这是牛....这是非常重要的一步。随着训练量不断增大,分类总结就越来越细致和准确。这和卷积神经网络识别世界万物一样,AlphaGo通过卷积神经网络认识了围棋世界的万物,也就是说他提取出了各种棋型的特征,识别了围棋世界的各种棋型。棋局即图片,和识猫本质相同。当然了,这里说的死棋活棋危险安全厚薄都是便于举例所做的类比,在机器的世界里自有他自己的特征,并非我们人类所能理解的。
A:L老师,千古无同局,围棋的棋型有数不清楚,这怎么统计的过来呢?
L:这世上不可能有两只一模一样的猫,可以说千古无同猫,但这丝毫不影响AI准确的识别出猫。卷积神经网络识别猫的过程实际上是收集猫的各个不同的特征与权重,合在一起打一个分数,最后根据打分结果来实现猫的判断。这里有一个非常重要的概念,叫权重。可以这样定义,权重是一种分配给一个元素或变量的相对重要性或影响力的度量。爸爸妈妈们应该都能理解,小朋友们你们知道是什么意思吗?
L:其实说起来很简单,比如对于识别一只猫来说,颜色是猫的特征之一,但是用颜色对识别是不是猫的贡献很小,因为黑猫白猫都是猫,所以颜色的权重就非常低。假如尖尖的耳朵对识别猫的贡献是比较大的,这个特征的权重就会很高。在识别猫的过程中,机器会用自己的方式来收集各种猫的特征,并为这些特征设置权重。
A爸:那机器如何设置各个初始权重,又如何调整呢?
L:问的好!机器学习是一个动态的过程,开始的特征收集和权重设置都比较随机,不过别忘了卷积神经网络是有反馈机制的,并且可以根据反馈进行自我调节的。故事上演了,在无数次认错猫后,机器会捂着被扇红的脸在想,这猫的颜色特征好像作用不大啊,嗯,得调低权重。不久后又觉得,不对,这颜色特征感觉压根儿没用,坑啊,甭提权重了,把它开了吧。再到后来它又有新发现,哇,这个耳朵特征好像是识猫好宝贝,咱一定要重视起来,权重得高....就这样,通过不断调整权重等参数,反复尝试,这台机器变聪明了,成为了识猫专家,具体流程如下图所示。
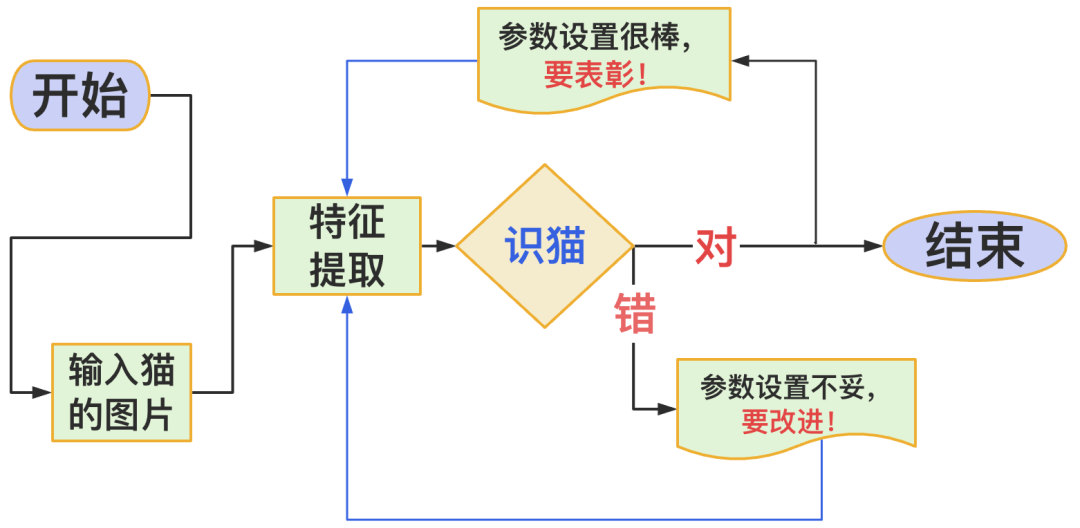
A:老师我明白了,围棋虽然千古无同局,但是依然可以分类总结各种类型的棋型,机器是提取特征而不是保存画面。L:说的很好!围棋和识别猫基本上是没有差别的,同样是一个动态调整优化参数,实力持续增强的过程,差别在于围棋AI可以通过模拟和实际下棋的输赢结果来做反馈,而识别猫则需要人工来反馈。具体流程如下图所示。
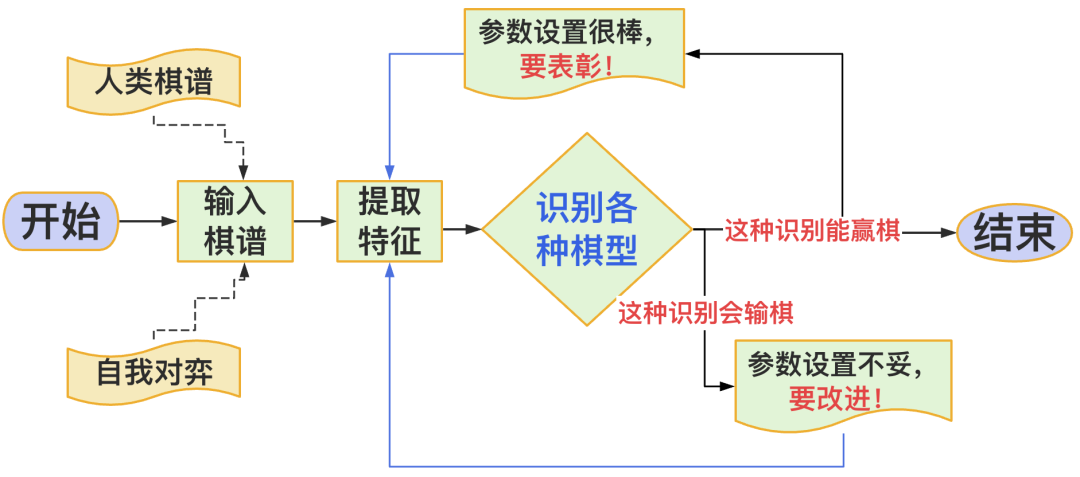
A爸:L老师,你这流程图还真清晰,我算是彻底明白了。L:A爸,你明白了,可我却完全不明白哦。
A爸:啥?
L:围棋的各局面及对应的提取的特征及权重,都不是我们人类所能理解的,但是却很好的完成了任务。这种黑盒子般的机制也导致部分科学家有些担忧,担心技术上失控。
A爸:那L老师您担心吗?
L:相比技术上失控,我更关注普通人如何与人工智能相互协作,而不至于被这个时代淘汰,协作真的很重要,狗大师为什么这么厉害,也是取决于其内部几个关键技术的完美协作。「 14 完美协作成就修仙之路」
L:大家知道,早先的围棋程序主要是依据蒙特卡洛方法实现,这种遍历算法受限棋盘太大,始终无法战胜人类职业高手。不过蒙特卡洛方法其实并非实力不济,而是缺少一个好拍档。很快,一位名叫深度学习(卷积神经网络)的大神来了。只见他手持价值网络和策略网络两大神器,激动的和蒙特卡洛树搜索紧紧拥抱在一起,开启了完美协作。然后,狗大师一下子变强了。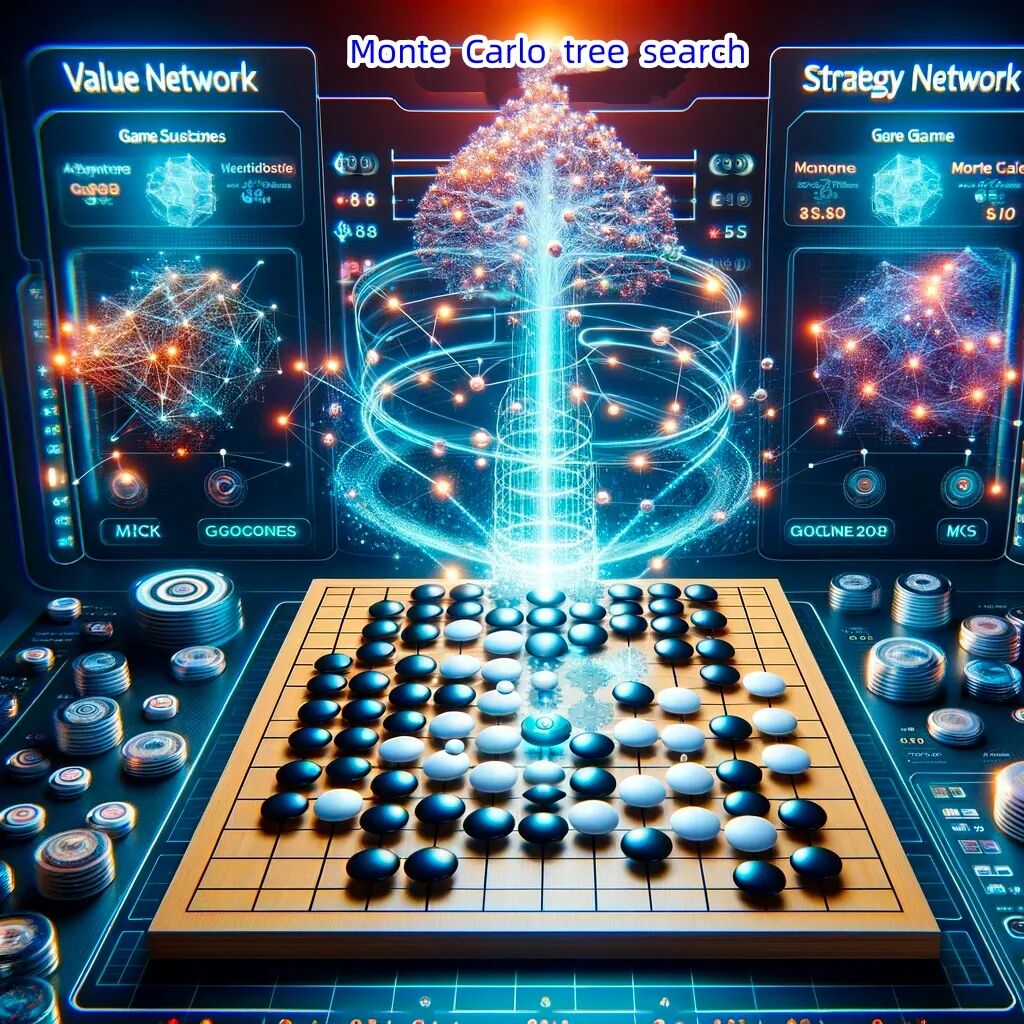
L:想象一下,蒙特卡洛树搜索就像是一个探索者,它在棋盘上寻找可能的路径。但在无尽的可能性中,它需要指引。这时,策略网络就像是一盏明灯,为蒙特卡洛树搜索指明方向,告诉它哪些路径值得探索。而价值网络则像是一个智者,它评估这些路径的价值,告诉蒙特卡洛树搜索,哪些路径可能引领至胜利。
通过这样的结合,AlphaGo能够在众多可能中,高效地找到最有价值的路径。策略网络缩小了搜索范围,使得蒙特卡洛树搜索不再盲目探索;而价值网络则提供了对每个局面胜负的快速准确预测,这使得每一步决策都建立在坚实的基础上。其实这种结合其实很好理解,就是棋感和计算相的结合。关键是,棋感的提升是可以通过不断的迭代中,反复提升的。狗大师落子的具体流程如下图所示。A爸:明白了,这样的配合确实大幅裁减了不必要的搜索,太巧妙了。L:AlphaGo确实设计的非常巧妙,也取得了非常大的突破,Google公司确实非常了不起,我们之前提到了AlphaGo、AlphaGo Zero、AlphaZero、MuZero外,继续不断前行,推出了研究蛋白质折叠预测的AlphaFold,为人工智能技术在生物学和相关领域的应用将打开新的研究方向。在2024年1月,Google又新的面向数学几何领域的模型 Alpha Geometry,数学几何能力已达到人类奥林匹克金牌选手的水平。小朋友们听得直咂舌,直呼不可思议。
L:大家发现没,这些天我们提到的人工智能应用都是锁定了一个特定的领域,比如人脸识别、下棋、打游戏、研究蛋白质、数学....也就是说,还不够通用。大家知道我接下来要提的是哪款人工智能产品。
众人几乎异口同声:Chatgpt。
L:是的,OpenAI公司推出的通用大语言模型Chatgpt无论是实现复杂度还是资金投入,都远超Google的Alpha系列,这是一个更为颠覆的产品,对社会产生了深远的影响,和每个人的命运都息息相关。大家是非常有必要去了解其实现的原理与机制,并学会与之高效合作。
A爸:Chatgpt的原理有什么特别之处吗,我觉得不就是将大量人类知识投喂给Chatgpt,当人们和他交流时,他从数据库里调出知识与你问答,我其实也不觉得有多颠覆啊。
L:A爸说的既对,又不对。我们不能简单的把大语言模型和数据库画一个等号,这里细节我们后续展开。我问大家一个问题,我们让Chatgpt写一首李白的静夜思,他写的出来吗?
众人纷纷认为可以。
L:回答正确!不过,如果我告诉大家,Chatgpt的数据库里根本就没有保存这首诗,也没有上网去搜索,就能为你一字不差写出静夜思,你们信吗?
A爸:这怎么可能,难道他能自己创造出李白的诗,还一字不差?
L:A爸,还真被你说对了,静夜思还真是Chatgpt创造出来的,具体是这样的。你让我写一首李白的静夜思,我该怎么写呢?让我好好想想,我怎么觉得第一个字应该是床,下一个是啥,应该是前吧....然后写出了床前明月光,疑是地上霜。举头望明月,低头思故乡。
L:我可没跟大家开玩笑,Chatgpt还真就这么把李白这首诗创造出来了,甚至他说的每一句话都是创造出来的,这才是真正颠覆的地方。他说的每一句话,在网上都找不到一样的存在,他是在创造。
众人的笑声停住了,很是惊愕。
A爸:L老师,为什么您说我回答的既对又不对,这啥意思呢?
L:这个问题很有趣,我们下回分解。
 梁敬彬约 32 分钟