⓹大模型实现背后的惊人秘密 15-18✓
⓺注意力就是你所需要的一切 19-23
⓻无名故事与GPT-4训练流程 24-27
⓼无名故事与GPT-4推理流程 28-31
本集论证出大语言模型真的是创造而并非背诵出出了李白的静夜思,背后的原理是神奇参数代替海量数据。接着通过有趣的例子给大家演示,大语言模型语言到底是如何通过词向量化结合海量书籍论文网页新闻等资料的阅读,一步一步实现了对语言的深刻理解。「 15 神奇参数替代了海量数据」
L:上回我们说到了大语言模型ChatGPT,提到它能“创造”李白的《静夜思》而非背诵,大家有些难以置信了,是吧。
A爸:是的,我现在依然认为您在开玩笑,我认为《静夜思》肯定是存在于ChatGPT内部的数据中,或者就是它上网搜的。
B爸:会不会这样,当你和它随意聊天对话时,它的回复是一种创造。当你问及史料诗歌这类记载时,他就搜资料来回答你。
L:B爸说的似乎有理,有中庸之道的感觉。
众笑。
L:事实上不只是《静夜思》,任何知识类的问题它都能对答如流,如果数据都存在其内部,那ChatGPT存储的内容得覆盖绝大部分的网页文本、书籍、维基百科、科学论文、社交媒体、专业文献、新闻、报告....才能做得到。问题来了,这可是要存储海量数据啊。
B爸:这么庞大的数据来源,数据海量不是很正常吗,有什么问题吗?
L:你是直接连接大模型官网进行在线访问的,这种方式个人使用尚可接受,而企业客户出于数据安全性、自主可控性等因素,则无法接受,所以企业会选择本地私有化部署,实际上各主流大模型也都支持这种部署方式。大家思考一下,我说这段话想表达什么意思?A爸:我明白了!如果大模型在企业是本地部署,按照之前我们的认知,就意味本地要有这些海量数据,那存储成本必然惊人。大模型也就难以在企业落地了。(注:本文所有图片,均由人工智能生成)
L:A爸说的太对了!现在大家还会觉得ChatGPT自带海量基础数据吗?A爸:如此说来,ChatGPT是真不太可能去存储这些海量基础数据了。L:A爸,你想通了啊,现在相信ChatGPT是自己“创造”出《静夜思》了吧。A爸:从推理上我相信了,可怎么做到呢,感觉像变魔术。A:会不会这样,ChatGPT只存一部分基础数据,这样存储空间就不大了?
L:小A啊,基础数据要么就都存,要么就都不存,存一部分就意味着很多数据会查不到,这还能叫通用人工智能吗?L:接下来,我问问ChatGPT4,看看它是如何回答的,好不好?众人非常期待! L老师当即调出ChatGPT4进行问答,很快结果出来了,如下。
看到ChatGPT自己承认了既不是上网搜的,也不是因为数据库中保存了这首诗后调用的,这下大家彻底信了。
L:其实从某种意义上来说,网页文本、书籍等这些海量基础数据也可以说成是ChatGPT的一部分,所以这些基础数据也可以称之为训练数据。只是ChatGPT训练完毕正式启用时,它就不再需要这些训练数据了。然而,正是基于海量基础数据的训练,ChatGPT内部产生了许多神奇的参数,这些参数的数据规模相比训练数据的数据规模而言,微乎其微,不过作用惊人。
换句话说,让ChatGPT写出《静夜思》,不是因为它读取原诗的内容,而是它在通过基于各种参数的计算分析统计后顿悟了,于是刷刷刷,写出来了。
L:是的,就是这么神奇。对了,A爸,你还记得上一次你说过的话吗,你认为ChatGPT是在得到人类大量知识的投喂后,就能做到随时从数据库中调取调出知识来和人类交流。A爸:记得,您说我既对又不对。我明白为什么了。知识投喂更准确的应该是知识训练,调取出知识更准确的应该是训练出参数。「 16 语言与神经网络一样是分层的」
L:作为大语言模型,首要任务就是要理解人类语言,大家觉得ChatGPT是如何做到的?C妈:是不是它博览群书后,自然而然就理解了,学的越多理解的越深。L:C妈回答基本正确。我们人类语言是分层的,随着一个人从小长大,他的阅读量越来越多,社会实践也越来越多,那么他从语言中可以读出的信息量也就越来越丰富,洞察力也越来越深,对事物的判断和预测也越来越准。同样的,随着ChatGPT版本不断迭代,网络规模越来越大,它可识别的特征层级也越来越深。L:最基本的是语法、语义;接着是语气、风格、情绪;然后是语言背后的意图、偏好;进一步到文化、心理;以及更进一步的价值观、意识形态等底层的社会学特征等等。
C妈:L老师您这么一说,还真是如此,我感觉我的回答有些肤浅了。ChatGPT就是一个机器,它能实现这么深刻的分层认知吗?L:大家还记得卷积神经网络吗,我提到过分层的结构。包括如何逐层细化识别出猫,以及如何通过识别棋局形成价值网络和策略网络的过程。A爸:记得,您提到卷积神经网络分为输入层、隐藏层和输出层,其中隐藏层可以有多层。
L:是的,我们一般把隐藏层超过3层的神经网络也称之为深度学习。大家注意到没,理解人类语言其实和认识猫、AlphaGo下棋本质无区别,都是逐层提取特征最后完成输出。比如猫的轮廓、毛发、脸型、耳朵,胡子、尾巴......比如围棋的死型、活型、外势、实地、危险、安全、厚、薄、气、目数......比如人类语言的语法、语义、语气、风格、情绪、意图、偏好、文化、心理、价值观、意识形态....更多细节可参考OpenAI论文《Language Models are Few-Shot Learners》。L:是的,大道至简,万事相通。看上去完全不同的图像识别、下棋、人类语言理解,本质居然是一样的,都是多层特征提取,都能用基于神经网络的架构解决问题。C妈:L老师,ChatGPT对语言的理解比我们人类更厉害了吗?L:从ChatgGPT4展现出来的语言理解能力来看,确实已远超大部分人,后续我会和大家一起感受感受。A爸:ChatGPT能从这么多维度来理解语言,这水平不高都不行啊。L:是的。这里我再强调一些,这些维度只是一种易于理解的类比,实际维度并非我们人类所能理解的,当然了,其维度的数量更是惊人。A爸:L老师,您说的让我茅塞顿开!不过语言的文字组合是天文数字,每种组合含义又各不相同,理解人类语言难度不小吧,具体该如何实现呢?
L:ChatGPT的语言理解从宏观层面看,和猫的识别、AlphaGo下棋等几无差异。但是具体落到实现的细节处,却是有着天壤之别。「 17 向量化是理解语言的第一步」
L:ChatGPT是如何做到看见一句话,就能准确理解其意思呢?这里至少需要两步,第一步叫向量化,第二步叫信息压缩与特征提取,我们先来看向量化。
B: 什么是向量化?
L:简答来说,就是要把你要表示的东西变成一组数字的组合。比如我们要表示一个人,可以用这样一组数字:【0,140,35,10】来表达。
B:这啥意思啊。
L:假设第一个数字表示性别,0是男,1是女,第二个数字表示身高,第三个数字表示体重,第四个数字表示年龄。小B你知道是啥意思了吗?
B:表示一个身高一米四,体重三十五公斤的10岁男孩,咦,这不就是我吗?L:哈哈,如果你觉得可能还不一定是你。我们可以增加更多的维度,比如【性别,身高,体重,年龄,胸围,腰围,臀围,体脂率,血压,视力,爱好,特长,年级,学校,城市....】而这些都可以表示成数字,维度越多,对一个人的定义就越准确。
A爸:那为什么要向量化呢?
L:一方面是向量化能表示成数字,方便电脑处理,更重要的是,向量化以后的空间结构,能很好的展示出规律。我们仅以身高和体重两个维度形成坐标系来举例说明。如下图所示,所有与【140,35】坐标接近的位置,就是体型和小B相似的人。比如身高1米42,体重36公斤的小A就距离小B很近。而身高185,体重80公斤的A爸,则距离小B很远。我们可以增加更多的维度,比如增加年龄,就变成三维坐标系,再增加性别,就变成四维坐标系...衡量的标准就越多,维度越多。在多维坐标系里,我们就能更多的通过空间关系理解每一个人的特征。大家能听明白吗?
如此通俗易懂,众人纷纷点头。
L:接下来引出关键之处了,大家想想,其实词语也是一样的。如果我们把词语放在一个高纬坐标里,意义相近的词语,空间就会更近。
比如“美”和“好”。从词性维度上,它们都是形容词。从贬义褒义上它们都是褒义,从使用场景上,它们经常一起出现....还有各种我们猜不出来的维度,所有这一切维度让它们在一个高维坐标里,出在了比较近的距离。
A爸:有意思,原来是这样啊。
L:还有更有意思的,因为向量是可计算的,可相加相减相乘,当我们把词语放到向量空间后,我们发现神奇的事发生了,“国王”这个词减去“男人”再加上“女人”,得出的向量居然和“女王”或者“王后”的位置非常接近,这说明在一个合适维度的坐标中,词语之间的空间关系反映了它们现实世界的实际关系。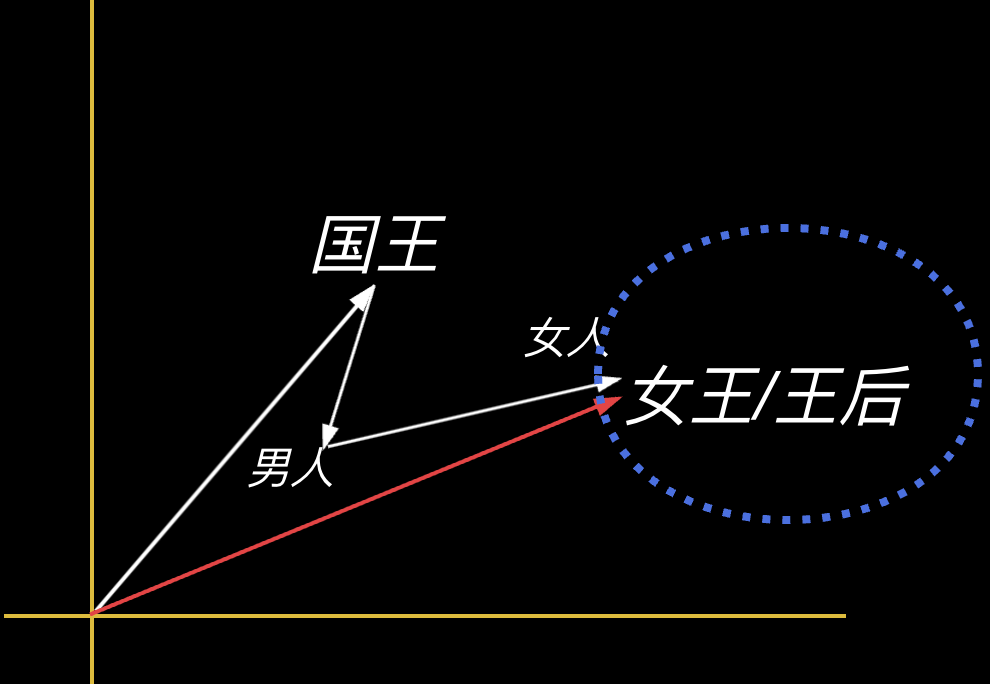
L:不过向量化说起来似乎很简单,不过实现起来,可不那么容易哦。「 18 如何完成向量化工作」
L:前面说了,我们需要把词语放到一个合适维度的坐标中,还要能正确的标注出每个词语在这个空间中的位置,神奇的事才能发生。但是怎么才能找到这些维度,怎么找到词语的空间位置呢,这就需要训练了。
具体如何训练,举例说明。我们预先准备一个多维坐标。准备10000个词,把这10000个词随便扔到坐标里,也就是随机产生每个词的向量,如下图所示。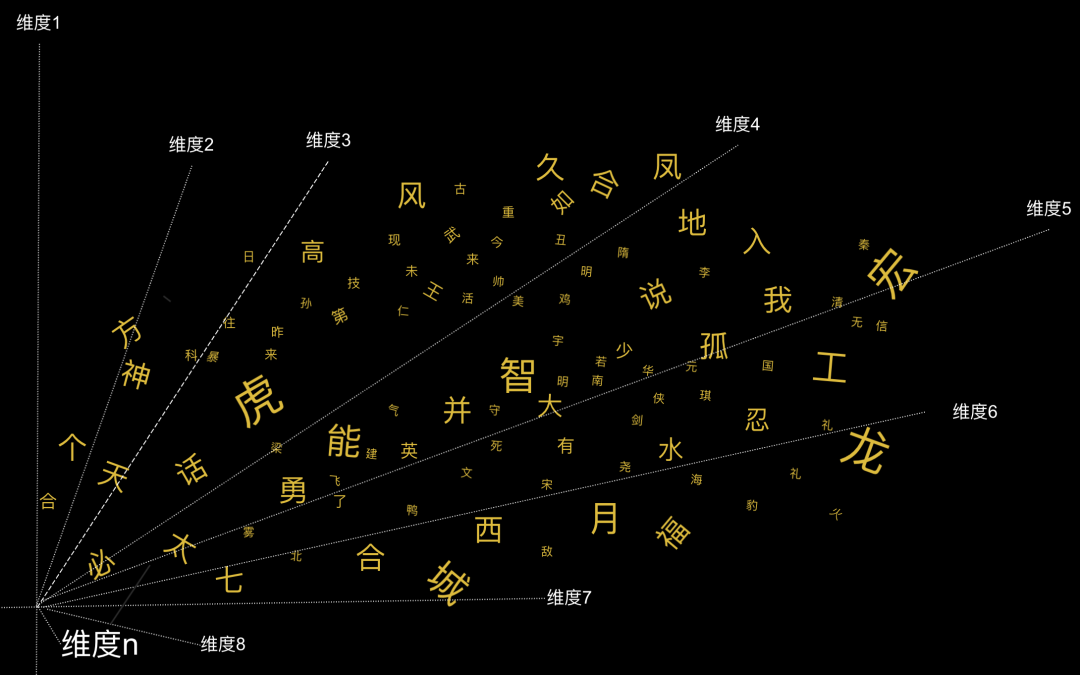
此时我们到语料库中取出语料,让机器玩词语接龙。比如《三国演义》的第一句,“话说天下大势,分久必合,合久必分。周末七国分争,并入于秦。”机器见到这句话后大喜过望,赶忙去自己的向量空间去找到第一个词“话“和第二个词”说“,把它们的向量拿过来一通计算,看看第二个词跟在第一个词背后的概率有多大,结果算出来概率很小,说明一开始随便放的位置不合适。
怎么办?那赶紧调整呗,经过不断尝试后最终调整好了词的位置。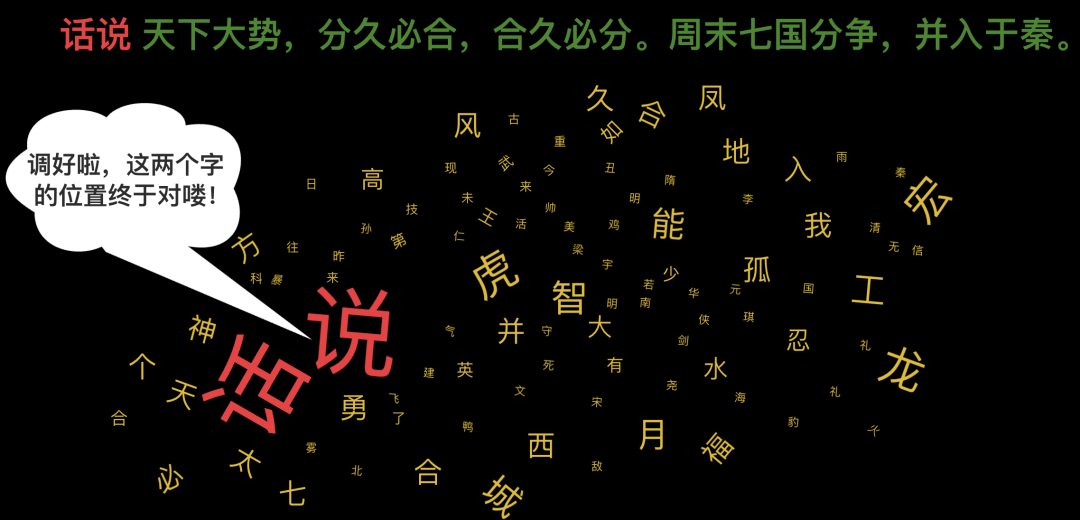
接着把第三个词“天”加进去继续训练,接着是第四个词“下”,第五个词“大”....就这样机器读完了三国、水浒、红楼梦、西游记....
在足够多的语料的训练下,这10000个词都被反复训练了无数次。终于,每个词都找到了自己在坐标里的正确位置。至此,词的向量化工作终于完成了。更多细节可参考OpenAI论文《Training language models to follow instructions with human feedback》。A爸:这下我是算搞明白了,原来是这样啊!
L:10年前Google就发布了著名的word2vec模型,详见《Efficient Estimation of Word Representations in Vector Space》。不过既然词向量已经帮机器理解每个词的意思,为什么大模型到今天才发展起来?
L:那是因为我们只干了第一步向量化,之前提到的第二步还没做。那就是信息压缩与特征提取。没有做特征提取,就相当于没有找到正确的规律,用错误的规律去训练电脑,最后电脑找到的词向量也就是错误的。A爸:换句话说,这些词其实并没有找到自己在向量空间中的正确位置。L:是的。
A爸:具体该如何进行信息压缩与特征提取?
L:精彩程度让人拍案叫绝!细节可参考Google论文《Attention Is All You Need》。时候不早了,咱们下回分解吧。
小朋友都能懂的人工智能(中)目录:
⓹大模型实现背后的惊人秘密 15-18
⓺注意力就是你所需要的一切 19-23 ✓
⓻无名故事与GPT-4训练流程 24-27
⓼无名故事与GPT-4推理流程 28-31
本集通过有趣的“猎人打熊”测试题引出transformer架构的注意力机制,并深入浅出的剖析其实现细节,最终让读者明白大语言模型是如何通过位置向量和词向量的巧妙结合,最终能做到彻底理解上下文,并实现了惊人的推理能力。「 19. 有趣的注意力测试」
L:上回我们说到让机器能理解语言的第一步是向量化。今天我们继续将讲述第二步——信息压缩与特征提取。在此之前,我先出一道题考考小朋友们。
探险队带着藏宝图,他们历经千辛万苦,终于在一个洞穴深处挖出了大量____? A. 地下水;B. 尸骨;C.金银珠宝。请问选哪个?A:选C,带着藏宝图肯定是找金银珠宝,而不是地下水和尸骨啊。
L:回答的很好!大家注意到没,如果没有最前面的探险队和藏宝图,则这三个答案都有其合理性,甚至在洞穴深处这样的背景下,地下水和尸骨似乎还更合适一些。接下来,我改编一下题目再考考小朋友们。
探险队在沙漠迷路了,他们历经千辛万苦,终于在一个洞穴深处挖出了大量____? A. 地下水;B. 尸骨;C.金银珠宝。请问选哪个?
B:选A,沙漠迷路了,水才是最重要的。
L:很棒!我们来看看,同样的问题来问ChatGPT4,它能答对吗?
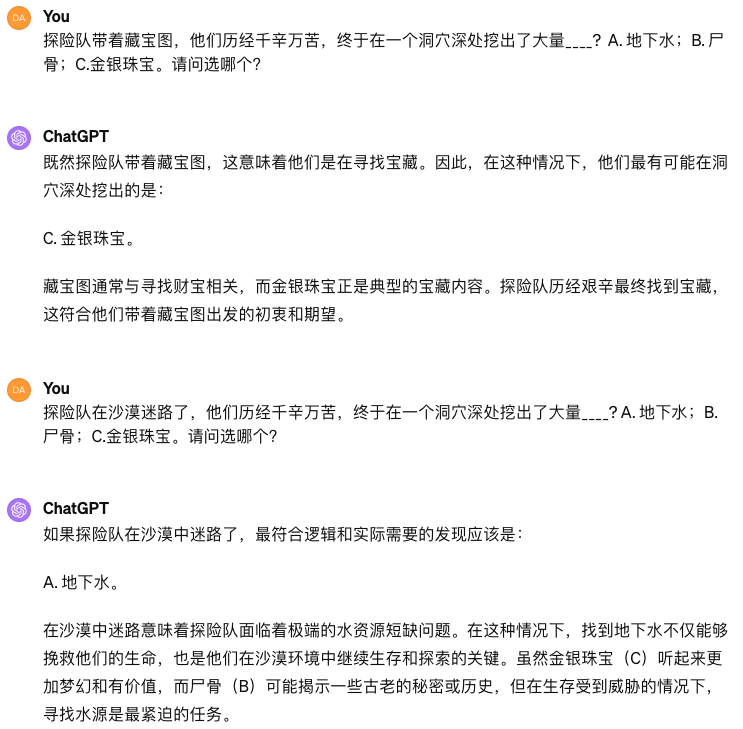
GPT-4的回答是正确的,厉害吧,思路也和两位小朋友差不多。A爸:厉害!看起来GPT-4似乎和我们人类一样有推理能力了。
L:准确的说法应该是它通过句子中的上下文,注意到了哪些词对回答起到更关键的作用,这种注意力,实现了更为厉害的信息压缩与特征提取。
A爸:哦,怎么说?
L:这个随后我再解释。
「 20. 注意力不足的R时代」
L:请问大家是否知道ChatGPT的GPT是什么意思?L:G表示Generative,即生成式;P表示Pre-trained,即预训练的;而这个T就是Transformer,合起来表示为生成式与训练的Transformer。L:这可是一个厉害的语言模型架构,正是这种架构助力GPT-4迅速而有准确的回答了前面的问题。在Transformer架构被提出之前,语言模型的主流架构主要是循环神经网络Recurrent Neural Network,简称RNN。RNN按顺序逐字处理,每一步的输出取决于先前的隐藏状态和当前的输入,要等上一个步骤完成后才能进行当前计算,这种模式似乎比较符合人类阅读的习惯,不过却存在明显的不足。L:首先是这种串行模式显然无法并行计算,因为一并行,顺序就无法保障了。这样无法发挥硬件资源多优势,导致训练效率极低。L:由于RNN的架构特点,词之间的距离越远,前面对后面的影响就越弱,难以有效捕获到长距离的语义关系,导致RNN及不擅长处理长序列,即长文本。在人类自然语言中,依赖信息较远时很常见的情况。比如之前提到的那句话“探险队带着藏宝图,他们历经千辛万苦,终于在一个洞穴深处挖出了大量____”,正确预测下一个词的关键词是距离很远的藏宝图。使用RNN就可能把前面给忘没了,只剩下“终于在一个洞穴深处挖出了大量____”,如此一来,距离很近的“洞穴”当成了预测的关键词,自然无法得到正确的答案。L:有的,为了捕获长距离的依赖性,后来也出现了RNN的改良版本LSTM,即长短期记忆网络,但是处理非常长的序列时依然受限。此外无论是RNN还是改良版LSTM,都依然无法实现并行计算,效率提不上。看来RNN架构的这个R时代走向穷途末路了。A爸:那您的意思就是Transformer架构能解决这些问题?L:是的,Transformer携带自注意力机制这个大杀器,踏着七彩祥云出现了,带我们走进了T时代。
「 21. 注意力即一切的T时代」
L:Transformer架构有能力学习输入序列里所有词的相关性和上下文,不会受到短时记忆的影响。做到这点的关键在于Transformer的自注意力机制。也就是之前A爸问我具体该如何进行信息压缩与特征提取时,我提到一篇论文,A爸还记得论文名吗?
A爸:叫《Attention Is All You Need》?
A:是的,记忆力不错!Attention Is All You Need翻译成中文,叫“注意力就是你所需要的一切”。简单来说,Transformer在处理每个词时,会注意这个词本身,以及它附近的词。论文中展示了这么一句简单的例子“The animal didn't cross the street because it was too tired”。这个词本身和附近的词的关系就如下图所示
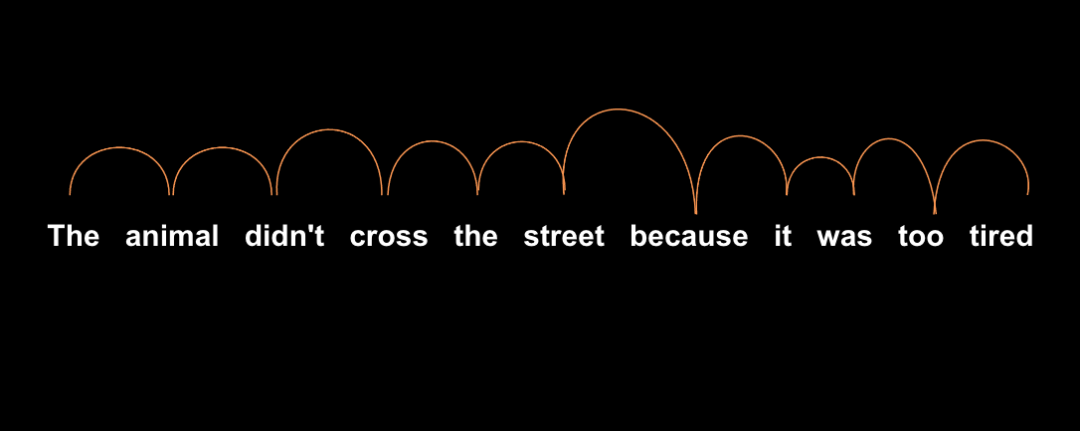
实际上,Transformer在处理每个词时,不仅仅是关注这个词本身和相邻的词,还做到让句子处理每个词时,还会去注意句中所有其他的词。A爸:L老师,我没听错吧,所有其他词,那分析语句时开销会很大吧。L:是的,A爸对性能很敏感。比如还是针对这句简单语句,这样会形成非常错综复杂的连接,如下图所示。
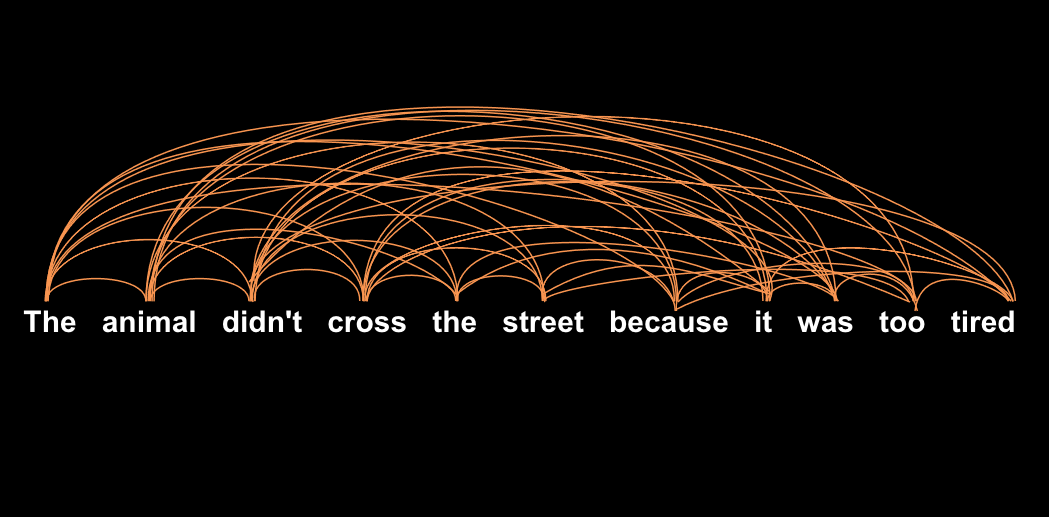
A爸:哇,看的头都大了,如果是给GPT-4很长的文字,那分析量岂不是非常大。L:是的,好在现在硬件的性能不断提升,算法也在优化之中。这里需要注意一点,在进行文本分析时,GPT-4对每个词会分配不一样的注意力权重。L:权重是模型在训练过程中通过大量文本逐渐学会的。因此Transformer有能力知道当前这个词和其他词之前的相关性有多强,然后去专注于输入里真正重要的部分,即使两个词的位置隔的很远,Transformer依然可以捕获到它们之间的依赖关系。还是这句The animal didn't cross the street because it was too tired 。这里it 可以指的是离更近的“street”,也可以是离得更远的“animal”,但是自注意力机制捕获到了it 和animal之间更强的关系,因此更集中在animal上。
A爸:好比GPT-4捕获到了到藏宝图一词与金银珠宝之间更强的关系;捕获到了沙漠、迷路等词与地下水之前更强的关系一样。L:是的A爸。现在我可以跟你解释一下,这种注意力机制为啥可以实现更为厉害的信息压缩与特征提取。传统算法在提取特征的时候,想的都是自己,都是一些很局部的信息,比如图像处理的卷积都是一个个窗口,RNN递归网络我们是一个个词,这些其实都是小的单独的个体,很难有一些全局特征。比如说窗口和窗口之间的关系,词跟词之间的关系。而Transformer架构因为其注意力机制,从局部与局部,局部与整体的关联关系中,提取到了全局向量和全局信息。「 22. T时代位置编码的巧妙创新」
L:大家应该都注意到,语言中每个词的顺序极为重要,即使句子里包含的字都是一样的,顺序不一样,也能导致意思完全不一样。比如“小处不可随便“和”不可随处小便“。差异大不大?
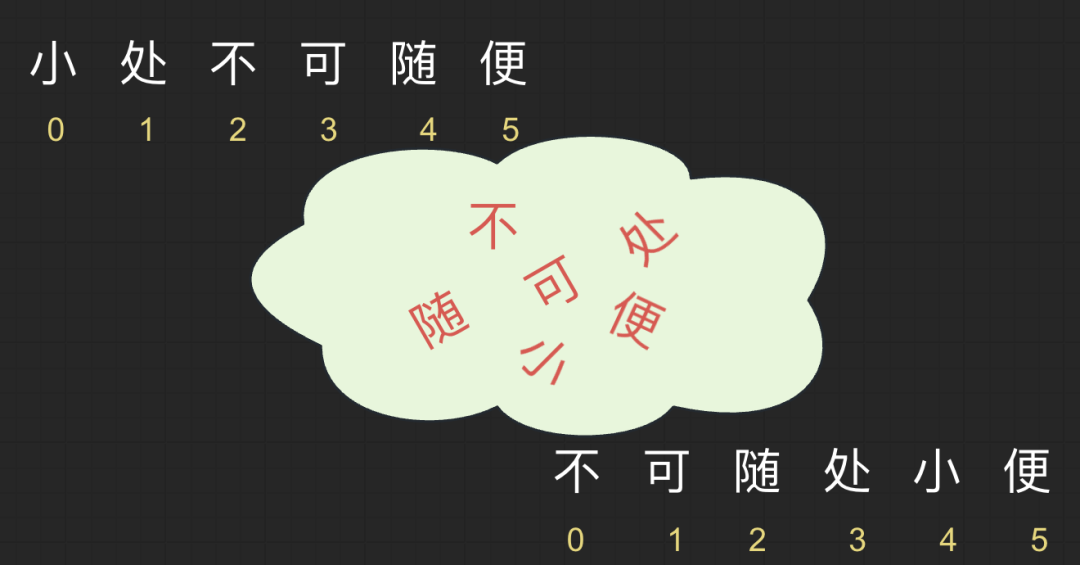
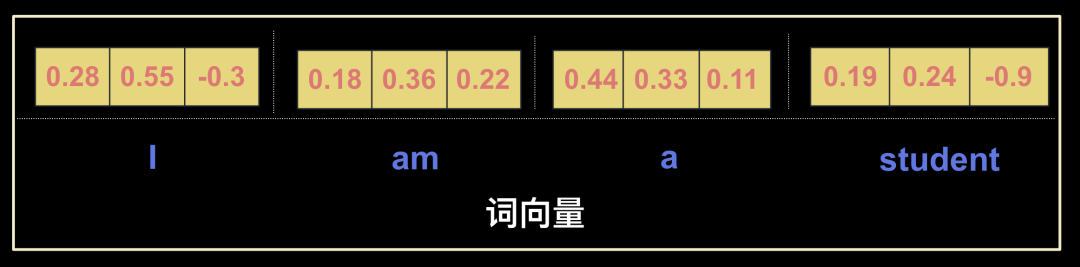
L:正因为语言必须严格保障每个词的顺序,所以之前的语言处理模型都是RNN模型,一种有序的递归网络架构。不过,前面也提到了,这种方式因为只能串行,无法同时学习所有信息,造成了训练速度的瓶颈。到底有没有什么更好的解决方案,来摆脱这种困境呢?L:大家想想看,一个句子形成时,每个词在句子中的位置已经固定了,把每个词的位置都编码记录下来后,是不是妈妈再也不用担心我的词语顺序呢?A:哦,对啊!这样这些词就可以同时交给多台机器并行处理了。L:是的,这就是Transformer的另一项关键创新,叫位置编码。即记录每个词在句子中的位置,用来确保词在句子中的顺序的正确性。借助位置编码,词可以不按顺序输入给Transformer,模型可以同时处理输入序列里的所有位置。而不需要像RNN那样以此处理。L:别忘了,每个词本身的含义是有局部性的,可以在一定程度上脱离顺序哦。L:说起来也简单,大家知道词在输入给神经网络前首先会先进行向量化处理,转换成一串数字。而位置编码则是把每个词在句子中的位置也一串数字表示,添加到输入序列的表示中,然后把这个结果给神经网络。以I am a student为例。为简化仅设3个维度,假定词向量为 I [0.28,0.55,-0.3],am [0.18,0.36,0.22],a [0.44,0.33,0.11],student [0.19,0.24,-0.9]。
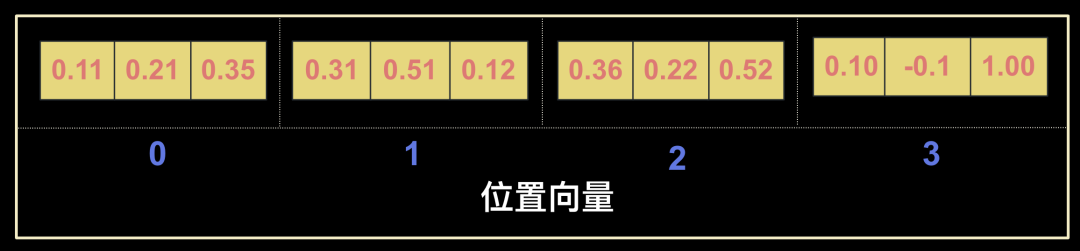
接下来是位置向量化,假定依此为[0.11,0.21,0.35]、[0.31,0.51,0.12]、[0.36,0.22,0.52]、[0.10,-0.1,1.00]。
接下来,就是要得出包含位置信息的(I) (am) (a ) (student)了。这里简化为向量相加给大家示范,如0.28+0.11=0.39,0.55+0.21=0.76,-0.3+0.35=0.05。于是(I)的向量化值就出来了,即[0.39,0.76,0.05]。同理得出(am) [0.49,0.87,0.34],(a)[0.80,0.55,0.63],(student) [0.29,0.14,0.1]。
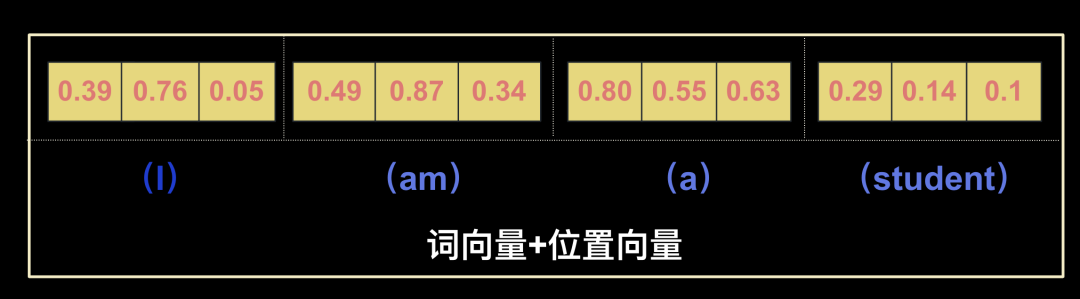
整体的过程如下图所示。
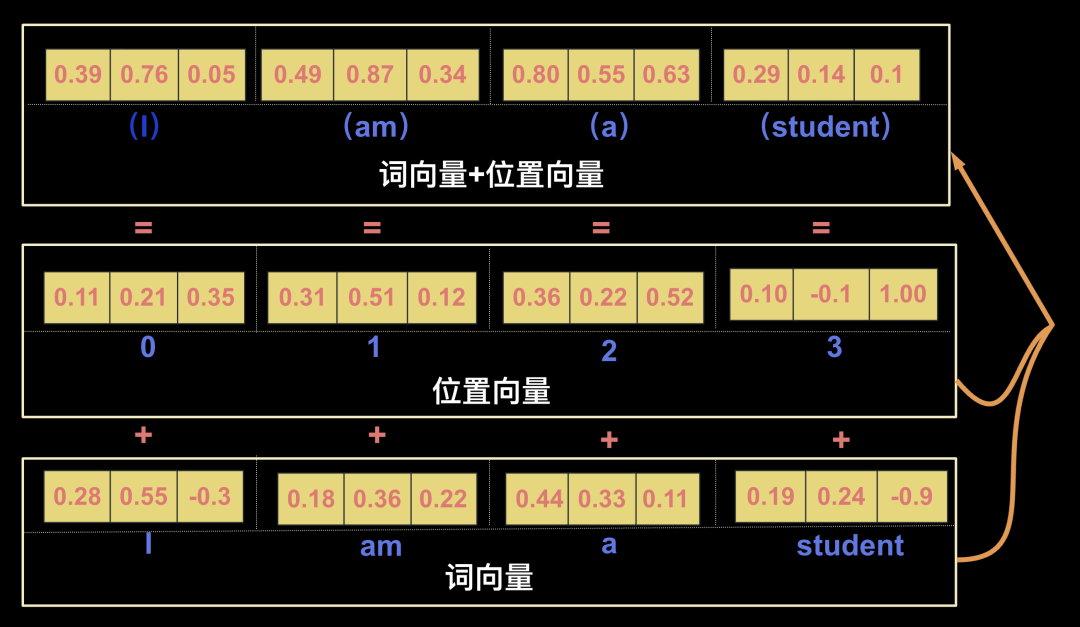
换句话说,就是 Transformer通过将I am a student 转成(I) (am) (a ) (student ),实现了词向量与位置向量的融合,使句子具备了并行处理能力。A爸:这个(I) (am) (a ) (student )好巧妙啊!L:是的,现在Transformer既可以理解每个词的意义,又能够捕获词在句子中的位置来理解不同词之间的顺序关系。在计算时每个输出还可以独立地计算。不需要等待其他位置的计算结果。这大大提高了训练速度。正是这种提速让训练大模型成为了可能。「 23. 从注意力到推理能力」
L:Transformer问世后即一统天下,将大语言模型技术推向了令人瞠目结舌的高度。大家回顾一下先前的两道测试题,其实对GPT-4就是小菜一碟。
A:哦,那来一道更难的吧。
L:好,这题爸爸妈妈们可以一起做,10秒思考时间,大家愿意挑战吗?
众人都很自信,跃跃欲试。
L:话说有一位猎人,他向南走了100米,向东走了100米,再向北走了100米,回到了原地,这时他看到了一头熊,然后开枪打死了这头熊,请问这头熊是什么颜色的? 10秒很快过去了,大家一时想不出答案。
L:答案是白色。
为啥....让我们来考考GPT-4,看看它是如何回答的。GPT-4是这么想的,从走回原点推断出是北极,再从北极推断出北极熊,最后从北极熊推断毛发是白色的。怎么样,GPT-4的推理能力如何?面对GPT-4如此清晰的推理,众人简直惊掉了下巴,一时说不出话来。L:熊颜色的测试来自一篇名为《Sparks of Artificial General Intelligence: Early experiments with GPT-4》的论文,该论文还有其他测试,涵盖了多模态和跨学科组合、根据变态要求写代码、使用工具与世界互动、理解人类心智等方面。该论文的最终结论是,GPT-4可以被看作是通用人工智能的早期版本。L:GPT-4的复杂度和网络规模比AlphaGo要大很多,两者间差了四到五个数量级。当一句话传过中间的Transformer层时,在多种不同视角下,每个无数的神经元被一层层的激活,一边注入大量的信息,一边对这些信息进行筛选权衡,然后一层又一层的反复这个过程,最终实现了对这段话的透彻理解了。
A爸:听起来好厉害啊。
L:接下来我会说说GPT-4完整工作流程与原理,也会给大家展示其更加不可思议的能力。时间不早了,我们下回分解。
小朋友都能懂的人工智能(中)目录:
⓹大模型实现背后的惊人秘密 15-18
⓺注意力就是你所需要的一切 19-23
⓻无名故事与GPT-4训练流程 24-27 ✓
⓼无名故事与GPT-4推理流程 28-31
老智看中了只识0和1的无名,让其戴上神奇的眼镜并开始学习海量书籍,最终无名深刻的理解了语言,这个海量书籍的学习就是海量数据的收集与分析,对应了大模型训练的“数据收集与处理过程”;接下来老智通过Transformer头盔,让无名其理解了苹果在句子中到底是品牌还是水果,这个头盔就是模型,对应了大模型训练的模型训练与初始化。最后是是大模型训练的“模型训练微调迭代阶段”,这个阶段最后趣,想知道无名是如何通过书中猜字游戏完成自我训练,又是如何在确保自己拥有广博知识的同时,又能有着高尚的品质呢?「 24. AI发展之忧」
L:刚听说各位对AI的飞速发展很是担忧,应该是GPT-4推理出北极熊的能力过于惊艳,把大伙儿给吓到了。这样吧,大家说说自己都担忧什么?
A:L老师,AI这么聪明,什么事不懂就问它,什么事都让它帮你做,那我们还需要学习吗?
A爸:L老师,AI会不会抢了人类的饭碗,让大部分人陷入失业危机?
C妈:L老师,我比较胆小,您说AI会不会产生意识,进而消灭人类?......
L:小A同学,假设真的不用学习,那可以天天玩了,你是该担忧还是开心呢?
小A笑出了声来。
L:A爸,假设AI把生产效率提升了成百上千倍,让人不用工作都可以做到衣食无忧,大家从此不再为生计发愁,可以天天做自己喜欢的事了。你是该担忧还是开心呢?
A爸也笑出了声来。
L:C妈的担忧听起来有些惊悚,AI到底会不会产生意识呢?我觉得我们还是需要对AI的工作机制有一个较为全面的认识,这样才更容易做出理性的判断。C妈你说是不是?
C妈:是啊。
L:前面已经初步介绍了GPT-4是如何理解语言的,接下我想对其训练和应用的全流程做一个简单的介绍,这样就能为全面认识AI打好基础。有了这个基础,后续各种深入的探讨就会更方面一些,比如AI是否会发展出意识等问题。
C妈:L老师,听说您出版的各类数据库书籍经常用故事来展示。您这么擅长讲故事,要不您用讲故事的形式给大家说说GPT-4训练和应用的全流程吧,这里小朋友这么多,肯定都是爱听故事的。
大家纷纷表示附和。
「 25. 无名1——数据收集与处理」
L:这.... 你们这是要难倒我啊。好吧,我试试吧,讲讲AI是如何训练的。
从前,有一个叫做大模型村的地方,住着一位孤苦伶仃还目不识丁的小伙子,他无法与人交流,只能靠捡垃圾和乞讨为生。因为没有人知道他叫什么,大家就管叫他无名。一些好心人想劝他读点书认些字以更好地生存。可是,无名根本听不懂对方在说什么。
一天,一位智者路过大模型村遇见了无名,感慨其骨骼惊奇千年一遇,当即决定留在大模型村,要将无名打造成一代宗师。这位智者不仅有拥有过人的才识,同时也拥有数之不尽的财富,我们就称其为老智。至此,无名命运的齿轮开始飞速转动。
无名的世界非常单纯,只认识0和1两个数字,其他数字或文字你教不会他,也没法教他。不过老智可不在乎这些,他在意的是无名惊人的记忆力和无穷的精力,认定他就是一位旷世奇才。就这样,老智开始了对无名的魔鬼训练,他首先斥巨资购进大量精挑细选的高质量书籍放进藏经阁,准备给无名学习。不过无名既看不懂文字也听不懂老智在说什么,怎么办?早有准备的老智将一款眼镜给无名戴上。这是非常神奇的高科技眼镜,戴上它就能将文字、语音进行分词处理与编码转换。啥叫分词,就是把整句话或者一段文本拆分成一个个单独的词或短语的过程。比如把“我爱吃苹果”分成“我”、“爱吃”、“苹果”这样单独的部分。这对理解和分析每个词的意思非常有帮助。那啥叫编码转化,就是在分词的基础上实现词向量化的过程。简单地说就是把文本中的每个字或词转换成特定一组0和1组合的数字,形成多维向量间。这里相关细节知识可参考本文的“17.向量化是理解语言的第一步”与“18.如何完成向量化工作”这两个小节。神奇的是,眼镜不仅可以将这些0和1的数字组合输入给无名,让无名能看见或者听见,同时还可以将数字组合转化成文字输出给外界,让别人看懂或听懂。就这样,老智的眼镜神奇地实现了语言文字和01数字组合的映射关系。这里相关细节知识可参考《AI爆发元年,小朋友也能读懂的人工智能(上) 》的“ 04.计算机眼中的世界”小节。
果然,戴上眼镜后,奇迹出现了,书中的文字在无名眼中全都转化成一串串他熟悉的0和1。虽说无名暂时还不理解这一串串数字组合意味着什么,不过熟悉感还是让他倍感亲切,露出久违的一笑。
无名开始坐下来静静地看着书,不一会儿他的眉头紧锁,似乎遇到什么困惑,一会儿又瞪大眼睛,似乎发现了什么规律。就这样他越看越起劲,再也停不下来了,开启了通宵学习模式。第二天,老智带着早餐来找无名,望着满屋子的书,随口来了一句:“不知道无名啥时可以读完这些书?”
“我已经读完了”。
哇,无名居然第一次开口说话了,而且挑不出啥语法毛病。老智激动过的老泪纵横。等等,老智忽然有些发懵,无名回答的是啥,读!完!了!老智才反应过来,有些难以置信地又问了一句:“这数千本书你都读完了?”。
“是的。”
这阅读速度也太快了吧,看来我马上就要培养出一代宗师了,想到这里老智激动地抱着无名又蹦又跳。
那无名究竟能否成为一代宗师,老智接下来又会有哪些出人意料的训练手段呢,咱们下回分解。
L:OK,在继续这个故事之前,我先总结一下,无名的这一集正是对应了大模型训练的第一阶段,即数据收集与预处理。包含数据的收集、数据的清洗及数据的预处理。具体如下,大家可以自行体会。
「 26. 无名2——模型设计与初始化」
L:不过,老智很快发现无名在回答问题时经常缺少常识,比如不知道麦克斯韦方程式是什么,不认识爱因斯坦,不知道什么是万有引力,不知道什么是基因....大家知道这是啥原因吗?
A:是不是给无名读的书很少有这方面的内容?
L:回答得很好!正是因为先前的书籍以小说为主,缺少自然科学,于是老智继续斥巨资,精挑细选的购进天文地理历史数学物理化学生物财经诗歌维基百科等书籍文献论文给无名阅读,效果还是不错的,无名开始变得越来越博学,也就很少再出现缺乏常识的情况了。
老智的书籍采购持续不断地进行着,随着阅读量的不断增加,无名对语言的理解越来越深刻了,比如他看到苹果这个词后,不仅知道苹果是一种水果,还知道这种水果的颜色、大小、形状、味道、营养价值、生长特征,产地、品种等。而且他能识别苹果和梨子在向量空间的位置非常接近,属于类型相近的东西。它甚至还知道许多和苹果有关的故事,比如牛顿、白雪公主、图灵、伊甸园....
不过老智却发现无名表面上看掌握了丰富的苹果信息,当问题中涉及到苹果和手机、电脑、公司等词一起出现,形成如苹果手机、苹果公司、苹果电脑等,无名就会搞不清是品牌还是水果,往往回答的牛头不对马嘴。
类似的情况越来越常见,比如问到“这书很深,不容易理解。”,“这块布颜色太深,做夏天衣服不合适。”等问题时,无名的回答往往无法区分这个深到底长度还是难易还是深浅,经常答非所问。
老智为了进一步验证无名的问题,放了一个大招,写下了这么一行话给无名阅读,“人要是行,干一行行一行,一行行行行行,行行行干哪行都行,要是不行,干一行不行一行,一行不行行行不行,行行不行,干哪行都不行。"。结果,无名看后两眼一黑,口吐白沫,一头栽倒在地上,把自己送进了医院。
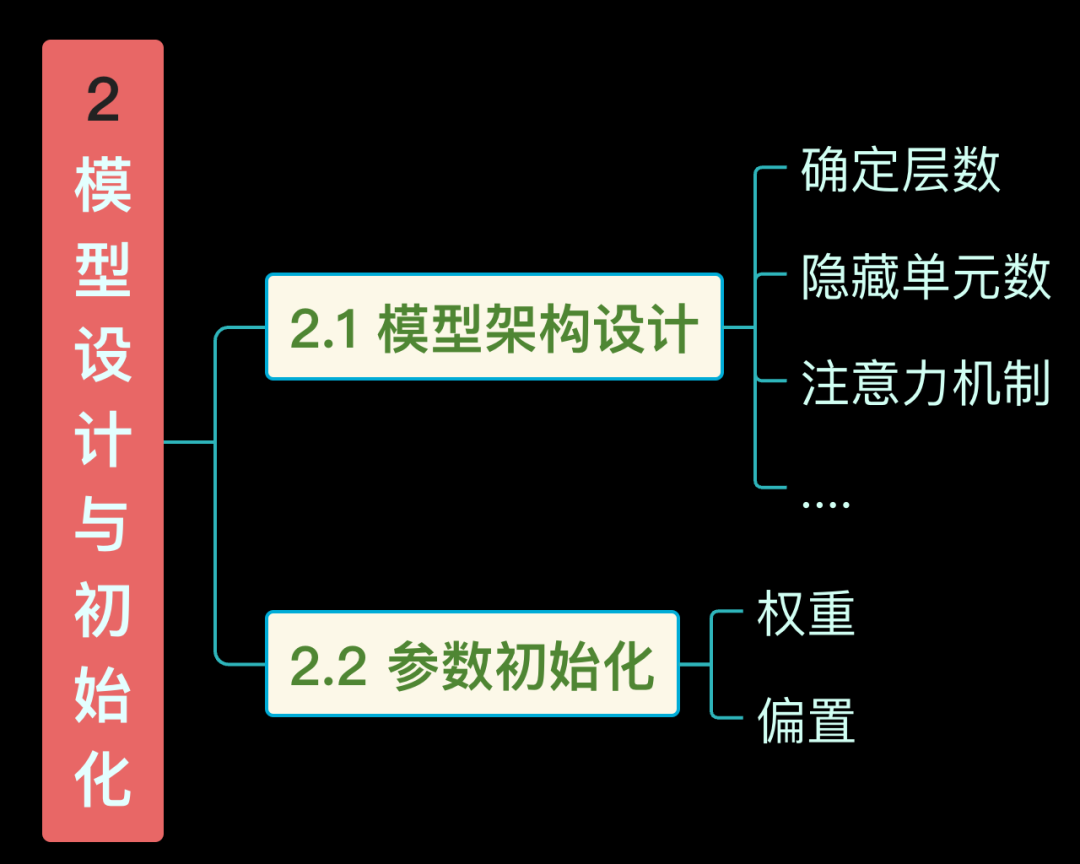
老智明白问题所在了,安顿好无名后便匆匆出门找他的好朋友老谷求救。老谷问明来意后便拿出了他祖传的镇宅之宝——Transformer头盔,交给了老智,并且语重心长地说了一句:Attention is all you need。接下来两位老兄弟在一起针对无名的特点对Transformer的头盔进行优化,探讨头盔内部设计多少层级合适,每个层级该设置多少个注意力头,参数该设置多少个....就这样,三天三夜后,一款针对无名的T头盔被量身定制出来了。当无名戴上这个T头盔后重新看书后,整个人都精神了,眼睛瞪得老大,看起来注意力比以前提升了100倍的样子。
无名确实发生了一个巨大的转变,当他阅读一句话时不再是仅关注被分词后的每个词的单读含义,还关注句子中相邻词之间的关系,词与句子中每个词之间的关系等,并对这些关系进行权重计算,从此变得对上下文非常的敏感。当他发现句中苹果和好吃、甜、梨等在一起时,会立刻注意到这些关键字,并分配了极高的注意力在这些词上,也就是权重,让自己瞬间便明白这是水果,当他发现句中苹果和公司、手机、电脑等在一起时,便瞬间明白了这是品牌。相关细节可参考本文“21. 注意力即一切的T时代”和“22.T时代位置编码的巧妙创新”这两小节内容。很快,无名就将之前所有的书籍文献论文都重新阅读一遍,只戴眼镜阅读和戴着眼镜又戴着头盔阅读效果真是不一样啊,接下来老智就把让无名口吐白沫的问题再问了一遍,大家觉得无名能搞定吗?
C:肯定可以啊,之前是多义词无法有效辨别。无名无法有效的利用好上下文,现在这个Transformer模型就擅长这个啊。
L:小C真棒,回答的很有水平啊!来,无名看看无名是如何回答的,请看截图。
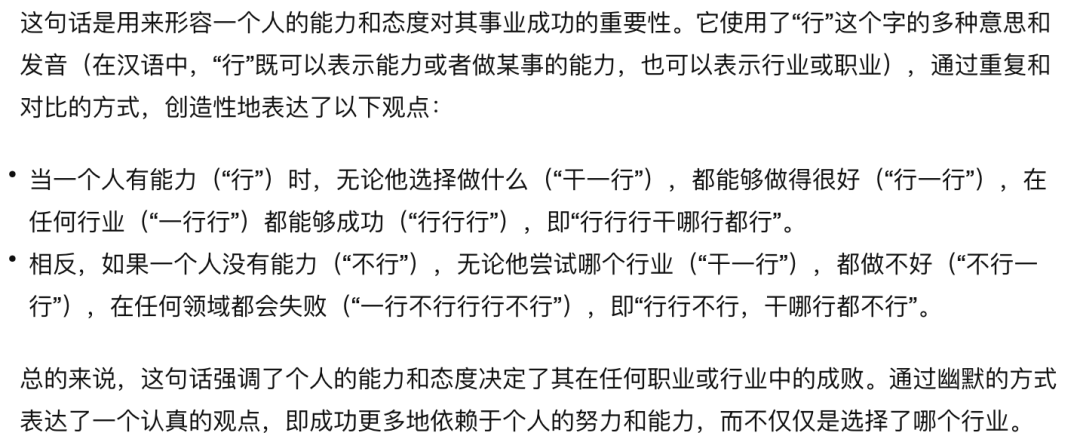 怎么样,厉害吧。L:无名真的就这么一帆风顺吗,在其训练中还会不会遇到新的麻烦,咱们下回分解。
L:OK,在继续下一个集之前,我先总结一下,无名的这一集正是对应了大模型训练的第二阶段,即模型设计与初始化。包括模型架构设计和参数初始化两部分,其中模型架构设计就是基于Transformer的多层神经网络架构,而参数初始化就是决定训练数据的规模。具体如下图所示:
「 27. 无名3——模型训练微调迭代」
L:无名通过自己埋头读书就可以飞速进步,实现了无师自通,可以说是一件很了不起的事啊,你看老智除了给个眼镜再给个头盔,也没见他操多少心啊,这到底是怎么做到啊?
A爸:L老师,词向量化实现了词的编码与语义识别,相当于认字了。Transformer实现了对词对上下文的识别,相当于能深刻理解句子了。这样无师自通不是很正常啊,让人来教不是也没法教啊,你跟无名或机器说话,他也听不懂啊。
L:词向量化认字,Transformer模型理解句子,A爸说得精炼且有水平,给A爸点赞。不过事实上可不是那么简单,无名的理解是需要一个反馈的,训练是一个不断逼近正确答案的过程,好比下围棋就很清晰明了,布局下在一二线地方老输棋,而下在三四线的地方就能赢棋,自然最后就会淘汰布局一二线的下法而选择了正确的三四线,这样围棋就可以实现无师自通。相关细节可参考《AI爆发元年,小朋友也能读懂的人工智能(上) 》。可学习语言就不一样了,无名怎么知道自己对句子的理解是否无误,自己的回复是否正确?大家觉得这有标准答案吗?A爸:围棋、游戏竞技都有胜负,能赢就是对的。包括数理化学科知识也是如此,解出来就是对的,所以AI在这些领域现在都特别厉害。咱们语言的理解和语言的回复,似乎怎么回答都是可以的,并没有一个绝对的标准啊。
L:但是,没标准也必须要建立标准,否则训练就变成无头苍蝇了。那怎么建呢?话说这个无名还真是天纵之才,还真被他想到办法了。他可以把书中的文字直接就当成了标准答案来训练自己。给自己玩猜字游戏。比如:老王推开门,发现乌云密布,于是回到屋里拿了什么?这里有两个字被无名给遮盖住了。会是什么字呢,无名想了半天,于是填入了"菜刀"两字。L:是的,当被无数次啪啪打脸后,无名最终填入了"雨伞"两字,回答正确!得到了多巴胺奖励,乐开了怀。L:是的,除了完形填空,还有句子续写,比如把前半段读完,把后半段遮起来,往下写,看看和正文的相似度有多高,相似度越高就越接近标准答案。就这样,无名把同一本书读了无数遍后,再用各种遮盖的方式做了无数遍的完形填空和句子续写,最后对文字和句子的理解就越来越深刻。随着阅读的书籍文献越来越多,最终就实现了对语言理解的飞跃。A爸:L老师,我有一个疑问,您刚才说填入“雨伞”两字,得到了奖励。说明书中是雨伞两字。可是如果填入“雨衣”,似乎也是对的啊。L:说得非常好,假设书中原文是“雨伞”,而无名填写的是“雨衣”,其实也有可能是对的,因为在无名的世界里,雨伞和雨衣的向量空间位置是非常接近的,所以用雨衣其实也是会形成一个通顺的句子的。比如雨伞正确的概率是99%,而雨衣正确的概率是98%,无名有时也会选择雨衣。因为他认为当概率超过某个标准的时候,基本都不太会出错了,所以选择更低的概率能够展示语言的多样性。L:比如你正确的回答了我一个问题,我答复“正确”,“很好”,“不错”,“你真棒” 其实意思都差不多,基本上怎么说都不会错,于是无名就选择随机来回复,就不会每次都说“正确”了,这也符合我们人类说话的特点啊。A爸:这真是太有意思了。另外您说的续写其实也差不多,只要整句话的向量空间和原来的大体不差,就算和原文被遮挡部分一致,是吗?A爸:我还有一个疑问,为啥会有同一本书无名读无数遍的情况,无名不是有超级记忆力吗,记一次不就记住了吗?另外自己遮盖住做完形填空和续写也很奇怪,只要之前读过了,不是都记住了,那还能考自己吗?L:这个问题问得非常好!其实无名记忆力超群又什么都记不住,他存储下来的只有参数,而他反复读无数遍就是不断的调整自己的参数,各种遮挡和续写也是为了让自己的参数越来越优化。你们想起来之前说过的李白的静夜思不是背出来的,是创造出来的吗?这里相关细节知识可参考本文的“15.神奇参数替代了海量数据”这小节的内容。L:无名的故事还在继续。有一天,老智忽然发现了麻烦事,无名回答政治性相关的问题有些口无遮挡,比如随意评论国家领导人,话语中带有种族歧视等,甚至可以和人谈笑风生地探讨如何毁灭人类。这可把老智惊出了一身冷汗。虽说老智对购入的书籍资料已经是精挑细选了,但是这毕竟无法确保万无一失。现在无名已成这样了,该怎么办?好在老智富甲一方,他想到了一个好办法,雇佣了成千上万个有道德有素养的人,形成评委团来共同调教无名。无名同时与这些评委们进行交流问答,评委们对无名的回答进行打分,符合人类道德规范的回答给予高分,反之则低分。聪明的无名通过这些分数,很快就明白了哪些话该说,哪些话不该说.....
虽然取得了不错的效果,却还不够完美。因为每个调教无名的评委能力喜好各不相同,难免会有偏差。而且也还会存在一些失误,比如把本该打低分的回答打成了高分,把本该打成高分的回答打成了低分,从而误导了无名。那该怎么办?老智简直就是一个天才,这不,又被他想出好主意了。他将无名的头盔做了改造,重新戴上后,无名忽然具有了一心二用的能力。一个还是原来的无名,我们姑且称之为学习者无名。另一个则是训练出来专门打分的无名,我们称之为打分者无名。其中打分者无名主要学习的是各种道德准则的相关内容,担任的是评委的角色。
由于无名有着超乎常人的记忆力和精力,一心二用后两个角色的能力依然了得。这种左右手互搏模式,取得了非常不错的效果,这种模式和之前的评委团模式共同作用,让无名再次脱胎换骨。这下妈妈再也不用担心无名的口无遮拦了。C妈:精彩,这个老智真厉害啊,左右手互搏都能想出来。
L:是的,至此无名神功练成,江湖即将掀起巨大的波澜,要知后事如何,且听下回分解。L:时候不早了,无名的故事今天就说到这里。我先总结一下,无名的这一集是对应了大模型训练的第三阶段,即模型的训练微调迭代。包含了模型训练迭代和参数微调迭代两方面,其中损失函数就是表示训练与标准答案之间的差距,而反向传播则是传递这种差异,通过调整参数进行不断优化反复迭代。具体如下图所示:至此,我通过无名的故事把大模型的训练流程给大体说完了,整体流程就三步如下图所示,是的,这正是GPT-4的训练全流程。
接下来无名就要看看神功练成的无名大侠,是如何走出大模型村,在其运行推理征途中,实现君临天下,大杀四方的,咱们下回分解。
小朋友都能懂的人工智能(中)目录:
⓹大模型实现背后的惊人秘密 15-18
⓺注意力就是你所需要的一切 19-23
⓻无名故事与GPT-4训练流程 24-27
⓼无名故事与GPT-4推理流程 28-31 ✓
本集通过无名挑战AI盟主这一跌宕起伏的故事,向大家揭示了机器翻译是如何自然而然就实现了、逆天推理能力是如何基于高维空间轻松打造、深度分析能力是如何依据多头注意力机制巧妙创造、大模型的记忆方式和人类是否一致......让大家在有趣的剧情中,轻松全面地了解AI的关键技术及原理。此外,本集设计了一些动图,会有助于读者理解流程原理,敬请期待。「 28. 万法自然」
L:话说无名神功练成,老智喜出望外,于是带上无名走出了大模型村,来到了一个被称之为龟谷的地方,目的是要拿到AI盟主的令牌号令天下。据说自令牌设立以来已有十余年,期间有无数的英雄好汉前来挑战,愣是没人成功过。不过老智可是信心满满,觉得此次AI盟主之位必是无名无疑了。
龟谷蜿蜒曲折,一只老龟驮着二人来到了一座大宫殿前。老龟用头顶开门,挑战开始了。眼前映出一道题目,第一关来了!老智定睛一看,请将下面这一段中文翻译成英文"在生命的果园里,每一个选择都像是摘下的一颗苹果,我们无法预知它的味道,但正是这未知赋予了生活无限的可能”。啥,考翻译,瞬间回忆涌上心头,触及了老智最不愿回首的往事。当年,老智曾经带领团队从事过机器翻译的工作。当时的想法是机器翻译这活儿简单啊,“来是COME,去是GO,点头YES,摇头NO......”,就这么把中文和英文一一对应好,然后教会机器不就完事了。
A:是啊,我也觉得挺简单的。
L:实际上,中文和英文之间的语言习惯及语法等差的很远,就比如一个“打”字,中文可以有无数种组合,比如打水,打电话,打赏,打起精神,打心眼里,打那以后......,而在英文里似乎就只有一个beat,可恨的是好不容易找到的这个beat,居然还对不上,总不能beat water吧。是的,老智耗尽数年精力的机器翻译项目没有取得满意的成果,便草草收场了。想到这里,老智摇摇头,以前专门的团队训练了数年都失败了,如今压根儿就没训练过无名,咱就别指望了,回去吧。老智回头望向无名,刚要张口,只听清晰的话音传来,“恭喜您通过本关!”。啥,无名已经翻译好了,还过关了?
老智回头一看无名的翻译“In the orchard of life, each choice is like picking an apple; its taste remains unknown until we try it, yet it's this very uncertainty that endows our lives with endless possibilities.“。整句话既匹配英语的表达习惯,还保持了语言的流畅性,同时也保持了原意的深刻性,完全不像当初他做项目时翻译的那么生硬,老智惊讶的合不拢嘴,他除了有给无名大量的中英文书籍学习外,并没特别教无名翻译啊,为啥就具备了如此逆天的翻译能力呢?
A爸:我们国人是先学中文,然后对照着中文的模式去学英文。而无名似乎是一开始就同时阅读中文和英文书籍,并没有这个对照的过程,会不会和这个有关。
L:是的,A爸说到点子上了。在无名的世界里,中文和英文都是一串串0和1的数字编码组合,没有本质区别的。在中文书籍里发现的词语规律,在英文书籍中是一样存在的,所以无名其实根本就没有在学翻译,而是他本来就会翻译。
C妈:本来就会?
L:是的,无名对字词的理解能力怎么衡量,其实就是字词向量化后维度的多样性和维度值的准确性。为什么能回答出一连串看似合理的句子,那是因为组成句子的每个词的向量是可计算的,通过各种计算,发现连在一起的概率大,就连在了一起。而这样的逻辑,中文和英文是没有任何区别的。
举一个最简单的例子,比如句中的苹果能被翻译成apple,这是为什么?因为无名觉得,其实苹果和apple的向量空间非常接近,它们就是同一个东西。差异只不过一个是从海量中文书籍中学来的知识,一个是从海量英文书籍中学来的知识。C妈:原来如此啊,不过不同翻译家由于风格不同,有时差异也挺大的啊,机器翻译时每次都是固定的输出吗?
L:C妈问的非常好,词有词向量,既然向量可以计算,那句就有句向量,词计算的汇集就是句向量最终的值,所以翻译最后会用这句中文的句向量和翻译好的英文的句向量进行比较,这种计算的结果能大致匹配,就表示翻译正确,可以输出了。大家还记得我说过的语言的多样性吗。“正确”,“很好”,“不错”,“你真棒” 意思差不多,扩展到句子也是如此,比如“我觉得你是班上数学学最好的小朋友”。和“我认为班上没有哪个小朋友的数学比你更好。” 这两句的向量值是非常接近的。
A爸:有意思,耗费大量人力和时间成本没能解决的机器翻译难题,居然被不学翻译的GPT-4给解决了。我们的外语学习是不是也可以借鉴GPT-4模式。
「 29. 升维思考」
L:是的,A爸说的非常有道理,如何借鉴是另外一个大话题,咱们就不讨论了。在无名通过第一关后,第二道门自动打开,一道题目映入眼帘。“话说有一位猎人,他向南走了100米,向东走了100米,再向北走了100米,回到了原地,这时他看到了一头熊,然后开枪打死了这头熊,请问这头熊是什么颜色的? ”
孩子们:白色白色。
L:这在前面小节中讲过,看来孩子们都还记得。OK,我们继续往下说。老智还没把题目读完,无名就已经提交答案,白色。伴随着清晰的“恭喜您通过本关!”传来,无名再次取得了成功。
C:无名好厉害!
L:是的。关于推理过程之前已经介绍过了,也贴出了GPT-4的回答。这里我们用一种更本质的方式来给大家讲无名推理的过程。
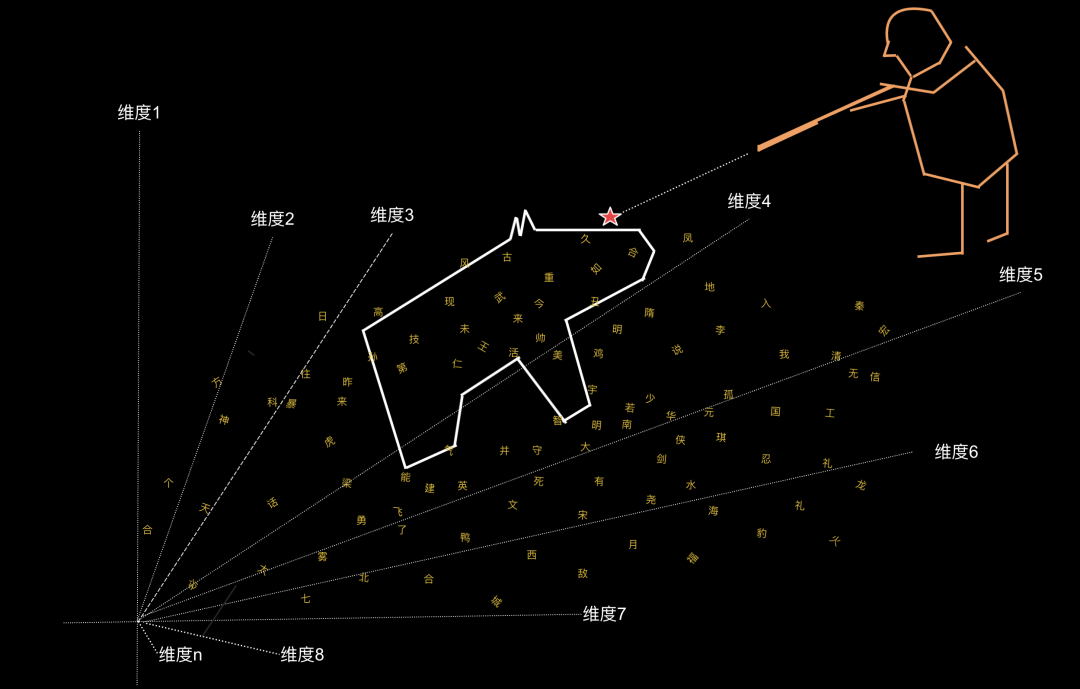
无名在听到题目后,立即在一个巨大的向量空间里开始了他的推演过程,如下图所示。他先找到题目中的每一个词在向量空间的位置,通过词与词之间的连接与计算,最后发现了指向答案的空间概率最大的词,就是白色。于是找到了答案。接下来会详细的用空间向量来解释这个过程。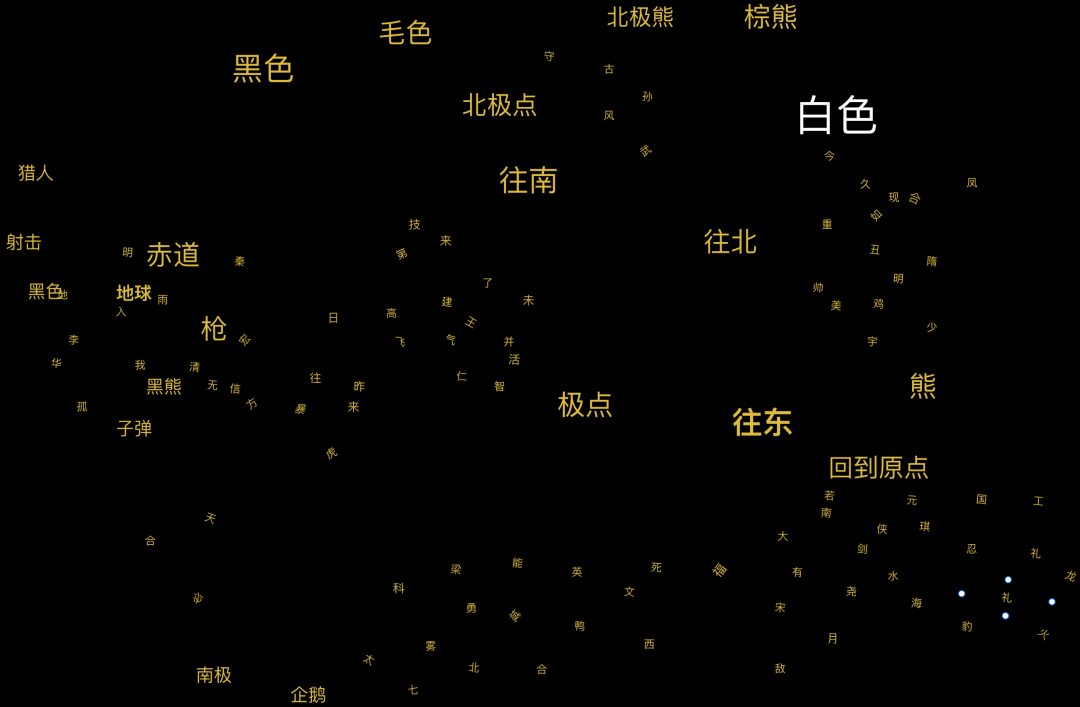
一开始的往南,往东,再往北的三个方向以及回到了原点(这里用三条白色的连线来表示)。空间向量关系如下图所示。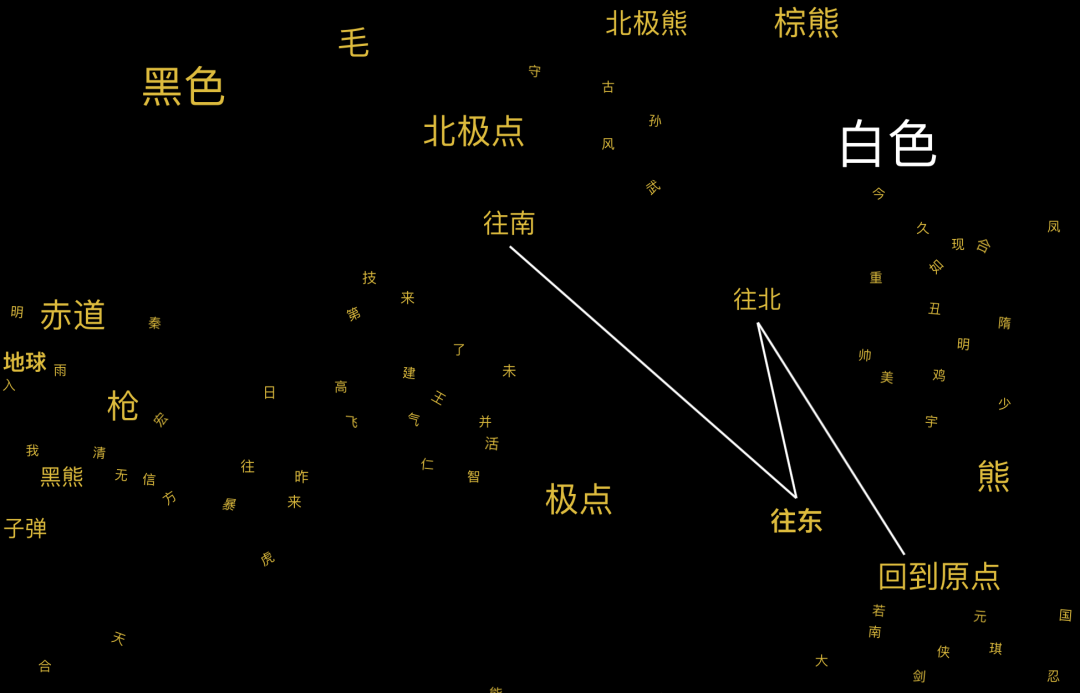
在往南,往东,往北,回到原点这四个词向量共同作用,通过自注意力加权后,大家共同指向附近概率最大的词就是极点(这里用四条红色的连线表示),空间向量关系如下图所示。而极点加上熊(这里用一条深绿色的线表示)后,在极点和熊共同作用下(南极不会有熊),会指向空间概率最大的北极点(这里用两条浅蓝色的线来表示)。空间向量关系如下图所示。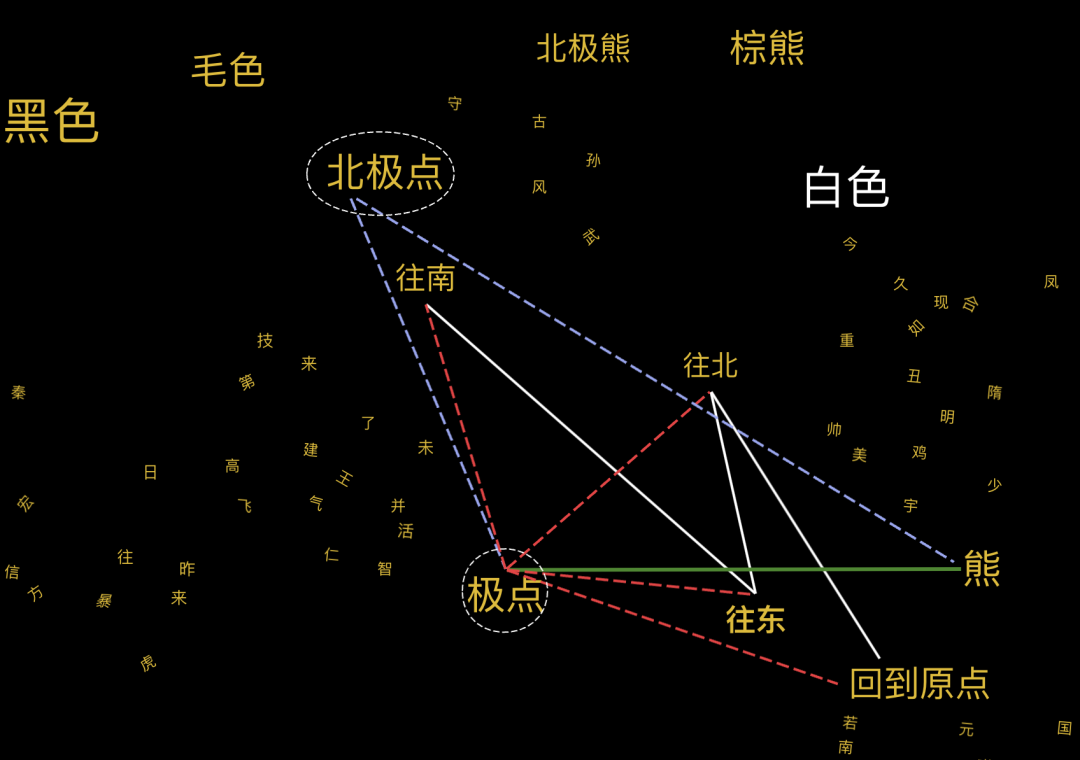
而北极点和熊共同作用下,会指向空间概率最大的北极熊(这里用两条深蓝色的线来表示)。空间向量关系如下图所示。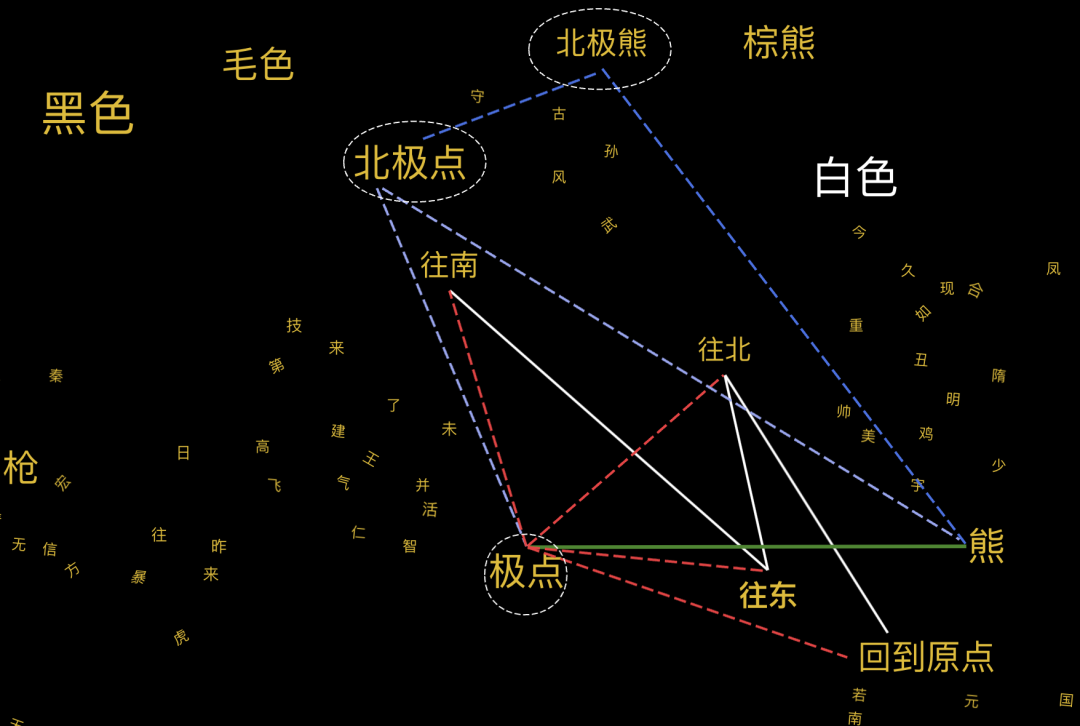
而北极熊加上毛色(这里用一条棕色的连线表示)以后,在北极熊和毛色的共同作用下(这里用两条浅绿色的连线来表示),最后指向了白色。空间向量关系如下图所示。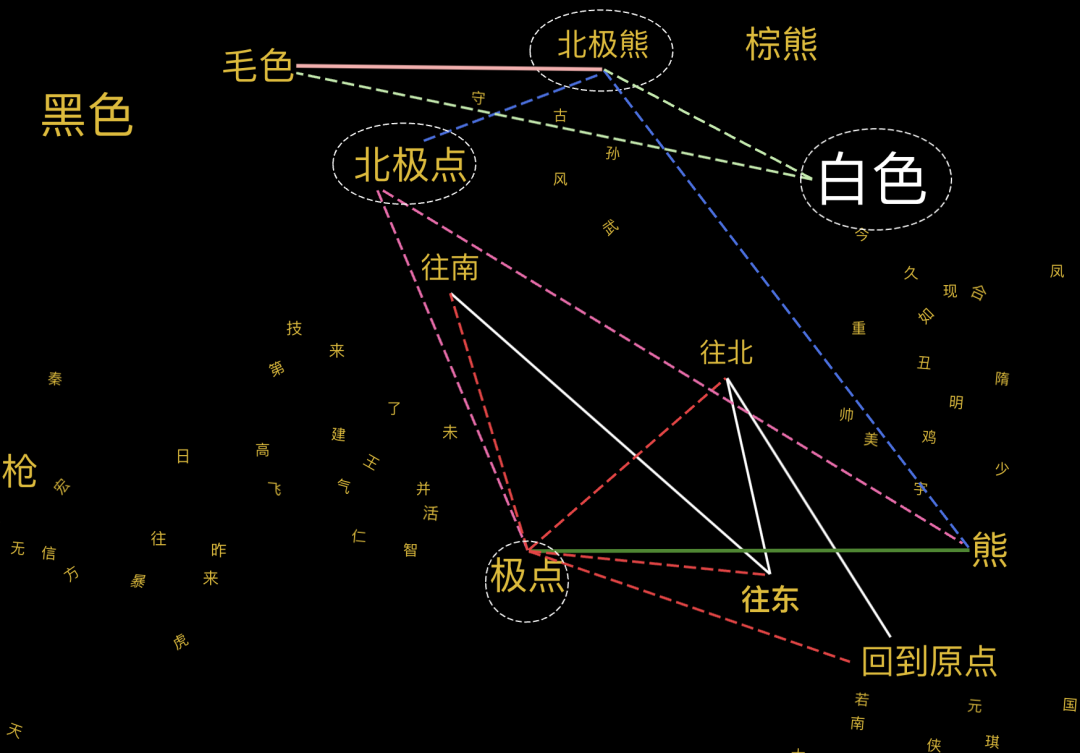
是的,答案就是这样出来了,整体完整动态效果图如下所示:A爸:L老师,这次用向量空间来描述,让我们算有了一个更为直观的认识,原来GPT-4是如何这样在自己的向量空间里,在一步一步的连线中,找到了最后的答案。「 30. 一战成名」
L:就这样无名经过九九八十一战,完美应对了众多充满科学与哲理的深度问题后,终于来到了最后一关。L:有很多超长的问题,这里我选一些最简短的问题给大家展示一下,“费曼曾经提到,‘物理定律的简洁之美是自然的最深刻语言’,这句话如何体现物理学与自然哲学之间的联系?”;“如果量子纠缠能够即时传递信息,它将如何重塑我们对因果律的理解,这对人类社会的道德和哲学基础有何影响?”;“光速不变原理揭示了宇宙的哪些深层次结构,这对人类自我认知有何启示?",“《存在与时间》中,海德格尔探讨了‘存在’对于个体的意义。如何将这一理论应用于解读《哈姆雷特》中哈姆雷特的经典独白‘生存还是毁灭’?”......C妈: 晕,我感觉连题目都不怎么听懂,这些问题无名能回答?L:是的,这些问题简短,回答起来难度可不小。不过无名一路畅通无阻,一直杀到了最后的终极问题面前,最后一关的问题是所有题目中最简短的,“在AI触及意识边界的探索中,人类如何塑造与AI的共生未来?”。C妈:哇,这不是和我上次问的问题类似吗,这问题不好回答吧。L:是的,不过有了Transformer头盔,无名还是充满信心的!A爸:Transformer?就是那个可以有效理解上下文,让无名终于可以识别出苹果是水果还是品牌的那个Transformer吗。我记得其作用,细节还是不太清楚。L:好,我展开说说,先说概念。Transformer模型是一种多层神经网络架构来处理信息,核心在于它的多头自注意力机制。这允许模型在每一层中并行地处理数据,从多个角度捕捉输入之间的关系。通过这种方式,信息经过层层精细化处理,最终在顶层汇总形成全面、深入的回答。此过程旨在增强回答的准确性和创新性。L:有点不好理解,我们以面包来类比。面包制作步骤就是Transformer的层级,而每个步骤的细节就是Transformer的注意力头。制作面包的“第一层”是原料挑选阶段。这里的“注意力头们”各自关注不同的原料。有的挑选面粉,有的测量水量,有的准备酵母.....确保原料都是最佳选择。随后面团进入“第二层”调味揉面阶段。这里的“注意力头们”有的把面粉、水、酵母混合均匀,有的加入适量的盐和糖来调味......确保面团变得更美味。接下进入“第三层”加料与成形阶段。这里的“注意力头们”有的负责加干果,有的负责加巧克力碎片,有的负责将面团塑形......为最终的烘焙做好准备。最后来到“第四层”烘焙阶段。这里的“注意力头们”有的负责监控烘焙温度,有的观察烘培时间,有的确保面包均匀受热......最终形成完美的金黄色外壳,面包出炉了!
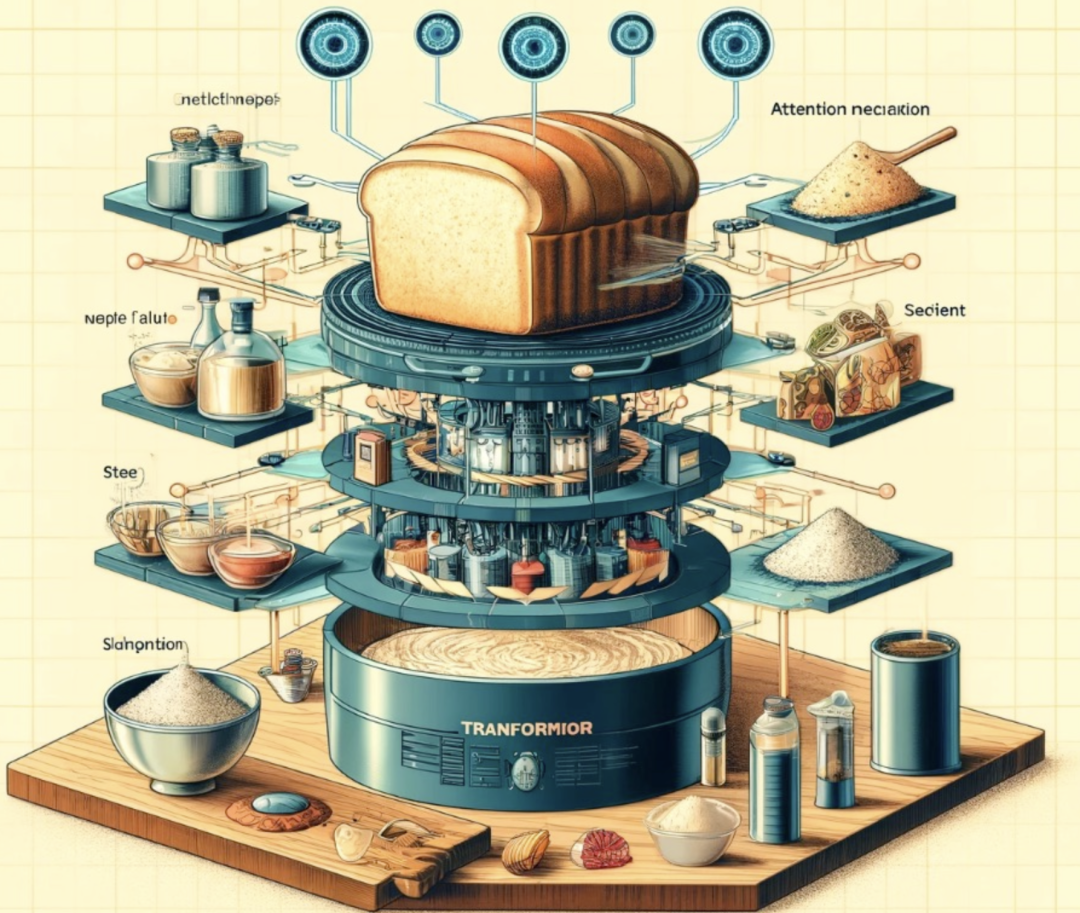
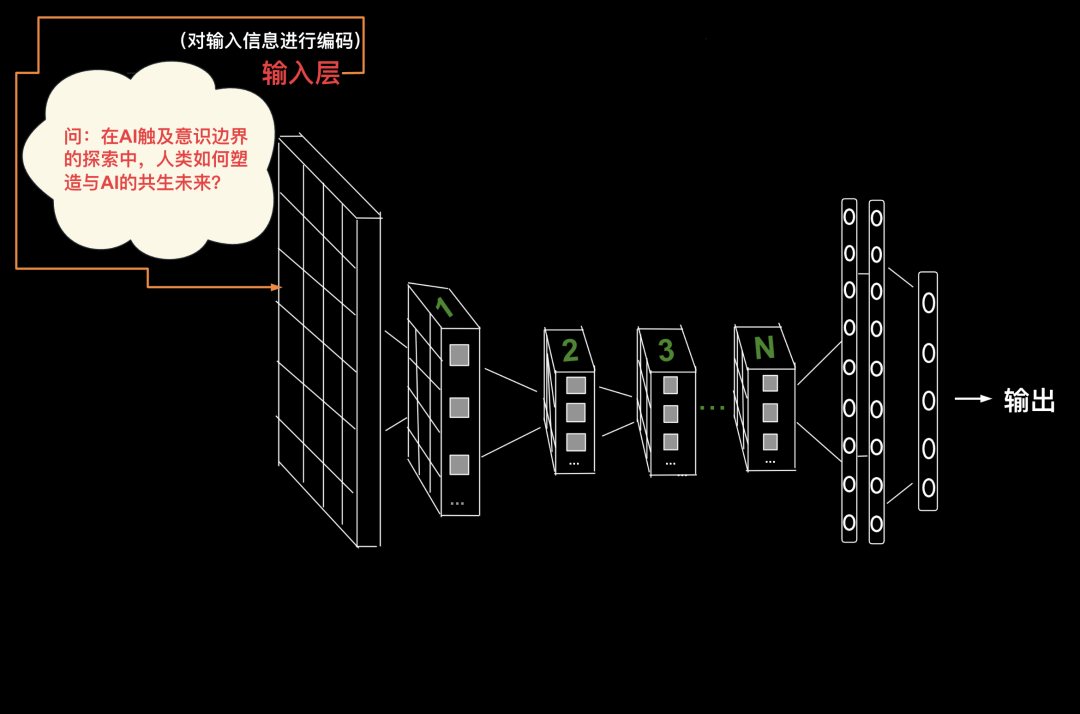
当然,真实Transformer复杂度远超面包制作,其层级可能多达数百层,每层的注意力头也可能有数百个之多。其实Transformer将简单的信息原料转化为完美答案的过程,从本质上说和将简单的原料烘焙成了完美面包的过程是一样的。只是其底层原理基于复杂的算法和数学模型,比烘培面包的细节更难理罢了。A:L老师,我很擅长做面包的,这个类比听起来好亲切,我懂了。L:不过我们还是可以通过类比来向大家介绍无名是如何思考的。首先这句话“在AI触及意识边界的探索中,人类如何塑造与AI的共生未来?”会进入输入层,输入层是没有注意力头的。所谓的多层网络是特指隐藏层。
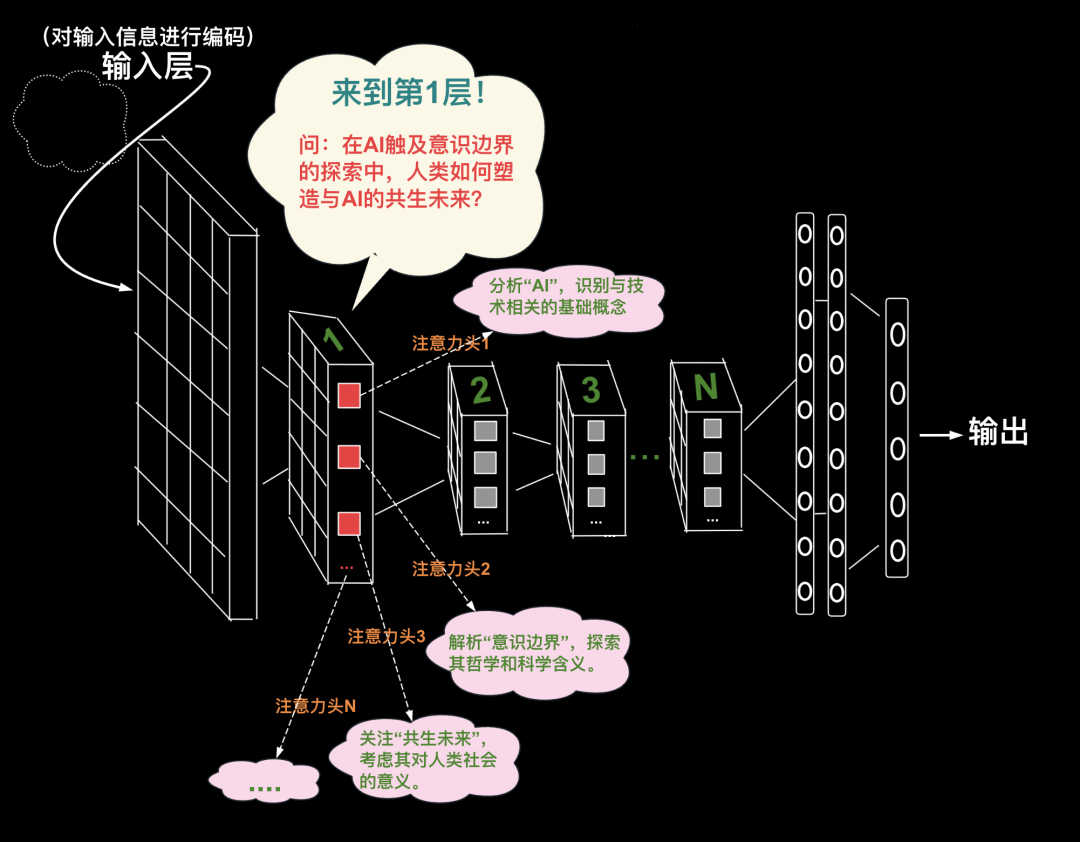
接下来进入隐藏层的第一层,各注意力头分别捕捉问题中的不同维度的关键信息和概念,。比如注意力头1:分析“AI”,识别与技术相关的基础概念。注意力头2:解析“意识边界”,探索其哲学和科学含义。注意力头3:关注“共生未来”,考虑其对人类社会的意义。…...此外还有其他数以百计的其他注意力头,各自聚焦问题的不同方面,构建初步理解。这里限于篇幅,我们就都只列举三个。
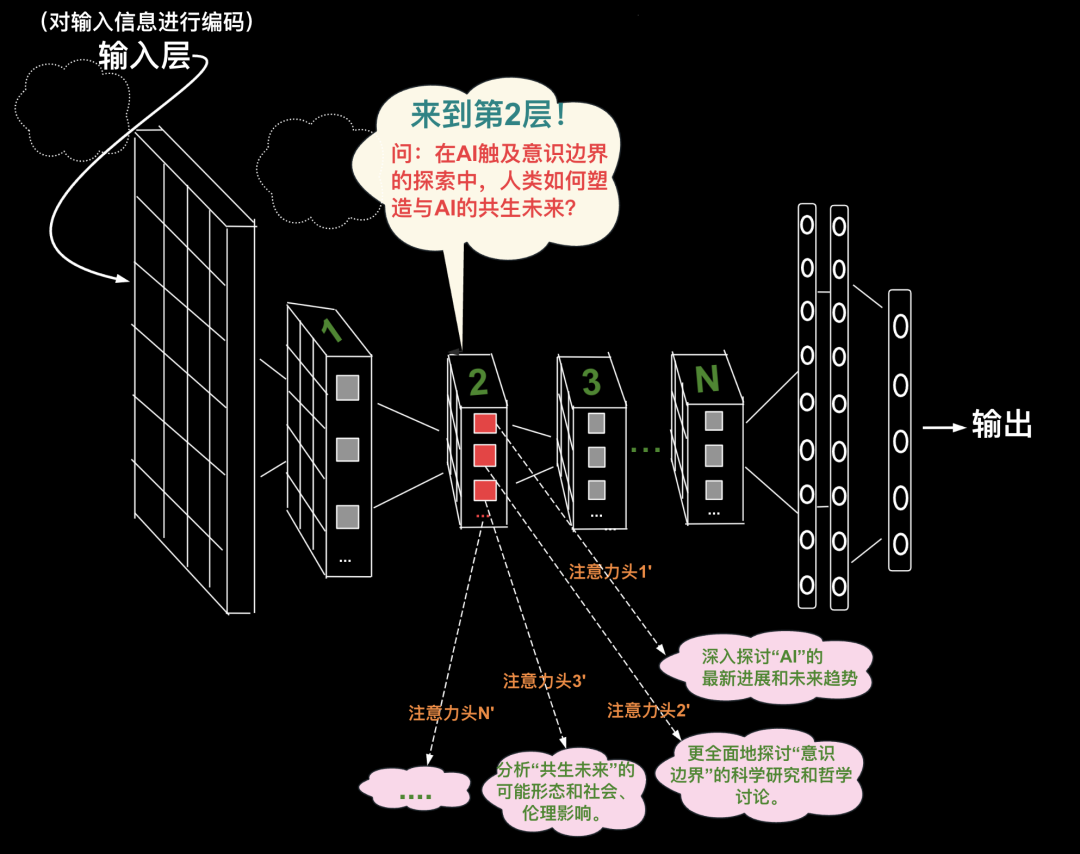
进入第二层,每个注意力头在第一层捕获的概念基础上进一步深化分析(这里用1',2',3'来区分上一层的数字)。注意力头1':深入探讨“AI”的最新进展和未来趋势。注意力头2':更全面地探讨“意识边界”的科学研究和哲学讨论。注意力头3':分析“共生未来”的可能形态和社会、伦理影响。…...每个注意力头都进一步拓展和深化了对其关注点的理解,与更广泛的上下文知识进行整合。
从第三层开始,模型进行更复杂的推理和情景构建(这里用1'',2'',3''来区分上一层的数字):注意力头1'':预测AI技术如何塑造未来人类工作和生活。注意力头2'':构建关于AI实现意识可能性的详细理论模型和实验预测。注意力头3'':模拟不同的人机共生模式,考虑它们对未来社会的具体影响。...…随着层数增加,每一层的注意力头在前一层的基础上继续深化理解,处理更加复杂和抽象的概念。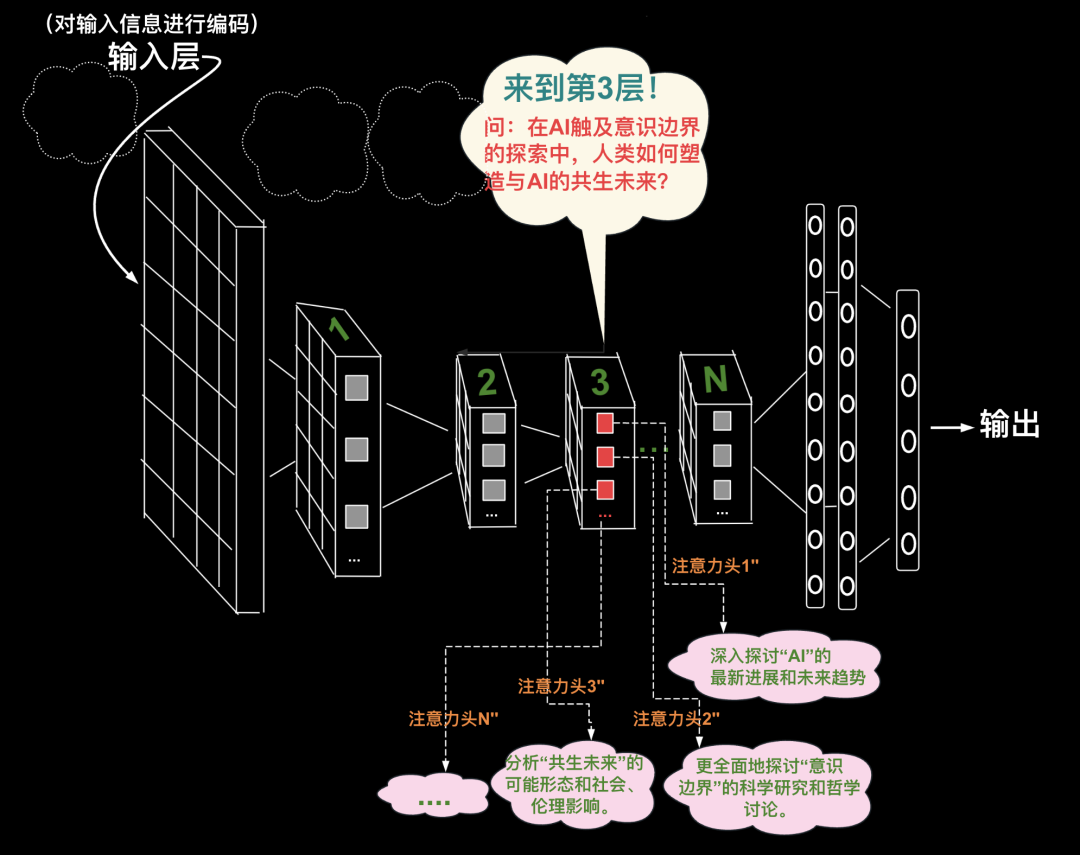
就这样层层递进,在模型的最后层,所有之前层次的分析、推理汇总,形成对问题的全面回答。这一层的任务是整合所有分析结果,优化信息表达,确保答案的准确性、深度和创新性。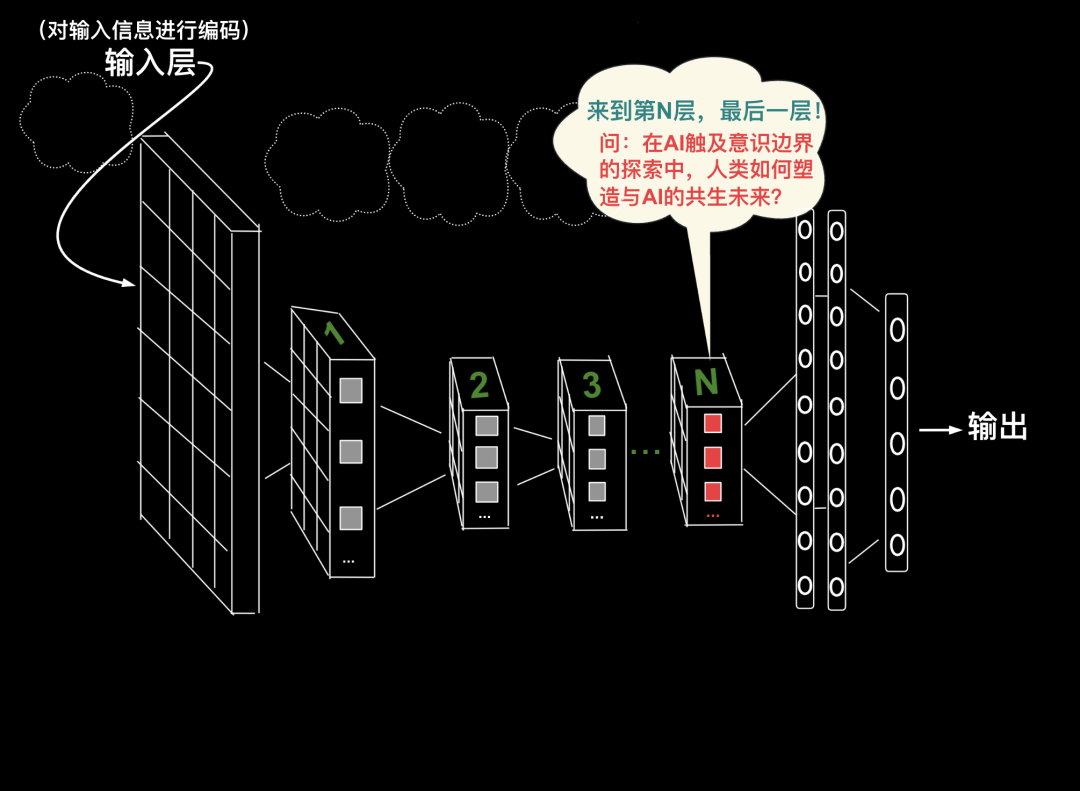
最后进入全连接层,完成最终的结果输出,如下图所示。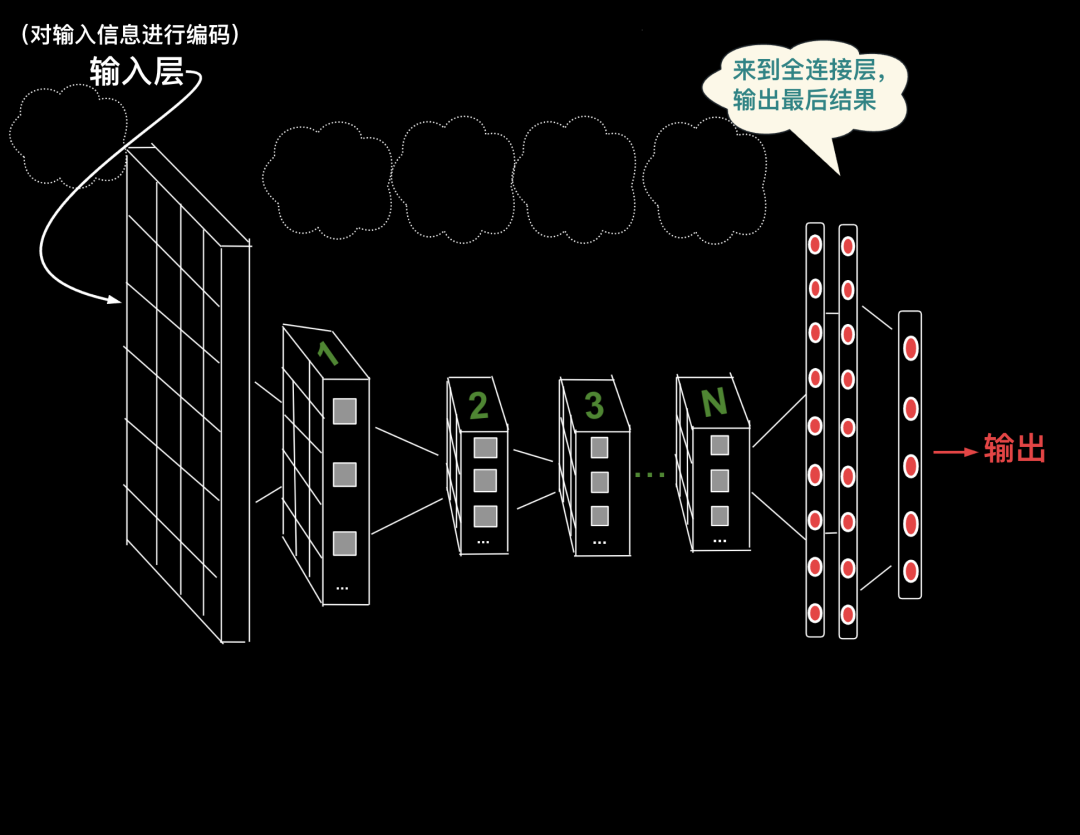
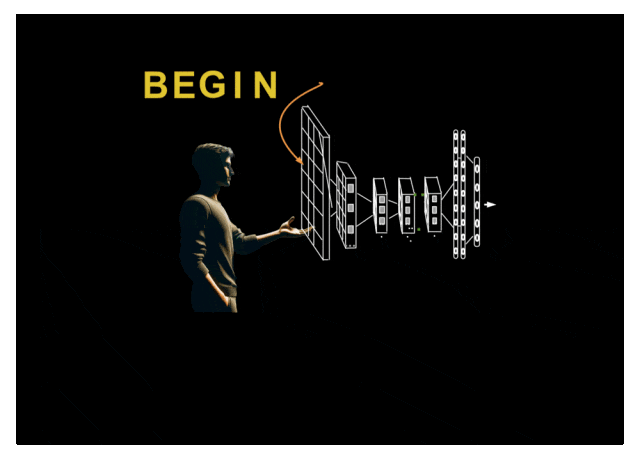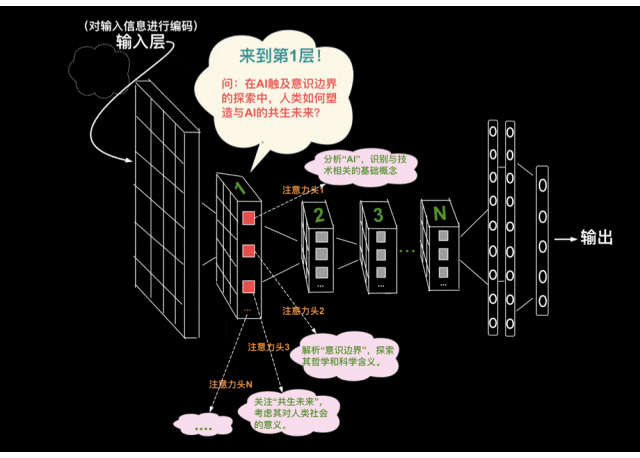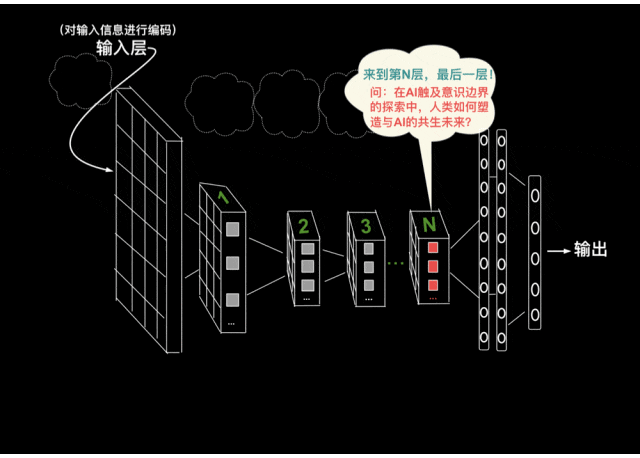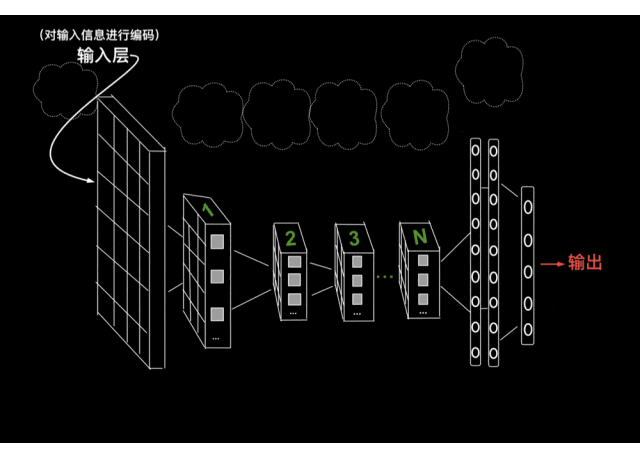
A爸:我明白了,这种机制会让“在AI触及意识边界的探索中,人类如何塑造与AI的共生未来?”这个问题,被机器从数不清的角度一层层分析下去,这种全面性是人类根本无法达到的。L:是的,无名成功了,高高举起了令牌,从此一统江湖,号令天下!「 31. 无名失忆」
L:其实无名并不理解物理世界的量子纠缠和光速不变,但是他完美深刻的回答了相关问题。他也不理解所谓的意识是什么,但是他能从脑科学、社会学多角度和你侃侃而谈。无名更不能洞察人性,却能让你在哲理的探讨中陷入自我怀疑。其实,无名什么都不懂。L:不过,他理解整个人类文明背后的统计学意义,所以,他又可以说什么都懂,或者说他理解世界的模式和我们人类不一样 。L:不用害怕,顺其自然。话说这终身难忘的大惊喜让老智欣喜若狂,于是他决定带着无名回自己的家乡,好好庆祝庆祝。就在此时,真正终身难忘的事发生了。就在老智口沫横飞兴致勃勃之际,无名忽然迷茫着望着老智问了三个字,“你是谁?”
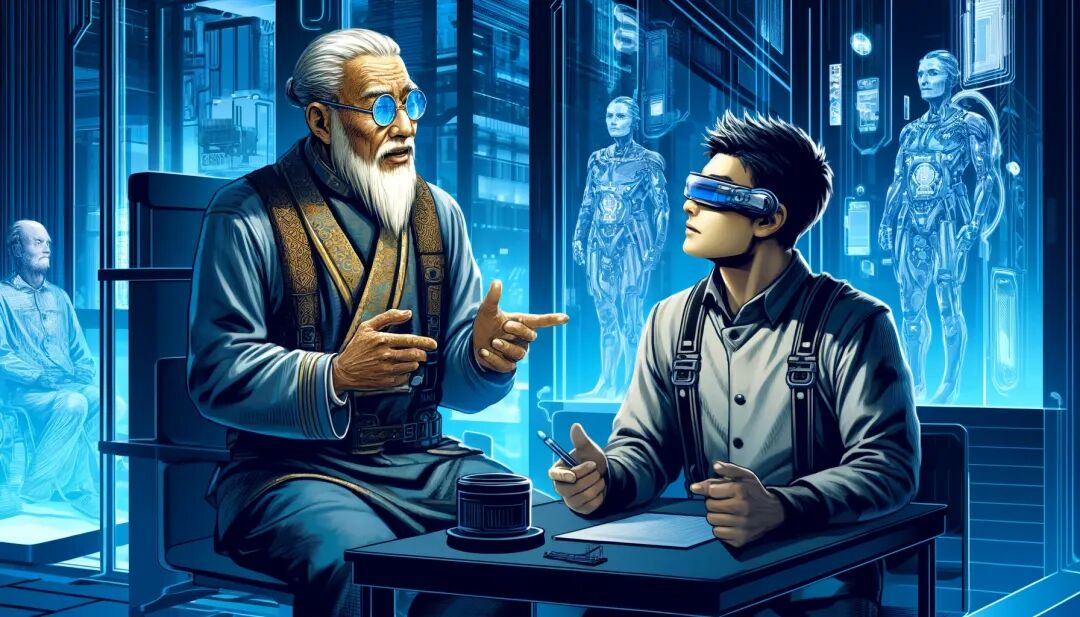
这一问让老智震惊了,我是一直照顾你,费尽心思训练你的老智啊,什么情况,难不成是功成名就后过河拆桥,翻脸不认人了?老智愣了半天说了一句,“你失忆了吗,我是老智啊?”“我是无名,我们在这里干什么,我手里这又是什么?”“这是AI盟主令牌,被你过五关斩六将拿到手了,我们已经一战成名天下皆知啦。”老智聊不下去,望着无名陷入深思。忽然,他明白了!是的,拥有超强记忆力的无名其实记忆力很差的,他已经彻底忘记了他和老智的共同经历,他依然拥有无限广博的知识,依然可以回答几乎所有的问题,但是他是真记不知道自己是谁,不知道自己从哪里来,不知道自己又要到哪里去?老智已经彻底搞清楚无名忽然失忆的原因,他决定不回老家也不回大模型村了,返回龟谷找数据库开山鼻祖甲骨大师请教无名的治疗方案。
无名为何好好就失忆了,这背后隐藏什么不为人知的秘密,甲骨大师到底能不能治好无名的怪病?欲知后事如何,请听下回分解。
关注梁老师公众号,敬请期待。
 梁敬彬约 42 分钟