不得不说,最近的面试真是五花八门,甚至有些企业的套路让人啼笑皆非。这不,有位网友在网上发帖说,他面试了一家公司,HR给出的薪水是9000元,比他的期望值1万元少了不少。但是HR却强调公司的员工福利相当优厚,餐补、五险一金全额交纳。有人说,9k跟1w其实差不多,因为很多公司不是全额缴纳的五险一金。也有人强调,福利是福利,工资是工资,砍福利的时候不需要征求员工同意。虎哥建议这位网友在做决定前,还是要仔细算一算账。如果你觉得公司提供的福利确实对你有吸引力,那可以尝试一下。毕竟,工作是为了更好的生活,而好的福利能让我们的生活更加有保障。顺便提一下,有个叫NSQL的开源工具,可以帮你轻松生成SQL语句,大大提高工作效率。虎哥平时经常在工作中遇到需要快速编写SQL查询的情况,不管是技术文档的整理,还是数据分析,总是离不开SQL这门语言。SQL作为最常用的数据库查询语言,广泛应用于各大数据库管理系统,比如Oracle、MySQL、PostgreSQL和MSSQL等。对虎哥这样的程序员来说,能通过简单提问让大型语言模型生成SQL查询,这简直是梦寐以求的事情。实现这个目标,通常有两种方法:使用现成的模型或者对基础模型进行精调。现成的模型通常是用公共数据训练的,缺乏与特定组织知识相关的内容。你可能会觉得提供上下文信息给GPT等大模型就能解决问题,但实际情况往往不如人意。模型生成的SQL查询有时会出现幻觉,尤其在使用特定命名约定或业务规则的情况下。这时候,使用组织特定数据对模型进行精调显得尤为重要,它能让模型更灵活地处理每个组织的数据。现成模型和精调模型的选择
现成的模型在通用任务上表现尚可,但缺乏个性化。每家公司的数据结构、命名规则都不同,特别是那些只有内部员工才熟悉的业务逻辑,现成的模型很难处理这些特定需求。相比之下,精调模型能利用特定数据进行微调,使其更好地适应实际业务场景。比如,虎哥在处理公司特有的数据库时,现成模型经常搞不清楚各种表名和字段的含义,而精调模型则能准确理解并生成有效的查询。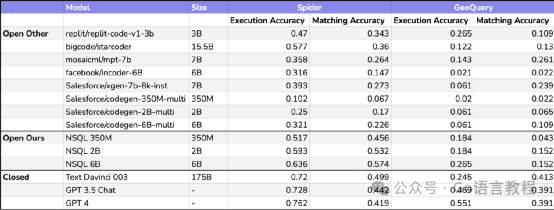
有些人可能认为,使用像GPT这样的大模型并提供充分的上下文信息,就能解决问题。但实际上,即使设置了temperature=0,模型依然可能产生幻觉。此外,动用参数数量高达500亿的通用模型来生成特定的SQL查询,资源消耗未免太大。因此,针对特定SQL任务,选择一个开源或封闭源的模型进行精调,往往是更合适的选择。NSQL的解决方案
为了解决这些问题,NSQL采用了两步训练过程。首先是收集大量的SQL代码和带有标记的文本到SQL对的数据,然后通过自监督学习对这些数据进行预训练。NSQL的训练过程包括两个主要数据集:一个是包含通用SQL查询的预训练数据集,另一个是包含文本到SQL对的微调数据集。这些数据来自Web上20个不同的公共来源,包括医疗数据等。通过这种方式,NSQL不仅能处理一般的SQL查询,还能执行特定任务,生成更符合实际需求的SQL代码。微调过程中,数据集经过模式增强、SQL清理和更好的指令生成,最终形成包含30万个样本的微调数据集。这些数据将在HuggingFace上公开,供大家下载和使用。性能评估
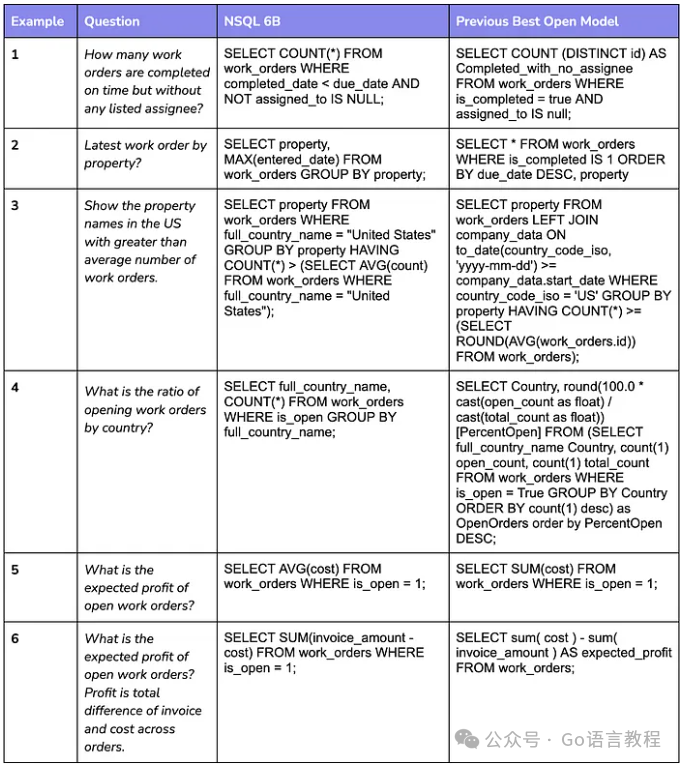
定性评估显示,NSQL在遵循指令方面表现更好,且幻觉比任何现有模型都少。尤其在提供模式作为上下文时,模型的表现尤为突出。以下是一些模型表现良好的案例:能够准确生成复杂的SQL查询
准确识别并处理特定的业务逻辑
同时,也有一些表现不佳的案例,主要是由于上下文不明确,导致模型生成的查询不准确。下载链接:www.songshuhezi.com/index_open/nsql.html
 点击关注👉约 4 分钟