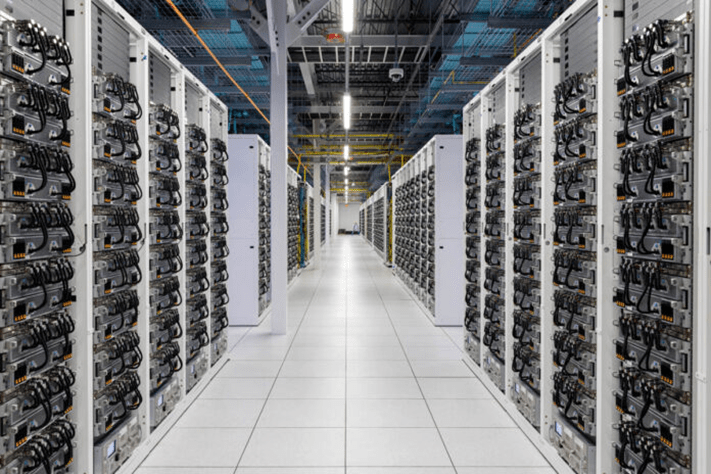
 *xAI Colossus 数据中心计算大厅
对于那些已经耳闻埃隆·马斯克在孟菲斯打造巨型AI超级计算机xAI的人来说,这正是那个令人瞩目的集群。这座耗资数十亿美元的AI集群配备了100,000个NVIDIA H100 GPU,不仅规模宏大,而且建造速度惊人。团队仅用了122天的时间,就成功建成了这个巨型集群。说明一下,鉴于构建全球最大的AI集群是一项高度敏感的事情,部分信息将进行模糊处理或故意表述得较为含混。我们之所以能这样做,是得到了Elon Musk及其团队的特别授权。
▌xAI 的超微液冷机架
Colossus的基本构建模块是 Supermicro 液冷机架。它由8台4U服务器组成,每台服务器配备8个NVIDIA H100,从而每个机架总计配备了64个GPU。具体来说,一个完整的GPU计算机架包括这8台GPU服务器,外加一台Supermicro冷却液分配单元(CDU)及其他必要的硬件设备。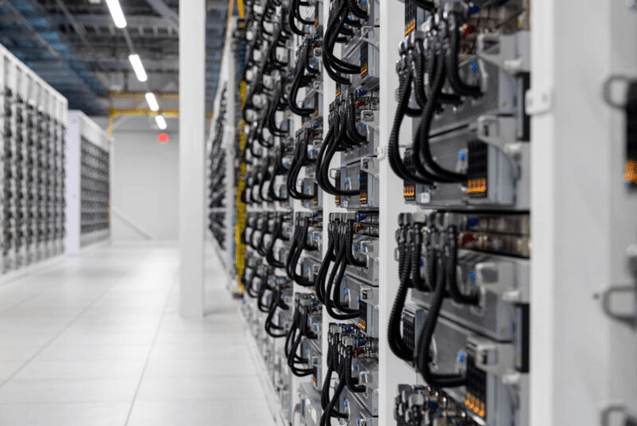
*xAI Colossus 数据中心 Supermicro 液冷节点低角度
这些机架被组成每组八个的阵列,总共包含512个GPU,再加上相应的网络设施,可在更大的系统中提供迷你集群环境。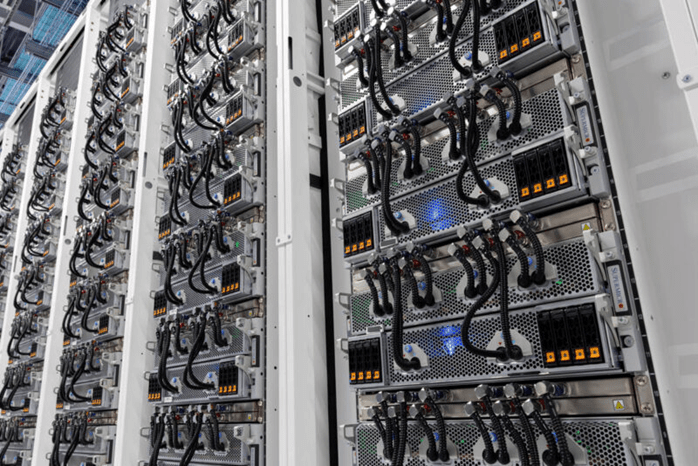
*xAI Colossus 数据中心 Supermicro 4U 通用 GPU 液冷服务器在此场景下,xAI采用的是Supermicro的4U通用GPU系统。这些系统之所以被视为当前市场上最先进的AI服务器,主要基于两大原因:一是其先进的液体冷却技术;二是卓越的可维护性。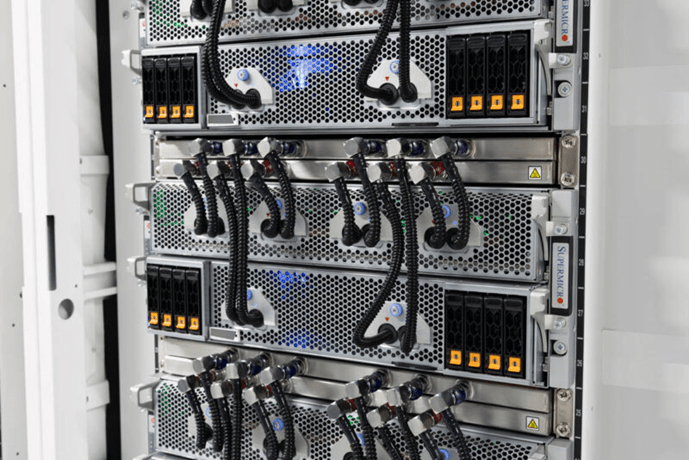
*xAI Colossus 数据中心 Supermicro 4U 通用 GPU 液冷服务器大约一年前,在丹佛举办的Supercomputing 2023(SC23)大会上,我们首次目睹了这些系统的原型。这些系统的一个亮点是它们可以放置在托盘上,无需从机架上卸下即可进行维修。具体来说,1U机架歧管的设计使得冷液体能够顺利引入每个系统,并将热液体排出。此外,快速断开装置使得液体冷却装置能够迅速移开,我们在去年的展示中演示了如何单手完成拆卸和安装。一旦这些装置被移除,托盘就可以轻松拉出,以便进行维修工作。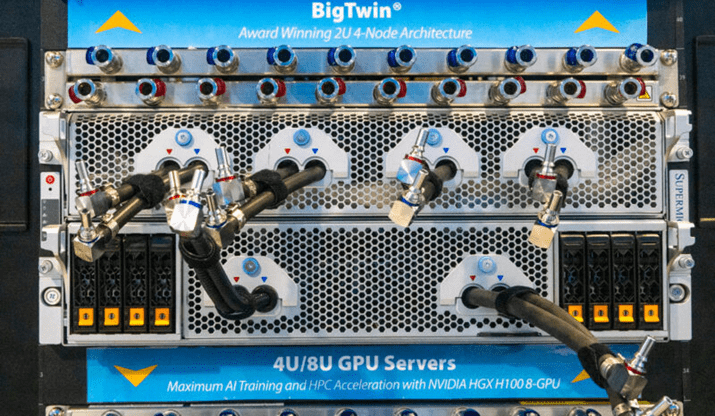
*Supermicro 4U 通用 GPU 系统适用于液冷 NVIDIA HGX H100 和 HGX 200
除了装备有8个NVIDIA HGX托盘的定制Supermicro液体冷却块外,CPU托盘的设计也彰显了为什么这些是业内无与伦比的下一代设计。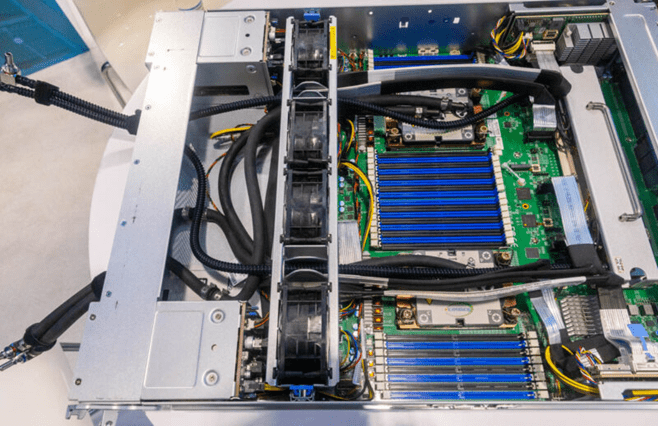 *Supermicro 4U 通用 GPU 系统适用于液冷 NVIDIA HGX H100 和 HGX 200
上图展示了SC23大会上的系统原型,其中两个x86 CPU的液冷块设计相当普遍。其独特亮点在于右侧部分:Supermicro的主板巧妙地将四个Broadcom PCIe交换机集成于一体,这四个交换机是当今几乎每个HGX AI服务器都不可或缺的组件。与之不同的是,业内其他AI服务器往往采用将PCIe交换机单独放置的设计,并在此基础上添加风冷系统。而Supermicro则独树一帜,其设计全程采用液冷技术,并且所有组件均出自同一家供应商之手。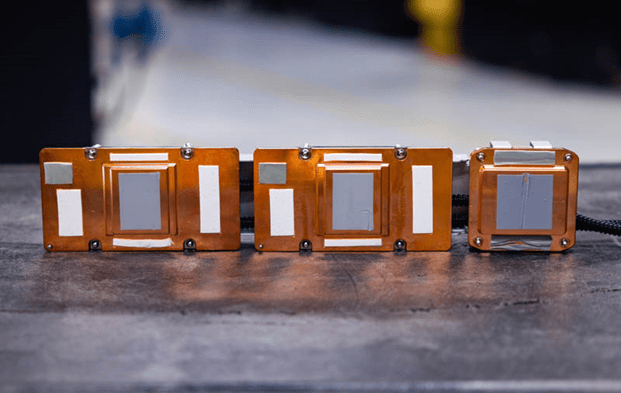
*Supermicro SYS 821GE TNHR NVIDIA H100 和 NVSwitch 液冷块这类似汽车设计,有些车型最初是设计为汽油驱动,而后在底盘上增加EV动力系统;而纯电动车则从一开始就是专为电动而设计的。
这款Supermicro系统就如同纯电动车一样,而其他HGX H100系统则更像是后来加装电动系统的汽油车。
自推出以来,我们已深入体验了大多数公共HGX H100/H200平台以及一些超大规模的设计。
毋庸置疑,这款Supermicro系统与其他系统之间存在着显著的差异,甚至超越了之前评测过的部分Supermicro其他采用液体或空气冷却的设计。
在机架后部,我们看到了用于GPU和CPU连接的400GbE光纤,以及用于管理网络的铜线。
这些网络接口卡(NIC)安装在自己的托盘上,无需拆卸整个机箱即可轻松更换,尽管它们位于机箱的后部。
此外,每台服务器都配备了四个热插拔的电源,这些电源通过三相PDU进行供电。
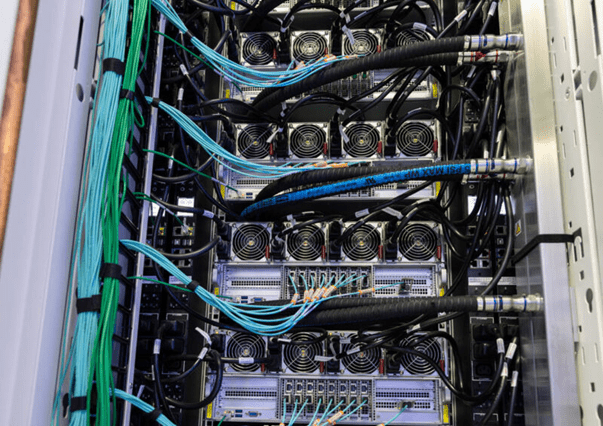
*xAI Colossus 数据中心 Supermicro 4U 通用 GPU 液冷服务器后置在机架底部,我们配置了CDU(冷却液分配单元),这些CDU扮演着巨型热交换器的角色。每个机架内部都设计有一个流体回路,专门用于向所有GPU服务器供应冷却流体。这里提到的“流体”并非单纯的水,而是根据液体冷却块、管道、歧管等组件的材料特性特别选定的。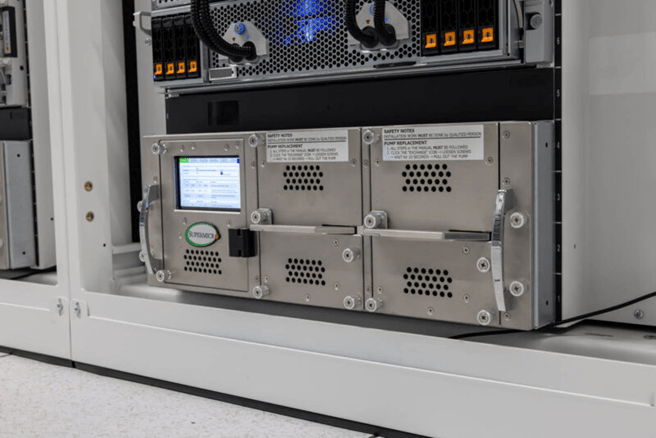
*xAI Colossus 数据中心 Supermicro CDU 位于机架底部每个CDU都有冗余泵和电源,以确保在其中一个组件发生故障时,能够现场进行更换,而无需中断整个机架的运行。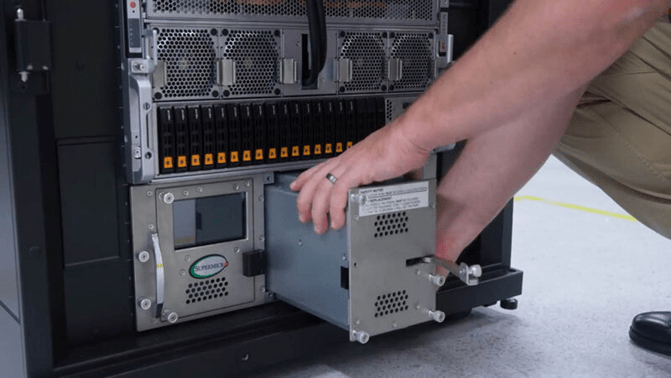
*Patrick 拆卸 Supermicro CDU 泵xAI机架承载着众多功能,而在拍摄2023年的相关作品时,我们更清楚地捕捉了Supermicro CDU的细节。通过这些画面,您可以清晰地观察到设施水与机架歧管的输入输出情况,以及每个CDU所配备的热插拔冗余电源。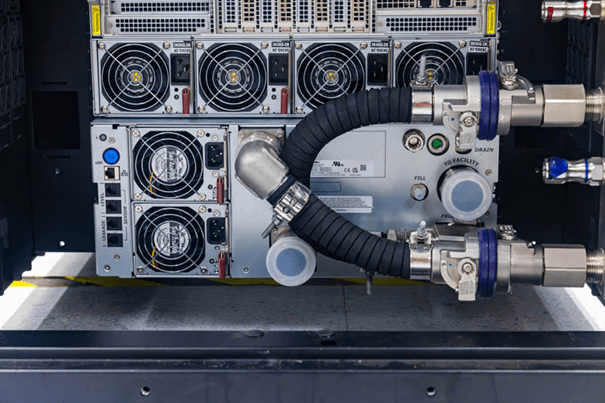
这是 Colossus 机架中的 CDU,被各种管子和电缆隐藏着。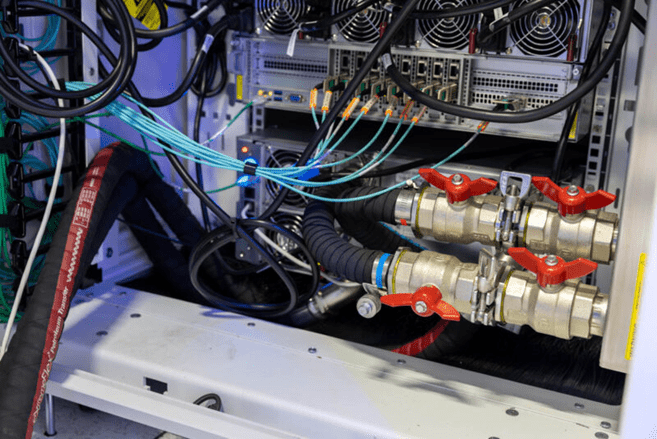
*xAI Colossus 数据中心 Supermicro CDU 后部在Colossus机架的两侧,均配置了三相PDU以及机架歧管。每个前置的1U歧管为4U通用GPU系统供电,而这些歧管则进一步由连接到CDU的机架主歧管供电。所有这些组件都采用了红色和蓝色的配件进行标识。这种颜色编码方案非常直观易懂:红色象征着热的部分,而蓝色则代表着环路中较冷的区域。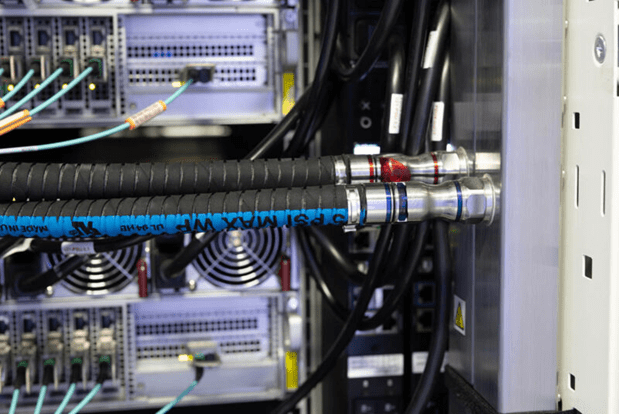
*xAI Colossus 数据中心 Supermicro 机架歧管软管事实上,许多液冷服务器都会采用风扇来对DIMM、电源、低功耗基板管理控制器、NIC等组件进行辅助散热。在Colossus中,为确保每个机架都能与数据大厅维持适当的中性冷却环境,从而避免部署庞大的空气处理设备,机架内的风扇设计用于从前方吸入较冷空气,并在服务器后部将其排出。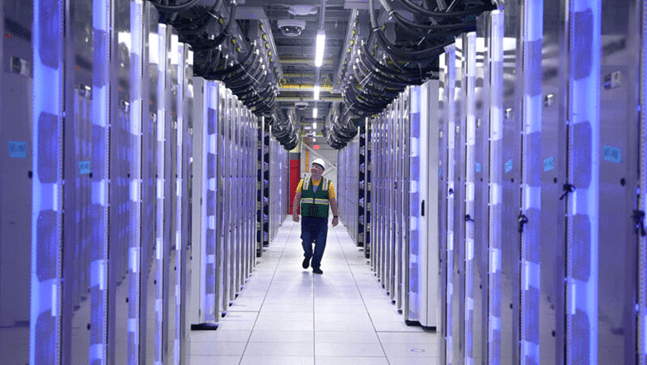
尽管后门热交换器听起来很花哨,但它们的工作原理与汽车散热器颇为相似。它们负责从机架内部吸取废气,并引导其通过带有翅片的热交换器进行散热。与服务器内部相似,这些热交换器中也循环有冷却液体,以便将热量传递到设施的水冷却系统中。空气通过设备后部的风扇被吸入进行散热。与大多数汽车散热器不同的是,这些热交换器具备一个巧妙的设计亮点:在正常运行时,它们会亮起蓝灯;而如果出现需要维修的故障,则会亮起红灯,当然,它们也可能显示其他颜色的灯光以指示不同状态。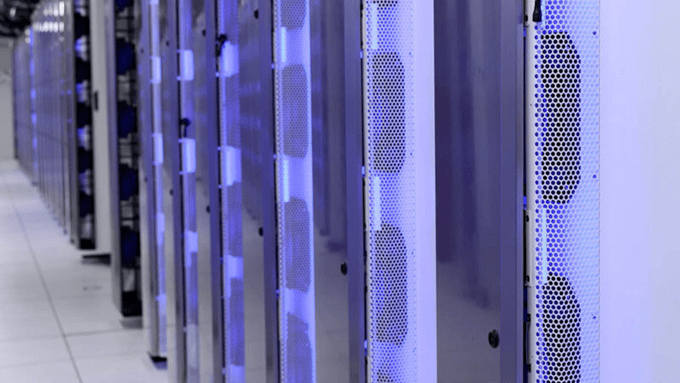
这些后门热交换器在数据大厅中还有另一个重要的设计用途:不仅可以消除 Supermicro 液冷GPU服务器产生的各种热量,还可以消除存储、CPU 计算集群和网络组件产生的热量。▌xAI 基于超微的存储
在这里,虽然运行着来自不同供应商的存储软件,但几乎每一个存储服务器都是Supermicro品牌的,这并不令人意外。毕竟,Supermicro是众多存储供应商的原始设备制造商(OEM)。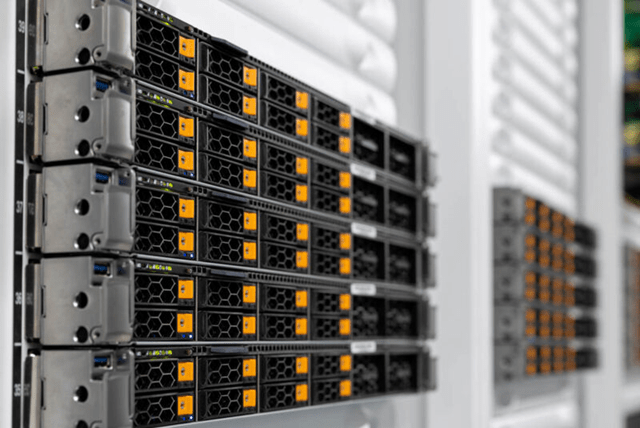
*xAI Colossus 数据中心 Supermicro 1U NVMe 存储节点一些存储服务器看起来与 CPU 计算服务器非常相似。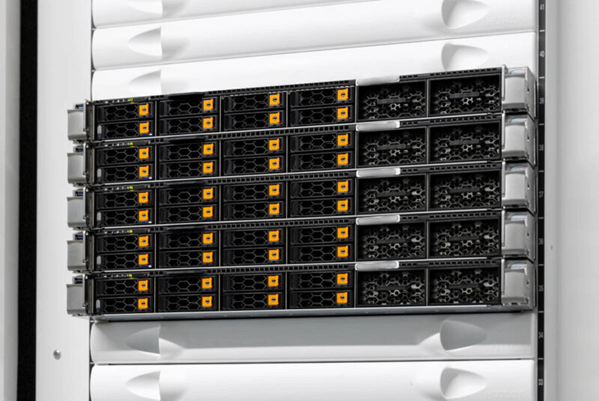
*xAI Colossus 数据中心 Supermicro 1U NVMe 存储节点 2数据中心有许多2.5英寸NVMe存储托架,因为大型AI集群已经逐渐从基于磁盘的存储转向闪存,因为不仅能节省大量电力,还能提供更为卓越的性能和更高的存储密度。尽管闪存每PB的成本可能更高,但在这种规模的集群环境中,其在总拥有成本(TCO)方面往往更具优势。
▌xAI 基于超微的CPU计算
在这些集群中,有大量的传统CPU计算节点。因为许多处理和数据操作任务在CPU上依然能够高效运行,而并非必须在GPU上执行。用户更倾向于让GPU专注于执行AI训练或推理等特定工作负载,而非其他类型的任务。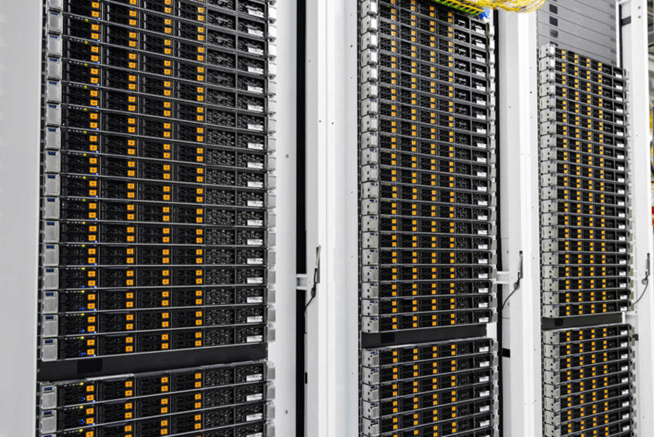
*xAI Colossus 数据中心 CPU 计算机架在这里,我们看到了 1U 服务器机架。每台服务器在设计时都力求在计算密度与产生的热量之间找到平衡点。一个典型的例子是,服务器前面板上的橙色标签标明了NVMe存储托架的位置,而面板的大约三分之一区域则专门用于吸入冷空气,以确保系统的有效散热。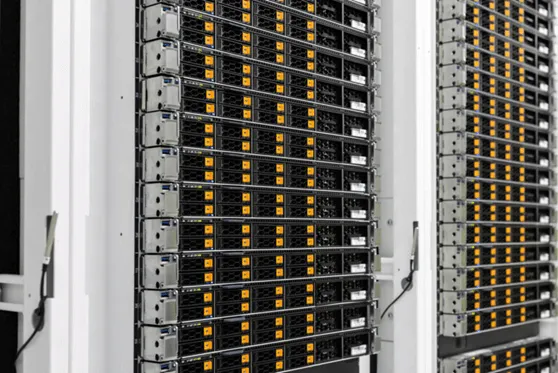
*xAI Colossus 数据中心 CPU 计算机架
这些1U计算服务器依靠风扇进行初步冷却,随后后门热交换器会进一步去除热量,并将其传递给设施的水冷却系统。得益于数据中心采用的后门热交换器设计,xAI系统能够兼容液冷与风冷设备,实现灵活的散热管理。
▌xAI Colossus 的网络
网络是其中最吸引人的部分之一,如果您的计算机使用以太网电缆,那么它与这里所采用的网络技术拥有相同的基础原理。不同之处在于,这里每个光纤连接的速度高达400GbE,比我们在其他地方常见的1GbE网络快了整整400倍。更令人惊叹的是,每个系统都配备了9个这样的高速链接,意味着我们每个GPU计算服务器所享有的带宽高达约3.6Tbps。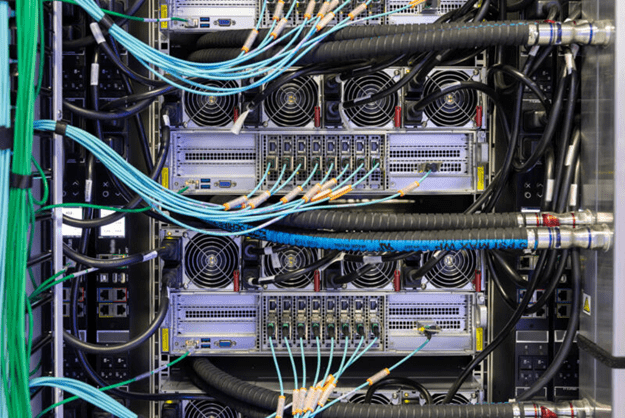
GPU的RDMA网络占据了该带宽的绝大部分。具体来说,每个GPU都配备了专属的NIC。在此,xAI系统采用的是NVIDIA的BlueField-3 SuperNIC和Spectrum-X网络。NVIDIA在其网络堆栈中整合了一系列特殊功能,这些功能能够确保数据准确无误地传输到指定位置,从而有效避免集群中出现瓶颈。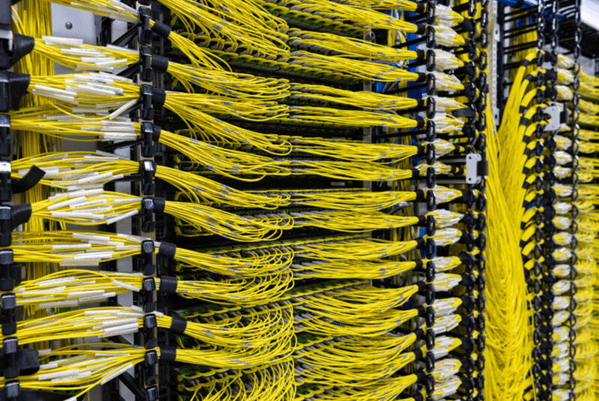
*xAI Colossus 数据中心交换机光纤 1
这是一项重大进展,尽管许多超级计算机网络倾向于采用InfiniBand或其他技术,但这里采用的是以太网技术,以太网意味着它具有出色的扩展能力。
以太网是互联网的基石,因此,它展现出极强的可扩展性。
这些庞大的AI集群正在不断拓展规模,已经超越了某些更为独特的技术所能触及的范围,这无疑是xAI团队的一次大胆尝试。
除了GPU RDMA网络外,CPU还享有400GbE连接,这依赖于完全不同的交换架构。
xAI为GPU运行一个专用网络,而为集群的其他部分则运行另一个网络,这种设计在高性能计算集群中十分常见。
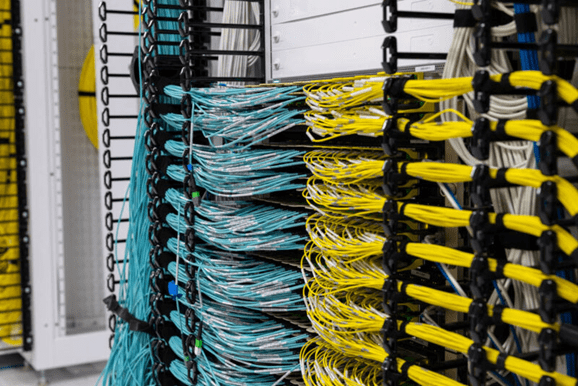
*xAI Colossus 数据中心单模和多模光纤为了直观了解400GbE的速度之快,可以将其与2021年初顶级Intel Xeon服务器处理器通过其所有PCIe通道所能处理的连接数进行对比。结果显示,400GbE的连接能力远超前者,而在这里,每台服务器都配备了九个这样级别的网络接口。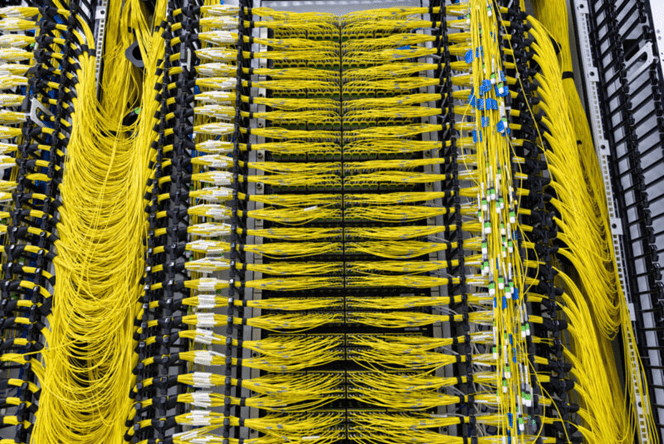
所有这些网络意味着我们拥有大量的光纤线路。每条光纤线路都经过切割和端接,长度正确,并贴上标签。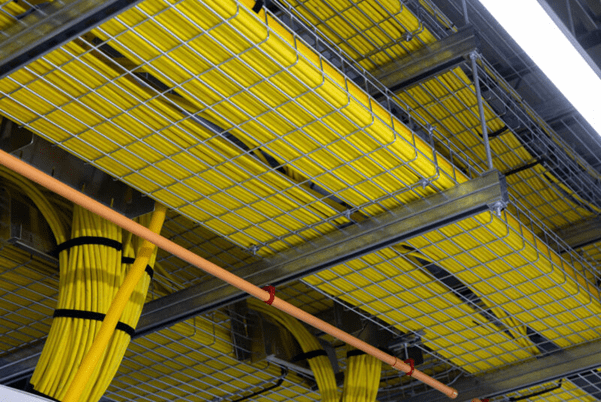
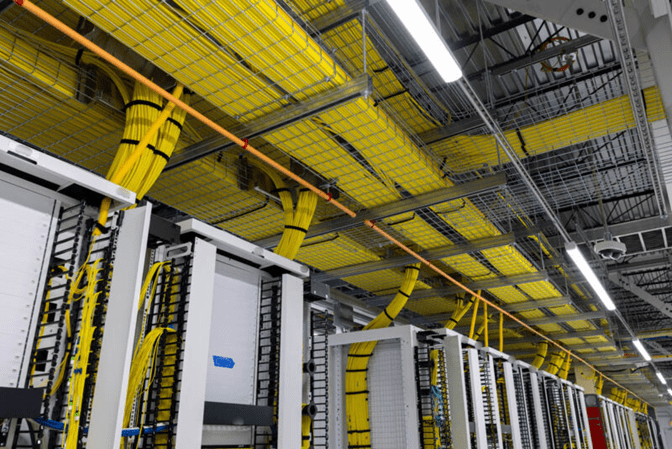
除了高速集群网络外,还存在低速网络,它们负责各类管理接口和环境设备在集群中的运行。
在参观该设施时,可以明显感受到液冷网络交换机的重要性。
最近,我们评测了一款64端口800GbE交换机,其性能级别高达51.2T,与众多AI集群中使用的交换机相当。
当前,业界面临的挑战不仅仅是冷却交换机芯片,还包括冷却光学器件,因为现代交换机的功耗可能远高于交换机芯片本身。
或许,像这样的大型安装将推动行业向共封装光学器件的转型,从而使得交换机的冷却能够像计算设备一样采用液体冷却技术。
我们之前已经见证过液冷共封装光学交换机的演示,因此,我们期待这次安装能够助力这些技术从原型阶段迈向实际生产。鉴于我们采用了液冷式AI服务器机架,电源供应和设施用水对于安装而言至关重要。下方铺设着巨大的水管,分为冷水和热水两组。冷水被引入设施,并在每个机架的冷却分配单元(CDU)中循环流动。在这个过程中,热量从GPU和后门热交换器回路传递到CDU的设施水回路中。随后,加热后的水被输送至设施外部的冷却装置中。当然,这里的冷却装置并非用于制冰的那种类型,而是旨在将水温降低至足够低的程度,以便能够再次在设施内循环使用,以实现有效的散热。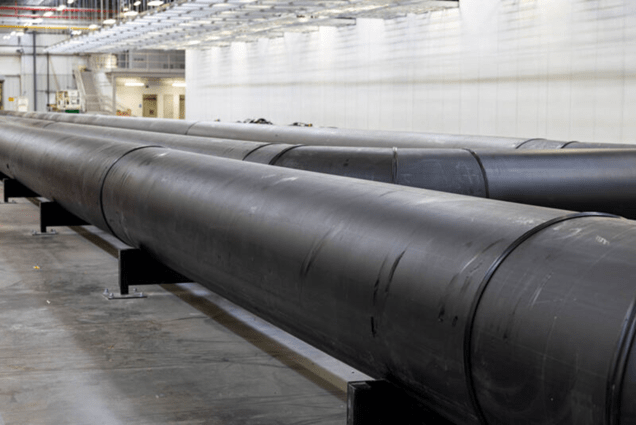
当我们在孟菲斯建设该系统时,我们能看到团队正在将巨大的电力电缆移到位。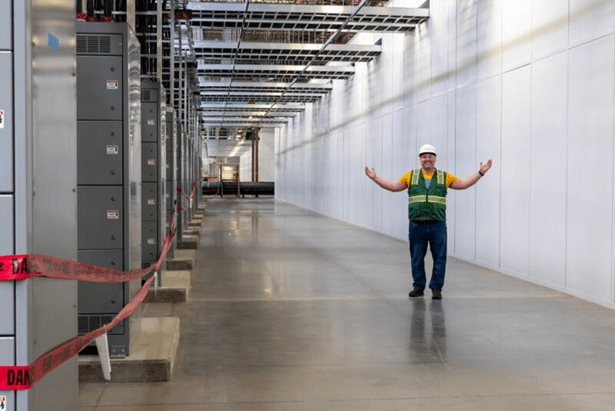
*XAI Colossus 数据中心与 Patrick 合作建设电力基础设施在设施的外部,我们看到了装有Tesla Megapacks的集装箱。这是团队在构建这个巨型AI集群时所汲取的一个重要经验。AI服务器并不会全天候24小时以100%的额定功率持续运行。相反,它们的功耗会出现许多高峰和低谷。由于现场部署了大量的GPU,随着工作负载在GPU之间转移、处理结果以及分配新的任务,功耗会产生波动。团队发现,即使是毫秒级的功率峰值和下降也会带来不小的压力。因此,引入Tesla Megapacks作为中间缓冲设备,以帮助应对这些功率峰值,从而提高了整个安装的可靠性和稳定性。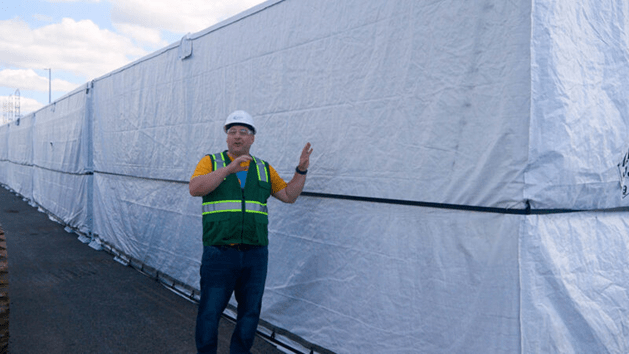
*Tesla Megapacks 准备在 xAI Colossus 进行安装在我们参观的时候,四个25,000 GPU的数据大厅中的初始集群已经启动并正在运行,总计可容纳大约100,000个GPU。
▌写在最后
在参与这个项目的过程中,我深刻体会到的一个关键点是,xAI团队需要更多时间去处理供应商之间的细微差异。
要实现如此宏大的目标,唯有依靠众多专家的共同努力,以前所未有的速度携手构建一个庞大的AI集群。
我们时常听到AI领域的人士讨论LLM如何通过增加计算资源来不断拓展其能力,以及它们如何能够广泛应用于聊天机器人等领域。
在Colossus周围漫步时,你会深深感觉到:只有那些深刻理解数据价值的人,才能够认识到这样规模的系统所蕴含的巨大潜力。Grok和xAI团队未来的努力,绝不仅仅局限于打造一个2024年的聊天机器人那么简单。
本文的英文原文发表于技术网站STH(www.servethehome.com),作者Patrick Kennedy,中文译文由黎曼猜想家翻译并首发于黄大年茶思屋(www.chaspark.com)。
原文链接↓
https://www.servethehome.com/inside-100000-nvidia-gpu-xai-colossus-cluster-supermicro-helped-build-for-elon-musk/4/译文链接↓
https://www.chaspark.com/#/hotspots/1069776586750394368因微信公众号整改,没有加“星标⭐️ ”的订阅号有时无法收到消息
1.为防止错过最新资讯,请将元宇宙与人工智能三十人论坛设为星标⭐️
2.点击“赞”和“在看”,提高我们相遇的几率。
3.精彩文章,请点击文末左下角“分享”给好友。
 元宇宙与人工智能三十人论坛约 11 分钟