批量推理:AI 大模型推理任务批处理
七 七牛云约 4 分钟
实时推理响应快,但处理海量数据时,接口调用频繁、成本高,任务还容易积压!
还有更高效、更经济的推理方式吗?有!
什么是批量推理? 简单来说,批量推理是相对于实时推理的另一种处理模式。相对实时推理的即时响应,批处理模式将多个推理请求集中起来,统一提交给大模型执行推理,在异步完成任务后返回结果。这种方式特别适合那些对即时响应要求不高、但数据量大的场景,推理费用更低。
要处理哪些文件(提供文件 URL 列表)。
要进行哪种 AI 操作(选定模型,例如:图像识别、内容审核、人脸检测等)。
处理结果保存到哪里(可选)。
高并发不排队:任务将被自动调度执行,无需关心实时限速和并发控制。 单任务支持数百万请求:通过 .jsonl 文件一次性提交,文件容量无硬性限制。 结果状态查询和下载:系统自动处理,任务完成后提供结果下载地址。 计费更友好:支持与实时接口统一的 Token 计费方式。 兼容模型更丰富:已支持 deepseek-v3、deepseek-r1、deepseek-r1-32b 等多种主流模型。
应用场景
这里,我们举个例子。
某大型电商平台希望对过去三个月的 1000 万条客服对话进行智能质检,包括识别负面情绪、违规话术、回复超时等情况。传统方式需耗费大量人工质检时间,效率极低。
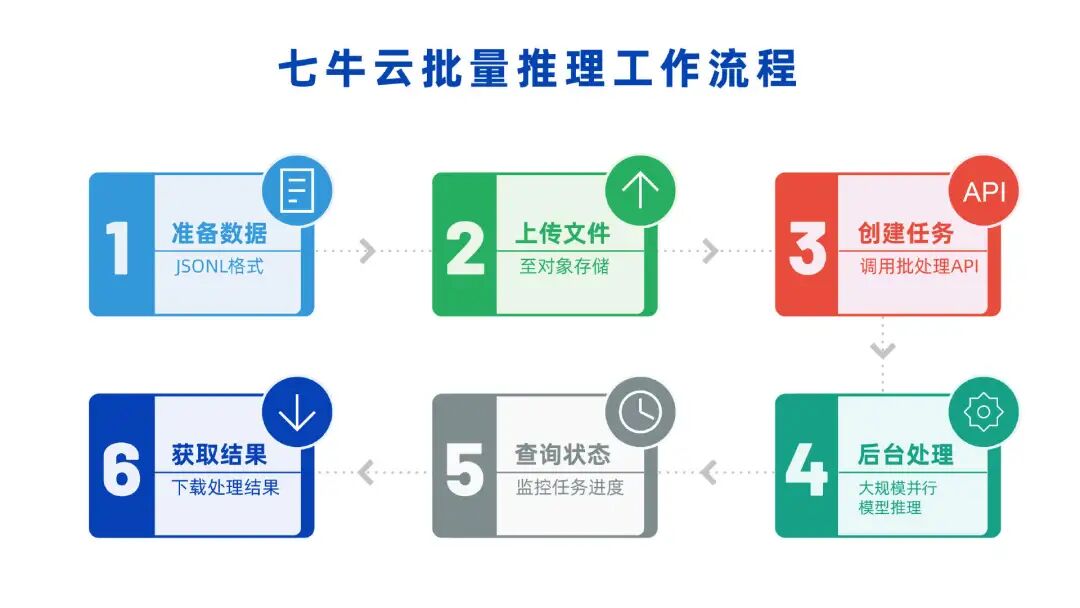
使用七牛云批量推理 API,技术团队将所有客服记录转为 JSONL 格式,按 5 万条一文件上传至对象存储,并通过 API 提交批处理任务,调用 deepseek-r1-32b 模型对每条对话进行情感与合规分析。
系统在后台自动调度,24 小时内完成所有推理任务,并将结构化结果返回至指定地址,极大地提升了质检效率和准确率。
典型输出格式:
{"custom_id": "session_23812","result": {"情感": "负面","风险等级": "高","风险点": ["辱骂客户", "未在规定时间内回复"]}}
快速上手
快速上手
1. 准备输入文件
1. 准备输入文件
{"custom_id": "request-1", "body": {"messages": [{"role": "user", "content": "介绍一下大语言模型。"}], "max_tokens": 1000, "top_p": 1}}{"custom_id": "request-2", "body": {"messages": [{"role": "user", "content": "什么是人工智能?"}], "max_tokens": 1000, "top_p": 1}}
每行必须包含唯一的 custom_id 字段,用于标识每个请求。
文件大小不超过 10MB。
文件需上传至可公网访问存储或 CDN 上(推荐用七牛云对象存储 Kodo )。
2. 创建批处理任务
2. 创建批处理任务
curl -X POST 'https://api.qnaigc.com/v1/batch/inference' \-H 'Authorization: Bearer YOUR_API_KEY' \-H 'Content-Type: application/json' \-d '{"name": "批量生成任务","model": "deepseek-v3","description": "处理用户提交的问答请求","input_files_url": "https://yourdomain.com/input.jsonl"}'
3. 查询任务列表、状态结果
3. 查询任务列表、状态结果
curl -X GET 'https://api.qnaigc.com/v1/batchjob/inferences?page=1&page_size=10' \-H 'Authorization: Bearer YOUR_API_KEY'