又一个开源 OCR 卷起来了:Chandra OCR 2,终于不只会“认字”,还开始真懂文档了
P AI工具教程 AI工具教程约 2 分钟
做过扫描件整理的人,应该都懂那种烦躁:字其实认出来了,但表格歪了,公式散了,页眉页脚混进正文,手写批注更是直接变天书。很多时候,最折磨人的甚至不是“识别不出来”,而是“识别出来一堆没法用的东西”。
这两天看到一个新开源项目,叫
Chandra OCR 2
,我第一反应还挺直接:这玩意儿不是在卷“识别率”那一个数字了,它是在卷“你最后拿到的东西能不能直接继续干活”。它支持把图片和 PDF 直接转成
Markdown、HTML、JSON
,而且重点是尽量把原始排版一并带出来。这个方向,明显比单纯吐一坨纯文本更实在。
官方给的信息也挺猛。Chandra OCR 2 支持
90 多种语言
,在它公布的 43 语种基准里,平均分是 **77.8%**;中文这一项是 **88.7%**。在 AllenAI 的 olmOCR 基准上,它的综合分数是 **85.9%**,项目页里把它写成了当前 SOTA。
但我觉得它真正有意思的,不是“第一名”这三个字,而是它专门啃的那些脏活累活:
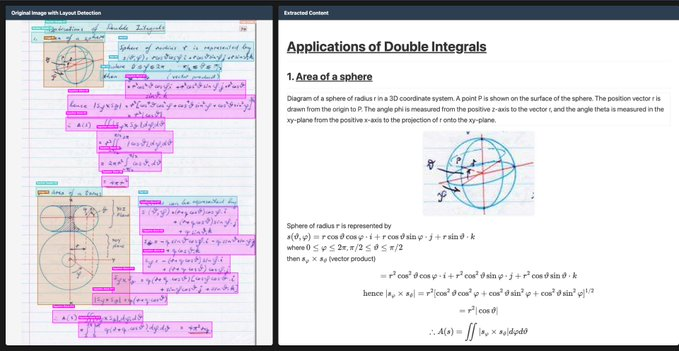
复杂表格、数学公式、表单、复选框、手写内容
,还有图表和图片的提取与描述。你一看就知道,团队盯的不是截图识别这种轻活,而是论文、报表、扫描档案、跨语言资料这些真会把人逼疯的文档。
还有一点很对我胃口:它命令行就能跑,单文件和整个目录都能处理,输出里除了 Markdown 和 HTML,还会带上 metadata,图片也能单独抽出来。这个就很像一个能接进工作流的工具,而不是一个演示页上看着很炫、真落地又得重搭一遍的玩具。
当然了,OCR 这个赛道现在也很卷,谁第一、能第一多久,都不好说。可至少从我看到的资料里,Chandra OCR 2 已经不只是“把字认对”,而是在往“把文档还原对”走。这个差别,真用过的人会懂。
你要是经常处理扫描 PDF、论文、票据、合同,或者手头老有中英混排、表格公式乱飞的文档,这个项目确实值得装起来试一下。
GitHub地址:
datalab-to/chandra。