LangGraph 1.0:别再用 DAG 写 Agent 了,你的 Agent 需要一个操作系统
 云朵君约 15 分钟
01为什么你的 Agent 跑着跑着就卡住了?
去年我在一个项目里写了这样一个 Agent:让它调研一个 GitHub 仓库,读 README、看最近 commits、翻几个关键文件的 blame,然后产出一份技术评估报告。
听起来不复杂。LangChain 的 LCEL 一把梭:prompt | model | tool_executor | parser,四条竖线串起来,几分钟就跑通了 demo。但上线第一周,就开始出问题:
—— 跑到第 3 步时,模型调用了一个不存在的 API endpoint,工具返回了空,链式调用继续往下走,把空结果当有效输入喂给了下一步,产出报告里第三章整个是胡编的。跑到第 7 步时,GitHub API 超时了——整个 pipeline 崩溃,前 6 步的中间结果全丢,重跑一遍又烧了 $3 的 token。
—— 我加了 try-except、加了重试逻辑、加了个 while 循环来控制反思次数。结果某天半夜,while 循环的条件判断被一个意外的 None 值绕过去了,Agent 在"think→没有结果→再 think→还是没有"的循环里跑了 200 多步,第二天早上账单上多了 $50。
不是 Prompt 的问题。是拓扑的问题。
LangChain Expression Language (LCEL) 的底层是一个 DAG(有向无环图)。数据从左往右流,每条边有方向,回边非法,每个节点最多执行一次。这是批处理脚本的计算模型:从头跑到尾,中间出错全丢。没有挂起,没有恢复,没有"想一想再决定下一步"。
而一个真正的 Agent 工作流需要什么?
循环反思:think → act → observe → think again。ReAct 模式天生是个环。 条件分支:如果工具 A 返回了空,改调工具 B;如果置信度低于阈值,走人工审批分支。 重试恢复:API 超时不等于任务失败——等 3 秒换个 endpoint 再试,而不是从头跑。 人工在环:执行到第 4 步时暂停,等人在 Slack 里点个"批准",再从第 4 步继续——注意是"继续",不是"重跑"。
这四个需求,每一项都对应 DAG 做不到的事。DAG 的天花板不是"写得不够好",而是无环图这个数学模型本身不允许回边——它被设计来处理数据流,不是控制流。
打个比方:DAG 是批处理脚本,Agent 需要的是多任务操作系统。 批处理时代,你提交一个作业,OS 从头跑到尾,中间崩了就崩了,打印一堆错误信息等你第二天来收尸。多任务 OS 时代,进程可以挂起(暂停到磁盘)、恢复(从磁盘读回)、时间片切换、隔离(一个进程崩了不影响别的)。
Agent 编排正在经历完全一样的范式转移。这个转移的核心产物,就是 LangGraph。
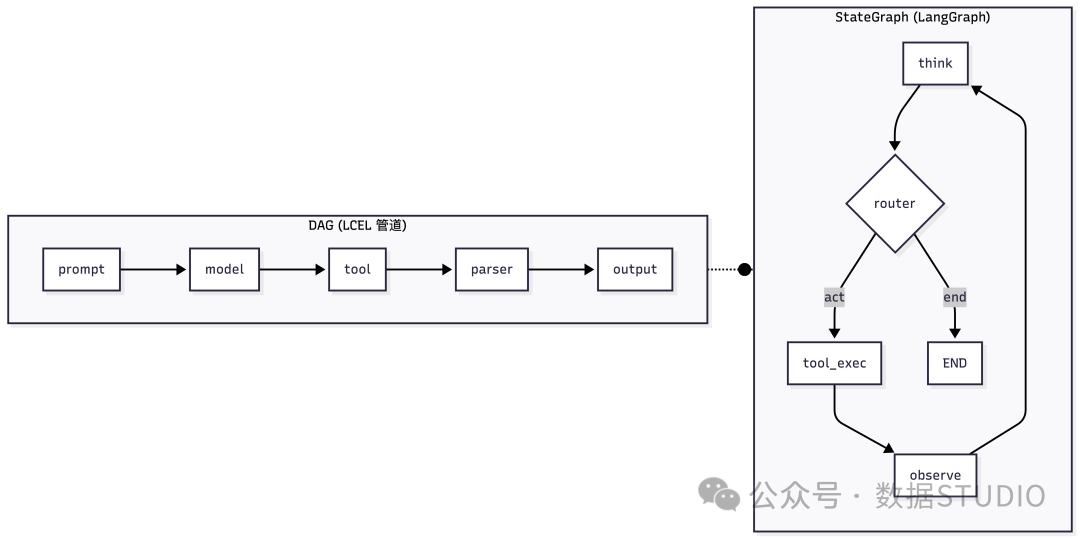
图1:DAG vs StateGraph 拓扑对比
02StateGraph:把图从管道变成状态载体
LangGraph 的核心抽象叫 StateGraph。名字里有"Graph",但它和 LangChain 的 DAG 是完全不同的计算模型。
LangChain 的 DAG 把图当作数据流的管道——数据进来,经过每个节点被加工,最后出去。每个节点拿到的是上一步的输出字符串。图的拓扑在编译时就锁死了。
LangGraph 的 StateGraph 把图当作状态的载体——一个共享的 TypedDict 或 Pydantic model 在所有节点间流转,每个节点读到的是完整 state,返回的是 state 的增量更新(diff),由 reducer 负责合并。
这里面的核心差别有三个。
第一,State 是共享真相源。
DAG 管道里,下游节点看不到上游节点的完整输出——它只拿到管道传过来的那个值。StateGraph 里,任意节点都能读到完整 state——包括之前所有步骤的累积结果。这让 Agent 可以在第 5 步"回看"第 2 步的判断依据,决定要不要改主意。
第二,Reducer 控制合并策略。
默认 reducer 是覆盖——节点返回 {"answer": "42"} 就把 state 里的 answer 字段覆盖为 "42"。但你可以自定义——比如 Annotated[list, add_messages] 会把新消息追加到消息列表而不是覆盖。这是 DAG 管道完全做不到的:管道只有"传递",没有"合并"。
第三,也是最关键的——Conditional Edge 让运行时状态决定控制流。
DAG 的边是编译时固定的:A → B → C,每次都一样。StateGraph 的条件边长这样:
graph.add_conditional_edges(
"think",           # 从 think 节点出发
    router_function,   # 检查当前 state,决定下一步
    {"act": "act", "end": END}  # 可能的去向
)
router_function 接收当前的完整 state,返回 "act" 或 "end"。这意味着同一入口,不同 state 走不同路径。这在 DAG 里需要把每个分支写成独立 pipe,五个分支就是五套代码——StateGraph 只需要一个 router。
来看一个最小对比。同样的任务——"查天气,如果下雨就建议带伞"——DAG 版和 StateGraph 版的代码差异:
DAG 版 — 无法循环, 单次调用
from langchain_core.runnables import RunnableLambda

def check_weather(city: str) -> dict:
    weather = get_weather(city)
if weather == "rain":
return {"advice": "带伞", "weather": weather}
return {"advice": "不用带伞", "weather": weather}

pipeline = RunnableLambda(check_weather)
result = pipeline.invoke("北京")  # 一次调用, 结束
StateGraph 版 — 循环反思, 直到用户满意
from typing import TypedDict, Annotated
from langgraph.graph import StateGraph, END

class AgentState(TypedDict):
    city: str
    weather: str
    advice: str
    user_satisfied: bool

def get_weather(state: AgentState) -> dict:
return {"weather": call_api(state["city"])}

def make_decision(state: AgentState) -> dict:
if state["weather"] == "rain":
return {"advice": f"{state['city']}有雨, 建议带伞"}
return {"advice": f"{state['city']}天气不错, 不用带伞"}

def ask_user(state: AgentState) -> dict:
# 模拟: 实际中这里可以 interrupt 等用户输入
return {"user_satisfied": input("满意吗? (y/n) ") == "y"}

def router(state: AgentState) -> str:
if state["user_satisfied"]:
return "end"
return "get_weather"# 不满意 → 重新查

graph = StateGraph(AgentState)
graph.add_node("get_weather", get_weather)
graph.add_node("make_decision", make_decision)
graph.add_node("ask_user", ask_user)

graph.add_edge("get_weather", "make_decision")
graph.add_edge("make_decision", "ask_user")
graph.add_conditional_edges("ask_user", router, {
"get_weather": "get_weather",  # 回边! 循环!
"end": END
})

graph.set_entry_point("get_weather")
app = graph.compile()
注意 ask_user → get_weather 这条边——在 DAG 的世界里,这是非法的。但 StateGraph 里有它,Agent 才能在用户不满意时真的回到第一步重来,而不是写一个 for i in range(3) 循环把整个逻辑包在里面祈祷别出 bug。
这就是从"管道思维"到"状态机思维"的转换。你不再写 step1 → step2 → step3 的线性脚本,而是定义节点(做什么)、边(去哪)、状态(记住什么)。运行时,当前 state 决定下一步走哪个节点。
03Pregel:Agent 的操作系统内核
StateGraph 定义"做什么",但真正"怎么跑"的是 LangGraph 底层的执行引擎——Pregel。
Pregel 源自 Google 2010 年的大规模图处理论文,原始设计是为了在数千台机器上并行处理网页链接图。LangGraph 借用了它的 BSP (Bulk Synchronous Parallel) 模型,并适配为 Agent 工作流的执行循环。
每个 superstep(超级步)包含三个阶段:
Plan(规划):检查所有 channel(状态通道),确定哪些节点的输入发生了变化——这些节点的输出需要重新计算。没有被"弄脏"的节点跳过。 Execute(执行):并行运行所有被 Plan 阶段选中的节点。每个节点接收当前 state,返回 partial update。因为 Agent 节点通常是 I/O 密集型(等 LLM 返回、等 API 响应),asyncio 并行可以同时发出多个调用。 Update(更新):把所有节点的输出原子化写入 channel,然后——checkpoint。整个 state 序列化保存到 checkpoint store。
然后进入下一个 superstep。循环。
这听起来像什么?操作系统的进程调度循环。
OS 内核不关心进程里跑的是 Word 还是 Chrome——它只做三件事:选一个就绪进程(Plan)、分配 CPU 时间片让它跑(Execute)、保存/恢复上下文(Update + Checkpoint)。Pregel 也不关心节点里是 LLM 调用还是工具执行——它只做三件事:决定哪些节点该跑、跑它们、保存状态。
这就是为什么"StateGraph 是 Agent 的操作系统内核"不是一个比喻——它是精确的工程描述。内核提供三个能力,DAG 一个都没有:
调度:不是所有节点每次都跑。Pregel 根据 channel 变更情况选择性触发——没被弄脏的节点不执行。相当于 OS 只调度处于"就绪"状态的进程。 持久化:每个 superstep 后自动 checkpoint。这意味着 Agent 可以在任何 interrupt()点休眠数小时、数天,甚至进程死掉——恢复时从最后 checkpoint 接着跑。Agent 是 checkpoint store 里的一行记录,不是进程栈帧里的临时变量。恢复:调用 graph.invoke(None, config)时如果指定thread_id且 checkpoint 存在——从上次中断的地方续跑,不是从零开始。
from langgraph.checkpoint.sqlite import SqliteSaver

checkpointer = SqliteSaver.from_conn_string("checkpoints.db")
app = graph.compile(checkpointer=checkpointer)

config = {"configurable": {"thread_id": "user-123"}}

# 第一次执行
app.invoke({"city": "北京"}, config)
# → 跑到 ask_user 时中断 (假设加了 interrupt_before)

# 服务器重启了, 进程死了
# 第二天:
app.invoke(None, config)
# → 从 ask_user 继续, 之前的状态完整恢复
这就是持久状态机的力量。DAG 管道一旦进程崩了,中间结果全在内存里,灰飞烟灭。StateGraph 的中间结果在 Postgres 里,换一台机器也能续跑。
图2:Pregel BSP 执行循环
04LangGraph 的边界:Checkpoint 保存一切,但不会自动救你
前面说的都是 LangGraph 做得好的地方。现在来说它的边界——因为一个诚实的工程判断,比一篇吹捧更有用。
2026 年 5 月,Diagrid(做 Dapr 那家公司)发了篇深度分析,核心论点就一句话:Checkpointing is not durable execution。 有个螃蟹实验很有意思——研究人员用 checkpoint/restore 方法测试 Agent 工作流的恢复正确性,发现超过 75% 的 Agent 轮次产生的是"恢复无关"的状态,原始 checkpoint 的重放正确率只有 8%。而改进后的语义感知 checkpointing 把正确率提到了 100%,同时减少了最多 87% 的 checkpoint 流量。
问题出在三个地方:
第一,保存状态 ≠ 自动检测故障。
LangGraph 会在每个 superstep 后写 checkpoint,但它不会主动发现"这个节点执行失败了需要重试"。checkpoint 是被动的存档机制,不是主动的健康检查。你需要自己写外部监控——比如一个定时任务检查 run 是否卡在某步超过 10 分钟,如果是,触发恢复。
第二,保存状态 ≠ 自动恢复。
失败了怎么办?LangGraph OSS 不会自动拉起一个新的执行。你需要自己搭建重试基础设施:一个 scheduler 检测到失败 → 调用 graph.invoke(None, config) resume → 处理 resume 后可能的重复执行。这套逻辑 LangGraph 给了你原语(checkpoint + thread_id + resume),但组装是开发者的事。
第三,resume 时重执行节点,不是续跑代码行。
这是最容易踩的坑。假设你的节点里写了三行代码:
def send_notification(state):
    send_slack("开始处理...")      # 第 1 行
    result = call_llm(state)       # 第 2 行
    send_slack(f"处理完成: {result}")  # 第 3 行
如果 LLM 调用在第 2 行超时了,checkpoint 保存的快照里这个节点还没跑完。resume 后会重新执行整个函数——Slack 里会收到两条"开始处理..."。所有有副作用的节点(发消息、写数据库、调付费 API、发邮件)必须做幂等处理——执行前先检查"这个操作是不是已经被做过了"。
好消息是 LangGraph 1.2(2026 年 5 月)已经在补这个方向:增加了 per-node timeouts(节点超时自动标记失败)、graceful shutdown(优雅退出时写完最后的 checkpoint)。但"自动检测故障并恢复"这件事,至今没有一个主流 OSS Agent 框架做到了——Microsoft Agent Framework 1.0 同样需要手动传 checkpoint_id 才能 resume,Dapr Agents 是唯一的例外(靠 K8s sidecar 提供基础设施级持久性)。
打一个游戏玩家的比方:Checkpoint 是手动按 F5 存档;Durable execution 是游戏自动帮你打到通关。F5 存档是必须的(DAG 连 F5 都没有,崩了就从第一关开始),但它不是自动通关。2026 年的 Agent 框架都还停留在"给了你 F5 键"的阶段——机制有了,自动化的调度和恢复策略还没来。
05两种 Agent OS:LangGraph vs Microsoft Agent Framework
LangGraph 不是唯一的"Agent OS"玩家。2026 年 4 月,Microsoft 把 AutoGen(多 Agent 对话框架)和 Semantic Kernel(企业级 AI 工具包)合并为 Microsoft Agent Framework 1.0,同时支持 Python 和 .NET。
这两个框架的底层能力越来越像:都有图工作流(MAF 叫 Dataflow Workflow)、都有 checkpoint(MAF 叫 WorkflowCheckpoint)、都支持条件路由和持久化。但设计哲学完全不同。
LangGraph 是"微内核"哲学。 给你四个原语——StateGraph(状态容器)、Node(计算单元)、Conditional Edge(运行时路由)、Checkpointer(持久化层)——然后你自己组合。你可以定义一个 50 个节点的复杂 Agent 拓扑,写出任何你需要的控制流。代价是你得写 150 行模板代码才能跑通一个"查询天气"的 demo。
Microsoft Agent Framework 是"宏内核"哲学。 给你完整的抽象——Sequential、Concurrent、Handoff、Group Chat 这些编排模式是一等原语,不需要你手动搭图。框架帮你做了很多决定,你的代码量少很多。代价是当你需要框架没给的模式时(比如一个三阶段嵌套 handoff + 每阶段内循环反思 + 某阶段暂停等外部信号),你会发现这些"高级原语"变成了束缚。
这很像操作系统史上的 Linux vs Windows 之争。Linux 给你一组系统调用和内核原语,你觉得重你可以自己搭轻量发行版,但你得自己配很多东西。Windows 给你完整的桌面环境和标准 API,开箱能用,但你想改内核行为?不好意思,那是微软的事。
| 编排模型 | ||
| Checkpoint 粒度 | ||
| 自动恢复 | ||
| 时间旅行调试 | ||
| 语言支持 | ||
| 云绑定 | ||
| GitHub Stars | ||
| 最适场景 |
选型三句话:
如果你是 Python 栈、需要严格控制 Agent 流程、团队愿意花 1-2 周上手图思维 → LangGraph。
如果你是 .NET 栈、已经在用 Azure、需要快速上线标准多 Agent 模式 → Microsoft Agent Framework。
如果这两个都太重、你只是在跑简单的角色分工型多 Agent → CrewAI 就够了。
图3:Agent 编排框架四象限定位
06从手工调度到真正 OS:Agent 运行时的下一步
站在 2026 年中回看,Agent 编排经历了一个清晰的演进:
2023 — 链式调用时代。LangChain LCEL 把多个 LLM 调用串成管道。一切看起来都很简单——因为 Agent 那时候还只是"调一次模型,选一个工具,返回一个答案"。 2024 — 框架爆发期。CrewAI、AutoGen、Dify、Coze 纷纷出现,各有各的编排理念。Agent 开始变复杂——多步推理、多工具协作、人工审批——大家发现链式调用开始撑不住了。 2025 Q4 — 状态机成为共识。LangGraph 1.0 发布,LangChain 主动把自己的 create_agent架在 LangGraph 引擎上——等于官方承认"链式调用只是图的一个子集"。DAG 从"主菜"变成了"特例"。2026 Q2 — 趋同与分化。Microsoft Agent Framework 1.0 走向图工作流 + checkpoint 模式,和 LangGraph 趋同。但双方在"Agent OS 该长什么样"上开始分化——微内核 vs 宏内核 vs 基础设施派(Dapr 靠 K8s 提供执行持久性)。
下一个阶段的关键词是 Durable Execution。当所有框架都有了 checkpoint 之后,竞争的焦点会从"能不能保存状态"转移到"能不能保证任务一定完成"——自动故障检测、自动恢复、分布式锁防重、幂等执行保障。
这很像 1970 年代操作系统从批处理到分时系统的过渡:机制先到位(进程调度 / 内存管理 / 文件系统),然后是调度策略和可靠性保证(优先级调度 / 死锁检测 / 事务处理)。Agent 框架正处于同样的拐点——机制层基本稳定,策略层才刚刚开始。
对现在的你来说,三个要记住的判断:
如果你的 Agent 有超过 3 步且含条件分支,现在就迁移到 StateGraph。 别等 DAG 管道在生产环境崩溃再换。迁移成本比修复"DAG 强塞回边闹出的 bug"低得多。 生产环境必须用 PostgresSaver + sync mode。 MemorySaver 是调试用的,进程死了就没了。SqliteSaver 在并发下写性能急剧下降。PostgresSaver 是多实例生产环境的唯一选择。 所有有副作用的节点必须做幂等。 发消息前先查"这条消息发过了吗",写数据库前先 INSERT ... ON CONFLICT DO NOTHING,调付费 API 前先检查"这笔费用已经扣过了吗"。LangGraph resume 时重执行节点,不是续跑代码行。
07你的第一个 StateGraph 模板
下面是一个可以直接复制运行的 LangGraph 模板——带 Postgres checkpoint、retry policy、和 interrupt 人工审批。
上下滑动查看更多源码
from typing import TypedDict, Annotated, Literal
from langgraph.graph import StateGraph, END
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.types import interrupt, RetryPolicy
import asyncio

# 1. 定义 State——所有节点共享的真相源
class ResearchAgentState(TypedDict):
    topic: str
    search_results: Annotated[list, lambda left, right: (left or []) + (right or [])]
    analysis: str
    draft: str
    human_approved: bool
    retry_count: int

# 2. 节点——每个函数返回 state 的 diff
def search(state: ResearchAgentState) -> dict:
"""搜索阶段。重试策略:最多 3 次,指数退避"""
try:
        results = call_search_api(state["topic"])
return {"search_results": results, "retry_count": 0}
except Exception:
if state.get("retry_count", 0) < 3:
return {"retry_count": state.get("retry_count", 0) + 1}
return {"search_results": [], "retry_count": 0}

def analyze(state: ResearchAgentState) -> dict:
return {"analysis": call_llm_analyze(state["search_results"])}

def draft(state: ResearchAgentState) -> dict:
return {"draft": call_llm_draft(state["topic"], state["analysis"])}

# ⚠️ 副作用节点——必须做幂等检查
def notify_reviewer(state: ResearchAgentState) -> dict:
"""通知审核人。幂等: 检查是否已发送过"""
if state.get("notification_sent"):
return {}  # 已发送, 跳过
    send_slack(f"请审核: {state['topic']}")
return {"notification_sent": True}

def human_review(state: ResearchAgentState) -> dict:
"""暂停等待人工审批。这是 LangGraph 的杀手级功能"""
    approval = interrupt({
"question": "是否可以继续发布?",
"draft_preview": state["draft"][:500]
    })
return {"human_approved": approval.get("approved", False)}

# 3. Router——运行时状态决定下一步
def review_router(state: ResearchAgentState) -> Literal["end", "revise"]:
if state["human_approved"]:
return "end"
return "revise"

# 4. 构建图
builder = StateGraph(ResearchAgentState)
builder.add_node("search", search)
builder.add_node("analyze", analyze)
builder.add_node("draft", draft)
builder.add_node("notify", notify_reviewer)
builder.add_node("review", human_review)

builder.set_entry_point("search")
builder.add_edge("search", "analyze")
builder.add_edge("analyze", "draft")
builder.add_edge("draft", "notify")
builder.add_edge("notify", "review")
builder.add_conditional_edges("review", review_router, {
"end": END,
"revise": "draft"# 不通过 → 重写
})

# 5. 生产环境配置
DB_URI = "postgresql://user:pass@localhost:5432/agent_checkpoints"
checkpointer = PostgresSaver.from_conn_string(DB_URI)
checkpointer.setup()  # 首次运行创建表

app = builder.compile(
    checkpointer=checkpointer,
    interrupt_before=["review"]  # review 前自动暂停
)
三种使用方式:
config = {"configurable": {"thread_id": "research-001"}}

# 方式 1: 同步执行
result = app.invoke({"topic": "LangGraph 1.0 架构分析"}, config)

# 方式 2: 流式——实时看到每一步
for event in app.stream({"topic": "LangGraph 1.0"}, config):
print(event)

# 方式 3: 崩溃恢复——进程死了也能续跑
# 第一次执行到一半, 进程崩溃
try:
    app.invoke({"topic": "..."}, config)
except Exception:
pass

# 重启后, 从 checkpoint 继续
result = app.invoke(None, config)  # None = 从上次中断处继续
这个模板涵盖了一个生产级 Agent 的核心模式:搜索→分析→写作→通知→人工审批→重写循环。你可以把 search/analyze/draft 替换成自己的业务逻辑,把 notify_reviewer 换成钉钉/飞书/webhook,把 Postgres 换成你的数据库——框架不变。
如果你已经用 LangChain 搭过 Agent,并且在复杂场景下踩过"为什么它卡住了"的坑——迁移到 StateGraph 不需要重写业务逻辑,只需要把你现有的函数"搬进"节点,把以前用 if/else + while 写的控制流替换成条件边。第一周可能会觉得"为什么这么麻烦",第二周你会想"为什么我以前没有这个"。
因为一个能挂起、恢复、分支、回退的持久状态机,不是一个更好的管道——它是一个不同的物种。